ToolMage
Anmelden

AI TOOL COMPARISON

Fluidstack vs Nebius

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

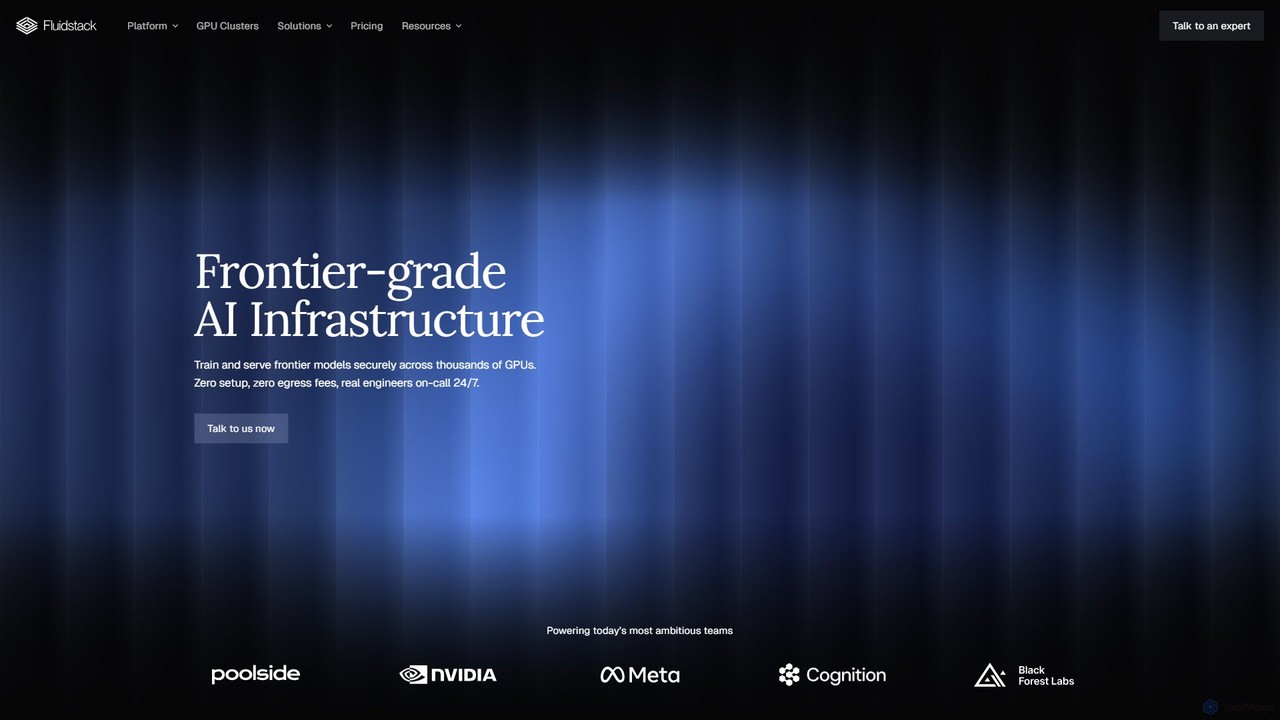
Fluidstack Produktübersicht

Fluidstack ist eine führende KI-Cloud-Plattform, die hochleistungsfähige, dedizierte GPU-Cluster für das Training und die Bereitstellung von Frontier-KI-Modellen anbietet. Sie ermöglicht den schnellen Einsatz von Tausenden von GPUs, vollständig verwaltete Dienste mit 24/7-Experten-Support und transparente Preise ohne Egress-Gebühren, um KI-Teams eine reibungslose Skalierung ohne Infrastrukturhürden zu ermöglichen.

Preview

Nebius Produktübersicht

Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für anspruchsvolle KI- und Machine-Learning-Workloads entwickelt wurde. Sie bietet skalierbaren Zugriff auf die neuesten NVIDIA-GPUs, von einzelnen Instanzen bis hin zu massiven Clustern, ergänzt durch eine Suite von Managed Services und ein integriertes AI Studio, um den gesamten ML-Lebenszyklus vom Training bis zur Inferenz zu optimieren.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Fluidstack VS Nebius — Kerndaten
KerndatenFluidstackNebius
Pricing modelPaidPaid
Product typeWebWeb
Primary focusUnternehmenslösungenGPU-Cloud
Zielgruppen und RollenNicht verifiziertKI-Forscher · Chief Technology Officer · Datenwissenschaftler · DevOps-Ingenieur · Machine Learning Ingenieur · Produktmanager · Softwareentwickler
KategorienUnternehmenslösungen · Maschinelles Lernen · Cloud ComputingGPU-Cloud · Maschinelles Lernen · Cloud Computing
Added09.08.202510.09.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Fluidstack

Fluidstack ist eine spezialisierte KI-Cloud-Plattform, die entwickelt wurde, um den ambitioniertesten KI-Teams der Welt – von Frontier-Startups bis hin zu etablierten Unternehmen – eine hochleistungsfähige GPU-Infrastruktur bereitzustellen. Die Kernmission der Plattform besteht darin, die Komplexität und Verzögerungen bei der Einrichtung und Verwaltung großer GPU-Cluster zu beseitigen, damit sich Forscher und Entwickler ausschließlich auf die Modellentwicklung und Innovation konzentrieren können. Fluidstack liefert vollständig verwaltete, dedizierte GPU-Cluster, die auf über 95 % der theoretischen Leistung getestet sind und so einen maximalen Durchsatz für anspruchsvolle KI-Workloads gewährleisten.

Fluidstack genießt das Vertrauen führender KI-Labore und Unternehmen wie poolside und hat seine Fähigkeit bewiesen, Tausende von GPUs wie NVIDIA H100 und A100 innerhalb von Tagen bereitzustellen – ein starker Kontrast zu den monatelangen Vorlaufzeiten traditioneller Hyperscaler. Die Plattform basiert auf einem speziell entwickelten Stack, einschließlich des Atlas OS für eine schnelle Bereitstellung und des Lighthouse-Überwachungssystems für proaktive Problemerkennung und automatische Fehlerbehebung, was eine hohe Verfügbarkeit und Zuverlässigkeit garantiert.

Wie man Fluidstack verwendet

Der Einstieg bei Fluidstack ist ein optimierter, beratender Prozess, der für ernsthafte KI-Entwicklung konzipiert ist:

  1. Beratung: Kontaktieren Sie zunächst das Expertenteam von Fluidstack über deren Website, um Ihre spezifischen Rechenanforderungen zu besprechen, einschließlich der benötigten Anzahl und Art von GPUs, des Projektzeitplans und des Umfangs.
  2. Cluster-Design: Die Ingenieure von Fluidstack arbeiten mit Ihnen zusammen, um einen maßgeschneiderten, dedizierten GPU-Cluster zu entwerfen, der für Ihre Workloads optimiert ist, sei es für groß angelegtes Modelltraining oder hochdurchsatzfähige Inferenz.
  3. Schnelle Bereitstellung: Nach Vertragsunterzeichnung stellt Fluidstack Ihren dedizierten Cluster bereit. Dieser Prozess ist unglaublich schnell, wobei die Bereitstellung von Tausenden von GPUs innerhalb von 48 Stunden möglich ist.
  4. Zugriff und Integration: Greifen Sie über Standard-Orchestrierungstools wie SLURM oder Kubernetes auf Ihren vollständig verwalteten Cluster zu. Fluidstack kümmert sich um die gesamte Einrichtung, Wartung und Upgrades und ermöglicht eine nahtlose Integration in Ihren bestehenden Workflow.
  5. Laufende Verwaltung: Nutzen Sie den praktischen 24/7-Support von Fluidstack und die Lighthouse-Überwachungsplattform. Das System erkennt und behebt Probleme automatisch, während Ingenieure mit einem 15-minütigen Reaktions-SLA für komplexe Probleme zur Verfügung stehen.

Kernfunktionen von Fluidstack

  • Dedizierte GPU-Cluster: Zugriff auf die neuesten GPU-Architekturen, einschließlich NVIDIA H100, H200, B200 und GB200, mit der Möglichkeit, auf über 12.000 GPUs in einem einzigen Fabric zu skalieren.
  • Atlas OS: Ein proprietäres Bare-Metal-Betriebssystem für KI-Infrastruktur, das eine schnelle Bereitstellung, reibungslose Orchestrierung und vollständige Kontrolle ermöglicht.
  • Lighthouse-Überwachung: Eine proaktive Überwachungs- und Auto-Remediation-Plattform, die Workloads überwacht, heilt und optimiert und Probleme erkennt, bevor sie die Leistung beeinträchtigen.
  • Vollständig verwalteter Service: End-to-End-Verwaltung Ihres Clusters, einschließlich Einrichtung, Orchestrierung (SLURM oder Kubernetes), Wartung und Upgrades.
  • 24/7-Experten-Engineering-Support: Direkter Zugang zu echten Ingenieuren über Slack mit einer garantierten Reaktionszeit von 15 Minuten (SLA), die Expertenantworten und praktischen Support bieten.
  • Hohe Sicherheit und Compliance: Die Infrastruktur ist standardmäßig Single-Tenant, was eine vollständige Isolation gewährleistet. Die Plattform ist konform mit den Standards HIPAA, GDPR, ISO27001 und SOC 2 Type I.
  • Transparente Preise: Keine versteckten Gebühren, einschließlich null Egress- oder Ingress-Gebühren, und NVMe-Speicher auf den Knoten ist inbegriffen.

Anwendungsfälle für Fluidstack

Fluidstack ist ideal für Organisationen mit anspruchsvollen, groß angelegten KI-Anforderungen:

  • Forschungslabore: Ermöglicht es Spitzenforschern, Infrastrukturverzögerungen zu überspringen und sich voll und ganz darauf zu konzentrieren, die Grenzen der KI-Modellentwicklung zu erweitern.
  • Unternehmens-KI-Teams: Bietet zuverlässige, hochleistungsfähige und konforme Cluster für den Betrieb geschäftskritischer KI-Anwendungen im großen Maßstab.
  • Souveräne KI-Initiativen: Bietet sichere, regionalspezifische Bereitstellungen mit vollständiger physischer und betrieblicher Sicherheit zum Aufbau nationaler KI-Fähigkeiten.
  • Finanzdienstleistungen: Ermöglicht schnelle und sichere Inferenz, quantitative Modellierung und Risikoanalyse-Workloads.
  • KI-Startups: Wie der Fall poolside zeigt, ermöglicht Fluidstack schnelllebigen Startups, große Cluster schnell bereitzustellen, die Markteinführungszeit zu verkürzen und ohne großes Anfangskapital oder langfristige Verpflichtungen effizient zu skalieren.

Vorteile von Fluidstack

Fluidstack bietet erhebliche Vorteile gegenüber traditionellen Cloud-Anbietern:

  • Unübertroffene Geschwindigkeit: Stellen Sie Cluster mit Tausenden von GPUs in Tagen statt Monaten bereit.
  • Spitzenleistung: Die Cluster sind vollständig eingebrannt und getestet, um vom ersten Tag an >95 % der theoretischen Leistung zu liefern.
  • Betriebliche Einfachheit: Befreit Ihr Team von der Komplexität der Infrastrukturverwaltung, von der Hardware-Einrichtung bis zur Kubernetes-Konfiguration.
  • Kosteneffizienz: Transparente All-inclusive-Preise ohne überraschende Datenübertragungsgebühren, was zu vorhersehbareren und oft niedrigeren Gesamtbetriebskosten führt.
  • Überlegener Support: Direkter, partnerschaftlicher Support von erfahrenen Ingenieuren, kein abgestuftes Ticketsystem.

Preise und Pläne

Fluidstack bietet flexible Preismodelle für unterschiedliche Bedürfnisse, alle mit transparenten All-inclusive-Bedingungen.

  • Reservierte Cluster: Konzipiert für groß angelegtes Training und Inferenz mit Laufzeiten von 30 Tagen oder mehr. Bietet ermäßigte Raten und garantierte Ressourcen für 256 bis 10.000+ GPUs. Preise auf Anfrage.
  • On-Demand: Für flexible Skalierungsanforderungen, mit denen Sie GPU-Instanzen in weniger als 5 Minuten starten und von 8 auf 4.000+ GPUs skalieren können. Abrechnung pro Stunde.
  • Private Cloud: Maßgeschneiderte, dedizierte Cluster für komplexe Anforderungen, bestimmte Regionen oder benutzerdefinierte Stacks.

Beispiele für stündliche On-Demand-Raten:

  • NVIDIA H200 SXM: 2,30 $ / GPU / Stunde
  • NVIDIA H100 SXM: 2,10 $ / GPU / Stunde
  • NVIDIA A100 80GB SXM: 1,30 $ / GPU / Stunde

Alle Pläne beinhalten 24/7-Engineering-Support, ein 15-Minuten-Reaktions-SLA, verwaltetes SLURM oder K8s, proaktive Überwachung und keine Egress-/Ingress-Gebühren.

Nebius

Nebius ist ein spezialisierter, hochleistungsfähiger Cloud-Anbieter, der von Grund auf für die intensiven Anforderungen von künstlicher Intelligenz und maschinellem Lernen konzipiert wurde. Als NVIDIA Reference Platform Cloud Partner bietet Nebius eine robuste und skalierbare Infrastruktur für KI-Entdecker, Forscher und Unternehmen. Die Plattform kombiniert modernste Hardware, einschließlich der neuesten NVIDIA-GPUs, mit einer umfassenden Suite von Managed Services und einem benutzerfreundlichen AI Studio, um eine End-to-End-Umgebung für die Entwicklung, das Training und die Bereitstellung von KI-Modellen jeder Größe zu schaffen.

Das Herzstück von Nebius ist seine KI-optimierte Infrastruktur, die in eigenen nachhaltigen und hocheffizienten Rechenzentren aufgebaut ist. Dies ermöglicht eine unübertroffene Leistung und Kosteneffizienz. Ob Sie ein großes Sprachmodell feinabstimmen, komplexe wissenschaftliche Simulationen durchführen oder generative KI-Anwendungen bereitstellen, Nebius bietet die Leistung und Flexibilität, die zur Beschleunigung von Innovationen erforderlich sind.

Wie man Nebius verwendet

Der Einstieg in Nebius ist für Entwickler und ML-Ingenieure unkompliziert gestaltet. Benutzer können sich zunächst auf der Plattform anmelden. Von dort aus können Sie Ressourcen über mehrere Schnittstellen bereitstellen: die intuitive Webkonsole, eine leistungsstarke Befehlszeilenschnittstelle (CLI), eine umfassende API oder durch die Verwendung von Infrastructure as Code (IaC)-Tools wie Terraform für automatisierte Bereitstellungen. Sie können aus einer Reihe von NVIDIA-GPU-Instanzen (wie H100, H200, B200) wählen und diese als eigenständige Maschinen oder als Teil großer, multi-nodaler Cluster konfigurieren, die mit Managed Kubernetes oder Slurm orchestriert werden. Für einen optimierten Arbeitsablauf bietet das Nebius AI Studio gebrauchsfertige Dienste für die Feinabstimmung von Modellen, Inferenz und Batch-Verarbeitung, die mit nur wenigen Klicks zugänglich sind.

Kernfunktionen von Nebius

  • Neueste NVIDIA-GPUs: Zugriff auf eine breite Palette von erstklassigen NVIDIA-Beschleunigern, einschließlich H100, H200, B200 und Vorbestellungen für den GB200 NVL72, um Spitzenleistung für KI-Workloads zu gewährleisten.
  • Skalierbare KI-Cluster: Flexible Skalierung von einer einzelnen GPU bis hin zu Superclustern mit Tausenden von GPUs, die mit Hochgeschwindigkeits-InfiniBand-Netzwerken (bis zu 3,2 Tbit/s pro Host) verbunden sind.
  • Managed Services: Vollständig verwaltete Lösungen für Kubernetes, Slurm, PostgreSQL, MLflow und Apache Spark, die den Betriebsaufwand reduzieren und es den Teams ermöglichen, sich auf die ML-Entwicklung zu konzentrieren.
  • Nebius AI Studio: Eine integrierte Plattform, die Dienste für Inferenz, Feinabstimmung, KI-Bilderzeugung und Batch-Verarbeitung anbietet, um den ML-Lebenszyklus zu beschleunigen.
  • Cloud-Native Erfahrung: Volle Unterstützung für moderne DevOps-Praktiken mit Terraform, API und CLI für das Infrastrukturmanagement.
  • Sicherheit auf Unternehmensniveau: Robuste Sicherheitsmaßnahmen, einschließlich Verschlüsselung auf Unternehmensniveau, intelligentes Zugriffsmanagement und eine sichere by-Design-Infrastruktur zum Schutz sensibler KI-Workloads.
  • Experten-Support: 24/7-Experten-Support und dedizierte Unterstützung durch Lösungsarchitekten für komplexe Multi-Node-Implementierungen, kostenlos zur Verfügung gestellt.

Anwendungsfälle für Nebius

Nebius ist ideal für eine Vielzahl von rechenintensiven Aufgaben. Zu den Hauptanwendungsfällen gehören das Training und die Feinabstimmung großer Sprachmodelle (LLMs), die Entwicklung und Bereitstellung von generativen KI-Anwendungen wie Bild- und Textgeneratoren sowie die Durchführung von Hochleistungsrechensimulationen (HPC) für die wissenschaftliche Forschung in Bereichen wie Genomik und Quantenchemie. Darüber hinaus nutzen Unternehmen Nebius, um skalierbare MLOps-Pipelines aufzubauen, komplexe KI-Workflows zu verwalten und große Batch-Inferenz-Jobs effizient auszuführen.

Vorteile von Nebius

Der Hauptvorteil von Nebius liegt in seinem alleinigen Fokus auf KI. Durch die Optimierung jeder Schicht des Stacks – von den eigens entwickelten, energieeffizienten Rechenzentren bis hin zu den vorkonfigurierten Softwareumgebungen – liefert Nebius eine überlegene Leistung und erhebliche Kosteneinsparungen im Vergleich zu Allzweck-Cloud-Anbietern. Sein Status als NVIDIA Reference Platform Cloud Partner garantiert den Zugang zu den neuesten Technologien und optimierten Architekturen. Die Kombination aus roher Rechenleistung, Managed Services und einem dedizierten AI Studio bietet eine umfassende, entwicklerfreundliche Plattform, die die gesamte KI-Entwicklungsreise vereinfacht und beschleunigt.

Preise und Pläne

Nebius bietet ein Pay-as-you-go-Preismodell für seine GPU-Ressourcen, das Transparenz und Flexibilität bietet. Die Abrechnung erfolgt in der Regel auf Stundenbasis. Beispielhafte Richtpreise sind:

  • NVIDIA H100 GPU: Ab 2,00 $ pro Stunde
  • NVIDIA H200 GPU: Ab 2,30 $ pro Stunde
  • NVIDIA B200 GPU: Ab 3,00 $ pro Stunde
Für große Verpflichtungen (Hunderte von Einheiten für mindestens 3 Monate) bietet Nebius wettbewerbsfähige Preise und verbesserte Kosteneinsparungen. Potenzielle Kunden werden ermutigt, das Vertriebsteam für ein personalisiertes Angebot zu kontaktieren. Alle angegebenen Preise verstehen sich zuzüglich der anfallenden Steuern.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Maschinelles LernenCloud Computing
Nur Fluidstack
Unternehmenslösungen
Nur Nebius
GPU-Cloud

Tags

Gemeinsam
KI-InfrastrukturDeep LearningGPU-CloudHochleistungsrechnenmaschinelles LernenModelltraining
Nur Fluidstack
B200Cloud ComputingUnternehmens-KIH100Inferenz
Nur Nebius
Cloud-PlattformKubernetesMLOpsModellinferenzNVIDIA GPUSlurm

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Fluidstack
Keine verifizierten Daten
Nur Nebius
KI-ForscherChief Technology OfficerDatenwissenschaftlerDevOps-IngenieurMachine Learning IngenieurProduktmanagerSoftwareentwickler

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Fluidstack monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
101.4K
Ø Besuchsdauer
1:06
Seiten pro Besuch
2.58
Absprungrate
39.33%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 28.9K
  • 2026-01: 91.6K
  • 2026-02: 69.4K
  • 2026-03: 95.5K
  • 2026-04: 101K
  • 2026-05: 101.4K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States87.31%88.5K
🇬🇧United Kingdom6.99%7.1K
🇮🇳India2.34%2.4K
🇨🇦Canada1.75%1.8K
🇻🇳Vietnam1.61%1.6K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt77.86%79K
Verweis16.42%16.7K
E-Mail5.72%5.8K

Suchbegriffe

fluid stackfluidstackfluidstack careersfluidstack jobsfluidstack technical program manager, deployments

Nebius monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
2.3K
Ø Besuchsdauer
0:24
Seiten pro Besuch
2.06
Absprungrate
30.76%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 6.4K
  • 2026-01: 78
  • 2026-02: 0
  • 2026-03: 365
  • 2026-04: 1.4K
  • 2026-05: 2.3K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India70.68%1.6K
🇺🇸United States19.85%454
🇬🇧United Kingdom9.47%217

Suchbegriffe

nebiusnebius ainebius ai cloudnebius gpunebius logo

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Fluidstack

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
160
Likes
152

Nebius

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
174
Likes
191

Fluidstack vs Nebius · Vergleichs-FAQ

What do Fluidstack and Nebius have in common?
Both tools are listed under Maschinelles Lernen、Cloud Computing. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Fluidstack and Nebius free?
Listed pricing models: Fluidstack — Paid; Nebius — Paid. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Fluidstack and Nebius?
The primary listed category is Unternehmenslösungen for Fluidstack, and GPU-Cloud for Nebius. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche