ToolMage
Anmelden

AI TOOL COMPARISON

Flyte vs Pipekit

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Flyte Produktübersicht

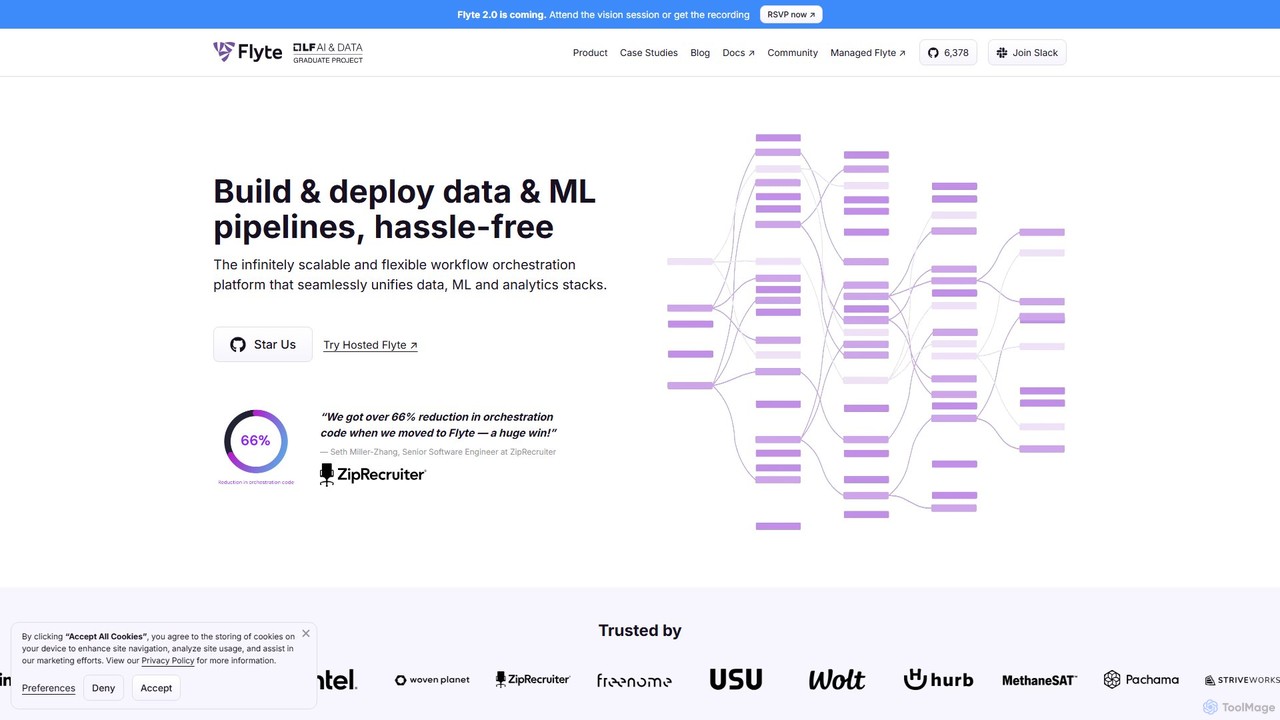
Flyte ist eine Open-Source, Cloud-native Workflow-Orchestrierungsplattform, die für die Erstellung, Bereitstellung und Verwaltung von produktionsreifen Daten-, Machine-Learning- und Analyse-Pipelines entwickelt wurde. Sie legt Wert auf Skalierbarkeit, Reproduzierbarkeit und Benutzerfreundlichkeit und ermöglicht es Teams, nahtlos von der lokalen Entwicklung zur groß angelegten Produktion überzugehen. Mit einem Python-first SDK und Unterstützung für mehrere Sprachen befähigt Flyte Datenwissenschaftler und Ingenieure, komplexe, versionierte und wartbare Workflows zu erstellen.

Preview

Pipekit Produktübersicht

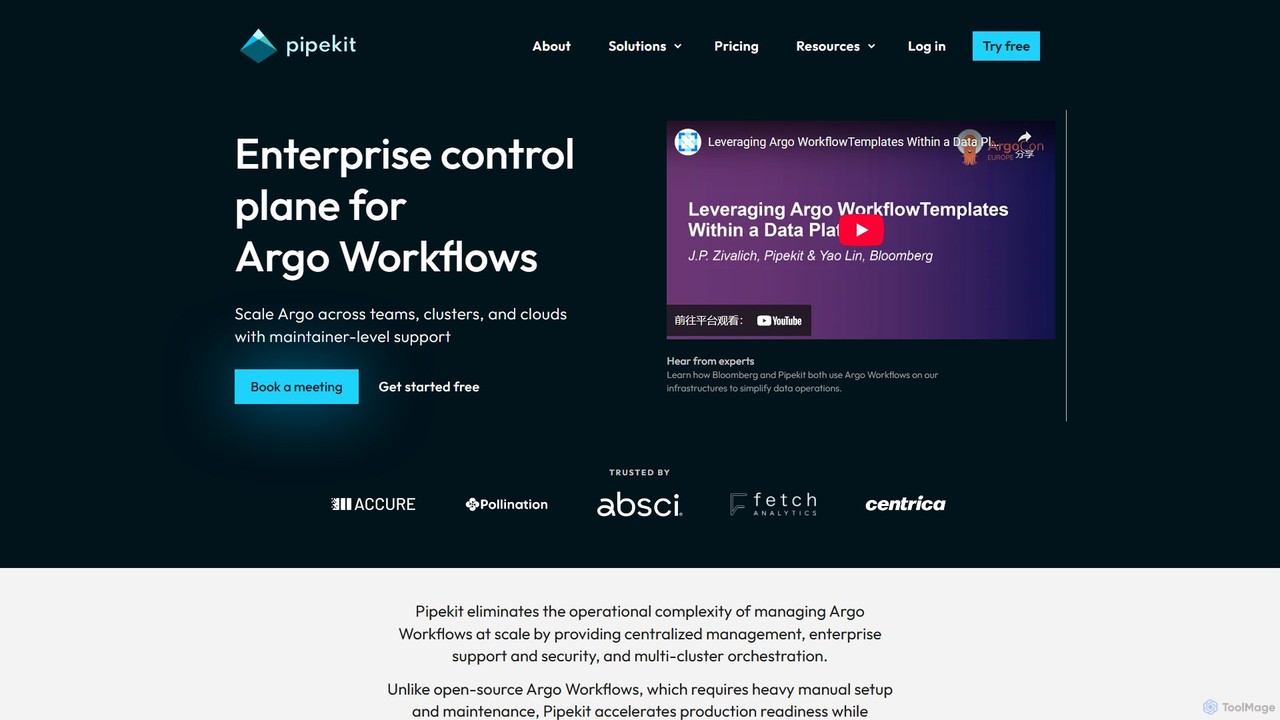
Pipekit ist eine unternehmenstaugliche Steuerungsebene und ein Support-Service für Argo Workflows. Es ermöglicht Plattform- und Datenteams, große Daten-, MLOps- und CI/CD-Pipelines auf Kubernetes über mehrere Cluster und Clouds hinweg auszuführen, zu überwachen und zu steuern.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Flyte VS Pipekit — Kerndaten
KerndatenFlytePipekit
Pricing modelFreemiumPaid
Product typeWebWeb
Primary focusMLOpsOrchestrierung
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienMLOps · Orchestrierung · AutomatisierungOrchestrierung · MLOps · DevOps
Added03.08.202515.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Flyte

Flyte ist eine produktionsreife, Open-Source- und Cloud-native Workflow-Orchestrierungsplattform, die speziell für komplexe Daten-, Machine-Learning- und Analyse-Pipelines entwickelt wurde. Als graduiertes Projekt der Cloud Native Computing Foundation (CNCF) bietet Flyte ein robustes und zuverlässiges Rückgrat für MLOps und schließt die Lücke zwischen lokaler Entwicklung und groß angelegten Produktionsumgebungen. Es ermöglicht Datenwissenschaftlern und ML-Ingenieuren, sich auf ihre Logik zu konzentrieren, während die Plattform Skalierbarkeit, Reproduzierbarkeit, Fehlertoleranz und Infrastrukturmanagement übernimmt.

Wie man Flyte verwendet

Die Verwendung von Flyte beinhaltet einen strukturierten, Code-first-Ansatz zur Definition und Verwaltung von Workflows:

  1. Tasks definieren: Ein Task ist die grundlegende Ausführungseinheit. Mit dem Python SDK definieren Sie einen Task mit dem `@task`-Decorator. Innerhalb des Tasks geben Sie dessen Eingaben, Ausgaben, Ressourcenanforderungen (z. B. CPU, Speicher, GPU) und Container-Image an.
  2. Workflows erstellen: Ein Workflow, definiert mit dem `@workflow`-Decorator, verkettet Tasks zu einem gerichteten azyklischen Graphen (DAG). Sie definieren den Datenfluss zwischen den Tasks und erstellen so eine vollständige Pipeline.
  3. Lokale Iteration: Flyte bietet Tools wie `pyflyte run`, um Ihre Workflows auf Ihrem lokalen Rechner auszuführen und zu debuggen. Dies ermöglicht eine schnelle Iteration und eine enge Feedback-Schleife vor der Bereitstellung.
  4. In Produktion registrieren: Sobald Ihr Workflow fertig ist, registrieren Sie ihn mit `pyflyte register` bei einem Flyte-Cluster. Diese Aktion versioniert Ihren gesamten Workflow, einschließlich Code und Abhängigkeiten, und gewährleistet so die Reproduzierbarkeit.
  5. Starten und Überwachen: Sie können Workflow-Ausführungen über die Flyte-Benutzeroberfläche, einen geplanten Cron-Job oder die API auslösen. Die Benutzeroberfläche bietet eine umfassende Ansicht zur Überwachung von Ausführungen, zur Überprüfung von Protokollen, zur Visualisierung von Ausgaben mit FlyteDecks und zur Analyse der Datenherkunft.
  6. Mit erweiterten Funktionen skalieren: Für die Verarbeitung im großen Maßstab können Sie Funktionen wie `map_task` nutzen, um einen Task parallel über eine Liste von Eingaben auszuführen, oder dynamische Workflows verwenden, um die Struktur der Pipeline zur Laufzeit anzupassen.

Kernfunktionen von Flyte

  • Reproduzierbarkeit & Versionierung: Jeder Task und Workflow ist versioniert und unveränderlich. Flyte verfolgt automatisch die Datenherkunft, sodass Sie jede Ausgabe auf den exakten Code und die Daten zurückführen können, die sie erzeugt haben.
  • Skalierbarkeit & Leistung: Auf Kubernetes aufgebaut, ist Flyte von Natur aus skalierbar. Es unterstützt dynamische Ressourcenzuweisung, GPU-Beschleunigung, Spot/Preemptible-Instanzen zur Kosteneinsparung und massive Parallelität durch Map-Tasks.
  • Entwicklerzentrierte Erfahrung: Bietet ein Python-first SDK, das für Datenwissenschaftler intuitiv ist. Es abstrahiert Infrastrukturkomplexitäten mit Funktionen wie `ImageSpec`, das Container-Images ohne Dockerfile-Kenntnisse erstellt.
  • Sprachunabhängig: Obwohl das primäre SDK Python ist, unterstützt Flyte das Schreiben von Tasks in jeder Sprache (Java, Scala, R usw.), indem sie in ihren eigenen Containern ausgeführt werden.
  • Robuste Datenverarbeitung: Bietet stark typisierte Schnittstellen, um Datenfehler zur Kompilierungszeit abzufangen. Die Typen `FlyteFile`, `FlyteDirectory` und `StructuredDataset` vereinfachen die Daten-E/A zwischen Tasks und Cloud-Speicher.
  • Erweiterte Orchestrierungslogik: Unterstützt dynamische Workflows, bedingte Verzweigungen, Intra-Task-Checkpointing für langlaufende Tasks und Caching, um die Neuberechnung teurer Schritte zu vermeiden.
  • Unternehmensreif: Bietet Mandantenfähigkeit zur Team-Isolation, Geheimnisverwaltung für den sicheren Zugriff auf Anmeldeinformationen und Benachrichtigungen über Slack, PagerDuty oder E-Mail.

Anwendungsfälle für Flyte

Flyte ist vielseitig und wird in verschiedenen Branchen für geschäftskritische Pipelines eingesetzt:

  • Groß angelegte Datenverarbeitung (ETL): Erstellung und Planung robuster ETL-Pipelines zur Verarbeitung von Terabytes an Daten für Analysen und Data Warehousing.
  • Training von Machine-Learning-Modellen: Orchestrierung von End-to-End-ML-Pipelines, von der Datenvorverarbeitung und dem Feature-Engineering bis hin zum verteilten Modelltraining, der Hyperparameter-Optimierung und der Evaluierung.
  • LLM & Generative KI: Feinabstimmung von Large Language Models (LLMs), Aufbau von Retrieval-Augmented Generation (RAG)-Systemen und Verwaltung komplexer Inferenzgraphen.
  • Bioinformatik & Genomik: Ausführung rechenintensiver Bioinformatik-Workflows, wie z. B. DNA-Sequenzabgleich und -analyse, im großen Maßstab.
  • Geodatenanalyse: Verarbeitung massiver Satellitenbilddatensätze zur Erstellung von Datenprodukten wie Mosaiken und digitalen Höhenmodellen, wie durch die Verwendung mit Xarray und GDAL demonstriert.

Vorteile von Flyte

Flyte bietet erhebliche Vorteile gegenüber anderen Orchestratoren:

  • Produktionsreif vom ersten Tag an: Der Fokus auf Typisierung, Versionierung und Unveränderlichkeit stellt sicher, dass Workflows zuverlässig und reproduzierbar sind.
  • Vereint Daten- & ML-Stacks: Bietet eine einzige Plattform für Dateningenieure, ML-Wissenschaftler und Analyseexperten, wodurch Silos aufgebrochen und die Zusammenarbeit gefördert wird.
  • Reduziert den Infrastrukturaufwand: Automatisiert viele der herausfordernden Aspekte von MLOps, wie Containerisierung, Ressourcenmanagement und Skalierung.
  • Kosteneffizient: Der Open-Source-Kern ist kostenlos, während Funktionen wie Caching, Fehlerbehebung und Spot-Instanz-Unterstützung die Rechenkosten erheblich senken.
  • Lebendiges Ökosystem: Als CNCF-Projekt verfügt es über eine starke Community und lässt sich nahtlos in eine breite Palette von Tools wie Spark, Ray, Pandera, Great Expectations und mehr integrieren.

Preise und Pläne

Flyte ist ein Open-Source-Projekt unter der Apache-2.0-Lizenz und kann daher völlig kostenlos heruntergeladen, verwendet und auf Ihrer eigenen Infrastruktur selbst gehostet werden. Für Organisationen, die eine vollständig verwaltete, unternehmensreife Lösung bevorzugen, bietet Union.ai (das Unternehmen, das Flyte ursprünglich entwickelt hat) eine gehostete Cloud-Plattform an. Dieses kommerzielle Angebot übernimmt die gesamte Einrichtung, Wartung und Skalierung der Infrastruktur und beinhaltet Unternehmenssupport und zusätzliche Funktionen.

Pipekit

Pipekit bietet eine robuste Lösung für Unternehmen, die ihre Cloud-nativen Operationen mit Argo Workflows skalieren möchten. Es bietet zwei Hauptdienste: die Pipekit Control Plane und den Pipekit Support Service. Gegründet von Experten, die bei Unternehmen wie Docker und Kite mit den Herausforderungen der Skalierung von Datenpipelines konfrontiert waren, wurde Pipekit entwickelt, um die Komplexität der Verwaltung von Argo im großen Maßstab zu vereinfachen, ohne Anbieterbindung.

Die Plattform ist auf Plattform- und Datenteams zugeschnitten, die Argo-Bereitstellungen über mehrere Teams oder Cluster hinweg verwalten müssen. Sie bietet eine zentralisierte, einheitliche Ansicht, um Bereitstellungen zu vereinheitlichen, Governance durchzusetzen und Entwicklern eine moderne, intuitive Benutzeroberfläche zu bieten. Dadurch hilft Pipekit Organisationen, Risiken zu mindern, Cloud-Ausgaben zu senken und Entwicklungs- und Debugging-Zyklen zu beschleunigen.

Wie man Pipekit verwendet

Die Verwendung von Pipekit beinhaltet die Integration seiner Steuerungsebene in Ihre bestehende Kubernetes-Infrastruktur, sei es vor Ort oder in der Cloud (AWS, Google Cloud, Microsoft Azure). Der Prozess folgt in der Regel diesen Schritten:

  1. Bereitstellung: Wählen Sie zwischen einer Cloud-gehosteten oder selbst gehosteten Bereitstellung der Pipekit Control Plane.
  2. Cluster-Verbindung: Verbinden Sie Ihre Kubernetes-Cluster mit der Pipekit-Plattform. Dies ermöglicht die Orchestrierung von Multi-Cluster-Workflows von einem einzigen Punkt aus.
  3. Workflow-Management: Verwenden Sie die einheitliche Benutzeroberfläche oder API, um Ihre Argo Workflows auszuführen, zu planen und zu überwachen. Entwickler können Tools wie das Hera Python SDK nutzen, um komplexe Workflows ohne umfangreiches YAML zu definieren.
  4. Governance und Sicherheit: Konfigurieren Sie Single Sign-On (SSO) und rollenbasierte Zugriffskontrolle (RBAC), um Berechtigungen zu verwalten und einen sicheren Zugriff für verschiedene Teams zu gewährleisten.
  5. Überwachung und Debugging: Nutzen Sie die integrierten Beobachtbarkeits- und Workflow-Tracing-Funktionen, um die Leistung zu überwachen, Engpässe zu identifizieren und Probleme schneller zu beheben.
  6. Support in Anspruch nehmen (optional): Teams, die den Pipekit Support Service nutzen, können direkt mit den Argo-Maintainern in Kontakt treten, um Expertenrat, Skalierungsstrategien und garantierte SLAs zu erhalten.

Kernfunktionen von Pipekit

  • Multi-Cluster-Workflow-Management: Führen Sie Argo Workflows nahtlos über mehrere Kubernetes-Cluster und Cloud-Anbieter von einer einzigen Schnittstelle aus.
  • Zentralisierte Beobachtbarkeit: Gewinnen Sie tiefe Einblicke in die Workflow-Leistung mit integrierten Überwachungs-, Protokollierungs- und Tracing-Funktionen.
  • Unternehmens-Governance: Setzen Sie Sicherheits- und Compliance-Richtlinien mit Single Sign-On (SSO) und feingranularer rollenbasierter Zugriffskontrolle (RBAC) durch.
  • Einheitliche Benutzeroberfläche und API: Eine moderne, intuitive Benutzeroberfläche und eine leistungsstarke API für Entwickler und Plattform-Ingenieure zur Interaktion mit dem System.
  • Experten-Unternehmenssupport: Direkter Zugang zu den Argo-Maintainern, der unternehmenstaugliche Service Level Agreements (SLAs), Einfluss auf die Roadmap und Expertenberatung zur Skalierung bietet.
  • Dynamische Planung: Planen Sie Workflows intelligent auf Ihrer eigenen Infrastruktur, um die Ressourcennutzung zu optimieren und Kosten zu senken.

Anwendungsfälle für Pipekit

Pipekit ist vielseitig und unterstützt eine breite Palette anspruchsvoller Anwendungen:

  • Groß angelegte Datenverarbeitung: Orchestrierung komplexer Big-Data-Pipelines mit Frameworks wie Apache Spark und Dask zur effizienten Verarbeitung von Petabytes an Daten.
  • MLOps und KI-Modelltraining: Erstellen, Trainieren und Evaluieren von großen Sprachmodellen (LLMs) und anderen maschinellen Lernmodellen im großen Maßstab, Verwaltung des gesamten ML-Lebenszyklus.
  • Cloud-native CI/CD: Modernisierung und Skalierung von CI/CD-Pipelines durch Migration von traditionellen Systemen wie Jenkins zu einer robusteren, Kubernetes-nativen Lösung mit Argo.
  • Automatisierte Störungsbehebung: Nutzung von Argo Events zur Erstellung ereignisgesteuerter Workflows, die Systemausfälle in Echtzeit automatisch erkennen und beheben, um die Systemzuverlässigkeit zu erhöhen.
  • Wissenschaftliches Rechnen & Forschung: Unterstützung komplexer computergestützter Forschung, wie in der Gentherapie, wo die Orchestrierung von Tausenden paralleler Aufgaben entscheidend ist.

Vorteile von Pipekit

  • Skalierbarkeit: Speziell für die Verarbeitung von Tausenden von Daten- und CI/CD-Pipelines entwickelt, damit Organisationen wachsen können, ohne an Orchestrierungsgrenzen zu stoßen.
  • Reduzierter Betriebsaufwand: Vereinfacht die Verwaltung von Argo und reduziert den Wartungsaufwand für Plattformteams erheblich.
  • Kostenoptimierung: Hilft, Cloud-Ausgaben durch effizientes Ressourcenmanagement, Arbeitsvermeidung und optimierte Planung zu sparen.
  • Schnelleres Debugging: Die zentralisierten Beobachtbarkeits- und Tracing-Funktionen ermöglichen es Teams, Probleme viel schneller zu identifizieren und zu lösen.
  • Gemindertes Risiko: Der Unternehmenssupport durch die Argo-Maintainer stellt sicher, dass kritische Open-Source-Infrastruktur zuverlässig und sicher ist.
  • Keine Anbieterbindung: Ermöglicht es Teams, die volle Leistung von Open-Source-Argo mit dem Sicherheitsnetz von unternehmenstauglichem Support und Tools zu nutzen.

Preise und Pläne

Pipekit bietet ein unkompliziertes Preismodell, das mit Ihren Anforderungen skaliert. Der Hauptplan ist:

  • Bringen Sie Ihre eigenen Kubernetes-Cluster mit: Ab $799 / Cluster / Monat.

Dieser Plan ermöglicht es Ihnen, Multi-Cluster-Workflows von einer einzigen Benutzeroberfläche oder API auszuführen, benutzerdefinierte Namespaces zu verwalten und funktioniert mit den meisten großen Cloud-Anbietern wie AWS, Google Cloud und Microsoft Azure. Für detaillierte Angebote und Unternehmensanforderungen wird empfohlen, eine kostenlose Beratung zu buchen.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
MLOps
Nur Flyte
OrchestrierungAutomatisierung
Nur Pipekit
OrchestrierungDevOps

Tags

Gemeinsam
DatenpipelineKubernetesMLOpsWorkflow-Orchestrierung
Nur Flyte
Datenengineeringmaschinelles LernenOpen SourcePythonReproduzierbarkeitSkalierbarkeit
Nur Pipekit
Argo WorkflowsCI/CDCloud-nativDevOpsUnternehmenssupportMulti-Cluster

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Flyte
Keine verifizierten Daten
Nur Pipekit
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Flyte monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
26.6K
Ø Besuchsdauer
0:12
Seiten pro Besuch
1.8
Absprungrate
38.08%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 37.5K
  • 2026-01: 29.4K
  • 2026-02: 32.2K
  • 2026-03: 30K
  • 2026-04: 31K
  • 2026-05: 26.6K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.74%12.4K
🇮🇳India15.16%4K
🇻🇳Vietnam14.31%3.8K
🇨🇦Canada13.45%3.6K
🇩🇪Germany10.34%2.7K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt54.58%14.5K
Verweis32.11%8.5K
E-Mail13.31%3.5K

Suchbegriffe

flyteflyte lyftgraphvizgraphviz onlinelyft flyte

Pipekit monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
5.8K
Ø Besuchsdauer
0:13
Seiten pro Besuch
1.74
Absprungrate
43.25%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.7K
  • 2026-01: 8.1K
  • 2026-02: 5.8K
  • 2026-03: 6.7K
  • 2026-04: 5.9K
  • 2026-05: 5.8K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States56.65%3.3K
🇮🇳India30.03%1.8K
🇬🇧United Kingdom12.97%757
🇨🇦Canada0.35%20

Suchbegriffe

argo workflow helm chartbest backtesting library pythonllm infra toolingoptions backtestingpipekit

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Flyte

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
185
Likes
181

Pipekit

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
210
Likes
202

Flyte vs Pipekit · Vergleichs-FAQ

What do Flyte and Pipekit have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Flyte and Pipekit free?
Listed pricing models: Flyte — Freemium; Pipekit — Paid. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Flyte and Pipekit?
The primary listed category is MLOps for Flyte, and Orchestrierung for Pipekit. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche