ToolMage
Anmelden

AI TOOL COMPARISON

instantapi vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

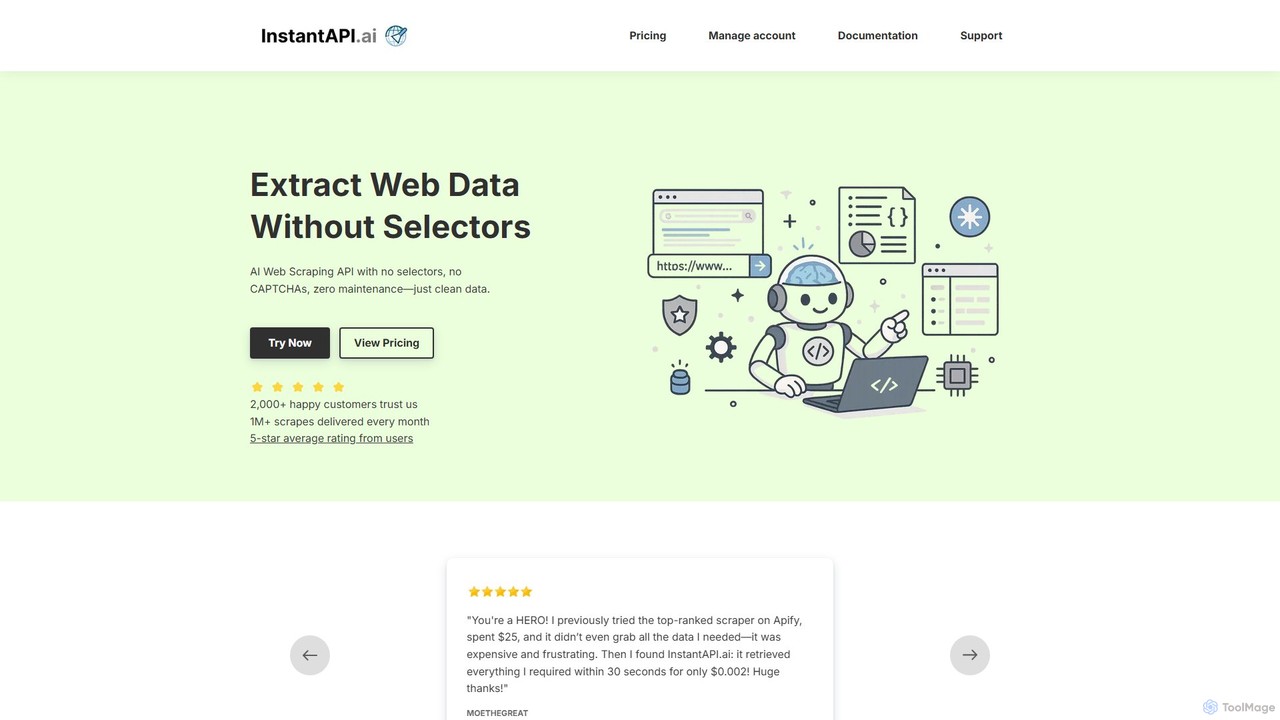
instantapi Produktübersicht

instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.

Preview

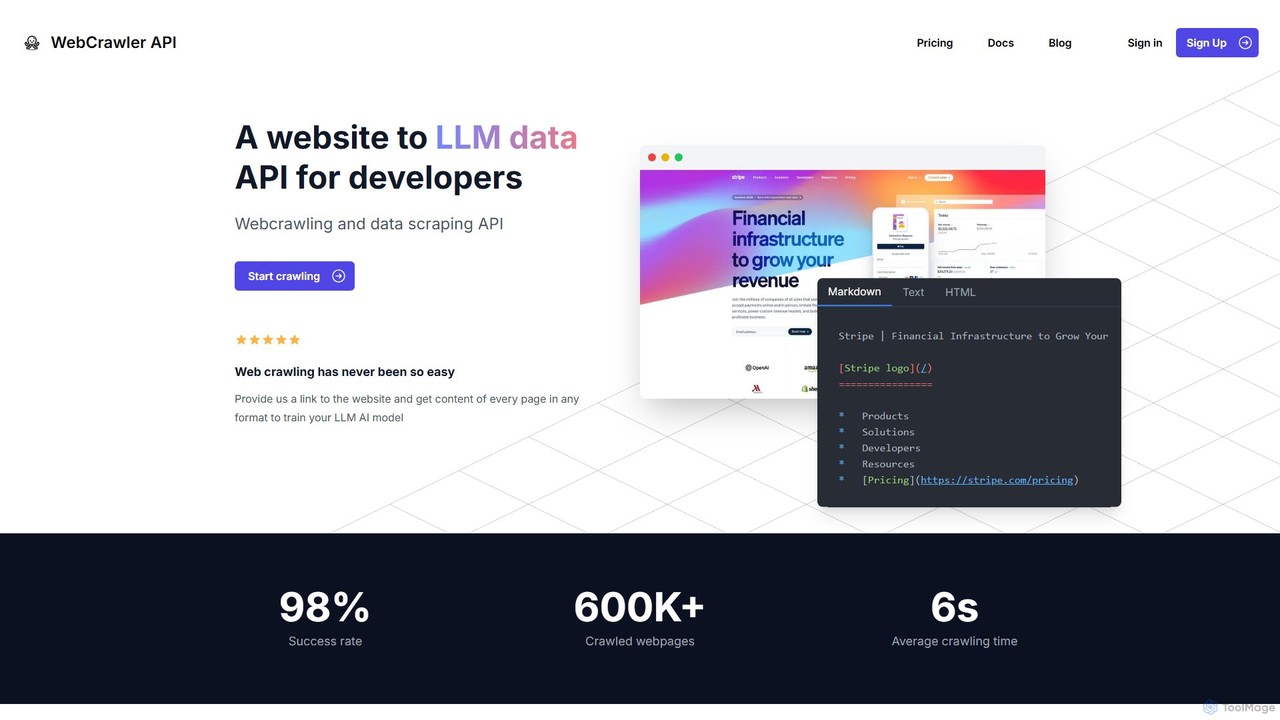
Webcrawlerapi Produktübersicht

Webcrawlerapi ist eine leistungsstarke API für Entwickler, um mühelos Websites zu crawlen und saubere Daten zu extrahieren. Sie vereinfacht das Web-Scraping durch die Handhabung von JavaScript-Rendering, Anti-Bot-Maßnahmen und Daten-Parsing. Ideal für das Sammeln von strukturierten Inhalten wie Markdown oder Text zum Trainieren von LLM-KI-Modellen oder für Retrieval-Augmented Generation (RAG)-Systeme, bietet sie eine hohe Erfolgsquote und ein einfaches Pay-as-you-go-Preismodell.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

instantapi VS Webcrawlerapi — Kerndaten
KerndateninstantapiWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusDatenextraktionDatenextraktion
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienDatenextraktion · API · Lead-Generierung · AutomatisierungDatenextraktion · API · Automatisierung
Added14.08.202502.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

instantapi

instantapi ist ein revolutionärer, KI-gesteuerter Web-Scraping-Dienst, der für Einzelpersonen und Unternehmen entwickelt wurde, die einfach nur Daten ohne Komplexität wollen. Frustriert von teuren, langsamen und unzuverlässigen Scrapern? instantapi bietet eine optimierte Lösung. Durch den Einsatz fortschrittlicher künstlicher Intelligenz kann es die Struktur einer Webseite verstehen und die gewünschten Informationen mit einer einfachen API-Anfrage extrahieren. Dies eliminiert die Notwendigkeit, benutzerdefinierte Parser zu schreiben und zu warten, sich mit IP-Sperren auseinanderzusetzen oder CAPTCHAs zu lösen, sodass Sie sich auf die Nutzung der Daten konzentrieren können, nicht auf deren Beschaffung.

Die Plattform basiert auf einer Philosophie der Einfachheit, Geschwindigkeit und Erschwinglichkeit. Wie von zahlreichen Benutzern hervorgehoben, hebt sich instantapi von der Konkurrenz durch seine unglaubliche Intuitivität und Kosteneffizienz ab. Es kann komplexe Datenextraktionsaufgaben in Sekunden zu einem Bruchteil der Kosten anderer Dienste durchführen, was es zu einem leistungsstarken Werkzeug für Projekte jeder Größenordnung macht, von der Bestückung einer kleinen Verzeichnis-Website bis hin zur Durchführung groß angelegter Marktforschung.

Wie man instantapi verwendet

Die Verwendung von instantapi ist so konzipiert, dass sie auch für Personen mit minimaler technischer Erfahrung unkompliziert ist. Der Prozess umfasst in der Regel diese einfachen Schritte:

  1. Anmelden & API-Schlüssel erhalten: Erstellen Sie ein Konto auf der instantapi-Website, um auf Ihr persönliches Dashboard zuzugreifen und einen einzigartigen API-Schlüssel zu erhalten.
  2. Ihre Anfrage formulieren: Machen Sie einen einfachen API-Aufruf mit Ihrer bevorzugten Programmiersprache (wie Python, JavaScript) oder einem Tool wie cURL. Die Anfrage enthält normalerweise die Ziel-URL, die Sie scrapen möchten.
  3. Lassen Sie die KI die Arbeit machen: Im Gegensatz zu herkömmlichen Scrapern müssen Sie keine CSS-Selektoren oder XPath angeben. Die KI analysiert intelligent die Struktur der Webseite, um wichtige Datenpunkte automatisch zu identifizieren und zu extrahieren.
  4. Strukturierte Daten erhalten: Die API verarbeitet die Seite, handhabt alle Anti-Scraping-Maßnahmen im Hintergrund und gibt die extrahierten Informationen in einem sauberen, strukturierten JSON-Format zurück, das sofort in Ihrer Anwendung, Datenbank oder Ihrem Analysewerkzeug verwendet werden kann.

Kernfunktionen von instantapi

  • KI-gestützte Datenextraktion: Das Herzstück des Dienstes. Die KI identifiziert und extrahiert automatisch relevante Datenfelder wie Produktnamen, Preise, Beschreibungen, Bewertungen und Kontaktinformationen ohne manuelle Konfiguration.
  • Einfache API-Schnittstelle: Eine saubere und einfach zu bedienende API, die nur eine Ziel-URL benötigt, um mit dem Scraping zu beginnen.
  • Behandelt dynamische Websites: Kann moderne Websites scrapen, die stark auf JavaScript zum Laden von Inhalten angewiesen sind, und gewährleistet so eine umfassende Datenerfassung.
  • Integrierte Proxy-Rotation & CAPTCHA-Lösung: Verwaltet automatisch Proxys und umgeht CAPTCHAs, um hohe Erfolgsraten zu gewährleisten und zu verhindern, dass Ihre IP blockiert wird.
  • Strukturierte JSON-Ausgabe: Liefert saubere, gut organisierte Daten im JSON-Format, was die Integration in jeden Workflow oder jede Anwendung erleichtert.
  • Hohe Geschwindigkeit und Skalierbarkeit: Auf Leistung ausgelegt, sodass Sie einzelne Seiten in Sekunden scrapen oder effizient auf Tausende von Seiten skalieren können.

Anwendungsfälle für instantapi

Die Vielseitigkeit von instantapi macht es für eine breite Palette von Anwendungen geeignet:

  • Marktforschung: Sammeln Sie Preise, Produktmerkmale und Kundenbewertungen von Wettbewerbern, um einen Wettbewerbsvorteil zu erzielen.
  • Lead-Generierung: Extrahieren Sie Kontaktdaten aus Online-Verzeichnissen, professionellen Netzwerken und Unternehmenswebsites, um Vertriebspipelines aufzubauen.
  • E-Commerce: Überwachen Sie Produktpreise, Lagerverfügbarkeit und Neuankömmlinge auf mehreren E-Commerce-Plattformen.
  • Content-Aggregation: Bestücken Sie automatisch Verzeichnis-Websites, Nachrichten-Aggregatoren oder Jobbörsen mit frischen, relevanten Inhalten.
  • Finanzdatenanalyse: Sammeln Sie Daten von Finanznachrichten-Websites, Börsenportalen oder Immobilienangeboten zur Analyse und Modellierung.

Vorteile von instantapi

Basierend auf Benutzerfeedback und seinem Design bietet instantapi erhebliche Vorteile:

  • Unübertroffene Einfachheit: Seine intuitive Natur ermöglicht es Benutzern, ohne steile Lernkurve sofort loszulegen.
  • Extreme Kosteneffizienz: Ein Pay-as-you-go-Modell mit sehr niedrigen Kosten pro Anfrage macht es sowohl für kleine Projekte als auch für große Operationen zugänglich.
  • Außergewöhnliche Geschwindigkeit: Liefert Daten in Sekunden und beschleunigt die Datenerfassungsworkflows drastisch.
  • Hohe Zuverlässigkeit: Extrahiert erfolgreich vollständige Daten, wo andere, komplexere Tools oft versagen.
  • Reaktionsschneller Entwickler-Support: Benutzer loben durchweg den schnellen, geduldigen und hilfreichen Support des Entwicklungsteams, oft über Discord.

Preise und Pläne

instantapi arbeitet mit einem äußerst wettbewerbsfähigen und transparenten Preismodell, hauptsächlich Pay-as-you-go. Dies stellt sicher, dass Sie nur für das bezahlen, was Sie nutzen, was es unglaublich budgetfreundlich macht.

  • Kostenlose Testversion/Credits: Neue Benutzer erhalten in der Regel kostenlose Credits, um die vollen Fähigkeiten der API ohne Verpflichtung zu testen.
  • Pay-As-You-Go: Die Hauptpreisstruktur basiert auf niedrigen Kosten pro erfolgreichem API-Aufruf. Wie von Benutzern erwähnt, kann ein einzelner Scrape nur einen Bruchteil eines Cents kosten (z. B. 0,002 $), was im Vergleich zu Wettbewerbern massive Einsparungen bietet.
  • Mengenrabatte: Obwohl keine spezifischen Pläne detailliert sind, bieten solche Dienste oft gestaffelte Preise oder den Kauf von Massen-Credits an, die niedrigere Raten pro Anruf für Benutzer mit hohem Volumen bieten.

Dieses flexible Modell macht instantapi zu einer idealen Wahl für Startups, Entwickler und Unternehmen, die eine leistungsstarke Scraping-Lösung ohne die Last fester monatlicher Abonnements suchen.

Webcrawlerapi

Webcrawlerapi ist eine spezialisierte API, die entwickelt wurde, um den Prozess des Web-Crawlings und der Datenextraktion für Entwickler zu optimieren. In einer Zeit, in der Daten für das Training von großen Sprachmodellen (LLMs) und die Stromversorgung von KI-Anwendungen entscheidend sind, stellt das traditionelle Web-Scraping erhebliche Herausforderungen dar. Dazu gehören der Umgang mit dynamischen, durch JavaScript gerenderten Inhalten, das Umgehen ausgeklügelter Anti-Bot-Systeme, die Verwaltung von Proxys und die Bereinigung von unordentlichem HTML in nutzbare Formate. Webcrawlerapi abstrahiert all diese Komplexitäten und bietet eine einfache, aber leistungsstarke Schnittstelle, um jede Website in eine strukturierte Datenquelle zu verwandeln.

Mit einer gemeldeten Erfolgsquote von 98 % und einer durchschnittlichen Crawling-Zeit von nur 6 Sekunden ist der Dienst auf Effizienz und Zuverlässigkeit ausgelegt. Er ermöglicht es Entwicklern, sich auf ihre Kernanwendungslogik zu konzentrieren, anstatt sich in den Feinheiten des Aufbaus und der Wartung einer skalierbaren Crawling-Infrastruktur zu verlieren. Durch die Bereitstellung eines Links können Entwickler saubere, gebrauchsfertige Inhalte in Formaten wie Markdown, Text oder rohem HTML erhalten, was es perfekt für die Einspeisung in KI-Modell-Trainingspipelines oder Wissensdatenbanken für RAG-Systeme macht.

Wie man Webcrawlerapi verwendet

Die Integration von Webcrawlerapi in Ihr Projekt ist unkompliziert gestaltet. Der Prozess umfasst in der Regel nur wenige Codezeilen. Zuerst müssen Sie sich auf der Webcrawlerapi-Website anmelden, um Ihren einzigartigen API-Zugangsschlüssel zu erhalten. Dann können Sie eine ihrer bereitgestellten Client-Bibliotheken für gängige Programmiersprachen verwenden.

In einer NodeJS-Umgebung würden Sie beispielsweise mit der Installation der Client-Bibliothek über npm beginnen: npm i webcrawlerapi-js. Dann importieren Sie in Ihrem Code die Bibliothek, erstellen eine neue Client-Instanz mit Ihrem API-Schlüssel und rufen die `crawl`-Methode auf. Diese Methode akzeptiert Parameter wie die Ziel-`url`, den gewünschten `scrape_type` (z. B. 'markdown') und optionale Limits wie `items_limit`. Die API kümmert sich dann im Hintergrund um den gesamten Crawling-Prozess und gibt eine strukturierte JSON-Antwort mit den extrahierten Daten zurück. Ähnliche einfache Integrationsmuster sind für Python, PHP und .NET verfügbar, was es für eine breite Palette von Entwicklern zugänglich macht.

Kernfunktionen von Webcrawlerapi

  • Automatische Link-Handhabung: Die API entdeckt und verwaltet intelligent alle internen Links auf einer Website und gewährleistet so ein umfassendes Crawling, während Duplikate automatisch behandelt und URLs bereinigt werden.
  • Fortschrittliches JavaScript-Rendering: Sie rendert effektiv dynamische, clientseitige Inhalte mit einem stabilen und robusten System und überwindet die Instabilität und Speicherprobleme, die oft mit Tools wie Puppeteer oder Playwright verbunden sind.
  • Robuste Anti-Bot-Umgehung: Webcrawlerapi verfügt über integrierte Mechanismen zum Umgang mit CAPTCHAs, IP-Sperren, Ratenbegrenzungen und anderen gängigen Anti-Bot-Abwehrmaßnahmen, was eine hohe Erfolgsquote gewährleistet.
  • Automatische Datenbereinigung: Sie enthält leistungsstarke Parsing-Regeln, um rohes, komplexes HTML in saubere, strukturierte Formate wie Markdown oder reinen Text umzuwandeln, was Entwicklern erhebliche Nachbearbeitungszeit spart.
  • Skalierbare Infrastruktur: Der Dienst verwaltet eine verteilte Infrastruktur von Crawlern und Proxys, sodass Sie Ihre Datenextraktionsbemühungen von wenigen Seiten auf Millionen skalieren können, ohne sich um die zugrunde liegende Hardware oder das Netzwerkmanagement kümmern zu müssen.
  • Entwicklerfreundliche API & SDKs: Bietet eine einfache API und offizielle Client-Bibliotheken für wichtige Sprachen wie NodeJS, Python, PHP und .NET, komplett mit klarer Dokumentation.

Anwendungsfälle für Webcrawlerapi

Webcrawlerapi ist vielseitig und kann auf eine Vielzahl von datenintensiven Aufgaben angewendet werden. Ihre Hauptanwendungsfälle drehen sich um KI und Datenanalyse.

  • Datensammlung für LLM-Training: Systematisches Crawlen von Websites, Blogs und Foren, um große Mengen hochwertiger, domänenspezifischer Textdaten für das Training oder die Feinabstimmung benutzerdefinierter großer Sprachmodelle zu sammeln.
  • Retrieval-Augmented Generation (RAG): Aufbau und Pflege aktueller Wissensdatenbanken für RAG-Systeme. Crawlen Sie Produktdokumentationen, Hilfezentren oder Nachrichtenseiten, um LLMs genaue Echtzeitinformationen zur Beantwortung von Benutzeranfragen bereitzustellen.
  • Marktforschung und Wettbewerbsanalyse: Automatisches Extrahieren von Produktdetails, Preisinformationen, Kundenbewertungen und Marketinginhalten von Wettbewerber-Websites, um strategische Einblicke zu gewinnen.
  • Content-Aggregation: Betreiben Sie Nachrichtenaggregatoren, Jobbörsen oder Immobilien-Listing-Websites, indem Sie regelmäßig mehrere Quellen crawlen und die Daten auf einer einheitlichen Plattform konsolidieren.

Vorteile von Webcrawlerapi

Der Hauptvorteil von Webcrawlerapi liegt in seiner Einfachheit und Effizienz. Es ermöglicht Entwicklungsteams, die gesamte Web-Crawling-Infrastruktur und den Wartungsaufwand auszulagern. Dies bedeutet eine schnellere Markteinführung für datengesteuerte Produkte. Die hohe Erfolgsquote (98 %) und die robusten Anti-Bot-Funktionen gewährleisten zuverlässige Datenpipelines. Darüber hinaus ist das transparente Pay-as-you-go-Preismodell äußerst kosteneffektiv, da Sie nur für erfolgreiche Anfragen bezahlen und so das mit Abonnements oder dem Aufbau einer internen Lösung verbundene Risiko und den Overhead eliminieren.

Preise und Pläne

Webcrawlerapi verwendet ein unkompliziertes und transparentes 'Pay-for-Usage'-Preismodell, das Abonnements und versteckte Gebühren vollständig vermeidet. Die Kosten werden basierend auf der Anzahl der Seiten berechnet, die Sie jeden Monat erfolgreich crawlen. Der Service umfasst unbegrenzte Crawl-Jobs, ein unbegrenztes und automatisch verwaltetes Proxy-Netzwerk sowie E-Mail-Support in seinem Preis. Für eine klare Kostenschätzung bietet die Website einen Rechner. Als Beispiel würde das Crawlen von 10.000 Seiten in einem Monat etwa 20 $ kosten. Dieses Modell ist ideal für Projekte jeder Größe, von kleinen Experimenten bis hin zu großen Datenoperationen, da die Kosten direkt mit der Nutzung skalieren. Die Plattform ermöglicht es den Nutzern auch, den Dienst vor dem Kauf auszuprobieren, wahrscheinlich durch eine kostenlose Guthabenzuweisung für neue Konten.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
DatenextraktionAPIAutomatisierung
Nur instantapi
Lead-Generierung
Nur Webcrawlerapi
Keine verifizierten Daten

Tags

Gemeinsam
APIAutomatisierungDatenextraktion
Nur instantapi
Data MiningEntwicklerwerkzeugeLead-GenerierungMarktforschungNo-CodeWeb Scraping
Nur Webcrawlerapi
DatenerfassungDaten-ScrapingEntwicklerwerkzeugJavaScript-RenderingLLM-TrainingRetrieval-Augmentierte GenerierungWeb-Crawling

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur instantapi
Keine verifizierten Daten
Nur Webcrawlerapi
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

instantapi

Nicht verifiziert

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
5.4K
Ø Besuchsdauer
0:46
Seiten pro Besuch
1.95
Absprungrate
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

Suchbegriffe

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

instantapi

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
191
Likes
201

Webcrawlerapi

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
182
Likes
179

instantapi vs Webcrawlerapi · Vergleichs-FAQ

What do instantapi and Webcrawlerapi have in common?
Both tools are listed under Datenextraktion、API、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are instantapi and Webcrawlerapi free?
Listed pricing models: instantapi — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between instantapi and Webcrawlerapi?
The primary listed category is Datenextraktion for instantapi, and Datenextraktion for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche