

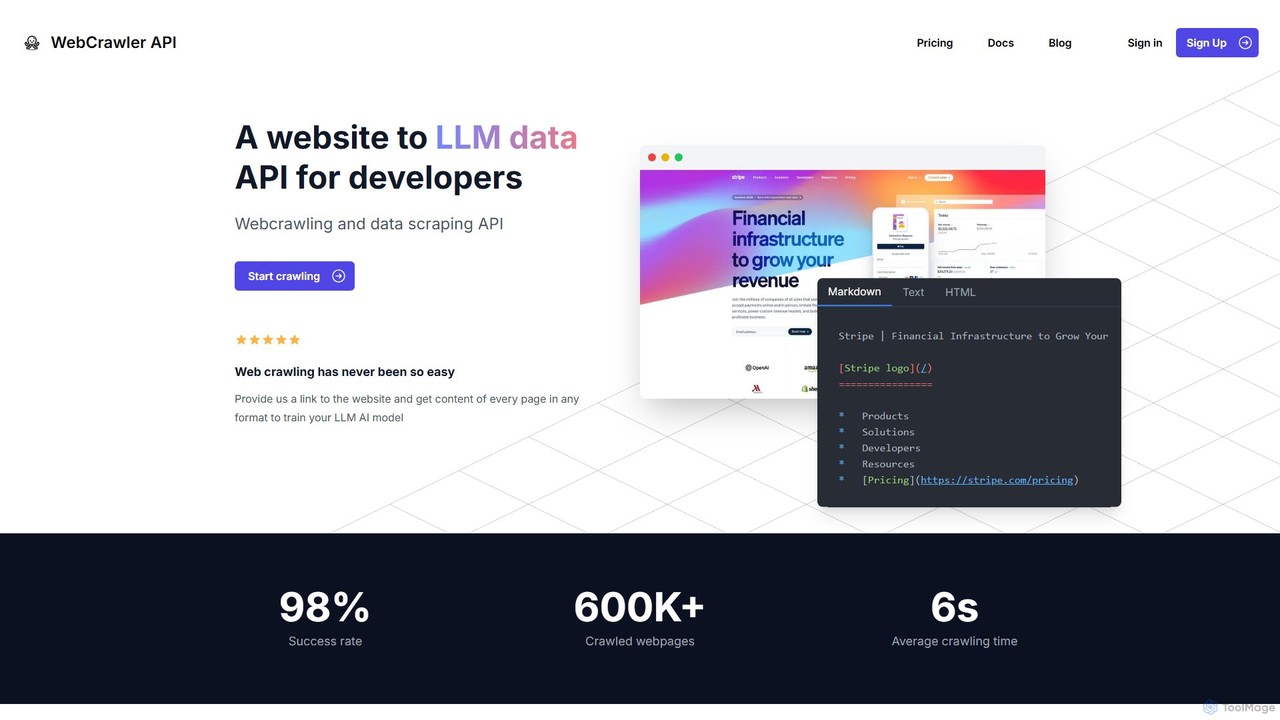
Webcrawlerapi Overview
Webcrawlerapi ist eine spezialisierte API, die entwickelt wurde, um den Prozess des Web-Crawlings und der Datenextraktion für Entwickler zu optimieren. In einer Zeit, in der Daten für das Training von großen Sprachmodellen (LLMs) und die Stromversorgung von KI-Anwendungen entscheidend sind, stellt das traditionelle Web-Scraping erhebliche Herausforderungen dar. Dazu gehören der Umgang mit dynamischen, durch JavaScript gerenderten Inhalten, das Umgehen ausgeklügelter Anti-Bot-Systeme, die Verwaltung von Proxys und die Bereinigung von unordentlichem HTML in nutzbare Formate. Webcrawlerapi abstrahiert all diese Komplexitäten und bietet eine einfache, aber leistungsstarke Schnittstelle, um jede Website in eine strukturierte Datenquelle zu verwandeln.
Mit einer gemeldeten Erfolgsquote von 98 % und einer durchschnittlichen Crawling-Zeit von nur 6 Sekunden ist der Dienst auf Effizienz und Zuverlässigkeit ausgelegt. Er ermöglicht es Entwicklern, sich auf ihre Kernanwendungslogik zu konzentrieren, anstatt sich in den Feinheiten des Aufbaus und der Wartung einer skalierbaren Crawling-Infrastruktur zu verlieren. Durch die Bereitstellung eines Links können Entwickler saubere, gebrauchsfertige Inhalte in Formaten wie Markdown, Text oder rohem HTML erhalten, was es perfekt für die Einspeisung in KI-Modell-Trainingspipelines oder Wissensdatenbanken für RAG-Systeme macht.
Wie man Webcrawlerapi verwendet
Die Integration von Webcrawlerapi in Ihr Projekt ist unkompliziert gestaltet. Der Prozess umfasst in der Regel nur wenige Codezeilen. Zuerst müssen Sie sich auf der Webcrawlerapi-Website anmelden, um Ihren einzigartigen API-Zugangsschlüssel zu erhalten. Dann können Sie eine ihrer bereitgestellten Client-Bibliotheken für gängige Programmiersprachen verwenden.
In einer NodeJS-Umgebung würden Sie beispielsweise mit der Installation der Client-Bibliothek über npm beginnen: npm i webcrawlerapi-js. Dann importieren Sie in Ihrem Code die Bibliothek, erstellen eine neue Client-Instanz mit Ihrem API-Schlüssel und rufen die `crawl`-Methode auf. Diese Methode akzeptiert Parameter wie die Ziel-`url`, den gewünschten `scrape_type` (z. B. 'markdown') und optionale Limits wie `items_limit`. Die API kümmert sich dann im Hintergrund um den gesamten Crawling-Prozess und gibt eine strukturierte JSON-Antwort mit den extrahierten Daten zurück. Ähnliche einfache Integrationsmuster sind für Python, PHP und .NET verfügbar, was es für eine breite Palette von Entwicklern zugänglich macht.
Kernfunktionen von Webcrawlerapi
- Automatische Link-Handhabung: Die API entdeckt und verwaltet intelligent alle internen Links auf einer Website und gewährleistet so ein umfassendes Crawling, während Duplikate automatisch behandelt und URLs bereinigt werden.
- Fortschrittliches JavaScript-Rendering: Sie rendert effektiv dynamische, clientseitige Inhalte mit einem stabilen und robusten System und überwindet die Instabilität und Speicherprobleme, die oft mit Tools wie Puppeteer oder Playwright verbunden sind.
- Robuste Anti-Bot-Umgehung: Webcrawlerapi verfügt über integrierte Mechanismen zum Umgang mit CAPTCHAs, IP-Sperren, Ratenbegrenzungen und anderen gängigen Anti-Bot-Abwehrmaßnahmen, was eine hohe Erfolgsquote gewährleistet.
- Automatische Datenbereinigung: Sie enthält leistungsstarke Parsing-Regeln, um rohes, komplexes HTML in saubere, strukturierte Formate wie Markdown oder reinen Text umzuwandeln, was Entwicklern erhebliche Nachbearbeitungszeit spart.
- Skalierbare Infrastruktur: Der Dienst verwaltet eine verteilte Infrastruktur von Crawlern und Proxys, sodass Sie Ihre Datenextraktionsbemühungen von wenigen Seiten auf Millionen skalieren können, ohne sich um die zugrunde liegende Hardware oder das Netzwerkmanagement kümmern zu müssen.
- Entwicklerfreundliche API & SDKs: Bietet eine einfache API und offizielle Client-Bibliotheken für wichtige Sprachen wie NodeJS, Python, PHP und .NET, komplett mit klarer Dokumentation.
Anwendungsfälle für Webcrawlerapi
Webcrawlerapi ist vielseitig und kann auf eine Vielzahl von datenintensiven Aufgaben angewendet werden. Ihre Hauptanwendungsfälle drehen sich um KI und Datenanalyse.
- Datensammlung für LLM-Training: Systematisches Crawlen von Websites, Blogs und Foren, um große Mengen hochwertiger, domänenspezifischer Textdaten für das Training oder die Feinabstimmung benutzerdefinierter großer Sprachmodelle zu sammeln.
- Retrieval-Augmented Generation (RAG): Aufbau und Pflege aktueller Wissensdatenbanken für RAG-Systeme. Crawlen Sie Produktdokumentationen, Hilfezentren oder Nachrichtenseiten, um LLMs genaue Echtzeitinformationen zur Beantwortung von Benutzeranfragen bereitzustellen.
- Marktforschung und Wettbewerbsanalyse: Automatisches Extrahieren von Produktdetails, Preisinformationen, Kundenbewertungen und Marketinginhalten von Wettbewerber-Websites, um strategische Einblicke zu gewinnen.
- Content-Aggregation: Betreiben Sie Nachrichtenaggregatoren, Jobbörsen oder Immobilien-Listing-Websites, indem Sie regelmäßig mehrere Quellen crawlen und die Daten auf einer einheitlichen Plattform konsolidieren.
Vorteile von Webcrawlerapi
Der Hauptvorteil von Webcrawlerapi liegt in seiner Einfachheit und Effizienz. Es ermöglicht Entwicklungsteams, die gesamte Web-Crawling-Infrastruktur und den Wartungsaufwand auszulagern. Dies bedeutet eine schnellere Markteinführung für datengesteuerte Produkte. Die hohe Erfolgsquote (98 %) und die robusten Anti-Bot-Funktionen gewährleisten zuverlässige Datenpipelines. Darüber hinaus ist das transparente Pay-as-you-go-Preismodell äußerst kosteneffektiv, da Sie nur für erfolgreiche Anfragen bezahlen und so das mit Abonnements oder dem Aufbau einer internen Lösung verbundene Risiko und den Overhead eliminieren.
Preise und Pläne
Webcrawlerapi verwendet ein unkompliziertes und transparentes 'Pay-for-Usage'-Preismodell, das Abonnements und versteckte Gebühren vollständig vermeidet. Die Kosten werden basierend auf der Anzahl der Seiten berechnet, die Sie jeden Monat erfolgreich crawlen. Der Service umfasst unbegrenzte Crawl-Jobs, ein unbegrenztes und automatisch verwaltetes Proxy-Netzwerk sowie E-Mail-Support in seinem Preis. Für eine klare Kostenschätzung bietet die Website einen Rechner. Als Beispiel würde das Crawlen von 10.000 Seiten in einem Monat etwa 20 $ kosten. Dieses Modell ist ideal für Projekte jeder Größe, von kleinen Experimenten bis hin zu großen Datenoperationen, da die Kosten direkt mit der Nutzung skalieren. Die Plattform ermöglicht es den Nutzern auch, den Dienst vor dem Kauf auszuprobieren, wahrscheinlich durch eine kostenlose Guthabenzuweisung für neue Konten.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.1K
- 2026-1: 4.5K
- 2026-2: 4.0K
- 2026-3: 4.3K
- 2026-4: 5.6K
- 2026-5: 5.4K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten49.1%
- 🇩🇪Deutschland20.9%
- 🇮🇳Indien14.8%
- 🇻🇳Vietnam12.2%
- 🇦🇺Australien2.9%
Top keywords
| Keyword | Cost per click |
|---|---|
| better to save as an html or md file packing more information | $0.00 |
| data scraping law cases | $0.00 |
| firecrawl alternatives | $11.71 |
| llms txt generator online | $0.00 |
| submit website to chatgpt | $0.00 |
Webcrawlerapi Alternatives
UseScraper
UseScraper ist eine leistungsstarke Web-Crawler- und Scraper-API, die für Entwickler und KI-Anwendungen konzipiert wurde. Sie extrahiert effizient Daten von jeder Website und bietet vollständiges JavaScript-Rendering, eine automatisch skalierende Infrastruktur und saubere Ausgabeformate wie Markdown, ideal zur Einspeisung von Daten in LLMs wie ChatGPT.
Datenextraktion
Foxscrape
FoxScrape ist eine KI-gestützte Web-Scraping-REST-API für Entwickler. Es vereinfacht die Datenextraktion, indem es jede Website in strukturierte JSON-Daten umwandelt, unter Verwendung von Funktionen wie KI-gesteuertem Parsen aus einfachem Englisch, JavaScript-Rendering für dynamische Websites und automatischer Proxy-Rotation, um Blockaden zu verhindern.
Datenextraktion
instantapi
instantapi ist eine KI-gestützte Web-Scraping-API, die auf Einfachheit und Geschwindigkeit ausgelegt ist. Sie ermöglicht es Benutzern, strukturierte Daten von jeder Website mit einem einzigen API-Aufruf zu extrahieren, ohne dass komplexe Programmierung oder manuelle Einrichtung erforderlich ist. Ideal für Entwickler, Datenanalysten und Unternehmen, die eine schnelle, kostengünstige und zuverlässige Datenextraktion ohne den Aufwand herkömmlicher Web-Scraper benötigen.
Datenextraktion
Skrape
Skrape ist eine LLM-gestützte Web-Scraping-API, die entwickelt wurde, um jede Website in saubere, strukturierte und LLM-fähige Daten umzuwandeln. Es vereinfacht die Datenextraktion, indem es Webseiten in strukturiertes JSON oder sauberes Markdown konvertiert, was es ideal für KI-Training, RAG-Systeme und Datenanalyse macht. Mit Funktionen wie der Handhabung dynamischer Inhalte und intelligentem Crawling bietet Skrape eine zuverlässige Lösung für Entwickler und Unternehmen zur Automatisierung ihrer Datenerfassungspipelines.
Scraping
Isomeric
Isomeric ist eine KI-gestützte API, die unordentlichen, unstrukturierten Text aus beliebigen Quellen in saubere, strukturierte JSON-Daten umwandelt. Durch die Definition eines einfachen JSON-Schemas können Sie automatisch spezifische Informationen von Websites, juristischen Dokumenten, Kundensupport-Transkripten und mehr extrahieren und so Datenpipelines und Automatisierung optimieren.
DatenextraktionWebcrawlerapi Categories
Webcrawlerapi Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraper ist eine leistungsstarke Web-Crawler- und Scraper-API, die für Entwickler und KI-Anwendungen konzipiert wurde. Sie extrahiert effizient Daten von jeder Website und bietet vollständiges JavaScript-Rendering, eine automatisch skalierende Infrastruktur und saubere Ausgabeformate wie Markdown, ideal zur Einspeisung von Daten in LLMs wie ChatGPT.
DatenextraktionSkrape
Skrape ist eine LLM-gestützte Web-Scraping-API, die entwickelt wurde, um jede Website in saubere, strukturierte und LLM-fähige Daten umzuwandeln. Es vereinfacht die Datenextraktion, indem es Webseiten in strukturiertes JSON oder sauberes Markdown konvertiert, was es ideal für KI-Training, RAG-Systeme und Datenanalyse macht. Mit Funktionen wie der Handhabung dynamischer Inhalte und intelligentem Crawling bietet Skrape eine zuverlässige Lösung für Entwickler und Unternehmen zur Automatisierung ihrer Datenerfassungspipelines.
ScrapingFoxscrape
FoxScrape ist eine KI-gestützte Web-Scraping-REST-API für Entwickler. Es vereinfacht die Datenextraktion, indem es jede Website in strukturierte JSON-Daten umwandelt, unter Verwendung von Funktionen wie KI-gesteuertem Parsen aus einfachem Englisch, JavaScript-Rendering für dynamische Websites und automatischer Proxy-Rotation, um Blockaden zu verhindern.
Datenextraktion
Scrapeless
Ein KI-gestütztes Web-Scraping-Toolkit für Entwickler und Unternehmen. Es bietet eine Suite von Tools, einschließlich eines Scraping-Browsers, einer universellen Scraping-API und einer Deep-SERP-API, um mühelos öffentliche Webdaten in großem Maßstab zu extrahieren. Es ist spezialisiert auf die Umgehung von Anti-Bot-Maßnahmen und liefert strukturierte Daten für E-Commerce, Marktforschung und das Training von KI-Modellen, mit einem Fokus auf Zuverlässigkeit und Benutzerfreundlichkeit.
Scraping
URLtoText
URLtoText ist ein KI-gestütztes Tool, das sauberen, strukturierten Text von jeder Website oder PDF extrahiert. Es entfernt intelligent Anzeigen, Seitenleisten und anderen Ballast, um nur den Hauptinhalt bereitzustellen. Mit JavaScript-Rendering, privaten IP-Proxys und einer Entwickler-API ist es für Forscher, Entwickler und Unternehmen konzipiert, die eine zuverlässige Datenextraktion von statischen und dynamischen Webseiten benötigen.
Content-Kuration
Apify
Apify ist eine Full-Stack-Web-Scraping- und Automatisierungsplattform, die es Entwicklern ermöglicht, Datenextraktionstools, sogenannte 'Actors', zu erstellen, bereitzustellen und zu veröffentlichen. Sie bietet einen riesigen Marktplatz mit vorgefertigten Scrapern für beliebte Websites wie Google Maps, Instagram und TikTok sowie eine robuste Cloud-Infrastruktur zur Erstellung benutzerdefinierter Lösungen. Mit Unterstützung für Python und JavaScript, Open-Source-Bibliotheken und nahtlosen Integrationen vereinfacht Apify die Erfassung von Webdaten in jedem Maßstab.
Datenerfassung
CapSolver
CapSolver ist ein KI-gestützter, automatischer CAPTCHA-Lösungsdienst, der für Entwickler und RPA-Experten entwickelt wurde. Er bietet eine hochpräzise, schnelle und skalierbare Lösung zur Umgehung verschiedener CAPTCHA-Typen, einschließlich reCAPTCHA, hCaptcha und FunCaptcha, und ermöglicht nahtloses Web-Scraping, Datenextraktion und Prozessautomatisierung.
Datenextraktion
WebScraping.AI
WebScraping.AI ist eine fortschrittliche API für Entwickler, die das Web-Scraping mit KI vereinfacht. Sie bietet rotierende Proxys, JavaScript-Rendering und Geotargeting, um Blockaden zu umgehen und auf dynamische Inhalte zuzugreifen. Ihre Kernstärke liegt in den LLM-gestützten Werkzeugen, die unstrukturierte Daten extrahieren, Zusammenfassungen erstellen und Fragen direkt von Webseiten beantworten können, was die Datenerfassung für jedes Projekt optimiert.
Datenextraktion
AgentQL
AgentQL ist ein Entwickler-Toolset, das LLMs und KI-Agenten mit dem Web verbindet. Es verwendet eine KI-gestützte Abfragesprache, um strukturierte Daten robust zu extrahieren und Web-Interaktionen zu automatisieren, und dient als leistungsstarke, selbstheilende Alternative zu fragilen XPath- und CSS-Selektoren.
LLM
Crawleo
Eine leistungsstarke Zwei-in-Eins-API für KI-Systeme, die Echtzeit-Websuche und Deep Crawling bietet. Sie liefert strukturierte, KI-fähige Daten (JSON, Markdown) von jeder Website, umgeht Anti-Bot-Maßnahmen und gewährleistet den Datenschutz durch eine strikte Null-Datenspeicherungs-Richtlinie. Entwickelt für RAG-Pipelines, LLMs und Automatisierungs-Workflows.
Datenabruf
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Jsonify
Jsonify ist eine KI-gestützte Plattform, die für Unternehmen entwickelt wurde, um Daten aus verschiedenen Dokumenten und Webquellen automatisch zu finden, zu extrahieren und in ein sauberes JSON-Format zu strukturieren. Sie optimiert Datenverarbeitungs-Workflows, eliminiert manuelle Eingaben und ermöglicht eine nahtlose Integration über ihre robuste API.
Datenanalyse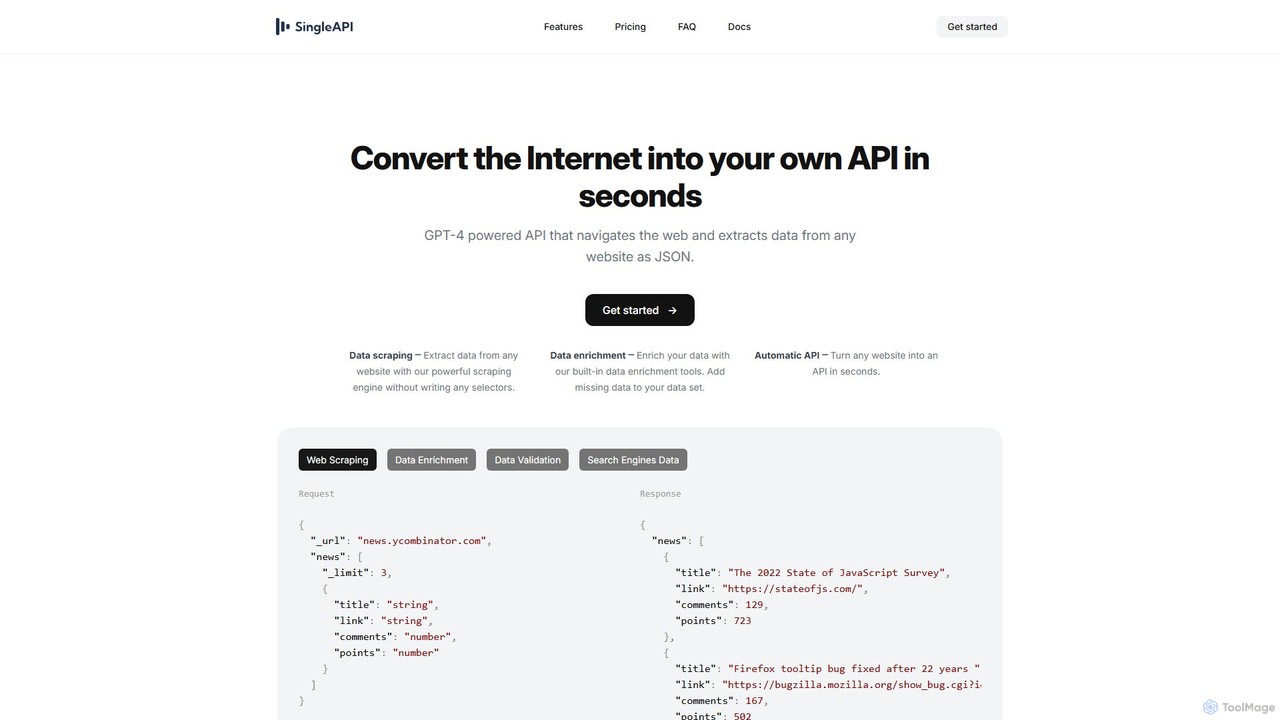
SingleAPI
SingleAPI ist ein GPT-4-gestütztes Tool, das jede Website sofort in eine strukturierte JSON-API umwandelt. Es vereinfacht Web-Scraping, Datenextraktion und Datenanreicherung, ohne dass Code oder Selektoren geschrieben werden müssen, und ermöglicht Benutzern den mühelosen Zugriff auf Webdaten für verschiedene Anwendungen.
Web Scraping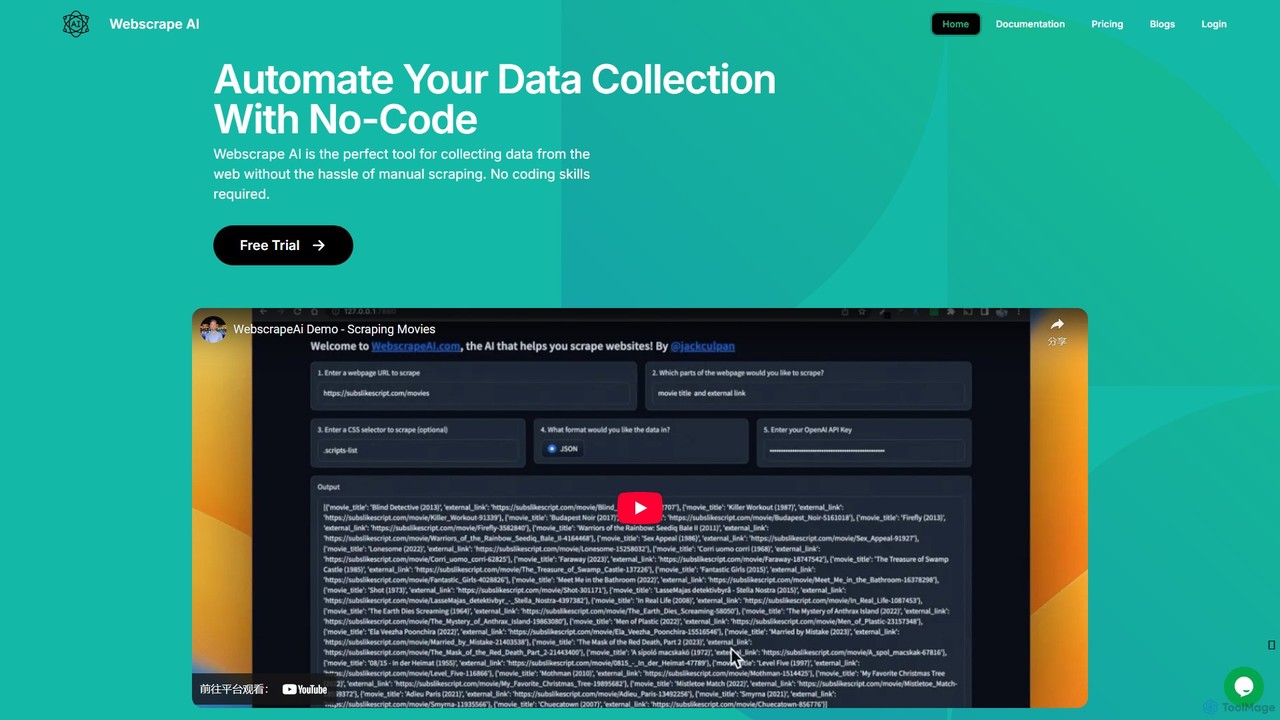
webscrapeai
WebscrapeAI ist eine No-Code, KI-gestützte Plattform zur Automatisierung der Web-Datenerfassung. Geben Sie einfach eine URL an und spezifizieren Sie die benötigten Daten, und die KI übernimmt den gesamten Scraping-Prozess. Es unterstützt dynamische Websites, Massen-Scraping, Proxy-Integration und bietet eine API für Entwickler, was die Datenextraktion schnell, genau und für jeden zugänglich macht.
Web Scraping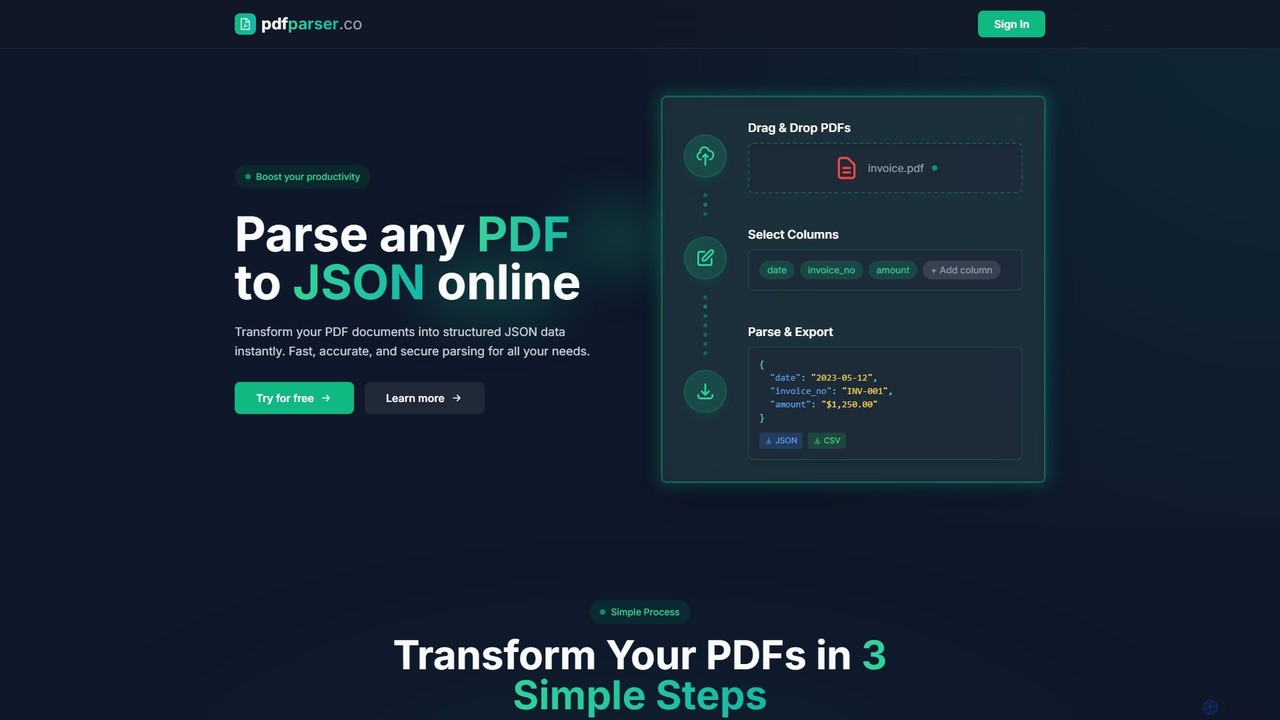
pdfparser
Ein KI-gestützter API-Dienst für Entwickler und Unternehmen, um PDF-Dokumente mühelos zu parsen. Er extrahiert Text, Tabellen und strukturierte Daten aus jedem PDF, einschließlich gescannter Dateien, und liefert eine saubere, maschinenlesbare JSON-Ausgabe, um Datenextraktions-Workflows zu automatisieren.
Automatisierung
Webcrawlerapi Comments (0)
Sign in to comment.
AnmeldenNo comments yet.