ToolMage
Anmelden

AI TOOL COMPARISON

Skrape vs UseScraper

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Skrape Produktübersicht

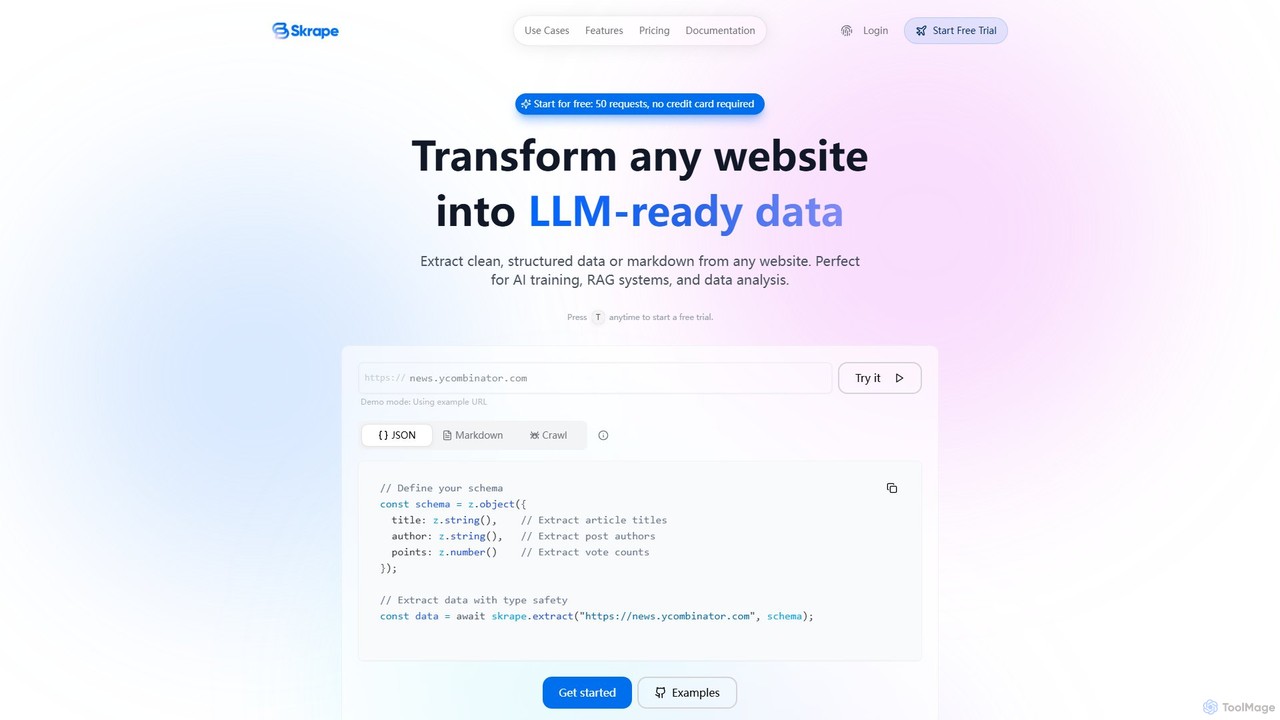
Skrape ist eine LLM-gestützte Web-Scraping-API, die entwickelt wurde, um jede Website in saubere, strukturierte und LLM-fähige Daten umzuwandeln. Es vereinfacht die Datenextraktion, indem es Webseiten in strukturiertes JSON oder sauberes Markdown konvertiert, was es ideal für KI-Training, RAG-Systeme und Datenanalyse macht. Mit Funktionen wie der Handhabung dynamischer Inhalte und intelligentem Crawling bietet Skrape eine zuverlässige Lösung für Entwickler und Unternehmen zur Automatisierung ihrer Datenerfassungspipelines.

Preview

UseScraper Produktübersicht

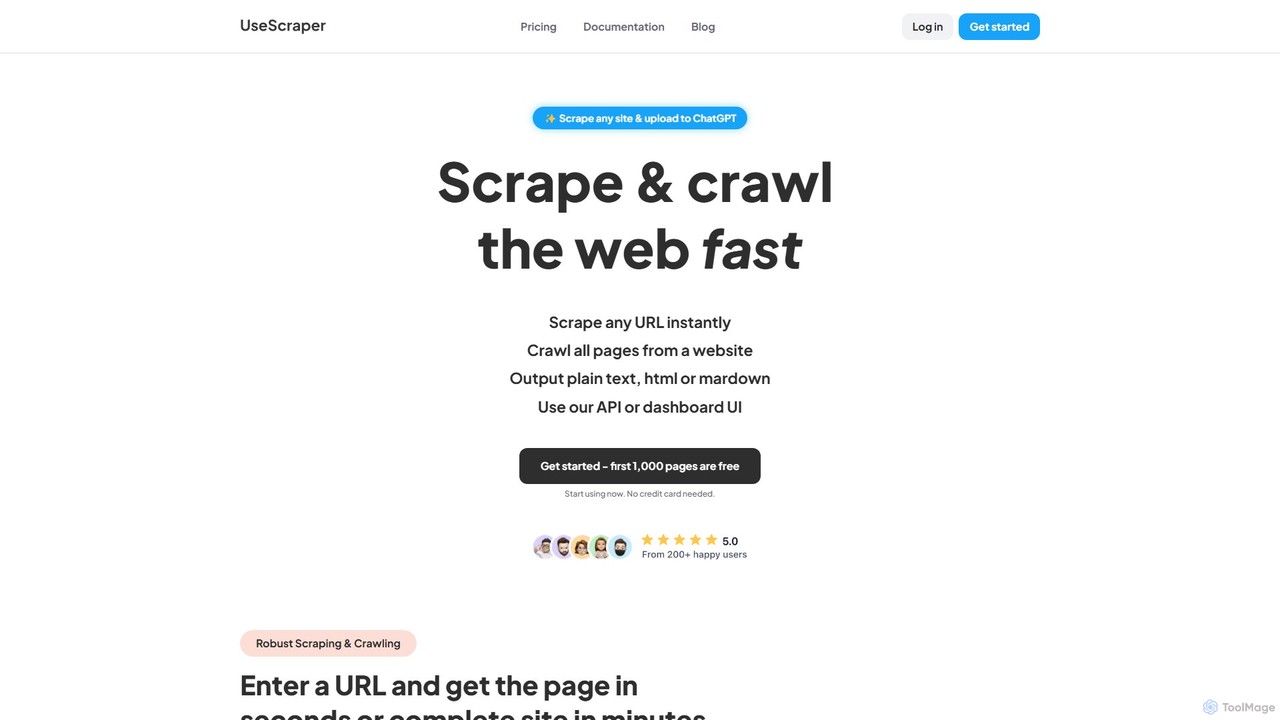
UseScraper ist eine leistungsstarke Web-Crawler- und Scraper-API, die für Entwickler und KI-Anwendungen konzipiert wurde. Sie extrahiert effizient Daten von jeder Website und bietet vollständiges JavaScript-Rendering, eine automatisch skalierende Infrastruktur und saubere Ausgabeformate wie Markdown, ideal zur Einspeisung von Daten in LLMs wie ChatGPT.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Skrape VS UseScraper — Kerndaten
KerndatenSkrapeUseScraper
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusScrapingDatenextraktion
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienScraping · API · AutomatisierungDatenextraktion · API · Automatisierung
Added12.08.202505.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Skrape

Skrape ist eine leistungsstarke und entwicklerfreundliche Web-Scraping-API, die große Sprachmodelle (LLMs) nutzt, um saubere, strukturierte Daten von jeder Website zu extrahieren. Es wurde speziell entwickelt, um den Prozess der Datenerfassung für moderne KI-Anwendungen wie Retrieval-Augmented Generation (RAG)-Systeme, Modell-Feinabstimmung und tiefgehende Datenanalyse zu optimieren. Der Dienst kann komplexe Webseiten, einschließlich solcher mit dynamisch durch JavaScript gerenderten Inhalten, in sauber formatiertes Markdown oder strukturierte JSON-Daten gemäß einem benutzerdefinierten Schema umwandeln.

Die Kernphilosophie von Skrape ist die Vereinfachung der Webdatenextraktion. Anstatt sich mit komplexem HTML-Parsing, Anti-Scraping-Maßnahmen oder der Verwaltung von Proxys zu befassen, können Entwickler einen einfachen API-Aufruf verwenden, um die benötigten Daten zu erhalten. Die Plattform ist auf Zuverlässigkeit und Skalierbarkeit ausgelegt und stellt sicher, dass Benutzer immer frische Echtzeitdaten ohne Caching erhalten.

Wie man Skrape verwendet

Die Verwendung von Skrape ist unkompliziert und auf eine nahtlose Entwicklererfahrung ausgelegt. Hier ist der typische Arbeitsablauf:

  1. Anmelden & API-Schlüssel erhalten: Erstellen Sie zunächst ein Konto auf der Skrape-Website. Sie können mit einer kostenlosen Testversion beginnen, die 50 Credits ohne Kreditkarte bietet. Nach der Anmeldung erhalten Sie einen API-Schlüssel von Ihrem Dashboard.
  2. Authentifizierung: Alle API-Anfragen müssen mit einem Bearer-Token authentifiziert werden. Sie müssen Ihren API-Schlüssel in den `Authorization`-Header Ihrer Anfragen einfügen (z. B. `Authorization: Bearer YOUR_API_KEY`).
  3. Einen Endpunkt wählen: Skrape bietet je nach Bedarf mehrere API-Endpunkte:
    • /api/markdown: Konvertiert eine einzelne Webseite in sauberes Markdown.
    • /api/extract: Extrahiert strukturierte JSON-Daten von einer Webseite basierend auf einem von Ihnen bereitgestellten Zod-Schema. Dies ermöglicht eine typsichere, präzise Datenextraktion.
    • /api/crawl: Crawlt eine gesamte Website und folgt Links, um effizient Daten von mehreren Seiten zu sammeln.
  4. Den API-Aufruf tätigen: Verwenden Sie Ihren bevorzugten HTTP-Client oder die offiziellen SDKs von Skrape (verfügbar für Node.js und Python), um Anfragen an die API zu stellen. Um beispielsweise Daten zu extrahieren, würden Sie Ihre gewünschte Datenstruktur als Schema definieren und diese zusammen mit der Ziel-URL an den `/api/extract`-Endpunkt übergeben.
  5. Die Ergebnisse verarbeiten: Die API gibt die extrahierten Daten in dem von Ihnen angeforderten Format zurück – entweder sauberes Markdown oder strukturiertes JSON. Der Dienst unterstützt auch die Verarbeitung von Hintergrundjobs für langlaufende Aufgaben, und Sie können den Jobstatus über den `/api/get-job`-Endpunkt überprüfen.

Kernfunktionen von Skrape

  • LLM-gestützte intelligente Extraktion: Definieren Sie Ihre gewünschte Datenstruktur mit einem Schema, und die KI extrahiert und formatiert die Informationen intelligent in strukturiertes JSON.
  • Intelligentes Crawling: Crawlt automatisch ganze Websites, auch solche ohne Sitemaps, und respektiert dabei die `robots.txt`-Regeln, um ethisches Scraping zu gewährleisten.
  • Handhabung dynamischer Inhalte: Unterstützt vollständig das JavaScript-Rendering und kann so Single Page Applications (SPAs) und andere dynamische Inhalte verarbeiten, mit denen herkömmliche Scraper Schwierigkeiten haben.
  • Saubere Markdown-Konvertierung: Konvertiert jede Webseite in perfekt formatiertes, sauberes Markdown, ideal für RAG-Systeme und Wissensdatenbanken.
  • API-Aktionen: Kann Aktionen auf einer Seite ausführen, wie das Klicken von Schaltflächen, Scrollen und Warten auf das Laden bestimmter Inhalte vor der Extraktion.
  • Echtzeitdaten: Skrape speichert keine Inhalte zwischen, sodass Sie immer die frischesten, aktuellsten Daten direkt von der Quelle erhalten.
  • Entwicklerfreundlich: Bietet offizielle SDKs für Node.js und Python, umfassende API-Dokumentation und ein konsistentes Fehlerbehandlungsformat.

Anwendungsfälle für Skrape

Skrape ist vielseitig und kann für eine breite Palette von Datenerfassungsaufgaben eingesetzt werden:

  • RAG-fähige Datenerfassung: Wandeln Sie Websites mit automatischer Metadatenextraktion in saubere, strukturierte Datensätze um, die perfekt für die Einspeisung in Retrieval-Augmented Generation-Anwendungen geeignet sind.
  • KI-Trainingsdaten-Pipeline: Automatisieren Sie die Sammlung vielfältiger, hochwertiger, mehrsprachiger Datensätze für die Feinabstimmung von Sprachmodellen und anderen KI-Anwendungen.
  • Aufbau von Wissensdatenbanken: Erstellen Sie umfassende Wissensdatenbanken, indem Sie technische Dokumentationen, API-Referenzen, Tutorials und Forschungsarbeiten aus mehreren Quellen scrapen.
  • KI-Inhaltsüberwachung: Bleiben Sie auf dem Laufenden über die neuesten Branchentrends, indem Sie KI-bezogene Nachrichten, Forschungsergebnisse und technische Blogs verfolgen und sammeln.
  • Model-Evaluierungsdaten: Sammeln Sie reale Daten aus verschiedenen Domänen, um die Leistung Ihrer LLMs zu bewerten und zu vergleichen.

Vorteile von Skrape

Skrape bietet einen erheblichen Vorteil gegenüber herkömmlichen Web-Scraping-Methoden. Seine Hauptvorteile sind Einfachheit, Leistung und Zuverlässigkeit. Der API-First-Ansatz abstrahiert die Komplexität des Web-Scrapings und ermöglicht es Entwicklern, sich auf die Nutzung der Daten zu konzentrieren. Die Verwendung von LLMs für die Extraktion bietet eine überlegene Genauigkeit und Flexibilität im Vergleich zu anfälligen CSS-Selektor-basierten Methoden. Darüber hinaus spart die Fähigkeit, dynamische Inhalte zu verarbeiten und saubere, gebrauchsfertige Ausgaben bereitzustellen, erheblich Entwicklungszeit und -aufwand.

Preise und Pläne

Skrape bietet ein transparentes, auf Credits basierendes Preismodell, das mit Ihren Anforderungen wächst.

  • Kostenlose Testversion: Starten Sie mit 50 kostenlosen Credits, um den Dienst zu testen. Keine Kreditkarte erforderlich.
  • Starter-Plan: 15 $/Monat für 3.000 Credits. Ideal für kleine Projekte und einzelne Entwickler.
  • Growth-Plan: 50 $/Monat für 10.000 Credits. Geeignet für wachsende Teams mit erhöhtem Nutzungsbedarf. Beinhaltet priorisierten Support.
  • Pro-Plan: 250 $/Monat für 50.000 Credits. Konzipiert für Unternehmen und Teams mit hohem Volumenbedarf. Beinhaltet priorisierten Support und benutzerdefinierte Ratenbegrenzungen.

Credit-Nutzung:

  • HTML zu Markdown: 1 Credit pro Seite
  • Web-Crawling: 1 Credit pro Seite
  • KI-Datenextraktion: 5 Credits pro Seite

UseScraper

UseScraper ist ein robuster und skalierbarer Web-Scraping- und Crawling-Dienst, der über eine einfache, aber leistungsstarke API bereitgestellt wird. Er wurde von Grund auf für Geschwindigkeit und Zuverlässigkeit entwickelt und ermöglicht es Benutzern, Daten von jeder Webseite in Sekunden zu extrahieren oder ganze Websites in Minuten zu crawlen. Dieses Tool ist besonders wertvoll für Entwickler, Datenwissenschaftler und Unternehmen, die Webdaten für Marktforschung, Lead-Generierung, Preisüberwachung oder zum Trainieren von KI-Modellen sammeln müssen.

Die Plattform ist darauf ausgelegt, die Komplexität des modernen Webs zu bewältigen. Sie verwendet einen echten Chrome-Browser für das vollständige JavaScript-Rendering, um sicherzustellen, dass Inhalte auf dynamischen Single-Page-Anwendungen (SPAs) genau erfasst werden. Diese Fähigkeit macht sie vielen herkömmlichen Scrapern überlegen, die nur statisches HTML abrufen. Die Ausgabe kann in verschiedenen Formaten geliefert werden, einschließlich rohem HTML, reinem Text und vor allem sauberem, gut strukturiertem Markdown, das das ideale Format für die Verarbeitung durch KI-Systeme und große Sprachmodelle (LLMs) ist.

Wie man UseScraper verwendet

Die Verwendung von UseScraper ist für Entwickler aller Erfahrungsstufen unkompliziert. Der Prozess umfasst einige einfache Schritte:

  1. Anmelden: Erstellen Sie ein kostenloses Konto, um loszulegen. Es ist keine Kreditkarte erforderlich, und Sie erhalten 1.000 kostenlose Seiten-Scrapes und 25 $ Guthaben bei der Anmeldung.
  2. Wählen Sie Ihr Werkzeug: Entscheiden Sie, ob Sie eine einzelne URL scrapen oder eine ganze Website crawlen möchten. UseScraper bietet dedizierte APIs für beide Aufgaben (Scraper API und Crawler API).
  3. Machen Sie eine API-Anfrage: Verwenden Sie Ihre bevorzugte Programmiersprache (Python, JavaScript, C# usw.), um eine Anfrage an den UseScraper-API-Endpunkt zu stellen. Sie müssen nur die Ziel-URL(s) angeben.
  4. Optionen konfigurieren: Sie können Ihre Anfrage mit erweiterten Optionen anpassen, z. B. dem Ausschließen bestimmter URLs oder CSS-Elemente, dem Einrichten von Webhooks für Benachrichtigungen und der Auswahl Ihres gewünschten Ausgabeformats (Markdown, Text oder HTML).
  5. Daten empfangen: Der gescrapte Inhalt wird in der API-Antwort zurückgegeben. Bei größeren Crawl-Jobs werden die Ergebnisse in einem dedizierten Datenspeicher gespeichert, auf den über die API zugegriffen werden kann. Sie können auch festlegen, dass Daten automatisch ablaufen, um den Speicher zu verwalten.

Kernfunktionen von UseScraper

  • Scraper- & Crawler-APIs: Dedizierte APIs zum sofortigen Scrapen einzelner Seiten oder zum Crawlen von Tausenden von Seiten einer Website.
  • Vollständiges JavaScript-Rendering: Verwendet einen echten Chrome-Browser, um JavaScript zu rendern, und gewährleistet so eine genaue Datenextraktion von dynamischen Websites und SPAs.
  • KI-fähige Markdown-Ausgabe: Bietet eine saubere, strukturierte Markdown-Ausgabe, die sich perfekt für den Einsatz in KI-Anwendungen, RAG-Systemen und zur Wissensvermittlung an LLMs wie ChatGPT eignet. Reiner Text und HTML sind ebenfalls verfügbar.
  • Hochgeschwindigkeits-, skalierbare Infrastruktur: Basiert auf einer automatisch skalierenden Infrastruktur, die superschnelles, paralleles Scrapen und Crawlen von Tausenden von Seiten pro Minute ermöglicht.
  • Erweiterte Crawling-Steuerung: Zu den Funktionen gehören das Crawlen mehrerer Websites in einem einzigen Job, das Ausschließen bestimmter URLs mit Glob-Mustern und das Entfernen von sich wiederholenden Inhalten (wie Kopf-/Fußzeilen) mit CSS-Selektoren.
  • Automatische Proxy-Rotation: (Demnächst verfügbar) Rotiert automatisch Proxys, um Anti-Scraping-Maßnahmen zu umgehen und Ratenbegrenzungen zu verhindern, was hohe Erfolgsraten gewährleistet.
  • Webhook-Benachrichtigungen: Erhalten Sie Echtzeit-Updates über den Status und den Abschluss Ihrer Crawl-Jobs über Webhooks.
  • Integrierter Datenspeicher: Gescrapte Daten werden in einem über die API zugänglichen Datenspeicher gespeichert, mit Optionen zum Festlegen des automatischen Ablaufs der Daten.

Anwendungsfälle für UseScraper

UseScraper ist vielseitig und kann für eine breite Palette von Datenextraktionsaufgaben eingesetzt werden:

  • KI-Modelltraining: Scrapen Sie große Mengen an Webinhalten, um Datensätze für das Training von maschinellen Lernmodellen zu erstellen oder eine Wissensdatenbank für die Retrieval-Augmented Generation (RAG) mit LLMs aufzubauen.
  • Markt- und Wettbewerbsanalyse: Sammeln Sie Produktinformationen, Preise, Bewertungen und Nachrichten von Wettbewerber-Websites, um die Geschäftsstrategie zu informieren.
  • Lead-Generierung: Extrahieren Sie Kontaktdaten und Geschäftsinformationen aus Online-Verzeichnissen und beruflichen Netzwerken.
  • Content-Aggregation: Betreiben Sie Nachrichtenportale, Jobbörsen oder Immobilien-Listing-Websites, indem Sie automatisch Daten aus mehreren Quellen sammeln.
  • SEO und Marketing: Überwachen Sie Suchmaschinen-Rankings, verfolgen Sie Markenerwähnungen und analysieren Sie Backlink-Profile durch das Crawlen von SERPs und Websites.

Vorteile von UseScraper

UseScraper zeichnet sich durch seinen Fokus auf Leistung, Kompatibilität mit dem modernen Web und Entwicklererfahrung aus. Zu seinen Hauptvorteilen gehören die Fähigkeit, JavaScript-lastige Websites mühelos zu handhaben, die Bereitstellung einer sauberen, auf KI zugeschnittenen Markdown-Ausgabe und seine skalierbare Hochgeschwindigkeitsarchitektur. Das flexible Preismodell, einschließlich einer großzügigen kostenlosen Stufe, macht es für Projekte jeder Größe zugänglich, von kleinen Skripten bis hin zu großen Unternehmensdatenoperationen.

Preise und Pläne

UseScraper bietet eine transparente und skalierbare Preisstruktur:

  • Pay-as-you-go-Plan: 0 $/Monat. Sie zahlen nur für das, was Sie nutzen, zu einem Satz von 1 $ pro 1.000 Webseiten. Dieser Plan umfasst 10 gleichzeitige Jobs, Scraper- & Crawler-APIs, JavaScript-Rendering und ist perfekt für kleinere Projekte. Die ersten 1.000 Seiten sind kostenlos.
  • Pro-Plan: 99 $/Monat, zuzüglich Nutzungskosten von 1 $ pro 1.000 Webseiten. Dieser Plan ist für groß angelegte Operationen konzipiert und umfasst alles aus dem kostenlosen Plan sowie unbegrenzte gleichzeitige Jobs, das Crawlen unbegrenzter Seiten pro Website, erweiterte Proxys (demnächst verfügbar) und priorisierten Support.

Neue Benutzer erhalten bei der Anmeldung 25 $ kostenloses Guthaben, was einen soliden Ausgangspunkt für Tests und Entwicklung bietet.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
APIAutomatisierung
Nur Skrape
Scraping
Nur UseScraper
Datenextraktion

Tags

Gemeinsam
APIAutomatisierungDatenerfassungDatenextraktionMarkdownRetrieval-Augmentierte GenerierungWeb Scraping
Nur Skrape
KI-TrainingEntwicklerwerkzeugdynamische InhalteJSONGroßes Sprachmodell
Nur UseScraper
KI-DatenChatGPTEntwicklerwerkzeugeJavaScript-RenderingWeb-Crawler

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Skrape
Keine verifizierten Daten
Nur UseScraper
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Skrape

Nicht verifiziert

UseScraper

Nicht verifiziert

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Skrape

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
166
Likes
153

UseScraper

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
188
Likes
166

Skrape vs UseScraper · Vergleichs-FAQ

What do Skrape and UseScraper have in common?
Both tools are listed under API、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Skrape and UseScraper free?
Listed pricing models: Skrape — Freemium; UseScraper — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Skrape and UseScraper?
The primary listed category is Scraping for Skrape, and Datenextraktion for UseScraper. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche