Skrape
Scraping
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Scraping
Datenextraktion
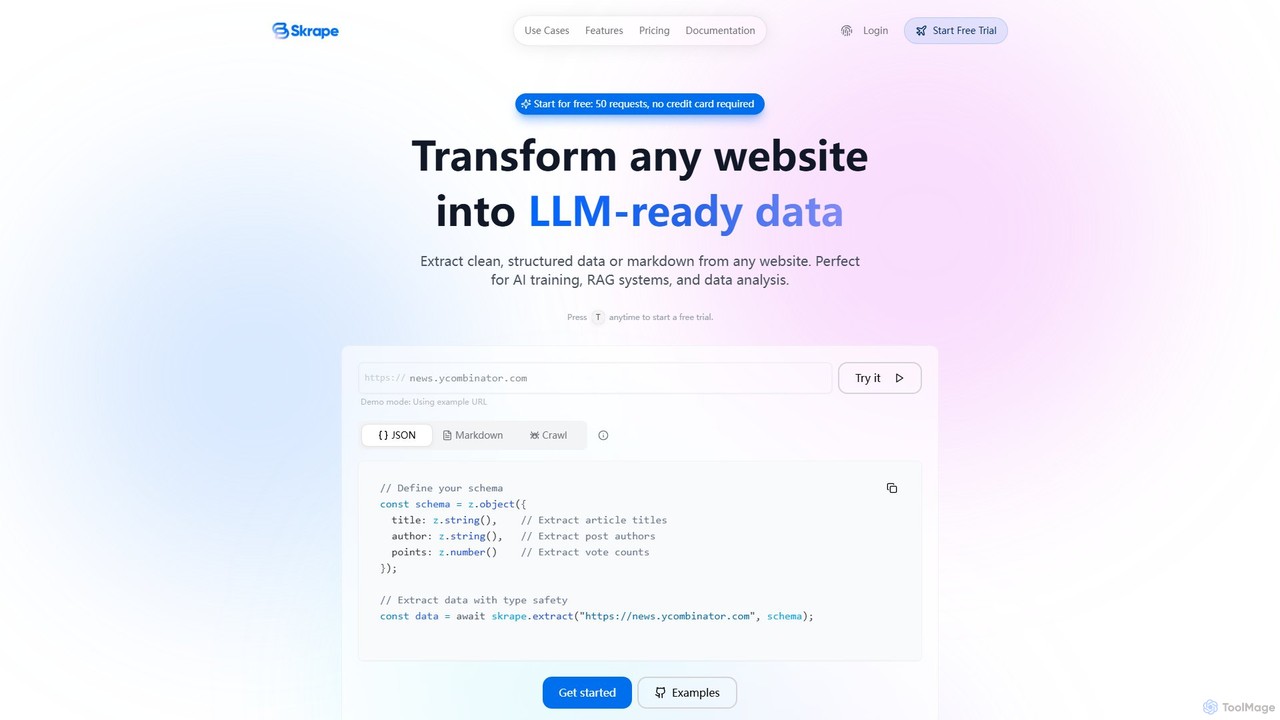
Skrape ist eine LLM-gestützte Web-Scraping-API, die entwickelt wurde, um jede Website in saubere, strukturierte und LLM-fähige Daten umzuwandeln. Es vereinfacht die Datenextraktion, indem es Webseiten in strukturiertes JSON oder sauberes Markdown konvertiert, was es ideal für KI-Training, RAG-Systeme und Datenanalyse macht. Mit Funktionen wie der Handhabung dynamischer Inhalte und intelligentem Crawling bietet Skrape eine zuverlässige Lösung für Entwickler und Unternehmen zur Automatisierung ihrer Datenerfassungspipelines.
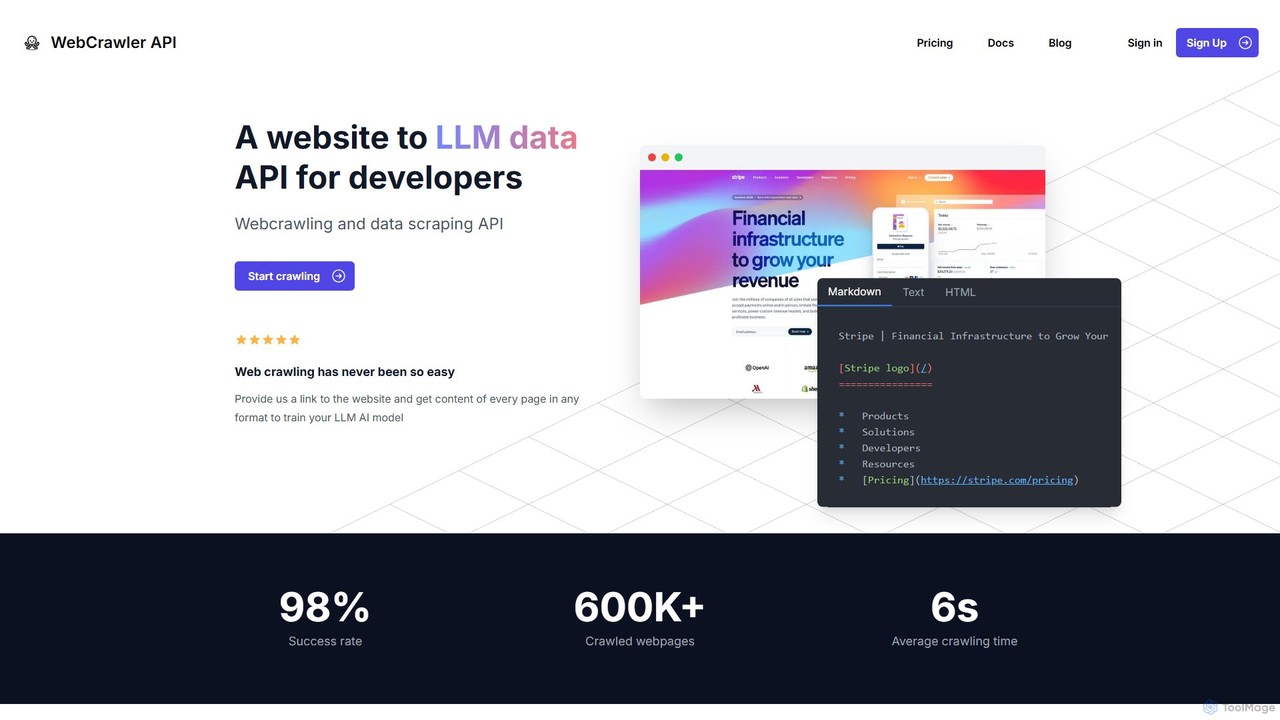
Webcrawlerapi ist eine leistungsstarke API für Entwickler, um mühelos Websites zu crawlen und saubere Daten zu extrahieren. Sie vereinfacht das Web-Scraping durch die Handhabung von JavaScript-Rendering, Anti-Bot-Maßnahmen und Daten-Parsing. Ideal für das Sammeln von strukturierten Inhalten wie Markdown oder Text zum Trainieren von LLM-KI-Modellen oder für Retrieval-Augmented Generation (RAG)-Systeme, bietet sie eine hohe Erfolgsquote und ein einfaches Pay-as-you-go-Preismodell.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Kerndaten | Skrape | Webcrawlerapi |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Scraping | Datenextraktion |
| Zielgruppen und Rollen | Nicht verifiziert | Nicht verifiziert |
| Kategorien | Scraping · API · Automatisierung | Datenextraktion · API · Automatisierung |
| Added | 12.08.2025 | 02.08.2025 |
| Aktualisiert | 19.11.2026 | 19.11.2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Skrape ist eine leistungsstarke und entwicklerfreundliche Web-Scraping-API, die große Sprachmodelle (LLMs) nutzt, um saubere, strukturierte Daten von jeder Website zu extrahieren. Es wurde speziell entwickelt, um den Prozess der Datenerfassung für moderne KI-Anwendungen wie Retrieval-Augmented Generation (RAG)-Systeme, Modell-Feinabstimmung und tiefgehende Datenanalyse zu optimieren. Der Dienst kann komplexe Webseiten, einschließlich solcher mit dynamisch durch JavaScript gerenderten Inhalten, in sauber formatiertes Markdown oder strukturierte JSON-Daten gemäß einem benutzerdefinierten Schema umwandeln.
Die Kernphilosophie von Skrape ist die Vereinfachung der Webdatenextraktion. Anstatt sich mit komplexem HTML-Parsing, Anti-Scraping-Maßnahmen oder der Verwaltung von Proxys zu befassen, können Entwickler einen einfachen API-Aufruf verwenden, um die benötigten Daten zu erhalten. Die Plattform ist auf Zuverlässigkeit und Skalierbarkeit ausgelegt und stellt sicher, dass Benutzer immer frische Echtzeitdaten ohne Caching erhalten.
Die Verwendung von Skrape ist unkompliziert und auf eine nahtlose Entwicklererfahrung ausgelegt. Hier ist der typische Arbeitsablauf:
/api/markdown: Konvertiert eine einzelne Webseite in sauberes Markdown./api/extract: Extrahiert strukturierte JSON-Daten von einer Webseite basierend auf einem von Ihnen bereitgestellten Zod-Schema. Dies ermöglicht eine typsichere, präzise Datenextraktion./api/crawl: Crawlt eine gesamte Website und folgt Links, um effizient Daten von mehreren Seiten zu sammeln.Skrape ist vielseitig und kann für eine breite Palette von Datenerfassungsaufgaben eingesetzt werden:
Skrape bietet einen erheblichen Vorteil gegenüber herkömmlichen Web-Scraping-Methoden. Seine Hauptvorteile sind Einfachheit, Leistung und Zuverlässigkeit. Der API-First-Ansatz abstrahiert die Komplexität des Web-Scrapings und ermöglicht es Entwicklern, sich auf die Nutzung der Daten zu konzentrieren. Die Verwendung von LLMs für die Extraktion bietet eine überlegene Genauigkeit und Flexibilität im Vergleich zu anfälligen CSS-Selektor-basierten Methoden. Darüber hinaus spart die Fähigkeit, dynamische Inhalte zu verarbeiten und saubere, gebrauchsfertige Ausgaben bereitzustellen, erheblich Entwicklungszeit und -aufwand.
Skrape bietet ein transparentes, auf Credits basierendes Preismodell, das mit Ihren Anforderungen wächst.
Credit-Nutzung:
Webcrawlerapi ist eine spezialisierte API, die entwickelt wurde, um den Prozess des Web-Crawlings und der Datenextraktion für Entwickler zu optimieren. In einer Zeit, in der Daten für das Training von großen Sprachmodellen (LLMs) und die Stromversorgung von KI-Anwendungen entscheidend sind, stellt das traditionelle Web-Scraping erhebliche Herausforderungen dar. Dazu gehören der Umgang mit dynamischen, durch JavaScript gerenderten Inhalten, das Umgehen ausgeklügelter Anti-Bot-Systeme, die Verwaltung von Proxys und die Bereinigung von unordentlichem HTML in nutzbare Formate. Webcrawlerapi abstrahiert all diese Komplexitäten und bietet eine einfache, aber leistungsstarke Schnittstelle, um jede Website in eine strukturierte Datenquelle zu verwandeln.
Mit einer gemeldeten Erfolgsquote von 98 % und einer durchschnittlichen Crawling-Zeit von nur 6 Sekunden ist der Dienst auf Effizienz und Zuverlässigkeit ausgelegt. Er ermöglicht es Entwicklern, sich auf ihre Kernanwendungslogik zu konzentrieren, anstatt sich in den Feinheiten des Aufbaus und der Wartung einer skalierbaren Crawling-Infrastruktur zu verlieren. Durch die Bereitstellung eines Links können Entwickler saubere, gebrauchsfertige Inhalte in Formaten wie Markdown, Text oder rohem HTML erhalten, was es perfekt für die Einspeisung in KI-Modell-Trainingspipelines oder Wissensdatenbanken für RAG-Systeme macht.
Die Integration von Webcrawlerapi in Ihr Projekt ist unkompliziert gestaltet. Der Prozess umfasst in der Regel nur wenige Codezeilen. Zuerst müssen Sie sich auf der Webcrawlerapi-Website anmelden, um Ihren einzigartigen API-Zugangsschlüssel zu erhalten. Dann können Sie eine ihrer bereitgestellten Client-Bibliotheken für gängige Programmiersprachen verwenden.
In einer NodeJS-Umgebung würden Sie beispielsweise mit der Installation der Client-Bibliothek über npm beginnen: npm i webcrawlerapi-js. Dann importieren Sie in Ihrem Code die Bibliothek, erstellen eine neue Client-Instanz mit Ihrem API-Schlüssel und rufen die `crawl`-Methode auf. Diese Methode akzeptiert Parameter wie die Ziel-`url`, den gewünschten `scrape_type` (z. B. 'markdown') und optionale Limits wie `items_limit`. Die API kümmert sich dann im Hintergrund um den gesamten Crawling-Prozess und gibt eine strukturierte JSON-Antwort mit den extrahierten Daten zurück. Ähnliche einfache Integrationsmuster sind für Python, PHP und .NET verfügbar, was es für eine breite Palette von Entwicklern zugänglich macht.
Webcrawlerapi ist vielseitig und kann auf eine Vielzahl von datenintensiven Aufgaben angewendet werden. Ihre Hauptanwendungsfälle drehen sich um KI und Datenanalyse.
Der Hauptvorteil von Webcrawlerapi liegt in seiner Einfachheit und Effizienz. Es ermöglicht Entwicklungsteams, die gesamte Web-Crawling-Infrastruktur und den Wartungsaufwand auszulagern. Dies bedeutet eine schnellere Markteinführung für datengesteuerte Produkte. Die hohe Erfolgsquote (98 %) und die robusten Anti-Bot-Funktionen gewährleisten zuverlässige Datenpipelines. Darüber hinaus ist das transparente Pay-as-you-go-Preismodell äußerst kosteneffektiv, da Sie nur für erfolgreiche Anfragen bezahlen und so das mit Abonnements oder dem Aufbau einer internen Lösung verbundene Risiko und den Overhead eliminieren.
Webcrawlerapi verwendet ein unkompliziertes und transparentes 'Pay-for-Usage'-Preismodell, das Abonnements und versteckte Gebühren vollständig vermeidet. Die Kosten werden basierend auf der Anzahl der Seiten berechnet, die Sie jeden Monat erfolgreich crawlen. Der Service umfasst unbegrenzte Crawl-Jobs, ein unbegrenztes und automatisch verwaltetes Proxy-Netzwerk sowie E-Mail-Support in seinem Preis. Für eine klare Kostenschätzung bietet die Website einen Rechner. Als Beispiel würde das Crawlen von 10.000 Seiten in einem Monat etwa 20 $ kosten. Dieses Modell ist ideal für Projekte jeder Größe, von kleinen Experimenten bis hin zu großen Datenoperationen, da die Kosten direkt mit der Nutzung skalieren. Die Plattform ermöglicht es den Nutzern auch, den Dienst vor dem Kauf auszuprobieren, wahrscheinlich durch eine kostenlose Guthabenzuweisung für neue Konten.
Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.
Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
Nicht verifiziert
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.