

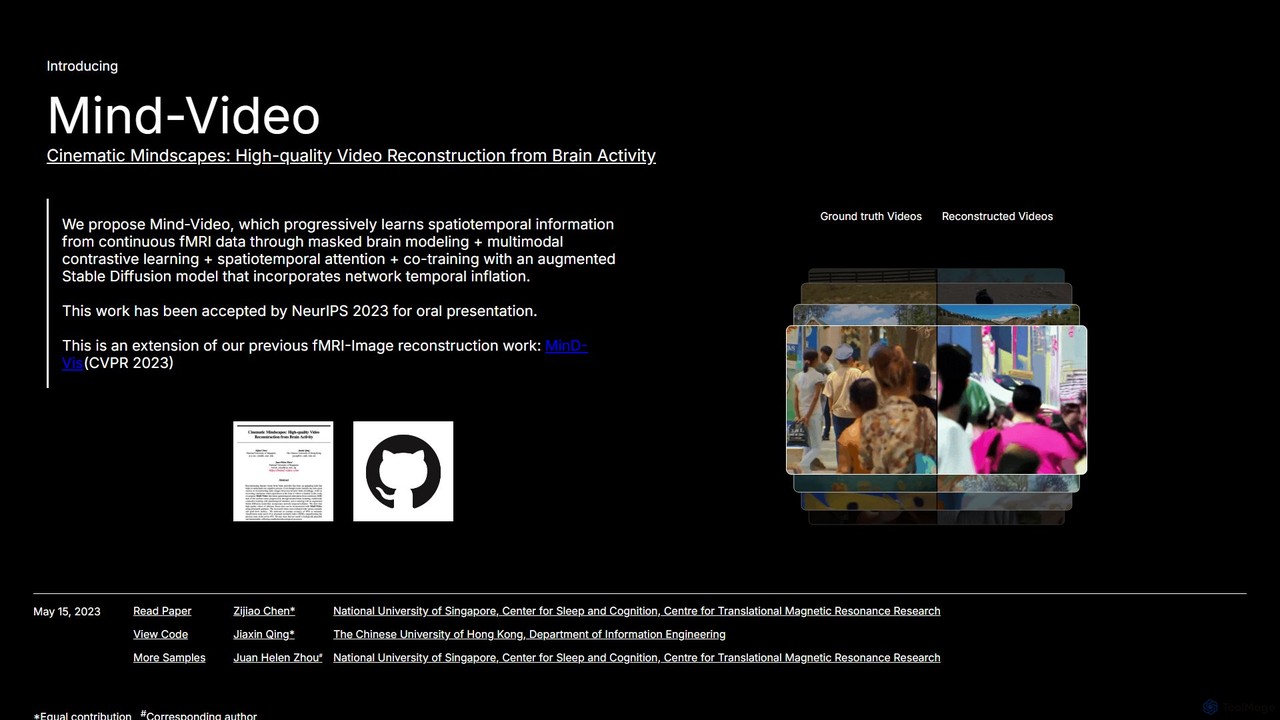
Mind-Video Overview
Mind-Video ist ein bahnbrechendes Forschungsframework, das von Forschern der National University of Singapore und der Chinese University of Hong Kong entwickelt wurde. Es steht an der Spitze der Neurowissenschaften und der künstlichen Intelligenz und demonstriert die Fähigkeit, hochwertige, kontinuierliche Videos aus nicht-invasiven funktionellen Magnetresonanztomographie-Daten (fMRT) zu rekonstruieren. Dieses Projekt erweitert frühere Arbeiten zur Rekonstruktion statischer Bilder (MinD-Vis), indem es die komplexen Herausforderungen der Dekodierung dynamischer visueller Erlebnisse aus Gehirnsignalen angeht.
Der Kern von Mind-Video ist eine innovative Zwei-Modul-Pipeline. Das erste Modul ist ein fMRT-Encoder, der schrittweise räumlich-zeitliche Informationen aus der Gehirnaktivität lernt. Es verwendet fortschrittliche Techniken wie maskiertes Gehirn-Modellieren, multimodales kontrastives Lernen und räumlich-zeitliche Aufmerksamkeit, um sowohl das „Was“ als auch das „Wie“ der visuellen Wahrnehmung zu erfassen. Das zweite Modul ist ein erweitertes Stable Diffusion-Modell, das speziell für die Videogenerierung angepasst wurde und gemeinsam mit dem fMRT-Encoder trainiert wird, um die gelernten Gehirnmerkmale in lebendige Videoclips zu übersetzen. Diese entkoppelte Architektur ermöglicht ein flexibles und effizientes Training, das zu hochmodernen Ergebnissen führt.
Wie man Mind-Video verwendet
Mind-Video ist keine kommerzielle, gebrauchsfertige Anwendung, sondern ein Forschungsframework mit öffentlich verfügbarem Code. Es richtet sich an Forscher, Entwickler und Studenten in Bereichen wie der computergestützten Neurowissenschaft, KI und BCI. Um es zu verwenden, würde man typischerweise diese Schritte befolgen:
- Zugriff auf die Projektressourcen: Besuchen Sie die offizielle Mind-Video-Projektwebsite und navigieren Sie zum Abschnitt „Code anzeigen“, der normalerweise zu einem GitHub-Repository verlinkt.
- Einrichten der Umgebung: Klonen Sie das Repository und richten Sie die erforderliche Rechenumgebung ein. Dies beinhaltet die Installation spezifischer Python-Bibliotheken, Deep-Learning-Frameworks (wie PyTorch) und anderer in der Dokumentation erwähnter Abhängigkeiten.
- Vorbereiten des Datensatzes: Beschaffen Sie fMRT-Datensätze. Das Projekt selbst nutzte öffentliche Datensätze wie das Human Connectome Project (HCP) und einen spezifischen fMRT-Video-Datensatz. Benutzer müssten ihre eigenen oder öffentliche fMRT-Daten vorverarbeiten, um dem vom Modell geforderten Eingabeformat zu entsprechen.
- Trainieren des Modells: Befolgen Sie die bereitgestellten Skripte und Anweisungen, um die Zwei-Modul-Pipeline zu trainieren. Dies ist ein rechenintensiver Prozess, der leistungsstarke GPUs erfordert. Das Training erfolgt in Phasen: Zuerst wird der fMRT-Encoder trainiert, dann das Diffusionsmodell und schließlich werden sie gemeinsam feinabgestimmt.
- Ausführen der Inferenz: Sobald das Modell trainiert ist, verwenden Sie die Inferenzskripte, um neue fMRT-Daten einzugeben und die entsprechenden Videorekonstruktionen zu generieren.
Kernfunktionen von Mind-Video
- fMRT-zu-Video-Rekonstruktion: Die Hauptfunktion besteht darin, fMRT-Signale, die Blutflussänderungen im Gehirn erfassen, zu dekodieren und in dynamische Videoinhalte zu übersetzen.
- Entkoppelte Zwei-Modul-Pipeline: Verfügt über eine flexible Architektur mit einem fMRT-Encoder und einem erweiterten Stable Diffusion-Modell, die separat trainiert und dann für optimale Leistung gemeinsam feinabgestimmt werden können.
- Progressives räumlich-zeitliches Lernen: Verwendet ein mehrstufiges Lernschema, einschließlich maskiertem Gehirn-Modellieren und multimodalem kontrastivem Lernen, um schrittweise ein reichhaltiges Verständnis der Gehirnsignale über die Zeit aufzubauen.
- Hohe semantische Genauigkeit: Zeichnet sich durch die Rekonstruktion von Videos aus, die semantisch mit den ursprünglichen visuellen Reizen übereinstimmen und Bewegung, Szenendynamik und Objektkategorien mit hoher Wiedergabetreue erfassen.
- Biologisch plausibles und interpretierbares Modell: Die Aufmerksamkeitsmechanismen des Modells lassen sich auf bekannte Gehirnnetzwerke wie den visuellen Kortex und höhere kognitive Netzwerke abbilden und liefern wertvolle Einblicke in die neuronale Grundlage der visuellen Wahrnehmung.
- Open-Source-Forschung: Der Code und die Methoden sind öffentlich verfügbar und fördern weitere Forschung, Validierung und Innovation im Bereich der Gehirndekodierung.
Anwendungsfälle für Mind-Video
Die Anwendungen von Mind-Video liegen hauptsächlich in der Forschung und zukünftigen Technologien:
- Neurowissenschaft und Kognitionswissenschaft: Bietet ein leistungsstarkes Werkzeug zur Untersuchung, wie das Gehirn dynamische visuelle Informationen verarbeitet, repräsentiert und versteht. Es kann helfen, Theorien der visuellen Wahrnehmung und des Bewusstseins zu validieren.
- Fortschrittliche Gehirn-Computer-Schnittstellen (BCI): Ebnet den Weg für zukünftige BCIs, die es Personen mit schwerer Lähmung oder Kommunikationsstörungen ermöglichen könnten, komplexe Gedanken oder visuelle Erinnerungen auszudrücken.
- Medizinische Diagnostik: Langfristig könnten ähnliche Technologien potenziell genutzt werden, um die subjektiven visuellen Erlebnisse von Patienten mit neurologischen oder psychiatrischen Störungen zu verstehen, wie z. B. Halluzinationen bei Schizophrenie oder Sehstörungen nach einem Schlaganfall.
- Traum- und Vorstellungsforschung: Bietet einen potenziellen Weg zur Visualisierung subjektiver mentaler Inhalte wie Träume oder vorgestellte Szenen, ein langjähriges Ziel in Psychologie und Neurowissenschaft.
Vorteile von Mind-Video
- Hochmoderne Leistung: Übertrifft frühere Ansätze bei der Videorekonstruktion aus fMRT erheblich und erreicht eine Genauigkeit von 85 % in semantischen Metriken, eine Verbesserung von 45 % gegenüber dem bisherigen Stand der Technik.
- Wegweisende Innovation: Schließt erfolgreich die Lücke zwischen der Rekonstruktion statischer Bilder und dynamischer Videos aus der Gehirnaktivität, eine große technische und wissenschaftliche Herausforderung.
- Wissenschaftliche Erkenntnisse: Das Modell ist nicht nur eine „Black Box“; seine Interpretierbarkeit bietet wertvolle Daten für Neurowissenschaftler und bestätigt die hierarchische Verarbeitung visueller Informationen im Gehirn.
- Offen und kollaborativ: Durch die Bereitstellung des Codes fördert das Projekt eine kollaborative Forschungsumgebung, die es anderen ermöglicht, auf dieser bahnbrechenden Arbeit aufzubauen und sie zu erweitern.
Preise und Pläne
Mind-Video ist ein akademisches Forschungsprojekt und wird nicht als kommerzielles Produkt angeboten. Der Quellcode, das Forschungspapier und ergänzende Materialien sind für akademische und Forschungszwecke kostenlos verfügbar. Es gibt keine Preispläne, Abonnements oder Gebühren im Zusammenhang mit der Nutzung des Frameworks. Forscher können über die offizielle Website des Projekts und die zugehörigen Code-Repositories auf die erforderlichen Ressourcen zugreifen.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 3.0K
- 2026-1: 17.8K
- 2026-2: 7.6K
- 2026-3: 2.3K
- 2026-4: 3.5K
- 2026-5: 3.3K
Geography
Top 5 countries / regions
- 🇧🇷Brasilien58.6%
- 🇺🇸Vereinigte Staaten39.1%
- 🇩🇿Algerien2.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| mind video | $0.15 |
| mindvideo | $0.36 |
| mind video ai | $0.19 |
| mindvideo ai | $0.57 |
| mindvideo.ai | $0.00 |
Mind-Video Alternatives
Papers with Code
Papers with Code ist eine kostenlose, offene Ressource für Forscher und Entwickler im Bereich des maschinellen Lernens. Es verbindet wissenschaftliche Arbeiten mit ihrem entsprechenden Open-Source-Code und macht Forschung zugänglicher und reproduzierbarer. Die Plattform bietet hochmoderne Ranglisten, durchsuchbare Datensätze und eine umfassende Sammlung von KI-Forschung, die Benutzern hilft, den Fortschritt zu verfolgen, Implementierungen zu finden und ihre Arbeit zu beschleunigen. Es ist ein unverzichtbares Werkzeug für jeden in der KI/ML-Community.
Maschinelles Lernen
ComfyUI
ComfyUI ist eine leistungsstarke, kostenlose und quelloffene knotenbasierte grafische Benutzeroberfläche für generative KI. Sie bietet unübertroffene Kontrolle und Flexibilität zur Erstellung komplexer Workflows für die Generierung von Bildern, Videos, 3D-Assets und Audio, entwickelt für Künstler, Entwickler und Forscher.
3D-Modellierung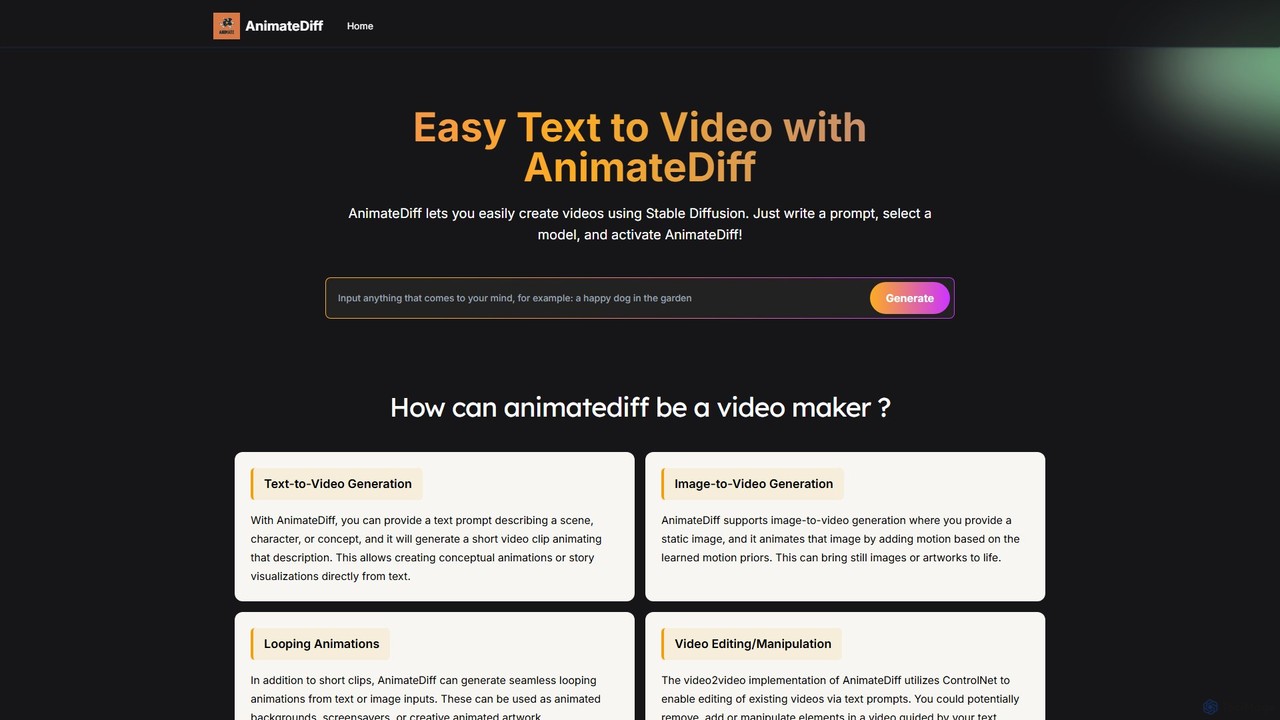
AnimateDiff
AnimateDiff ist ein KI-gestütztes Werkzeug, das kurze Videos und Animationen aus Textaufforderungen oder statischen Bildern generiert. Durch die Integration eines Bewegungsmoduls mit Stable Diffusion-Modellen erweckt es Ihre kreativen Ideen zum Leben und erstellt mühelos nahtlose Schleifen, Charakteranimationen und dynamische visuelle Effekte.
Animation
Google Labs
Google Labs ist der offizielle Hub für Googles KI-Experimente und bietet frühen Zugang zu einer vielfältigen Palette von Kreativ- und Produktivitätstools. Nutzer können modernste Technologien wie Gemini und Veo erkunden, testen und Feedback geben, um die Zukunft von Googles KI-Produkten direkt zu beeinflussen. Es ist ein Spielplatz für Kreative, Entwickler und Enthusiasten, um die Spitze der künstlichen Intelligenz-Innovation zu erleben, von KI-Filmemachen und Musikgenerierung bis hin zu Programmierassistenten und Design-Tools.
Experimentelle Werkzeuge
Leonardo.ai
Leonardo.ai ist eine umfassende generative KI-Suite zur Erstellung hochwertiger visueller Assets. Sie bietet eine breite Palette von Werkzeugen, einschließlich Bild- und Videogenerierung, AI Canvas, 3D-Texturierung und zahlreichen feinabgestimmten Modellen. Ideal für einzelne Kreative, kollaborative Teams und Entwickler, betont sie Qualität, Geschwindigkeit und Stilkonsistenz.
Generative KunstMind-Video Categories
Mind-Video Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Papers with Code
Papers with Code ist eine kostenlose, offene Ressource für Forscher und Entwickler im Bereich des maschinellen Lernens. Es verbindet wissenschaftliche Arbeiten mit ihrem entsprechenden Open-Source-Code und macht Forschung zugänglicher und reproduzierbarer. Die Plattform bietet hochmoderne Ranglisten, durchsuchbare Datensätze und eine umfassende Sammlung von KI-Forschung, die Benutzern hilft, den Fortschritt zu verfolgen, Implementierungen zu finden und ihre Arbeit zu beschleunigen. Es ist ein unverzichtbares Werkzeug für jeden in der KI/ML-Community.
Maschinelles LernenComfyUI
ComfyUI ist eine leistungsstarke, kostenlose und quelloffene knotenbasierte grafische Benutzeroberfläche für generative KI. Sie bietet unübertroffene Kontrolle und Flexibilität zur Erstellung komplexer Workflows für die Generierung von Bildern, Videos, 3D-Assets und Audio, entwickelt für Künstler, Entwickler und Forscher.
3D-ModellierungAnimateDiff
AnimateDiff ist ein KI-gestütztes Werkzeug, das kurze Videos und Animationen aus Textaufforderungen oder statischen Bildern generiert. Durch die Integration eines Bewegungsmoduls mit Stable Diffusion-Modellen erweckt es Ihre kreativen Ideen zum Leben und erstellt mühelos nahtlose Schleifen, Charakteranimationen und dynamische visuelle Effekte.
Animation
Nous Research
Nous Research ist eine KI-Forschungsorganisation, die sich der Entwicklung von quelloffenen, menschenzentrierten Sprachmodellen widmet. Sie konzentrieren sich auf die Demokratisierung der KI durch dezentrale Trainingsinfrastruktur, fortschrittliche Modellarchitekturen und leistungsstarke Inferenz-APIs und fordern damit den konventionellen Ansatz geschlossener Modelle heraus.
Dezentrales Computing
Seed
Seed ist die fortschrittliche KI-Forschungsinitiative von ByteDance, die sich auf die Entwicklung allgemeiner künstlicher Intelligenz konzentriert. Sie entwickeln grundlegende Modelle in verschiedenen Bereichen wie Multimodalität, Vision, Sprache, Robotik und LLMs und treiben Innovationen sowohl in der akademischen Forschung als auch in realen Anwendungen voran.
Basismodelle
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
pinokio
Pinokio ist ein Desktop-Browser, mit dem Sie KI-Anwendungen und terminalbasierte Apps mit einem einzigen Klick auf Ihrem Computer installieren, ausführen und steuern können. Er vereinfacht die komplexe Einrichtung von Open-Source-KI-Modellen durch die Automatisierung der Umgebungserstellung, der Abhängigkeitsverwaltung und der Ausführung. Dies ermöglicht Benutzern aller Erfahrungsstufen, leistungsstarke KI-Tools lokal zu testen und dabei die Privatsphäre und die volle Kontrolle über ihre Daten zu wahren.
Modellbereitstellung
Stability AI
Stability AI ist ein führendes Open-Source-Unternehmen für generative KI, das grundlegende Modelle zur Erstellung von Bildern, Videos, Audio, 3D-Assets und mehr entwickelt. Es bietet leistungsstarke, zugängliche Werkzeuge für Kreative, Entwickler und Unternehmen, insbesondere die weltbekannte Stable Diffusion-Modellreihe. Es bietet flexible Bereitstellungsoptionen wie APIs, Self-Hosting und Cloud-Dienste.
API
Allen Institute for AI (AI2)
Das Allen Institute for AI (AI2) ist ein gemeinnütziges Forschungsinstitut, das sich der Entwicklung bahnbrechender KI für das Gemeinwohl widmet. Es konzentriert sich auf die Schaffung wirklich quelloffener großer Sprachmodelle wie OLMo, umfassender Datensätze und spezialisierter KI-Tools, um die wissenschaftliche Forschung voranzutreiben und große globale Herausforderungen in Bereichen wie Klimawissenschaft, Naturschutz und Medizin anzugehen.
Datensätze
Fooocus
Fooocus ist ein kostenloses Open-Source-KI-Bilderzeugungstool, das den Prozess der Erstellung hochwertiger Bilder mit Stable Diffusion vereinfacht. Es kombiniert Benutzerfreundlichkeit mit leistungsstarken Funktionen wie Inpainting, Stilkontrolle und Gesichtstausch und ist somit sowohl für Anfänger als auch für fortgeschrittene Benutzer zugänglich.
Digitale Kunst
Zyphra
Zyphra ist ein Open-Source-KI-Forschungsunternehmen, das leistungsstarke und effiziente Grundlagenmodelle entwickelt. Sie bieten hochmoderne kleine Sprachmodelle (SLMs), Text-to-Speech (TTS)-Systeme und spezialisierte Reasoning-Modelle für Entwickler und Forscher an, mit dem Ziel, fortschrittliche KI für On-Device- und Unternehmensanwendungen zu demokratisieren.
Modellentwicklung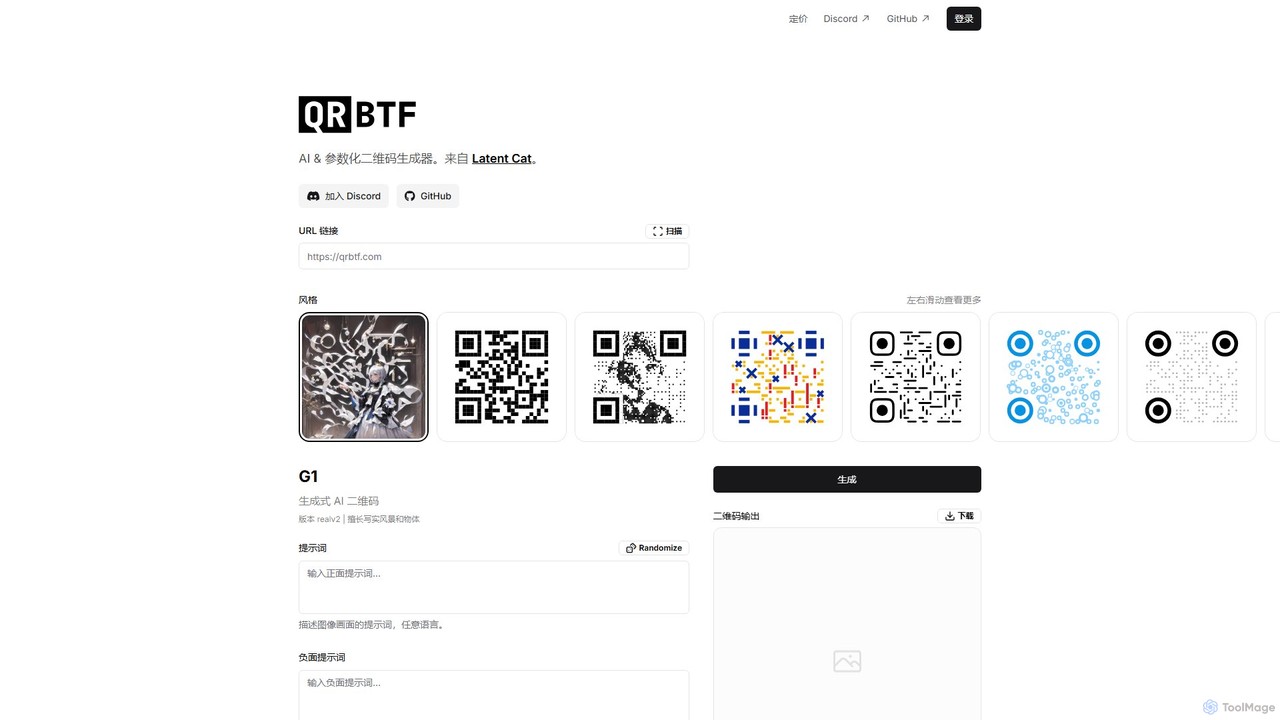
QRBTF
QRBTF ist ein innovativer KI-gestützter QR-Code-Generator, der Standard-QR-Codes in atemberaubende Kunstwerke verwandelt. Durch die Nutzung von generativer KI und parametrischen Steuerungen können Benutzer QR-Codes nahtlos in schöne Bilder auf Basis von Text-Prompts einbetten und so visuell ansprechende und scannbare Designs für Marketing, Kunst und den persönlichen Gebrauch erstellen.
KI-Kunstgenerator
Stable Horde
Stable Horde ist ein kostenloser, quelloffener und Crowdsourcing-basierter verteilter Cluster für die KI-gestützte Bild- und Texterzeugung. Es ermöglicht jedem den Zugriff auf leistungsstarke KI-Modelle, indem die von Freiwilligen einer globalen Gemeinschaft bereitgestellte Rechenleistung genutzt wird, ohne dass eigene High-End-Hardware erforderlich ist.
API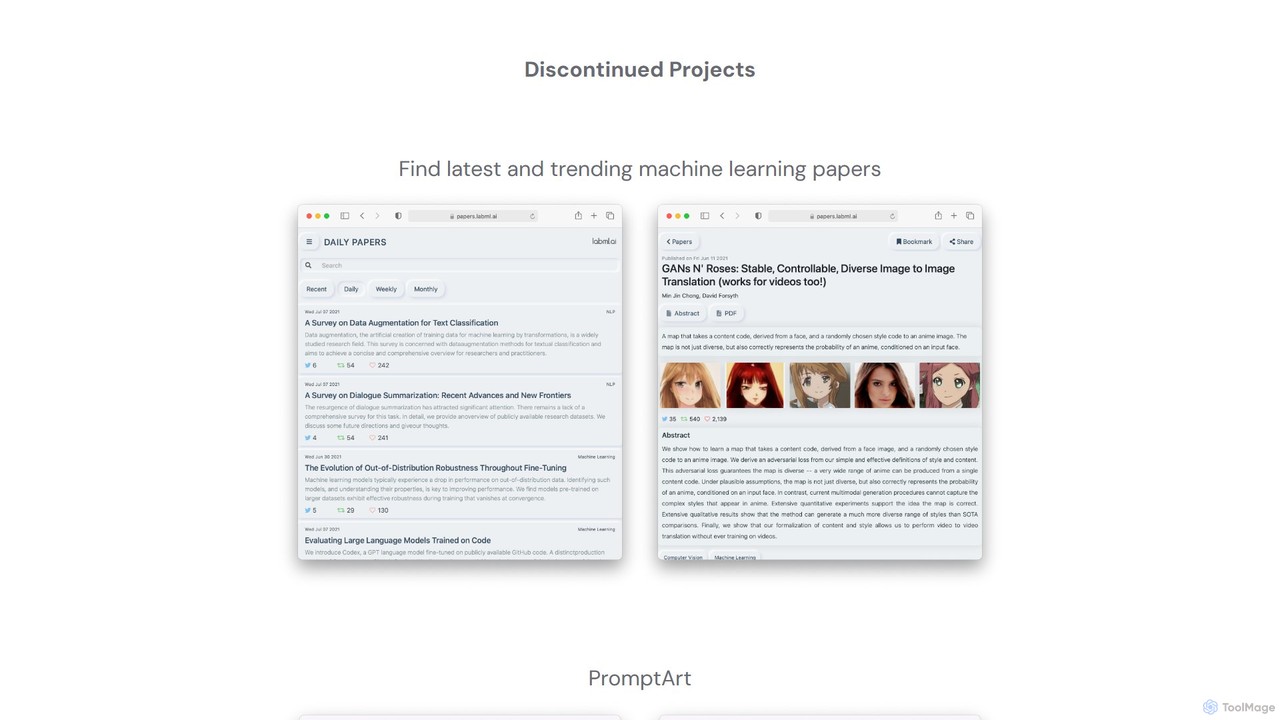
PromptArt
PromptArt ist ein KI-gestütztes Kunst-Generierungstool des Forschungslabors labml.ai. Es ermöglicht Benutzern, Textbeschreibungen in einzigartige und visuell ansprechende Bilder umzuwandeln. Es wurde sowohl für Künstler als auch für Forscher im Bereich des maschinellen Lernens entwickelt und bietet eine Plattform zum Experimentieren mit generativen Modellen, zur Feinabstimmung von Parametern und zur Erkundung des kreativen Potenzials der KI.
Kreative Werkzeuge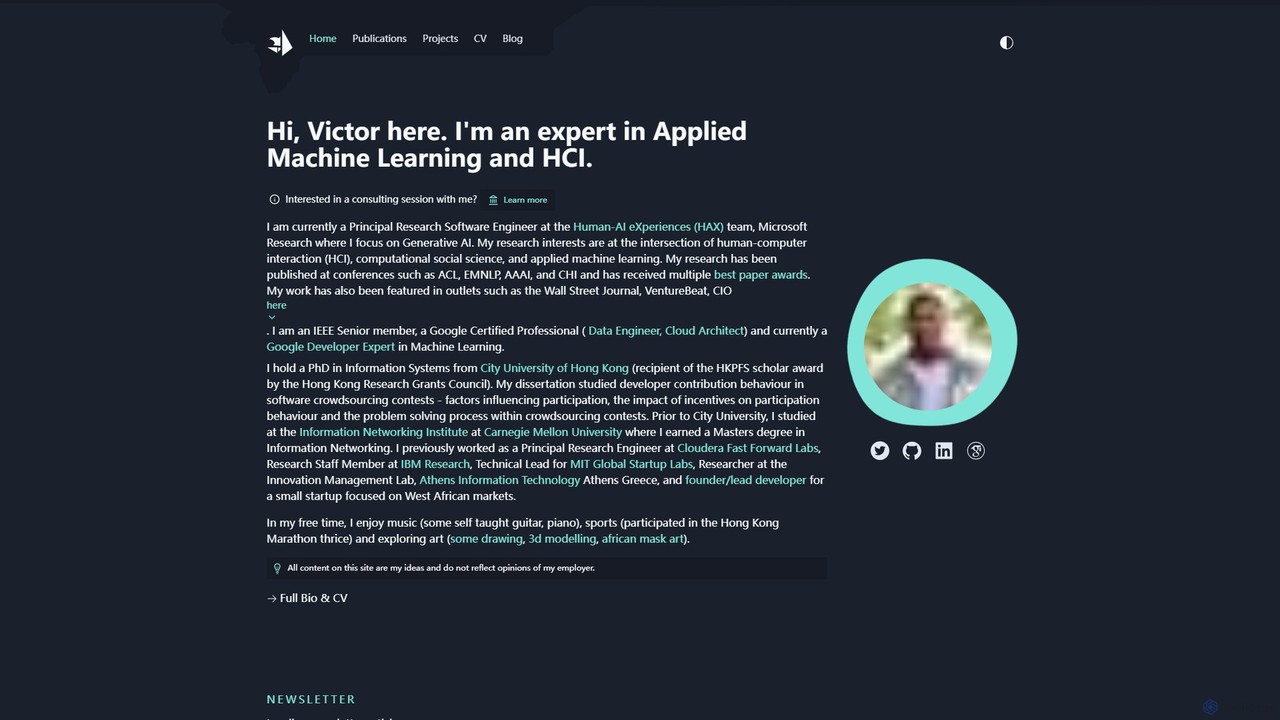
victordibia
Ein umfassender Ressourcen-Hub von Victor Dibia, einem führenden Forscher in Angewandtem ML und HCI. Er bietet Open-Source-KI-Tools wie AutoGen Studio und LIDA, tiefgehende Artikel, Forschungsarbeiten und Vorträge zu generativer KI, Multi-Agenten-Systemen und Mensch-Computer-Interaktion. Eine wertvolle Plattform für Entwickler, Forscher und KI-Enthusiasten.
Datenvisualisierung
Mind-Video Comments (0)
Sign in to comment.
AnmeldenNo comments yet.