
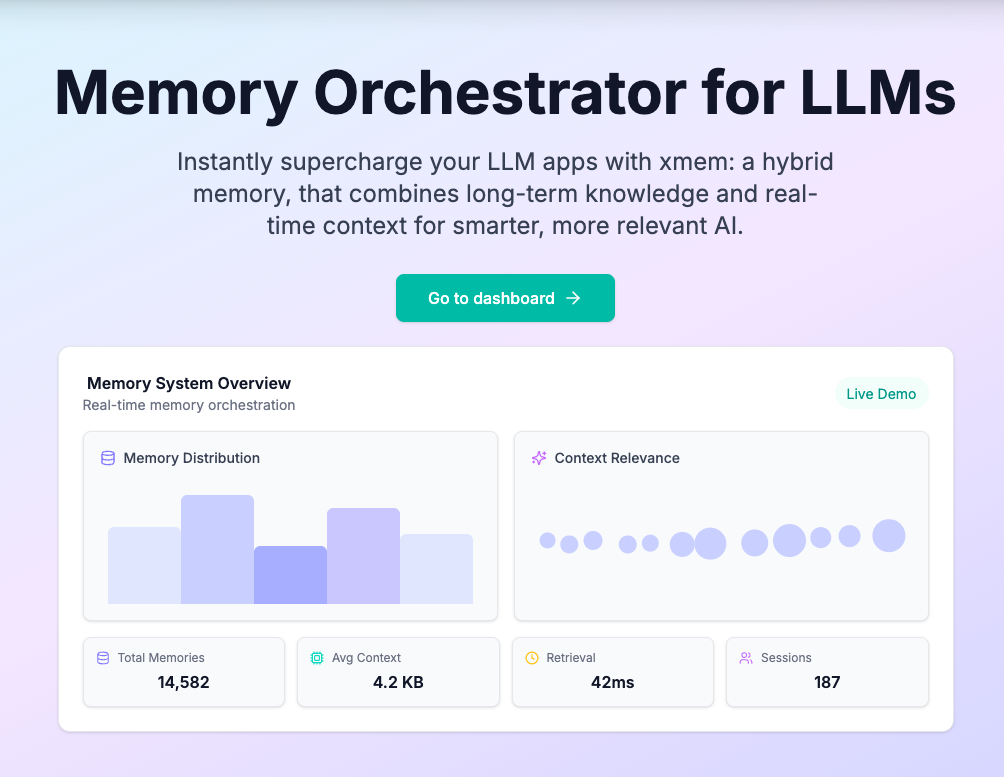
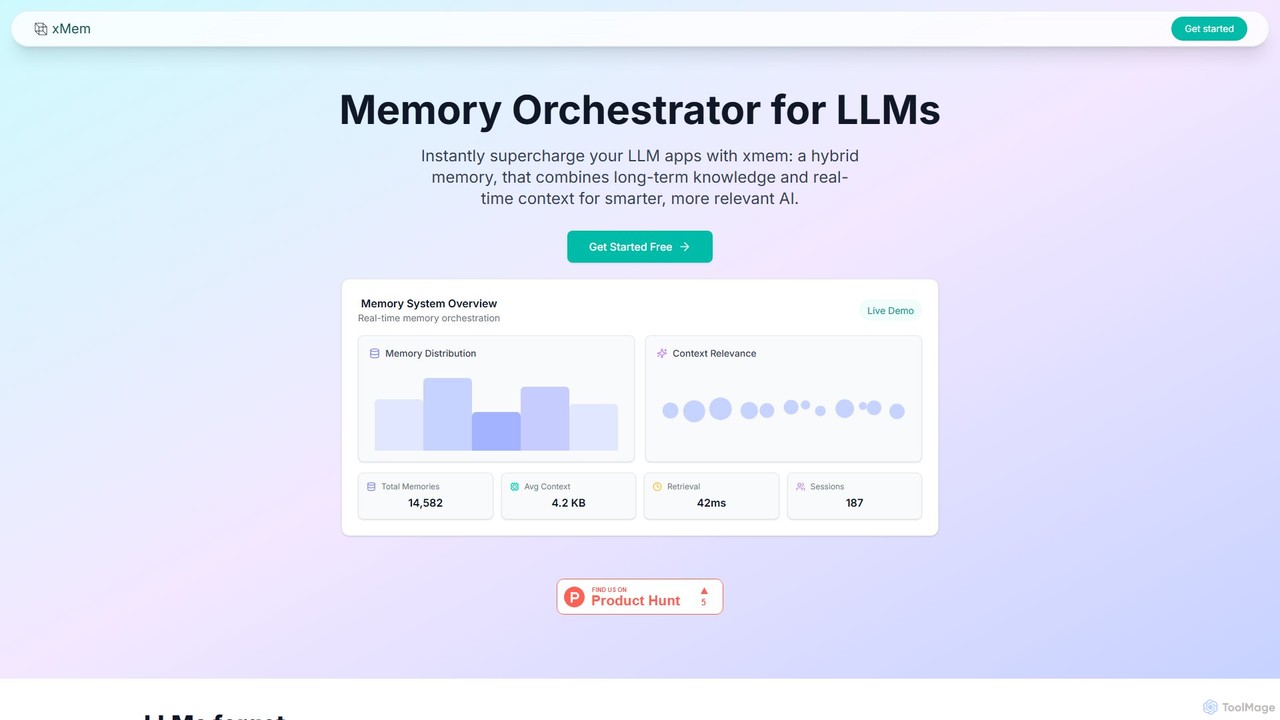
xMem Overview
xMem ist ein hochentwickelter Speicher-Orchestrator, der für Entwickler entwickelt wurde, die Anwendungen mit großen Sprachmodellen (LLMs) erstellen. Er löst eine der größten Herausforderungen in der KI-Entwicklung: die inhärente Vergesslichkeit von LLMs. Durch die Bereitstellung eines hybriden Speichersystems stellt xMem sicher, dass KI-Anwendungen den Kontext und das Wissen nicht nur innerhalb einer einzigen Sitzung, sondern über mehrere Interaktionen hinweg aufrechterhalten können.
Die Plattform funktioniert durch die intelligente Kombination von zwei Arten von Speicher. Der Langzeitspeicher speichert und ruft persistente Informationen wie Dokumente, Benutzerhistorie und grundlegendes Wissen mithilfe von Vektorsuche ab und integriert sich in beliebte Vektordatenbanken wie Qdrant, ChromaDB und Pinecone. Gleichzeitig verfolgt der Sitzungsspeicher den unmittelbaren Kontext der aktuellen Konversation, einschließlich der letzten Nachrichten und Anweisungen, zur Personalisierung und Aktualität. Die RAG (Retrieval-Augmented Generation) Orchestrierungsschicht von xMem stellt automatisch den relevantesten Kontext aus beiden Speichern für jeden LLM-Aufruf zusammen, wodurch manuelle Abstimmungen entfallen und die Genauigkeit und Relevanz der KI-Antworten erheblich gesteigert werden.
Wie man xMem verwendet
Die Integration von xMem in eine LLM-Anwendung ist für Entwickler ein unkomplizierter Prozess:
- Einrichtung und Konfiguration: Beginnen Sie mit der Auswahl Ihrer bevorzugten Komponenten. xMem ist Open-Source-freundlich und unterstützt verschiedene LLM-Anbieter (wie OpenAI, Llama.cpp, Ollama), Vektordatenbanken (Qdrant, ChromaDB) und Sitzungsspeicher (In-Memory, MongoDB).
- Installation: Installieren Sie das xMem SDK in Ihrem Projekt. Das primäre SDK ist für TypeScript/JavaScript-Umgebungen verfügbar.
- Instanziierung: Erstellen Sie im Code Ihrer Anwendung eine Instanz des xMem-Orchestrators. Bei diesem Initialisierungsschritt übergeben Sie Ihre gewählten Konfigurationen für den Vektorspeicher, den Sitzungsspeicher und den LLM-Anbieter.
- Abfrage: Anstatt das LLM direkt aufzurufen, verwenden Sie die `orchestrator.query()`-Methode von xMem. Wenn Sie eine Benutzeranfrage über diese Methode senden, übernimmt xMem automatisch den komplexen Prozess des Abrufens relevanter Langzeitkenntnisse und des jüngsten Sitzungskontexts, verpackt diese und sendet sie an das LLM.
- Überwachung: Nutzen Sie das xMem-Dashboard, um die Leistung des Systems zu überwachen. Das Dashboard bietet Einblicke in die Speicherverteilung, Kontextrelevanz, Abruflatenz und aktive Sitzungen. Es verfügt auch über einen Wissensgraphen zur Visualisierung der Verbindungen zwischen verschiedenen Informationen.
Kernfunktionen von xMem
- Hybrides Speichersystem: Kombiniert nahtlos persistenten Langzeitspeicher (über Vektor-DBs) und flüchtigen Kurzzeitsitzungsspeicher für einen umfassenden Kontext.
- Automatisierte RAG-Orchestrierung: Ruft intelligent den optimalen Kontext für jede Abfrage ab und stellt ihn zusammen, um die Antwortqualität ohne manuellen Eingriff zu verbessern.
- Wissensgraph: Visualisiert die Beziehungen zwischen Konzepten, Fakten und Benutzerkontext in Echtzeit und ermöglicht es dem LLM, komplexere Schlussfolgerungen und Erinnerungen durchzuführen.
- Open-Source-First: Entwickelt, um mit jedem Open-Source-LLM (z. B. Llama, Mistral) und jeder Vektordatenbank zu funktionieren, was maximale Flexibilität bietet und Vendor-Lock-in vermeidet.
- Mühelose Integration: Bietet eine einfache API und ein umfassendes Dashboard für eine einfache Integration, Überwachung und Verwaltung des Speichersystems.
- Persistenter Benutzerkontext: Löst das Problem des Kontextverlusts, indem sichergestellt wird, dass die KI Benutzerdetails, Projektinformationen und vergangene Gespräche über Sitzungen hinweg speichert.
Anwendungsfälle für xMem
xMem ist ideal für jede Anwendung, bei der kontextbezogener Speicher für eine hochwertige Benutzererfahrung entscheidend ist:
- Fortschrittliche Chatbots und virtuelle Assistenten: Erstellen Sie Assistenten, die sich an Benutzerpräferenzen, vergangene Gespräche und persönliche Details erinnern und so ein wirklich personalisiertes Erlebnis bieten.
- KI-Copiloten für Entwicklung und Arbeit: Bauen Sie Copiloten, die den Kontext eines Projekts, einer Codebasis oder von Teamdiskussionen beibehalten und relevante Hilfe ohne ständige Erinnerungen bieten.
- Intelligente Kundensupport-Agenten: Setzen Sie KI-Agenten ein, die Zugriff auf die gesamte Interaktionshistorie eines Kunden haben und so nahtlosen und informierten Support bieten können.
- Personalisiertes Wissensmanagement: Entwickeln Sie Systeme, die nicht nur Dokumente durchsuchen, sondern auch den Forschungskontext des Benutzers verstehen und neue Anfragen mit früheren Erkenntnissen verknüpfen.
Vorteile von xMem
Der Hauptvorteil von xMem ist seine Fähigkeit, LLM-Anwendungen erheblich intelligenter und benutzerfreundlicher zu machen. Indem es LLMs ein zuverlässiges Gedächtnis gibt, verhindert es frustrierende Situationen, in denen Benutzer sich wiederholen müssen. Seine Open-Source-Natur bietet Entwicklern Flexibilität und Kontrolle. Die automatisierte Orchestrierung vereinfacht die komplexe Aufgabe der Kontextverwaltung für RAG-Pipelines und spart Entwicklungszeit und -aufwand. Letztendlich steigert xMem die LLM-Genauigkeit, verbessert das Benutzerengagement und erschließt das Potenzial für anspruchsvollere KI-Agenten und Copiloten.
Preise und Pläne
xMem arbeitet nach einem Freemium-Modell. Es bietet eine großzügige kostenlose Stufe, die es Entwicklern ermöglicht, loszulegen und den Speicher-Orchestrator in ihre Projekte zu integrieren. Für Anwendungen mit größerem Bedarf, höheren Nutzungsgrenzen oder erweiterten Unternehmensfunktionen werden voraussichtlich kostenpflichtige Pläne verfügbar sein. Spezifische Details zu den Stufen und Preisen finden Sie auf der offiziellen Website.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-8: 65
- 2025-9: 367
- 2026-3: 0
- 2026-4: 0
- 2026-5: 616
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten100.0%
Top keywords
| Keyword | Cost per click |
|---|---|
| xme ai | $0.00 |
xMem Alternatives
MyScale Chat
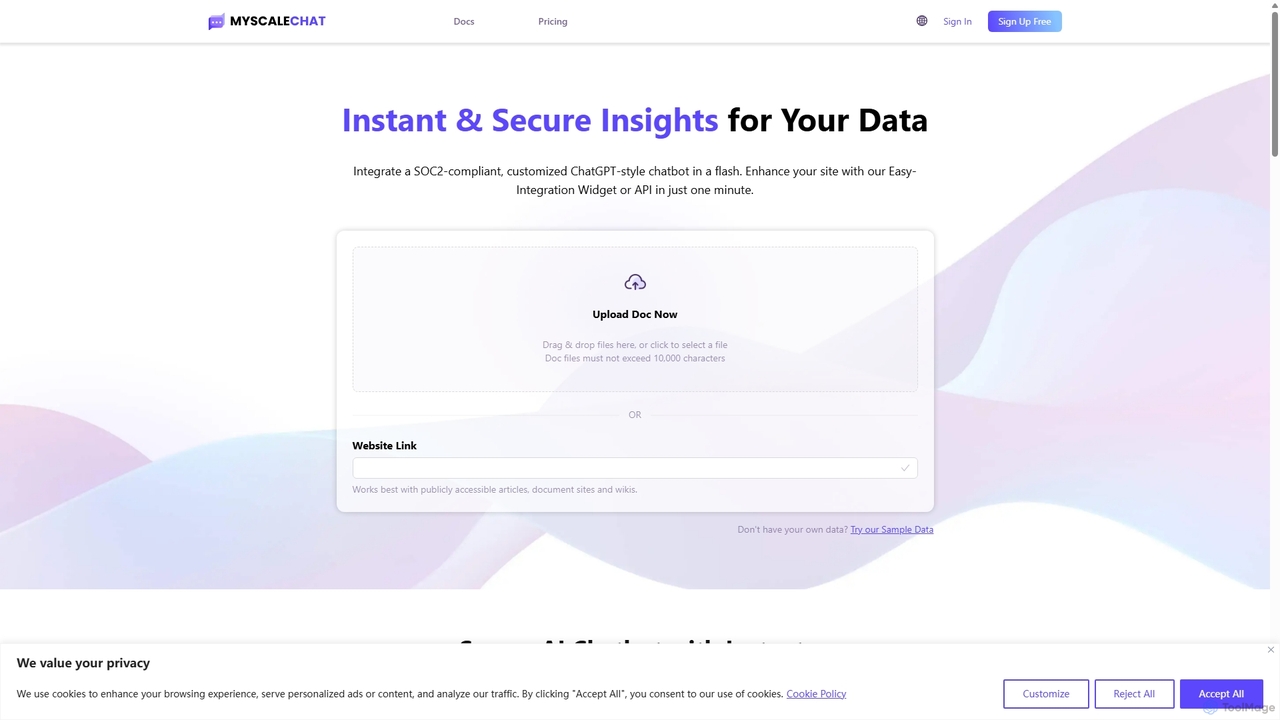
MyScale Chat ist eine KI-gestützte Plattform, die es Benutzern ermöglicht, benutzerdefinierte Chatbots zu erstellen, indem sie mit ihren eigenen Daten chatten. Durch die Nutzung der leistungsstarken MyScale-Vektordatenbank liefert sie sofortige, sichere und genaue Einblicke aus Dokumenten, Websites oder Wissensdatenbanken. Sie wurde für Entwickler und Unternehmen entwickelt, um anspruchsvolle RAG-Anwendungen (Retrieval-Augmented Generation) zu erstellen und private Daten in interaktive, intelligente Konversationsagenten zu verwandeln.
Dokumentenanalyse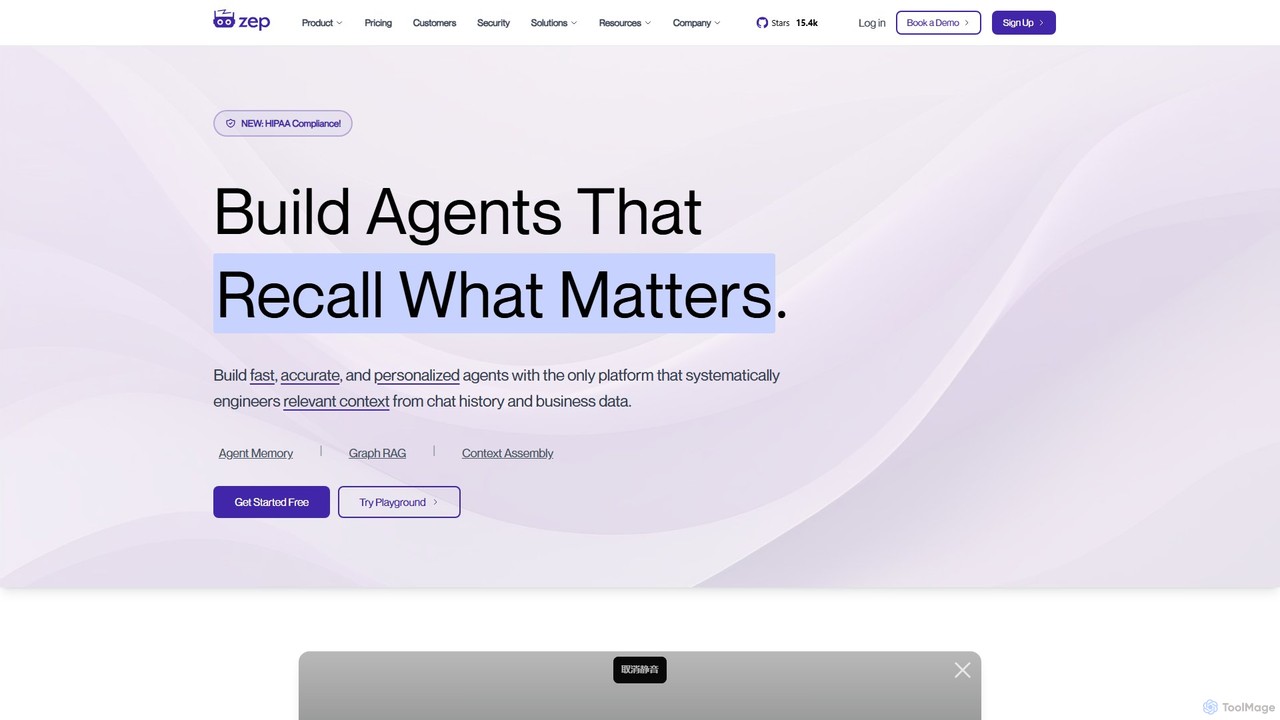
Zep
Zep ist eine Context-Engineering-Plattform für Entwickler, die KI-Agenten erstellen. Sie bietet Langzeitgedächtnis und erweiterte Graph-RAG-Funktionen, die es Agenten ermöglichen, sich an Benutzerpräferenzen, Gesprächsverläufe und dynamische Geschäftsdaten zu erinnern. Durch die automatische Erstellung von temporalen Wissensgraphen liefert Zep relevanten und token-effizienten Kontext an LLMs, was zu schnelleren, genaueren und hochgradig personalisierten KI-Interaktionen führt.
Agenten-Builder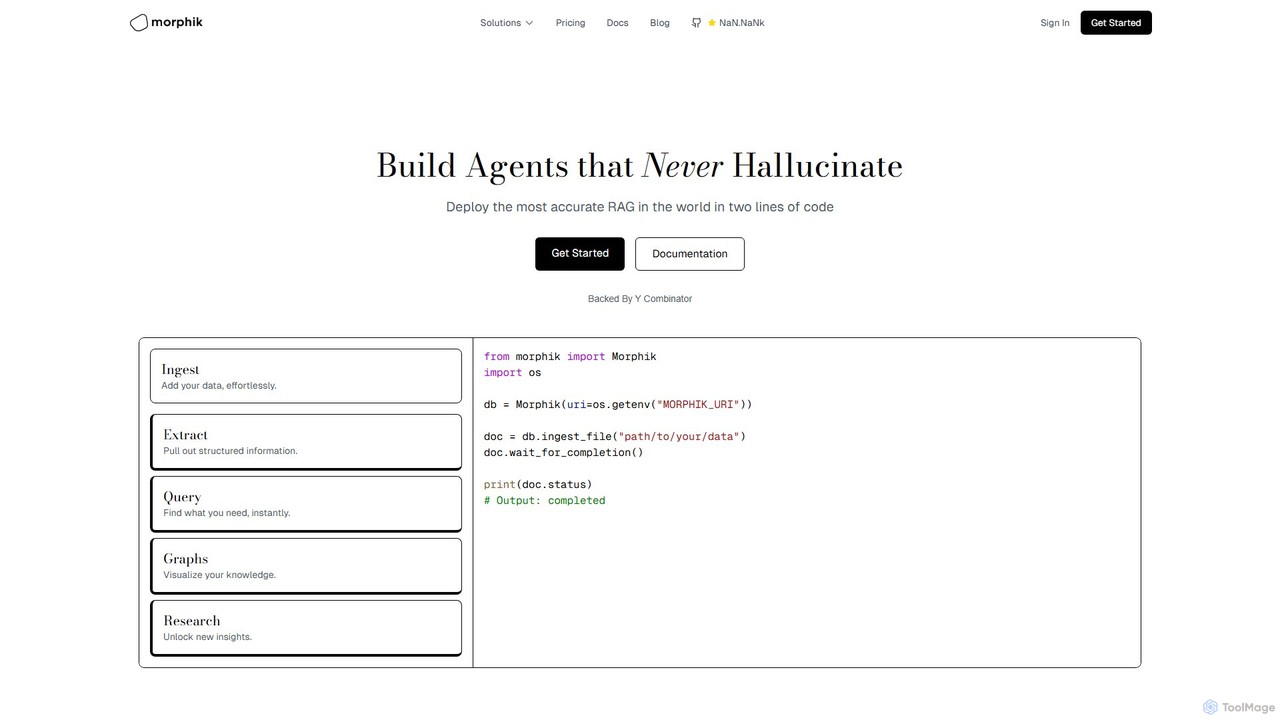
Morphik
Morphik ist eine fortschrittliche Entwicklerplattform zum Erstellen hochpräziser Retrieval-Augmented Generation (RAG)-Systeme und KI-Agenten. Sie ist darauf spezialisiert, Halluzinationen durch eine „Visual-First“-Retrieval-Methode zu eliminieren, um komplexe, domänenspezifische Dokumente, einschließlich Diagrammen und Schaltplänen, zu verstehen. Mit nur zwei Codezeilen einsetzbar, bietet sie überlegene Leistung, Geschwindigkeit und Skalierbarkeit für KI-Anwendungen auf Unternehmensebene.
Unternehmen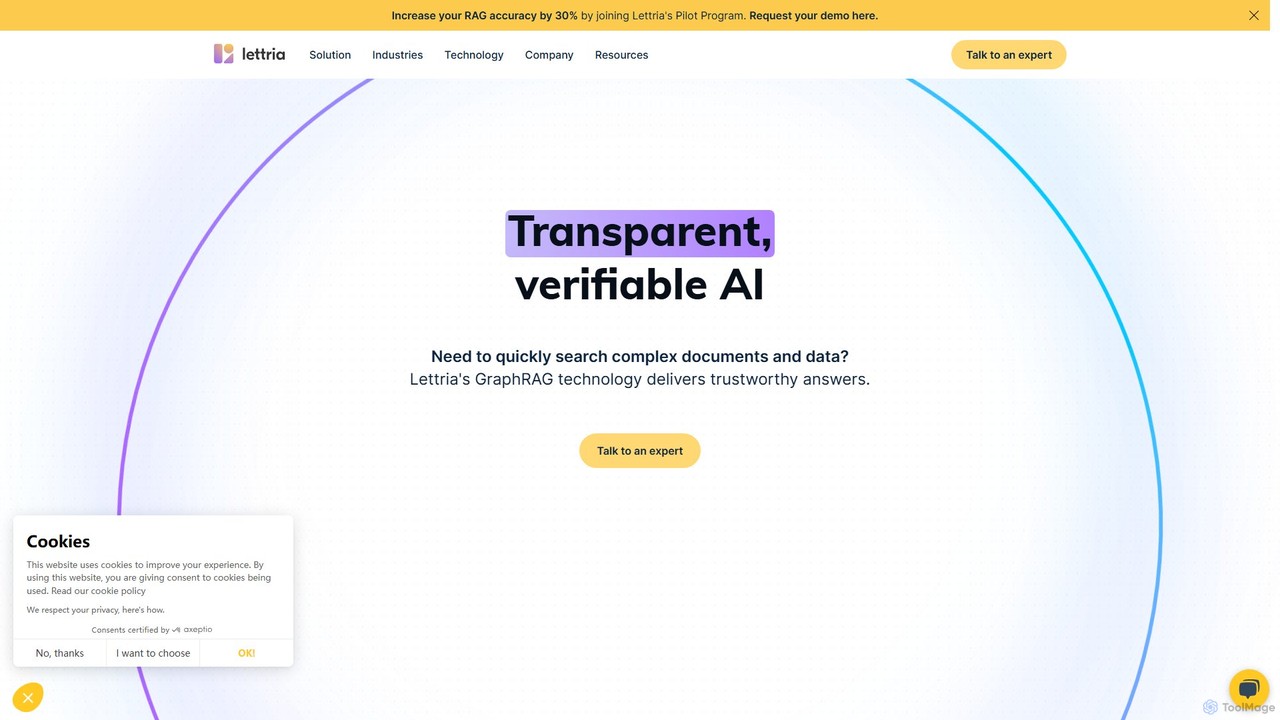
Lettria
Lettria ist eine unternehmenstaugliche KI-Plattform mit GraphRAG-Technologie. Sie verbessert die Retrieval-Augmented Generation (RAG), indem sie Wissensgraphen mit Vektordatenbanken kombiniert, um präzise, überprüfbare und transparente Antworten aus komplexen, unstrukturierten Daten zu liefern. Entwickelt für Sektoren wie Gesundheitswesen, Finanzen und Recht, eliminiert sie KI-Halluzinationen und schafft Vertrauen in geschäftskritische Anwendungen.
Dokumentenintelligenz
Pinecone
Pinecone ist eine hochleistungsfähige, vollständig verwaltete Vektordatenbank, die für die Erstellung von wissensbasierten KI-Anwendungen im großen Maßstab entwickelt wurde. Sie ermöglicht Entwicklern die Implementierung fortschrittlicher Funktionen wie semantische Suche, Retrieval-Augmented Generation (RAG) und personalisierte Empfehlungen durch effizientes Speichern und Abfragen von Milliarden von Vektor-Embeddings in Echtzeit.
DatenbankxMem Categories
xMem Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
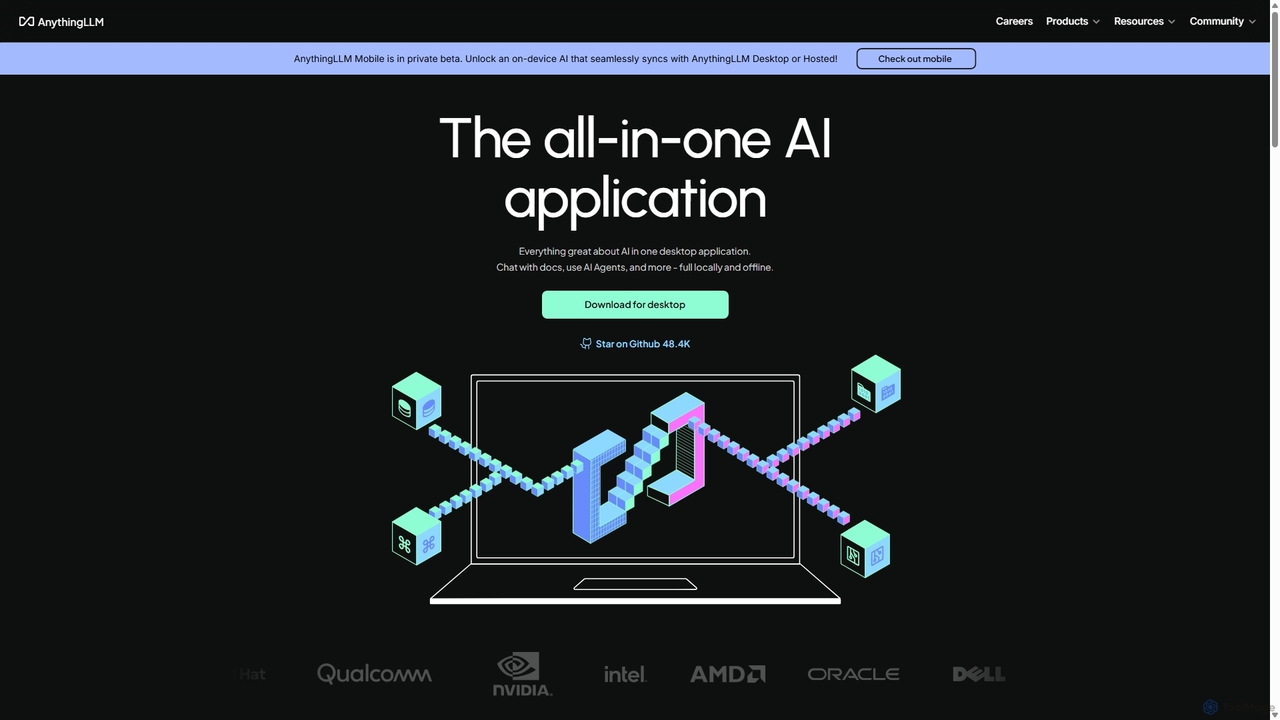
AnythingLLM
AnythingLLM ist eine Open-Source-All-in-One-KI-Anwendung, die lokal auf Ihrem Desktop läuft oder selbst gehostet werden kann. Sie ermöglicht es Ihnen, eine private Wissensdatenbank aus beliebigen Dokumenten zu erstellen, mit Ihren Daten zu chatten und leistungsstarke KI-Agenten zu nutzen, während die vollständige Datensicherheit und -kontrolle gewährleistet wird.
Dokumentenmanagement
Embedding.io
Eine KI-gestützte Plattform, die jede Website in eine interaktive, abfragbare Wissensdatenbank für große Sprachmodelle (LLMs) umwandelt. Erstellen Sie einfach benutzerdefinierte Chatbots, KI-Suchfunktionen und automatisierte Support-Systeme, indem Sie eine einfache URL angeben. Es kümmert sich um Crawling, Embedding und API-Integration.
Suchen
phidata
phidata ist ein Open-Source-Python-Framework zum Erstellen autonomer KI-Assistenten. Es vereinfacht die Integration von LLMs mit Gedächtnis, Wissensdatenbanken und externen Tools und ermöglicht es Entwicklern, mühelos leistungsstarke, zustandsbehaftete KI-Anwendungen zu erstellen.
FrameworksMyScale Chat
MyScale Chat ist eine KI-gestützte Plattform, die es Benutzern ermöglicht, benutzerdefinierte Chatbots zu erstellen, indem sie mit ihren eigenen Daten chatten. Durch die Nutzung der leistungsstarken MyScale-Vektordatenbank liefert sie sofortige, sichere und genaue Einblicke aus Dokumenten, Websites oder Wissensdatenbanken. Sie wurde für Entwickler und Unternehmen entwickelt, um anspruchsvolle RAG-Anwendungen (Retrieval-Augmented Generation) zu erstellen und private Daten in interaktive, intelligente Konversationsagenten zu verwandeln.
Dokumentenanalyse
Chroma
Chroma ist die Open-Source, KI-native Retrieval-Datenbank, die für die Erstellung leistungsstarker KI-Anwendungen mit Retrieval-Augmented Generation (RAG) entwickelt wurde. Sie vereinfacht das Speichern und Suchen von Embeddings, Dokumenten und Metadaten und bietet Vektorsuche, Volltextsuche und eine skalierbare, serverlose Cloud-Plattform. Sie ist darauf ausgelegt, einfach zu bedienen, kostengünstig und leistungsstark zu sein, von der lokalen Entwicklung bis zur groß angelegten Produktion.
Vektordatenbank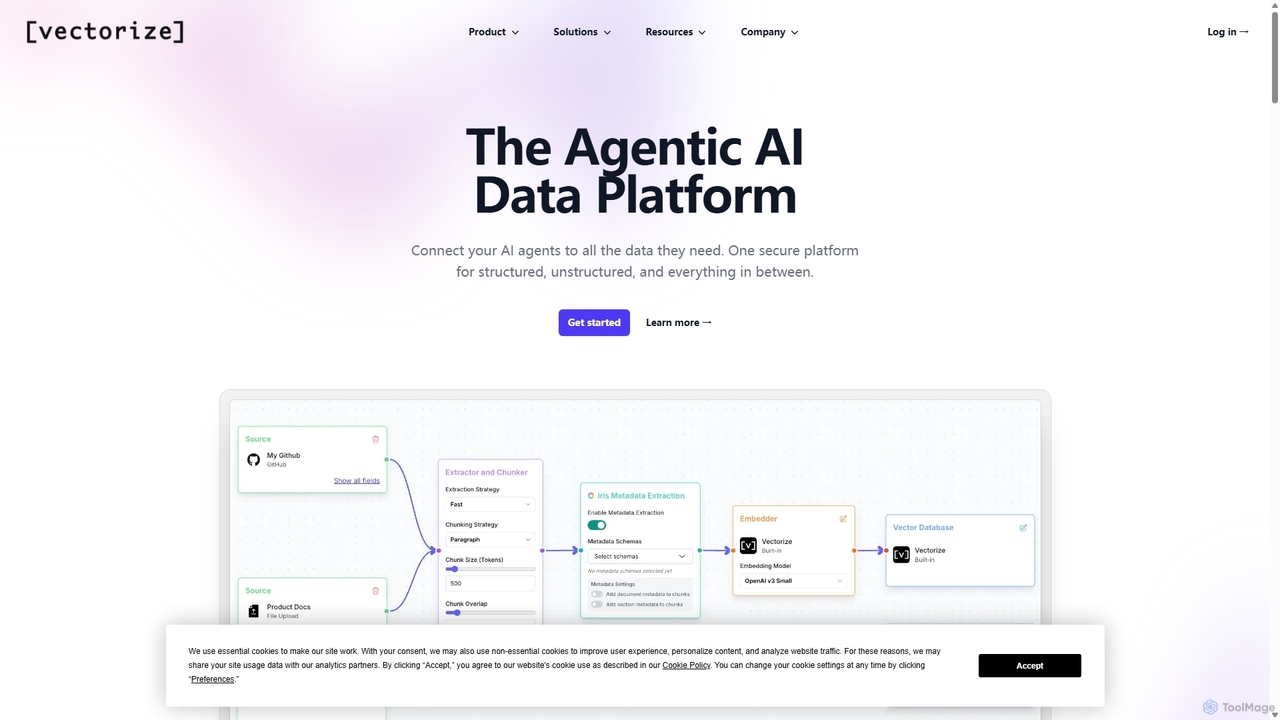
Vectorize
Vectorize ist eine RAG-as-a-Service-Plattform, die die Erstellung von KI-Anwendungen auf unstrukturierten Daten vereinfacht. Sie bietet verwaltete RAG-Pipelines, umfangreiche Datenquellen-Konnektoren und die Flexibilität, die verwaltete Vektordatenbank zu nutzen oder eine eigene anzubinden, sodass Entwickler produktionsreife KI-Lösungen schnell bereitstellen können.
Lappen
supermemory
supermemory ist eine Speicher-API und Infrastruktur für das KI-Zeitalter, die für Entwickler konzipiert wurde, um LLMs mit einem langlebigen, persistenten Gedächtnis zu erstellen. Es überwindet die Begrenzung des endlichen Kontextfensters und ermöglicht die Erstellung intelligenter, kontextbewusster KI-Agenten, Chatbots und Anwendungen, die sich an vergangene Interaktionen und Informationen über verschiedene Plattformen hinweg erinnern.
LLM
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Weaviate
Weaviate ist eine Open-Source, KI-native Vektordatenbank, die für Entwickler konzipiert wurde. Sie ermöglicht skalierbare, latenzarme Vektor-, Schlüsselwort- und Hybridsuchen. Ideal für die Erstellung von KI-Anwendungen wie semantischer Suche, Empfehlungssystemen und Retrieval-Augmented Generation (RAG)-Systemen, integriert sie sich nahtlos in gängige Machine-Learning-Modelle, um Daten basierend auf semantischer Bedeutung zu speichern und abzufragen.
Vektordatenbank
ragie
Ragie ist eine vollständig verwaltete RAG-as-a-Service-Plattform für Entwickler. Sie vereinfacht die Erstellung und Bereitstellung von KI-Anwendungen, indem sie die gesamte Pipeline der Retrieval-Augmented Generation (RAG) übernimmt. Verbinden Sie Ihre Datenquellen und nutzen Sie eine einfache API, um präzise, kontextbezogene Chatbots, semantische Suche und Wissensmanagementsysteme zu betreiben, ohne die Komplexität der Infrastrukturverwaltung.
Maschinelles Lernen
infiniflow
infiniflow ist eine hochleistungsfähige, quelloffene, KI-native Datenbank, die speziell für LLM-Anwendungen entwickelt wurde. Sie bietet eine unglaublich schnelle Vektorsuche, leistungsstarke hybride Suchfunktionen (Vektor, Volltext, Tensor) und eine vereinfachte Bereitstellung. Mit einer intuitiven Python-API ist sie darauf ausgelegt, anspruchsvolle KI-Aufgaben wie Retrieval-Augmented Generation (RAG) und semantische Suche mit Millisekunden-Latenz zu unterstützen.
Vektorsuche
PostgresML
PostgresML ist eine leistungsstarke Open-Source-Erweiterung, die maschinelles Lernen und KI direkt in Ihre PostgreSQL-Datenbank integriert. Es ermöglicht GPU-beschleunigte Inferenz, Vektorsuche und vollständige RAG-Pipelines mit einfachen SQL-Befehlen, wodurch Datenbewegungen eliminiert und der MLOps-Stack für hochleistungsfähige, skalierbare KI-Anwendungen vereinfacht wird.
MLOps
Superpowered AI
Superpowered AI ist eine Plattform, die Große Sprachmodelle (LLMs) verbessert, indem sie sie sicher mit Ihren privaten Daten verbindet. Sie ermöglicht Entwicklern und Unternehmen, hochpräzise, zitierte KI-Anwendungen wie Chatbots, Suchwerkzeuge und Inhaltsgeneratoren über eine flexible API und eine intuitive No-Code-Oberfläche zu erstellen.
Chatbots
Firecrawl
Firecrawl ist eine Open-Source, entwicklerorientierte API, die jede Website in saubere, LLM-fähige Daten umwandelt. Es bewältigt alle Komplexitäten des Web-Scrapings, einschließlich JavaScript-Rendering, Proxy-Rotation und Ratenbegrenzungen, und ermöglicht es Ihnen, KI-Anwendungen, Agenten und RAG-Systeme mit zuverlässigen Web-Inhalten zu versorgen. Es bietet Scraping-, Crawling- und Suchfunktionen über eine einfache API.
Datenerfassung
LobeHub
LobeHub ist eine All-in-One-KI-Plattform, mit der Sie ein personalisiertes Team von KI-Agenten aufbauen und verwalten können. Sie bietet eine überlegene Benutzererfahrung im Vergleich zu Standard-LLM-Schnittstellen wie ChatGPT, mit Unterstützung für zahlreiche Modelle, Plugins und multimodale Interaktionen. Erstellen, teilen und nutzen Sie spezialisierte Agenten für Aufgaben von Codierung und Schreiben bis hin zu akademischer Forschung und dem täglichen Leben, alles in einer einzigen, intuitiven Chat-Oberfläche.
Chatbot-Plattform
xMem Comments (0)
Sign in to comment.
AnmeldenNo comments yet.