
ToolMage
Iniciar sesión

Best 1 Datos de Entrenamiento AI tools for Desarrollo de Modelo de IA

Popular Datos de Entrenamiento AI tools in Desarrollo de Modelo de IA include Label Studio, helping you work more efficiently.

Label Studio
Freemium

Label Studio

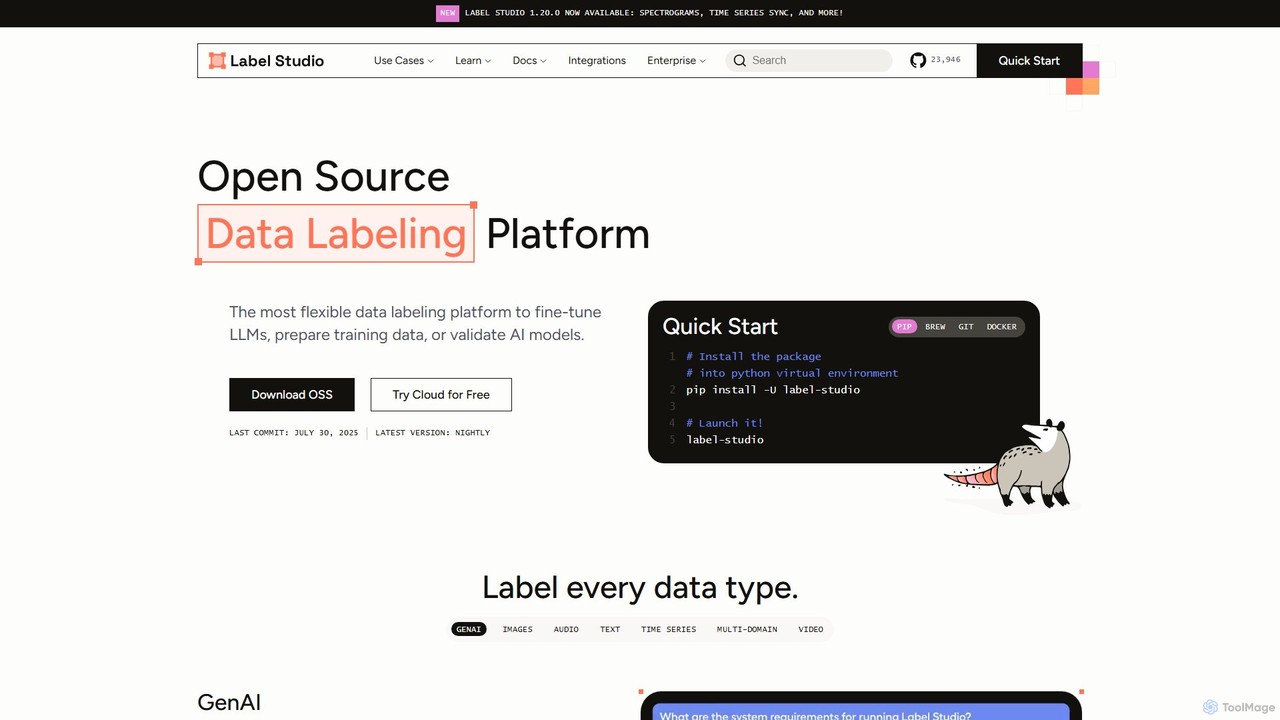
Label Studio es una versátil plataforma de etiquetado de datos de código abierto diseñada para una amplia gama de tipos de datos. Permite a los usuarios anotar imágenes, texto, audio, video y datos de series temporales para afinar LLMs, preparar datos de entrenamiento para machine learning y validar modelos de IA con retroalimentación humana en el ciclo.

Datos de Entrenamiento
Visits 268.1KFavorites 160Likes 171

About Datos de Entrenamiento

Las herramientas de Datos de Entrenamiento son plataformas especializadas impulsadas por IA, diseñadas para recopilar, anotar y preparar conjuntos de datos de alta calidad, esenciales para desarrollar y refinar modelos de aprendizaje automático. Estas herramientas agilizan la fase inicial crucial del desarrollo de modelos de IA, asegurando que los datos estén etiquetados y formateados con precisión. Permiten a los profesionales de la IA construir modelos robustos que funcionan de manera confiable en diversas aplicaciones, desde la visión por computadora hasta el procesamiento del lenguaje natural.

Características Principales

  • Recopilación y Obtención de Datos: Facilita la reunión de datos brutos diversos y relevantes de varias fuentes.
  • Anotación y Etiquetado de Datos: Proporciona interfaces y funciones asistidas por IA para etiquetar, categorizar y segmentar datos con precisión.
  • Aumento de Datos: Genera datos sintéticos o modifica datos existentes para aumentar el tamaño y la diversidad del conjunto de datos.
  • Garantía y Validación de Calidad: Implementa mecanismos para verificar la precisión de la anotación y la coherencia de los datos.
  • Control de Versiones y Gestión de Datos: Rastrea los cambios en los conjuntos de datos, asegurando la reproducibilidad y los flujos de trabajo colaborativos.

Casos de Uso

Estas herramientas son indispensables para investigadores de IA, científicos de datos e ingenieros de aprendizaje automático. Se utilizan para preparar conjuntos de datos para entrenar modelos de visión por computadora para la detección de objetos, anotar texto para la comprensión del lenguaje natural o etiquetar datos de sensores para sistemas de conducción autónoma. El objetivo es transformar la información bruta en formatos estructurados y utilizables para la ingesta del modelo.

Cómo Elegir

Al seleccionar una plataforma de datos de entrenamiento, considere los tipos de datos que necesita procesar (imágenes, texto, audio, video), la complejidad de las tareas de anotación y los requisitos de escalabilidad para grandes conjuntos de datos. Evalúe sus capacidades de integración con las tuberías de ML existentes, el nivel de automatización ofrecido para la anotación y la robustez de sus características de control de calidad. Los modelos de precios y el soporte para flujos de trabajo colaborativos también son factores importantes.

Datos de Entrenamiento use cases

1

Anotación de Imágenes para Modelos de Visión por Computadora

Un ingeniero de aprendizaje automático necesita entrenar un modelo de detección de objetos para vehículos autónomos. Utiliza una plataforma de datos de entrenamiento para etiquetar con precisión miles de imágenes con cuadros delimitadores alrededor de peatones, vehículos y señales de tráfico. Esta anotación detallada asegura que el modelo identifique y localice objetos con precisión en escenarios de conducción reales, lo cual es crucial para la seguridad y el rendimiento.

2

Preparación de Datos de Texto para Procesamiento del Lenguaje Natural

Un científico de datos está construyendo un modelo de PNL para el análisis de sentimientos de reseñas de clientes. Utiliza herramientas de datos de entrenamiento para anotar datos de texto, categorizando oraciones o frases como positivas, negativas o neutrales. Este proceso implica identificar entidades clave y relaciones dentro del texto, lo que permite al modelo comprender y clasificar con precisión el tono emocional de los comentarios de los clientes.

3

Generación de Datos Sintéticos para Escenarios Raros

En industrias como la salud o las finanzas, los datos del mundo real para eventos raros pero críticos (por ejemplo, brotes de enfermedades específicas, patrones de fraude) son escasos. Los ingenieros de datos utilizan herramientas de datos de entrenamiento con capacidades de aumento para generar datos sintéticos que imitan estos escenarios raros. Esto expande el conjunto de datos, permitiendo que los modelos de IA sean entrenados en un rango más completo de situaciones, mejorando su capacidad para detectar y responder a anomalías.

4

Transcribir y Anotar Audio para Reconocimiento de Voz

Una empresa que desarrolla un asistente de voz necesita datos de audio de alta calidad para el entrenamiento. Emplean herramientas de datos de entrenamiento para transcribir el lenguaje hablado a texto y anotar elementos específicos como turnos de orador, ruido de fondo o tono emocional. Este proceso meticuloso asegura que el modelo de reconocimiento de voz pueda convertir con precisión diversas entradas de audio en texto, mejorando la comprensión y la capacidad de respuesta del asistente.

5

Validación y Limpieza de Conjuntos de Datos para Robustez del Modelo

Antes de implementar un modelo de IA, un especialista en calidad de datos utiliza herramientas de datos de entrenamiento para validar y limpiar los conjuntos de datos preparados. Esto implica identificar y corregir inconsistencias, eliminar entradas duplicadas y manejar valores faltantes. Asegurar que los datos estén limpios y precisos evita que el modelo aprenda patrones erróneos, lo que lleva a un rendimiento del sistema de IA más robusto, justo y confiable en entornos de producción.

6

Preparación de Datos Geoespaciales para Monitoreo Ambiental

Los científicos ambientales utilizan herramientas de datos de entrenamiento para procesar y etiquetar datos geoespaciales, como imágenes satelitales o grabaciones de drones, para modelos de IA que monitorean la deforestación, la expansión urbana o los impactos del cambio climático. Esto implica segmentar tipos de cobertura terrestre, identificar características específicas y rastrear cambios a lo largo del tiempo. Los datos geoespaciales etiquetados de alta calidad son críticos para desarrollar modelos predictivos precisos para la conservación del medio ambiente y la gestión de recursos.

Datos de Entrenamiento FAQ

¿Qué son los Datos de Entrenamiento en IA?

Los datos de entrenamiento en IA se refieren a la colección de información, como imágenes, texto, audio o video, que ha sido cuidadosamente preparada y etiquetada para enseñar a un modelo de aprendizaje automático. Sirve como entrada para el modelo durante su fase de aprendizaje, permitiéndole identificar patrones, hacer predicciones o realizar tareas específicas. Los datos de entrenamiento de alta calidad son fundamentales para construir modelos de IA efectivos y precisos, impactando directamente su rendimiento y confiabilidad en aplicaciones del mundo real.

¿Cómo elegir la plataforma de Datos de Entrenamiento adecuada?

Elegir la plataforma de datos de entrenamiento adecuada implica evaluar varios factores clave. Primero, considere los tipos de datos con los que trabajará (por ejemplo, imágenes, texto, audio, video) y asegúrese de que la plataforma los admita. Segundo, evalúe sus capacidades de anotación, incluyendo la variedad de herramientas de anotación y el nivel de asistencia de IA. Tercero, observe la escalabilidad para manejar grandes volúmenes de datos y su integración con sus tuberías de aprendizaje automático existentes. Finalmente, evalúe sus características de control de calidad, estructura de precios y soporte para flujos de trabajo colaborativos en equipo.

¿Cuál es la diferencia entre recopilación y anotación de datos?

La recopilación de datos implica reunir información bruta y sin procesar de diversas fuentes, como el rastreo web, las alimentaciones de sensores o las bases de datos existentes. La anotación de datos, por otro lado, es el proceso de etiquetar o marcar estos datos brutos recopilados con atributos significativos para que sean comprensibles para los modelos de aprendizaje automático. Por ejemplo, recopilar imágenes es recopilación de datos, mientras que dibujar cuadros delimitadores alrededor de objetos en esas imágenes y etiquetarlos es anotación de datos. Ambos son pasos cruciales en la preparación de datos de entrenamiento, pero la anotación añade el contexto necesario para el aprendizaje de la IA.

¿Por qué los datos de entrenamiento de alta calidad son cruciales para los modelos de IA?

Los datos de entrenamiento de alta calidad son cruciales porque influyen directamente en la precisión, la equidad y la robustez de los modelos de IA. Los modelos aprenden de los patrones y ejemplos presentes en los datos; si los datos son sesgados, inexactos o incompletos, el modelo heredará estos defectos, lo que llevará a un rendimiento deficiente, predicciones incorrectas y resultados potencialmente dañinos. Los datos limpios, diversos y etiquetados con precisión aseguran que el modelo generalice bien a datos nuevos y no vistos y funcione de manera confiable en escenarios del mundo real, haciéndolo confiable y efectivo.

¿Cuáles son los pasos clave en la preparación de datos de entrenamiento?

La preparación de datos de entrenamiento generalmente implica varios pasos clave. Primero, la recopilación de datos reúne información bruta de fuentes relevantes. Segundo, la limpieza y preprocesamiento de datos implica manejar valores faltantes, eliminar duplicados y transformar los datos a un formato consistente. Tercero, la anotación y etiquetado de datos añade etiquetas o atributos significativos a los datos. Cuarto, el aumento de datos expande el conjunto de datos creando variaciones. Finalmente, la garantía y validación de calidad aseguran la precisión y consistencia de los datos preparados antes de que se utilicen para entrenar modelos de IA.