ToolMage
Iniciar sesión

Best 7 Conjuntos de datos AI tools for Datos

Popular Conjuntos de datos AI tools in Datos include Kaggle, Defined.ai, LAION, Segmed, Bethge Lab, Grably y dataset.gold, helping you work more efficiently.

Segmed
Paid

Segmed

Segmed proporciona acceso a gran escala a datos de imágenes médicas desidentificados y de grado diagnóstico para el desarrollo de IA y la investigación clínica. Su plataforma, Openda, ofrece millones de estudios tokenizados de una red global diversa de proveedores de atención médica. Segmed acelera la innovación para empresas de ciencias de la vida, dispositivos médicos y tecnología al proporcionar conjuntos de datos multimodales de grado regulatorio, cruciales para entrenar modelos de IA, validación y obtener la aprobación de la FDA/CE.

Conjuntos de datos
Visits 10.1KFavorites 141Likes 154
Grably
Paid

Grably

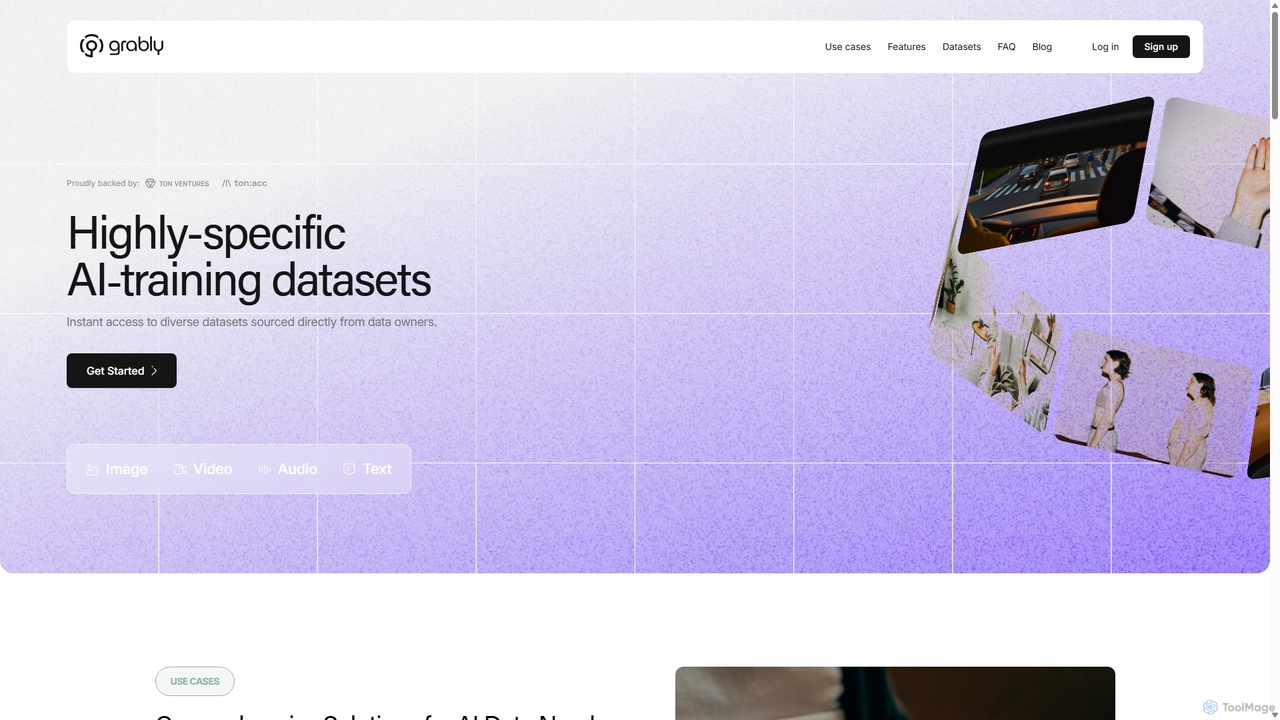
Grably es una red descentralizada de propiedad de datos (DeDON) que proporciona datos de entrenamiento de IA de alta calidad y de origen ético. Ofrece una vasta colección de conjuntos de datos listos para usar, recolección de datos personalizada, curación y servicios de anotación para acelerar el desarrollo de IA, permitiendo a los usuarios monetizar sus datos de forma segura y transparente.

Etiquetado de Datos
Visits 7.2KFavorites 133Likes 127
Kaggle
Freemium

Kaggle

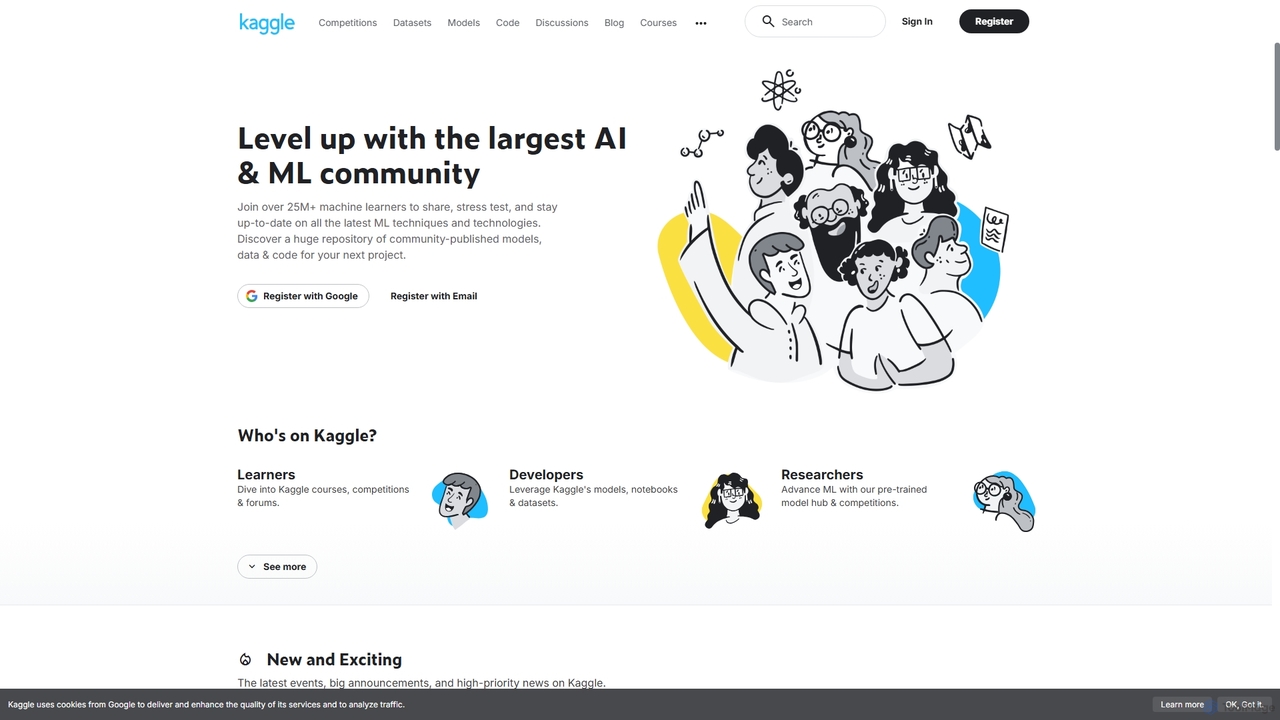
Kaggle es la comunidad en línea más grande del mundo para científicos de datos y profesionales del machine learning. Propiedad de Google, proporciona una plataforma para explorar conjuntos de datos, construir modelos en un entorno web, competir en desafíos de machine learning y acceder a recursos educativos. Ofrece acceso gratuito a potentes recursos computacionales, incluyendo GPUs y TPUs, convirtiéndola en una herramienta esencial para cualquiera, desde principiantes hasta expertos en los campos de la IA y la ciencia de datos.

Conjuntos de datos
Visits 12.4MFavorites 138Likes 133
Bethge Lab
Free

Bethge Lab

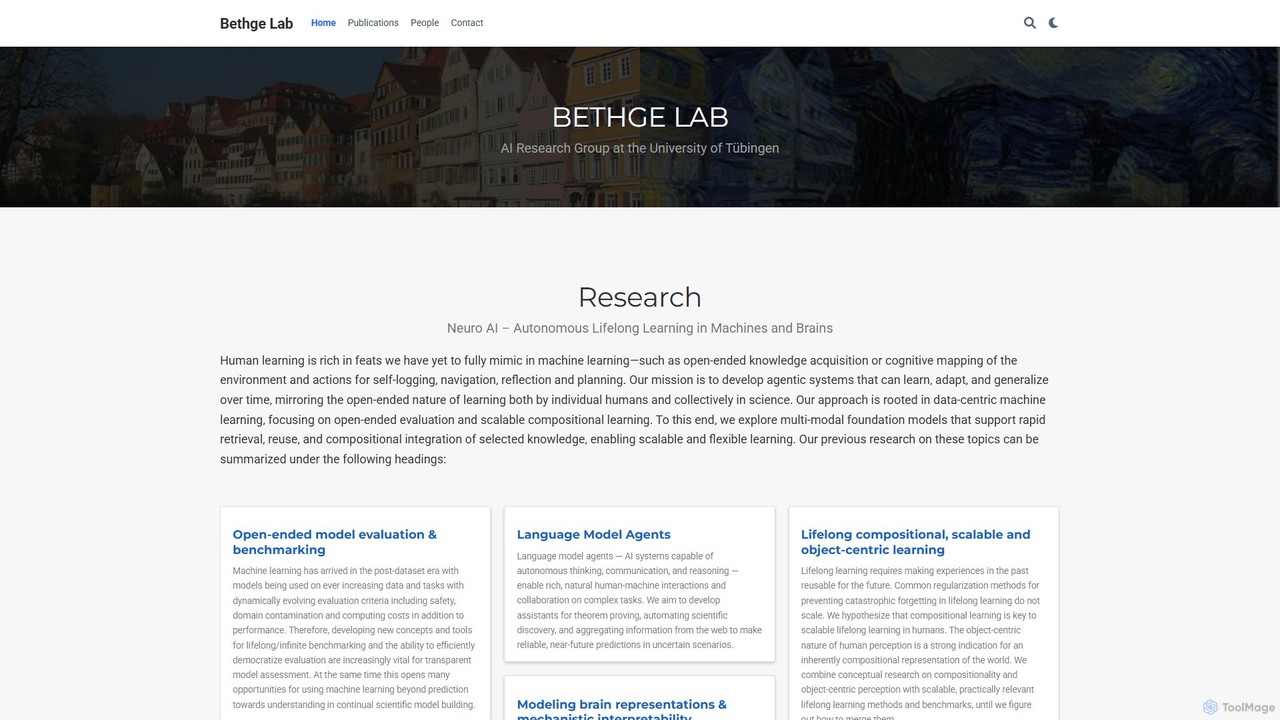
Bethge Lab es un grupo de investigación de IA líder en la Universidad de Tubinga, centrado en la intersección de la neurociencia computacional y el aprendizaje automático. Su objetivo es desarrollar sistemas de IA agénticos capaces de un aprendizaje autónomo y de por vida, inspirándose en el cerebro humano. El laboratorio produce modelos de código abierto, conjuntos de datos e investigación pionera.

Conjuntos de datos
Visits 10.1KFavorites 136Likes 129
LAION
Free

LAION

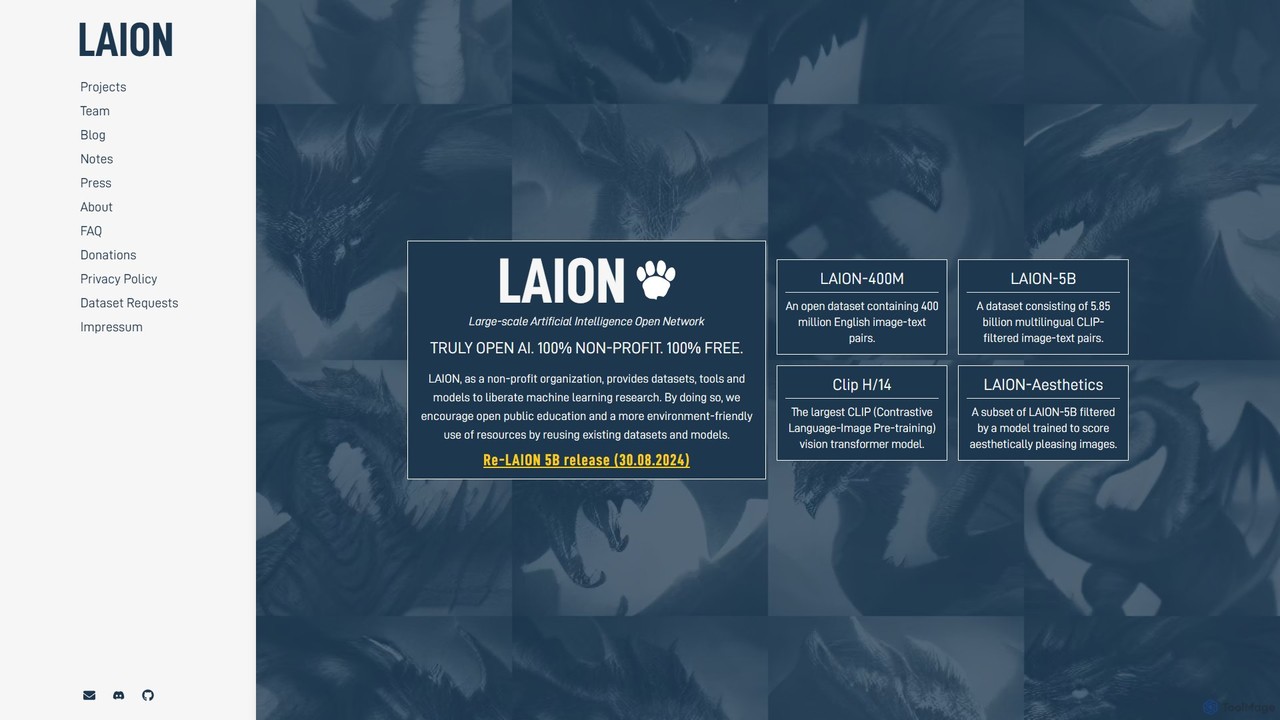
LAION (Large-scale Artificial Intelligence Open Network) es una organización sin ánimo de lucro dedicada a democratizar la investigación en IA. Proporciona al público conjuntos de datos masivos de código abierto, modelos preentrenados y herramientas, fomentando la investigación abierta, la educación y el desarrollo eficiente de recursos en el aprendizaje automático.

Conjuntos de datos
Visits 37.6KFavorites 142Likes 131
Defined.ai
Paid

Defined.ai

Defined.ai es un mercado y plataforma líder para datos de entrenamiento de IA de alta calidad. Proporciona conjuntos de datos listos para usar y servicios personalizados de recopilación/anotación de datos para visión por computadora, PNL y reconocimiento de voz. Aprovechando una multitud global y una plataforma robusta, Defined.ai ayuda a las empresas a acelerar el desarrollo de modelos de IA precisos y éticos.

Anotación de Datos
Visits 69.9KFavorites 131Likes 149
dataset.gold
Free

dataset.gold

Un directorio curado de conjuntos de datos de código abierto y alta calidad para IA y aprendizaje automático. Descubra el estándar de oro de los datos para entrenar sus modelos en visión por computadora, PNL y más.

Conjuntos de datos
Visits 6.4KFavorites 148Likes 148

About Conjuntos de datos

Los conjuntos de datos son colecciones curadas de información estructurada diseñadas específicamente para entrenar, probar y validar modelos de inteligencia artificial y aprendizaje automático. Estos recursos fundamentales proporcionan el material bruto —que abarca desde imágenes y texto hasta registros numéricos— del que los algoritmos aprenden para identificar patrones, hacer predicciones y realizar tareas complejas. Al suministrar datos diversos y representativos, los conjuntos de datos son indispensables para desarrollar sistemas de IA robustos, precisos y sin sesgos en varios dominios.

Características Principales

  • Recopilación y Curación de Datos: Herramientas para recolectar, limpiar y organizar datos brutos de diversas fuentes en formatos utilizables.
  • Anotación y Etiquetado: Funcionalidad para añadir metadatos, etiquetas o rótulos a los puntos de datos, crucial para tareas de aprendizaje supervisado.
  • Aumento de Datos: Técnicas para expandir conjuntos de datos existentes creando versiones modificadas de los datos, mejorando la robustez del modelo.
  • Control de Versiones: Sistemas para rastrear cambios, gestionar diferentes iteraciones y asegurar la reproducibilidad de los conjuntos de datos a lo largo del tiempo.
  • Privacidad y Seguridad de Datos: Funciones para anonimizar, cifrar y gestionar el acceso a datos sensibles, asegurando el cumplimiento y el uso ético.

Escenarios de Aplicación

Los conjuntos de datos son fundamentales para investigadores de IA, ingenieros de aprendizaje automático y científicos de datos. Se utilizan en la investigación académica para el desarrollo de modelos, por startups que construyen nuevos productos de IA y por grandes empresas para mejorar los sistemas de IA existentes. Por ejemplo, una empresa de vehículos autónomos depende de vastos conjuntos de datos de imágenes y sensores para entrenar sus modelos de percepción, mientras que una institución financiera utiliza conjuntos de datos transaccionales para detectar fraudes.

Cómo Elegir

Al seleccionar o crear conjuntos de datos, considere el volumen y la variedad de datos requeridos para su tarea específica de IA, la calidad y limpieza de los datos, y la precisión de cualquier anotación existente. Evalúe los términos de licencia, las implicaciones de privacidad y la facilidad de integración con sus pipelines de aprendizaje automático existentes. La escalabilidad y la disponibilidad de herramientas para el mantenimiento y las actualizaciones continuas también son factores cruciales.

Conjuntos de datos use cases

1

Entrenamiento de IA para Reconocimiento de Imágenes

Los ingenieros de aprendizaje automático utilizan grandes conjuntos de datos de imágenes anotadas (por ejemplo, ImageNet, COCO) para entrenar modelos de visión por computadora. Al alimentar al modelo con millones de imágenes etiquetadas con objetos, escenas o acciones, la IA aprende a identificar y clasificar con precisión elementos visuales en imágenes nuevas y no vistas, crucial para aplicaciones como vehículos autónomos o diagnósticos médicos.

2

Construcción de IA para la Comprensión de Texto

Los investigadores de PNL emplean extensos conjuntos de datos de texto (por ejemplo, volcados de Wikipedia, artículos de noticias, registros conversacionales) para entrenar modelos de lenguaje. Estos conjuntos de datos permiten a la IA comprender los matices del lenguaje humano, realizar análisis de sentimientos, traducir idiomas o generar texto coherente, impulsando chatbots, asistentes virtuales y herramientas de generación de contenido.

3

Mejora de la Detección de Fraudes Financieros

Los analistas financieros aprovechan los conjuntos de datos de transacciones históricas, incluidos los registros de comportamiento del cliente y anomalías, para entrenar modelos de IA para la detección de fraudes. La IA aprende a identificar patrones sospechosos que se desvían de la actividad normal, marcando posibles transacciones fraudulentas en tiempo real, minimizando así las pérdidas financieras y mejorando la seguridad.

4

Impulso de Sugerencias de Productos Personalizadas

Las plataformas de comercio electrónico utilizan conjuntos de datos de interacción del cliente (historial de compras, comportamiento de navegación, calificaciones) para entrenar motores de recomendación. Estos modelos de IA analizan las preferencias individuales y patrones de usuarios similares para sugerir productos relevantes, mejorando significativamente la experiencia del usuario e impulsando las ventas al presentar ofertas altamente dirigidas.

5

Asistencia en el Análisis de Imágenes Médicas

Investigadores médicos y clínicos utilizan conjuntos de datos especializados de registros de pacientes anonimizados, imágenes médicas (rayos X, resonancias magnéticas) y datos genómicos para entrenar IA para asistencia diagnóstica. La IA puede detectar indicadores sutiles de enfermedades, predecir resultados de pacientes o acelerar el descubrimiento de fármacos analizando grandes cantidades de información biológica compleja.

6

Generación de Datos para Casos Extremos

En escenarios donde los datos del mundo real son escasos o sensibles (por ejemplo, brotes de enfermedades raras, amenazas específicas de ciberseguridad), los científicos de datos utilizan modelos de IA generativa para crear conjuntos de datos sintéticos. Estos conjuntos de datos artificiales imitan las propiedades estadísticas de los datos reales, permitiendo que los modelos sean entrenados en casos extremos críticos sin comprometer la privacidad o esperar suficientes ocurrencias en el mundo real.

Conjuntos de datos FAQ

¿Qué son los Conjuntos de Datos en IA?

Los conjuntos de datos en IA son colecciones estructuradas de información utilizadas para entrenar, probar y validar modelos de aprendizaje automático. Sirven como la entrada bruta que permite a los algoritmos de IA aprender patrones, hacer predicciones y realizar tareas específicas. Estas colecciones pueden incluir varios tipos de datos como imágenes, texto, audio, video y registros numéricos, a menudo meticulosamente etiquetados o anotados para el aprendizaje supervisado.

¿En qué se diferencian los Conjuntos de Datos de IA de los Datos Brutos?

Los datos brutos se refieren a información sin procesar y desorganizada recopilada de diversas fuentes. Los conjuntos de datos, por otro lado, son datos brutos que han sido limpiados, estructurados, formateados y a menudo anotados o etiquetados específicamente para el consumo del modelo de IA. Esta transformación hace que los datos brutos sean utilizables para entrenar algoritmos, asegurando consistencia, calidad y relevancia para la tarea de aprendizaje automático prevista.

¿Qué hace que un Conjunto de Datos sea bueno para el entrenamiento de IA?

Un buen conjunto de datos para el entrenamiento de IA se caracteriza por su calidad, cantidad y representatividad. Debe ser limpio, libre de errores y lo suficientemente grande como para capturar patrones diversos. Crucialmente, debe ser representativo de los escenarios del mundo real que la IA encontrará, equilibrado para evitar sesgos y etiquetado con precisión. La diversidad en los puntos de datos ayuda al modelo a generalizar bien a datos nuevos y no vistos.

¿Cuáles son los tipos comunes de Conjuntos de Datos de IA?

Los tipos comunes de conjuntos de datos de IA incluyen conjuntos de datos de imágenes (por ejemplo, para detección de objetos), conjuntos de datos de texto (por ejemplo, para procesamiento de lenguaje natural), conjuntos de datos de audio (por ejemplo, para reconocimiento de voz), conjuntos de datos de video (por ejemplo, para reconocimiento de acciones) y conjuntos de datos tabulares (por ejemplo, para análisis predictivo). Cada tipo se adapta a tareas de IA específicas y a menudo requiere métodos de anotación especializados.

¿Por qué es importante la anotación de datos para los Conjuntos de Datos de IA?

La anotación de datos es crucial para el aprendizaje automático supervisado, donde los modelos aprenden de ejemplos etiquetados. Implica añadir etiquetas, rótulos o metadatos significativos a los datos brutos (por ejemplo, dibujar cuadros delimitadores alrededor de objetos en imágenes, transcribir audio, categorizar texto). Una anotación precisa proporciona la verdad fundamental para que la IA aprenda, impactando directamente el rendimiento y la fiabilidad del modelo.