ToolMage
Iniciar sesión

Best 4 Observabilidad AI tools for Eso

Popular Observabilidad AI tools in Eso include Resolve.ai, Digma, Incerto y Anomify, helping you work more efficiently.

Anomify
Freemium

Anomify

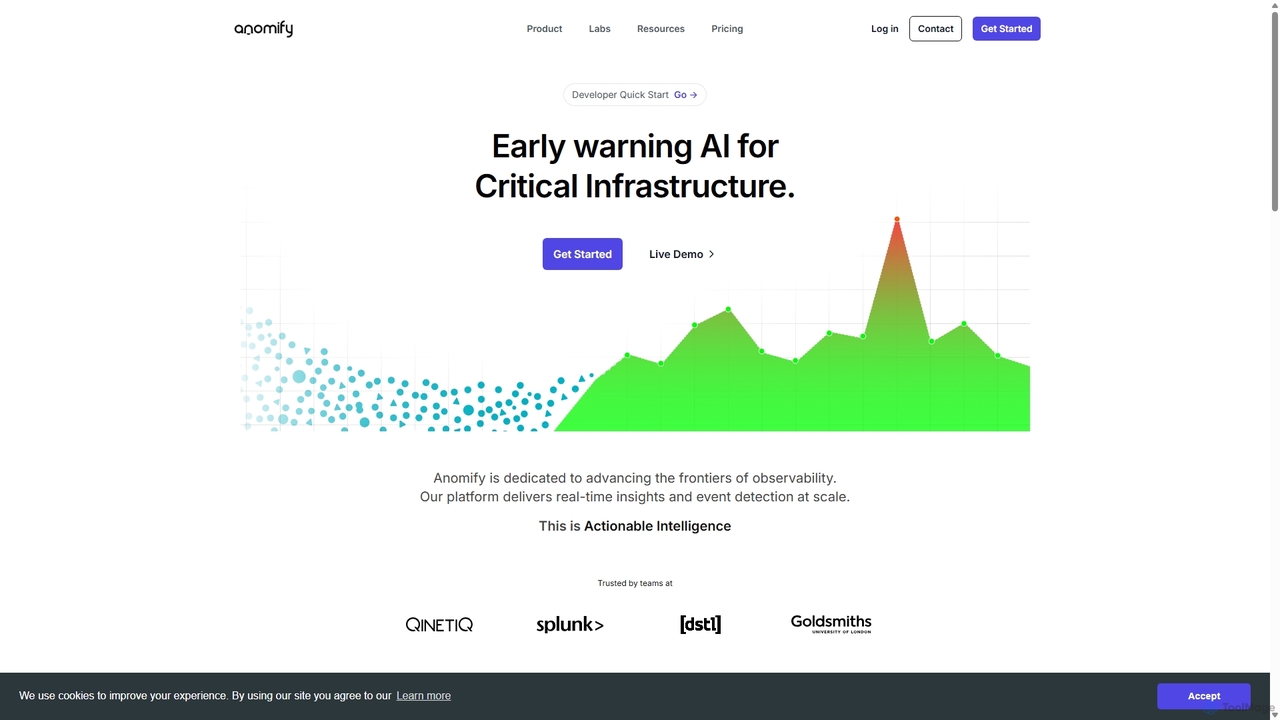
Anomify es una plataforma de alerta temprana impulsada por IA para infraestructuras críticas, que ofrece detección de anomalías en tiempo real y observabilidad a escala. Aprovecha el aprendizaje automático multietapa para analizar datos de series temporales, reducir significativamente los falsos positivos y acelerar el análisis de causa raíz. Diseñado para equipos de DevOps, SRE e IT, Anomify transforma el monitoreo de reactivo a proactivo, garantizando el rendimiento y la fiabilidad del sistema.

Detección de Anomalías
Visits 7.9KFavorites 139Likes 134
Digma
Freemium

Digma

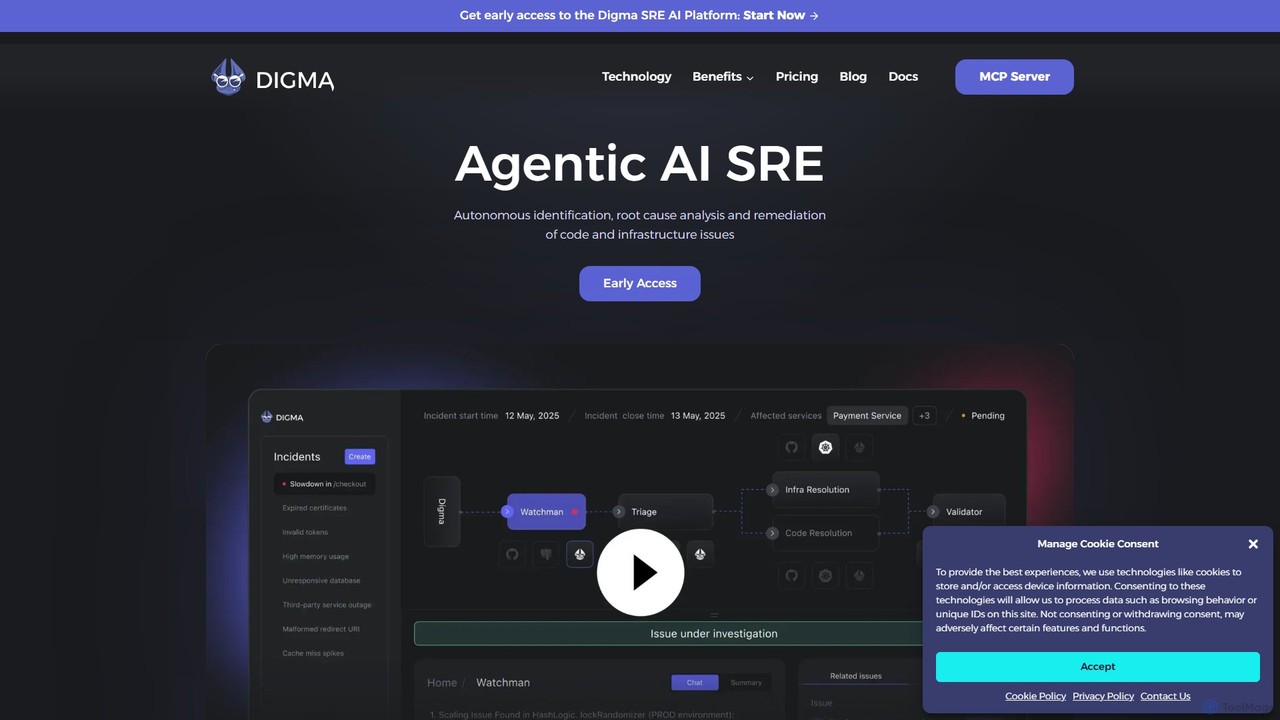
Digma es una plataforma SRE de IA agéntica que utiliza Análisis Dinámico de Código (DCA) para identificar, analizar y remediar de forma autónoma problemas de código e infraestructura antes de que lleguen a producción. Se integra con tu pila de observabilidad para proporcionar información en tiempo real, prevenir cambios disruptivos y optimizar el rendimiento de la aplicación, reduciendo significativamente el tiempo de resolución y el esfuerzo de ingeniería.

Calidad del Código
Visits 18.8KFavorites 125Likes 154
Incerto
Freemium

Incerto

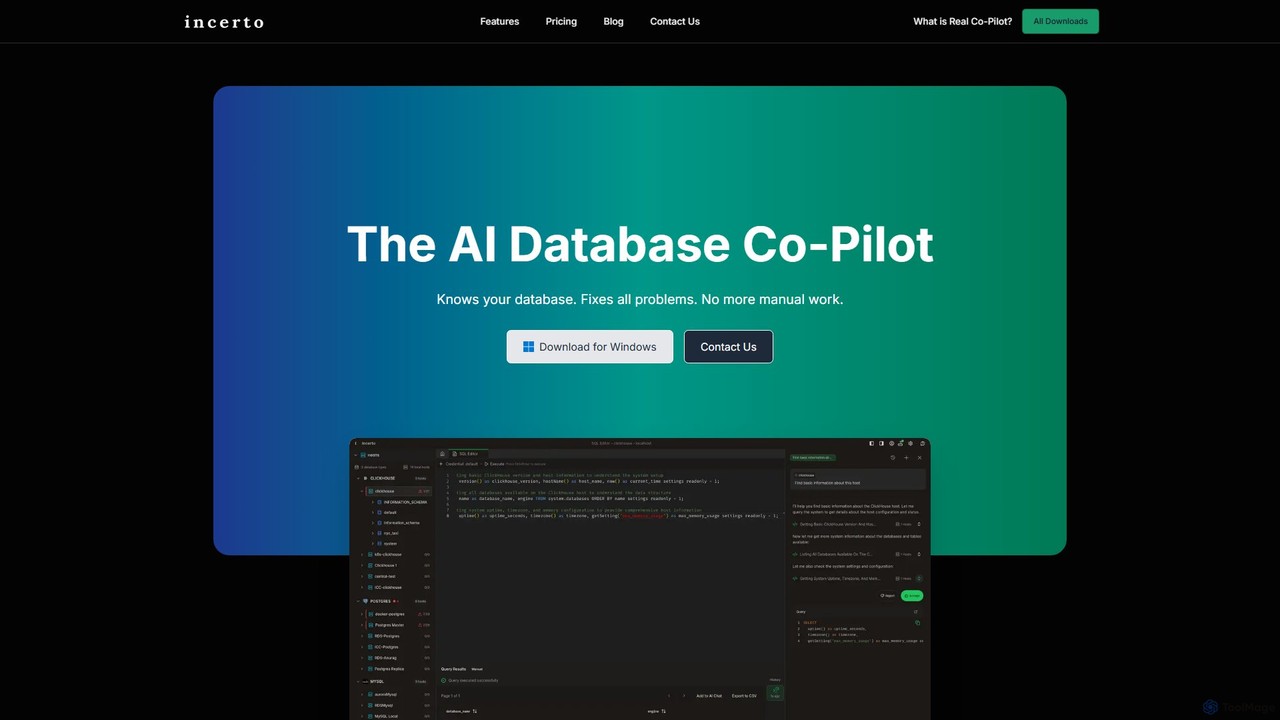
Incerto es un copiloto de IA agéntico diseñado para resolver todos los problemas de bases de datos. Detecta y resuelve proactivamente problemas de producción, optimiza el rendimiento de las consultas y automatiza tareas complejas de gestión de bases de datos. Al aprovechar un rico motor de contexto y agentes de IA especializados, Incerto reduce significativamente el trabajo manual, minimiza el tiempo de inactividad y mejora la eficiencia y seguridad general de las bases de datos para desarrolladores y DBAs.

Base de Datos
Visits 8.2KFavorites 95Likes 115
Resolve.ai
Paid

Resolve.ai

Resolve.ai es una plataforma de SRE con IA Agéntica que automatiza la respuesta a incidentes y el análisis de causa raíz. Actúa como un miembro virtual del equipo de guardia, investigando alertas, probando hipótesis e identificando problemas en minutos para reducir el MTTR, disminuir el agotamiento de los ingenieros y aumentar el tiempo de actividad del sistema.

Gestión de Incidentes
Visits 90.4KFavorites 194Likes 172

About Observabilidad

Las herramientas de Observabilidad son plataformas avanzadas diseñadas para proporcionar información profunda y consultable sobre el estado interno de sistemas de TI complejos. Funcionan recopilando, correlacionando y analizando datos de telemetría de alta cardinalidad, principalmente registros (logs), métricas y trazas. Esto permite a los equipos de ingeniería ir más allá de la simple monitorización para explorar y comprender activamente el comportamiento del sistema, lo que hace posible depurar problemas novedosos en entornos distribuidos. Estas herramientas son cruciales para mantener la fiabilidad y el rendimiento de las aplicaciones nativas de la nube modernas.

Funciones Clave

  • Datos de Telemetría Unificados: Ingiere y correlaciona los tres pilares de la observabilidad: registros, métricas y trazas distribuidas en una única plataforma.
  • Trazado Distribuido: Visualiza el recorrido de extremo a extremo de las solicitudes a medida que viajan a través de múltiples microservicios y componentes.
  • Análisis de Alta Cardinalidad: Permite consultar y filtrar datos basados en atributos arbitrarios, esencial para depurar sesiones de usuario o solicitudes específicas.
  • Detección de Anomalías con IA: Identifica automáticamente patrones inusuales o desviaciones del rendimiento base sin reglas preconfiguradas.
  • Mapeo de Dependencias de Servicios: Genera mapas en tiempo real de cómo interactúan los diferentes servicios y componentes de la infraestructura.

Casos de Uso

Las herramientas de observabilidad son utilizadas principalmente por ingenieros de DevOps, Ingenieros de Fiabilidad de Sitios (SRE) y desarrolladores de software que trabajan en sistemas complejos y distribuidos. Son esenciales para solucionar incidentes de producción en arquitecturas de microservicios, optimizar el rendimiento de las aplicaciones identificando cuellos de botella y comprender el impacto de las nuevas implementaciones de código en tiempo real. Estas plataformas también son valiosas para la gestión de infraestructuras en la nube y el análisis de seguridad.

Cómo Elegir

Al seleccionar una herramienta de Observabilidad, considere la compatibilidad de sus fuentes de datos y la amplitud de sus integraciones. Evalúe la potencia y la usabilidad de su lenguaje de consulta para explorar datos. Analice su escalabilidad para manejar su volumen de datos y su modelo de precios (por ejemplo, por host, por GB ingerido). Finalmente, considere la efectividad de sus herramientas de visualización, paneles y capacidades de alerta impulsadas por IA para el flujo de trabajo de su equipo.

Observabilidad use cases

1

Depurar fallos de microservicios en producción

Un Ingeniero de Fiabilidad de Sitios (SRE) recibe una alerta por altas tasas de error en el servicio de pago. Usando una plataforma de observabilidad, accede a la traza distribuida de una transacción fallida. La traza visualiza la ruta de la solicitud a través de los microservicios de autenticación, inventario y pago. Identifican rápidamente que el servicio de pago está agotando el tiempo de espera al llamar a una API de terceros. Al inspeccionar los registros asociados con ese ID de traza específico, encuentran el mensaje de error exacto, lo que les permite resolver el problema en minutos en lugar de horas.

2

Optimizar proactivamente el rendimiento de la aplicación

Un equipo de DevOps nota un aumento gradual en los tiempos de respuesta de la API. Utilizan una herramienta de observabilidad para analizar métricas de sus servidores de aplicaciones, bases de datos y cachés. Al crear un panel que correlaciona el uso de la CPU, la latencia de las consultas a la base de datos y las tasas de acierto de la caché, descubren una consulta de base de datos específica que se ha vuelto ineficiente a medida que los datos han crecido. La función de trazado distribuido confirma que esta consulta es el principal cuello de botella. El equipo optimiza la consulta y despliega la solución, reduciendo con éxito el tiempo de respuesta promedio de la API en un 40% antes de que afecte a los usuarios finales.

3

Comprender el impacto de las nuevas implementaciones de código

Un desarrollador de software implementa una nueva función que refactoriza una parte central de la aplicación. Inmediatamente después de la implementación, utiliza una plataforma de observabilidad para comparar métricas de negocio clave (como registros de usuarios) y métricas de rendimiento (como latencia y tasas de error) antes y después del cambio. Los paneles de la plataforma muestran un ligero aumento en la latencia pero una caída significativa en el uso de memoria. Este enfoque basado en datos permite al equipo validar que la refactorización fue exitosa y tuvo el impacto positivo previsto en el consumo de recursos sin afectar negativamente la experiencia del usuario.

4

Monitorear el uso y los costos de los recursos en la nube

Un ingeniero de la nube tiene la tarea de optimizar los costos de infraestructura. Utiliza una herramienta de observabilidad para recopilar métricas detalladas de su clúster de Kubernetes, incluido el uso de CPU/memoria por pod, el tráfico de red y las reclamaciones de volúmenes persistentes. Al visualizar estos datos, identifican varios servicios sobreaprovisionados que utilizan constantemente menos del 20% de sus recursos asignados. También detectan una fuga de memoria en un contenedor de aplicación específico. Basándose en estos conocimientos, ajustan las solicitudes y los límites de recursos para los servicios y corrigen la fuga, lo que resulta en una reducción del 25% en su factura mensual de la nube.

5

Correlacionar la salud del sistema con los KPI de negocio

Un gerente de producto de un sitio de comercio electrónico quiere entender por qué las tasas de abandono de carritos son altas. Usando una herramienta de observabilidad que se integra con análisis de negocio, crea un panel que superpone métricas técnicas (tiempo de carga de la página, errores de API) con métricas de negocio (artículos agregados al carrito, finalizaciones de compra). Descubre una fuerte correlación: cada vez que la latencia de la API de 'procesamiento de pagos' supera los 2 segundos, la tasa de abandono de carritos aumenta en un 50%. Este vínculo directo entre el rendimiento técnico y los resultados de negocio proporciona una justificación clara para priorizar los recursos de ingeniería para optimizar la API de pago.

6

Mejorar la seguridad con detección de anomalías

Un equipo de operaciones de seguridad (SecOps) utiliza una plataforma de observabilidad para ingerir registros de autenticación de todos los servicios. Configuran un monitor impulsado por IA para detectar anomalías en los patrones de inicio de sesión. El sistema marca automáticamente un aumento repentino en los intentos de inicio de sesión fallidos desde un rango de IP nunca antes visto, seguido de un inicio de sesión exitoso. Esto activa una alerta inmediata. El analista de seguridad investiga las trazas y los registros asociados, confirma que es un ataque de relleno de credenciales y bloquea rápidamente el rango de IP malicioso y fuerza un restablecimiento de contraseña para la cuenta comprometida, evitando una brecha mayor.

Observabilidad FAQ

¿Qué son las herramientas de Observabilidad con IA?

Las herramientas de Observabilidad con IA son plataformas que proporcionan información profunda sobre la salud y el rendimiento de sistemas de TI complejos. A diferencia del monitoreo tradicional, que rastrea métricas predefinidas, la observabilidad le permite hacer nuevas preguntas sobre el comportamiento de su sistema utilizando datos ricos de registros, métricas y trazas. El componente de 'IA' mejora esto al detectar automáticamente anomalías, predecir fallos e identificar causas raíz, ayudando a los equipos a resolver problemas desconocidos más rápido.

¿Cuál es la diferencia entre Observabilidad y Monitoreo?

El monitoreo consiste en rastrear la salud de un sistema basándose en un conjunto predefinido de métricas y registros, respondiendo a preguntas conocidas como '¿Está alto el uso de la CPU?'. La observabilidad es el siguiente paso; se trata de tener suficientes datos y herramientas para explorar su sistema y responder a preguntas desconocidas, como '¿Por qué la aplicación es lenta solo para los usuarios de una región específica?'. En resumen:

  • Monitoreo le dice cuándo algo está mal.
  • Observabilidad le ayuda a entender por qué está mal.
La observabilidad es crucial para sistemas complejos y distribuidos donde las fallas pueden ser impredecibles.

¿Cuáles son los tres pilares de la Observabilidad?

Los tres pilares de la observabilidad son los tipos principales de datos de telemetría utilizados para comprender el estado de un sistema. Son:

  • Registros (Logs): Registros de texto con marca de tiempo, no estructurados o estructurados, de eventos discretos. Son útiles para comprender los detalles de lo que sucedió en un momento determinado.
  • Métricas: Mediciones numéricas agregadas durante un período de tiempo, como el porcentaje de uso de la CPU o el recuento de solicitudes por segundo. Son buenas para paneles y alertas sobre tendencias.
  • Trazas (o Trazas Distribuidas): Una representación del viaje completo de una sola solicitud a medida que se mueve a través de todos los diferentes servicios en una aplicación. Son esenciales para depurar la latencia y los errores en arquitecturas de microservicios.

¿Cómo elijo la herramienta de Observabilidad adecuada?

Elegir la herramienta de observabilidad adecuada depende de sus necesidades específicas. Considere estos factores:

  • Compatibilidad de datos: ¿La herramienta es compatible con los lenguajes, frameworks e infraestructura que utiliza? Verifique una amplia gama de integraciones.
  • Escalabilidad: ¿Puede la plataforma manejar su volumen de datos actual y futuro sin degradación del rendimiento o costos excesivos?
  • Consulta y visualización: ¿Qué tan fácil es consultar sus datos y construir paneles significativos? Un lenguaje de consulta potente pero intuitivo es clave.
  • Modelo de precios: Comprenda la estructura de costos. ¿Se basa en la ingesta de datos, el número de hosts, los usuarios o una combinación? Modele su uso esperado para evitar sorpresas.
  • IA y automatización: Evalúe las capacidades de IA de la herramienta para la detección de anomalías, el análisis de causa raíz y las alertas inteligentes para reducir el esfuerzo manual.

¿Quién debería usar herramientas de Observabilidad?

Las herramientas de observabilidad son más beneficiosas para los equipos técnicos responsables de construir y mantener aplicaciones de software modernas. Los usuarios clave incluyen:

  • Ingenieros de DevOps y SREs: Para mantener la fiabilidad del sistema, solucionar incidentes y gestionar el rendimiento de la infraestructura.
  • Desarrolladores de software: Para entender cómo se comporta su código en producción, depurar problemas complejos y medir el impacto de nuevas características.
  • Equipos de operaciones de TI: Para una comprensión más profunda de la salud del sistema más allá de las métricas de monitoreo tradicionales.
  • Analistas de seguridad: Para analizar registros y trazas en busca de amenazas de seguridad y comportamiento anómalo.
Esencialmente, cualquiera que necesite responder 'por qué' está sucediendo algo dentro de un entorno de TI complejo puede beneficiarse de la observabilidad.