
ToolMage
Iniciar sesión

Best 1 Benchmarking AI tools for Investigación

Popular Benchmarking AI tools in Investigación include LMArena, helping you work more efficiently.

LMArena
Free

LMArena

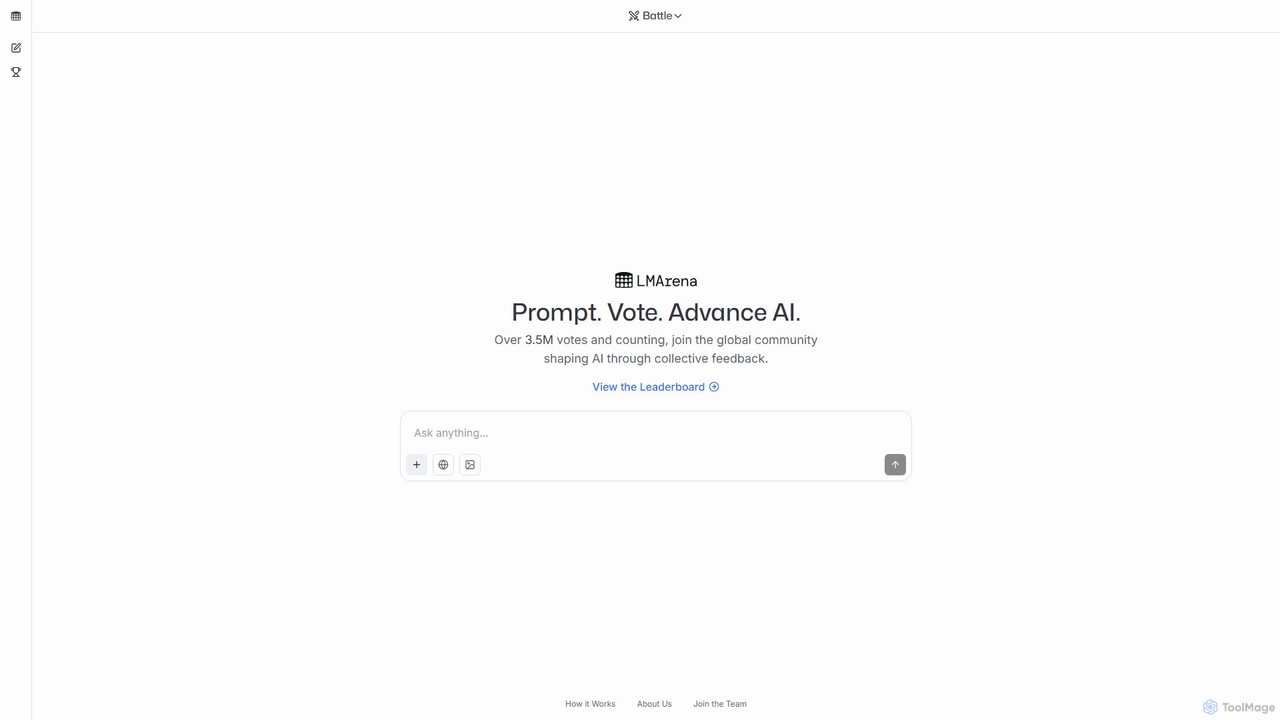
LMArena es una plataforma abierta y de crowdsourcing de investigadores de UC Berkeley para evaluar y comparar los principales modelos de IA. Los usuarios prueban anónimamente dos modelos uno al lado del otro, votan por la mejor respuesta y contribuyen a una tabla de clasificación pública y dinámica. Su objetivo es hacer que el progreso de la IA sea transparente y se base en la retroalimentación humana del mundo real.

Inteligencia Artificial
Visits 631.4KFavorites 141Likes 112

About Benchmarking

Las herramientas de Benchmarking de IA son una clase de software diseñado para medir, comparar y clasificar sistemáticamente el rendimiento de modelos y sistemas de IA. Operan ejecutando pruebas estandarizadas en varios modelos utilizando conjuntos de datos consistentes y métricas de evaluación, como precisión, velocidad o consumo de recursos. Este proceso proporciona información objetiva y basada en datos, permitiendo a desarrolladores e investigadores identificar los modelos más efectivos para tareas específicas y seguir el progreso en el campo. Como parte clave del conjunto de herramientas de Investigación de IA, estas herramientas son esenciales para validar las capacidades del modelo y garantizar la transparencia en el desarrollo de la IA.

Características Clave

  • Suites de Pruebas Estandarizadas: Proporciona colecciones predefinidas de conjuntos de datos y tareas para evaluar modelos en áreas como PNL y visión por computadora.
  • Seguimiento de Métricas de Rendimiento: Automatiza el cálculo y la visualización de métricas clave como precisión, puntuación F1, latencia y rendimiento.
  • Tablas de Clasificación Comparativas: Genera clasificaciones públicas o privadas de diferentes modelos basadas en su rendimiento en benchmarks específicos.
  • Análisis de Uso de Recursos: Monitorea e informa sobre los costos computacionales, incluido el uso de CPU/GPU y el consumo de memoria durante las pruebas.
  • Marcos de Reproducibilidad: Asegura que los experimentos puedan ser repetidos de manera fiable por otros mediante instantáneas de entorno o contenedorización.

Casos de Uso

Las herramientas de Benchmarking de IA son utilizadas principalmente por laboratorios de investigación de IA, instituciones académicas y equipos de I+D empresariales. Son críticas en campos como el desarrollo de grandes modelos de lenguaje (LLM), la investigación en visión por computadora y las pruebas de sistemas autónomos para validar nuevas arquitecturas y compararlas con los modelos más avanzados.

Cómo Elegir

Al seleccionar una herramienta, considere los tipos de modelos y frameworks soportados (p. ej., PyTorch, TensorFlow). Evalúe la amplitud y relevancia de las suites de benchmark disponibles para su dominio. Verifique las capacidades de integración con plataformas MLOps e infraestructura en la nube, y evalúe la claridad de sus funciones de informes y visualización para un análisis más fácil.

Benchmarking use cases

1

Comparar el rendimiento de LLM para el desarrollo de chatbots

Un equipo de desarrollo necesita seleccionar el mejor Modelo de Lenguaje Grande (LLM) para su nuevo chatbot de servicio al cliente. Utilizan una herramienta de benchmarking para evaluar tres modelos diferentes en un conjunto de datos personalizado de consultas de usuarios. La herramienta mide sistemáticamente la precisión de la respuesta, la relevancia y la latencia de cada modelo. Luego, genera una tabla de clasificación comparativa, proporcionando una base clara y basada en datos para seleccionar el modelo más rentable y de mayor rendimiento, asegurando una experiencia de usuario de alta calidad.

2

Validar modelos de visión por computadora para control de calidad

Una empresa de fabricación está probando varios modelos de detección de objetos para identificar defectos en una línea de producción. Utilizando una plataforma de benchmarking, cargan su conjunto de datos propietario de imágenes de productos. La plataforma ejecuta pruebas estandarizadas para comparar la precisión, el recall y la velocidad de inferencia de cada modelo en hardware de borde específico. El informe resultante les permite implementar el sistema más fiable y eficiente, minimizando los errores de producción.

3

Investigación académica y publicación de artículos

Un grupo de investigación universitario desarrolla una nueva arquitectura de red neuronal. Para demostrar su superioridad sobre los métodos existentes, utilizan una herramienta de benchmarking pública. Ejecutan su modelo en conjuntos de datos académicos establecidos como ImageNet o SQuAD y comparan sus resultados con los de los modelos de vanguardia que figuran en las tablas de clasificación públicas. Esto proporciona evidencia verificable y reproducible del rendimiento de su modelo, fortaleciendo su artículo de investigación y contribuyendo a la comunidad científica.

4

Optimizar la eficiencia del algoritmo para reducir costos en la nube

Un equipo de MLOps tiene como objetivo reducir los costos operativos de sus servicios de IA. Utilizan una herramienta de benchmarking para analizar el consumo de recursos (tiempo de GPU, memoria) de sus modelos implementados bajo diversas condiciones de carga. La herramienta les ayuda a identificar modelos ineficientes y a probar versiones optimizadas una al lado de la otra. Al comparar la relación rendimiento-costo, pueden seleccionar e implementar variantes de modelos que ofrecen una precisión similar con una reducción cuantificable en su factura mensual de computación en la nube.

5

Pruebas de regresión en pipelines de CI/CD para IA

Una empresa de software integra una herramienta de benchmarking de IA en su pipeline de CI/CD. Cada vez que un desarrollador confirma una actualización de un modelo, el pipeline activa automáticamente una prueba de benchmark contra un conjunto de datos de referencia. Esto asegura que los cambios recientes no hayan afectado negativamente el rendimiento o la precisión. Si se detecta una regresión (por ejemplo, la precisión cae un 2%), la compilación falla, evitando que un modelo degradado llegue a producción y manteniendo la calidad del servicio.

6

Seleccionar APIs de IA de terceros según el rendimiento

Una startup necesita elegir una API de terceros para la transcripción de voz a texto. En lugar de confiar en las afirmaciones de marketing, utilizan una herramienta de benchmarking para enviar el mismo conjunto de archivos de audio a múltiples proveedores. La herramienta mide y compara objetivamente la Tasa de Error de Palabra (WER), el tiempo de procesamiento y el costo por solicitud para cada servicio. Este enfoque basado en datos les permite seleccionar la API que ofrece el mejor equilibrio entre precisión y costo para su caso de uso específico.

Benchmarking FAQ

¿Qué son las herramientas de Benchmarking de IA?

Las herramientas de Benchmarking de IA son plataformas especializadas que se utilizan para evaluar y comparar sistemáticamente el rendimiento de diferentes modelos o sistemas de IA. Proporcionan un entorno controlado, conjuntos de datos estandarizados y métricas consistentes para producir mediciones objetivas y repetibles de capacidades como la precisión, la velocidad y la eficiencia. Esto permite a los desarrolladores e investigadores clasificar varios modelos y seguir el progreso tecnológico a lo largo del tiempo.

¿Cómo elijo la herramienta de Benchmarking de IA adecuada?

Para elegir la herramienta adecuada, considere estos factores clave:

  • Cobertura de Benchmarks: Asegúrese de que admita las tareas y dominios relevantes para su trabajo (p. ej., PNL, visión por computadora, reconocimiento de voz).
  • Compatibilidad de Frameworks: Verifique si funciona con sus frameworks de modelos preferidos, como PyTorch, TensorFlow u ONNX.
  • Personalización: Determine si puede usar sus propios conjuntos de datos privados y definir métricas de evaluación personalizadas.
  • Integración: Evalúe su capacidad para integrarse con su flujo de trabajo MLOps existente, pipelines de CI/CD y entorno en la nube.
¿Cuál es la diferencia entre Benchmarking y Evaluación de Modelos?

La evaluación de modelos es un término general para valorar el rendimiento de un solo modelo en un conjunto de datos. El benchmarking es una forma de evaluación más estructurada y comparativa. Implica probar múltiples modelos en los mismos conjuntos de datos y tareas estandarizadas bajo condiciones controladas para crear una comparación formal o una tabla de clasificación. La diferencia clave es que el benchmarking enfatiza la comparación estandarizada y reproducible entre múltiples modelos, mientras que la evaluación puede ser una valoración única de un solo modelo.

¿Cuáles son algunas métricas comunes utilizadas en el benchmarking de IA?

Las métricas varían significativamente según la tarea. Algunos ejemplos comunes incluyen:

  • Tareas de clasificación: Precisión, Recall y Puntuación F1 se utilizan ampliamente para medir la corrección.
  • Modelos de lenguaje: Perplejidad (para modelado de lenguaje) y puntuaciones BLEU/ROUGE (para traducción y resumen) son estándar.
  • Detección de objetos: La Precisión Media Promedio (mAP) es una métrica clave.
  • Rendimiento del sistema: Latencia (tiempo de respuesta), Rendimiento (consultas por segundo) y uso de recursos (ciclos de GPU/CPU, memoria) son críticos para la preparación para producción.
¿Quién debería usar las herramientas de Benchmarking de IA?

Las herramientas de Benchmarking de IA son principalmente para usuarios técnicos involucrados en el ciclo de vida del desarrollo de IA. Esto incluye a investigadores de IA/ML que validan nuevas arquitecturas, científicos de datos que comparan modelos para un problema de negocio específico, e ingenieros de MLOps que monitorean el rendimiento del modelo y previenen regresiones en producción. Esencialmente, cualquiera que necesite tomar decisiones objetivas y basadas en datos sobre la elección, implementación o mejora de modelos de IA puede beneficiarse de estas herramientas.