ToolMage
Iniciar sesión

AI TOOL COMPARISON

Browserless vs Foxscrape

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

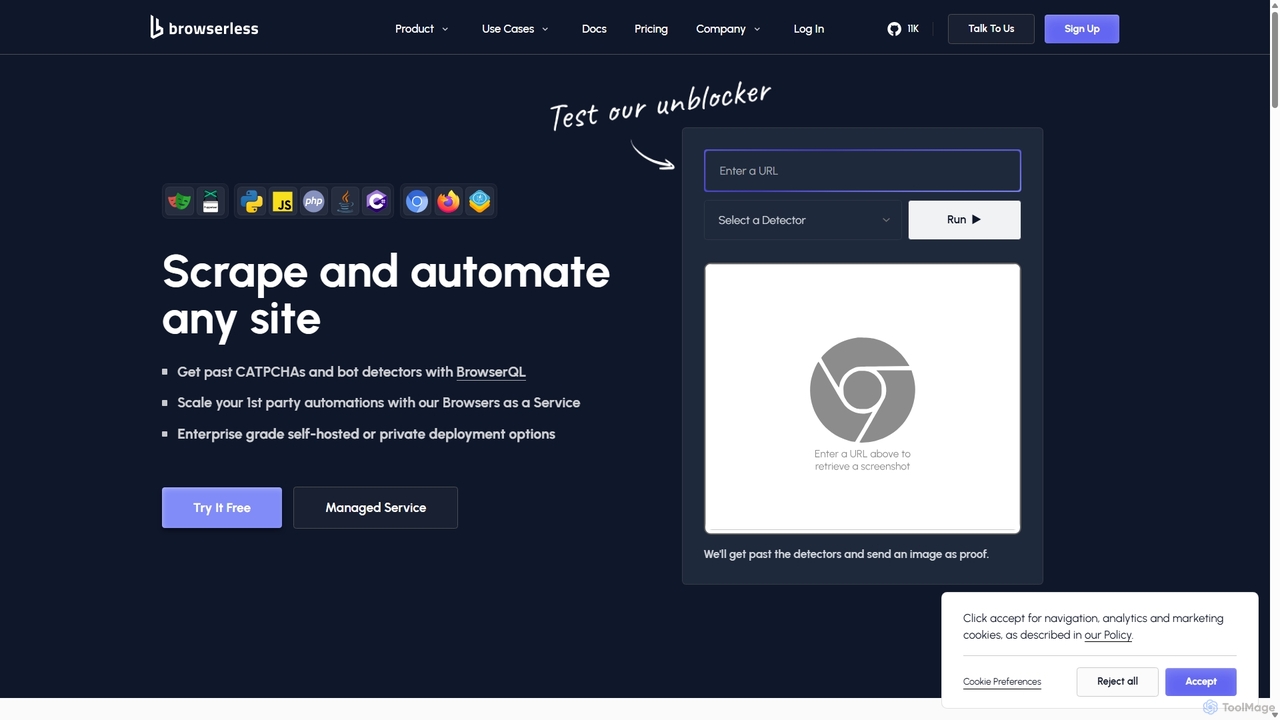
Browserless Resumen del producto

Browserless es una potente plataforma de Navegador como Servicio (BaaS) diseñada para el web scraping escalable y la automatización de navegadores. Ayuda a los desarrolladores a eludir CAPTCHAs y detectores de bots sin esfuerzo utilizando Puppeteer, Playwright o su lenguaje propietario BrowserQL. El servicio gestiona la infraestructura del navegador, permitiendo a los usuarios centrarse en la creación de scripts de automatización sin preocuparse por actualizaciones, fugas de memoria o escalado.

Preview

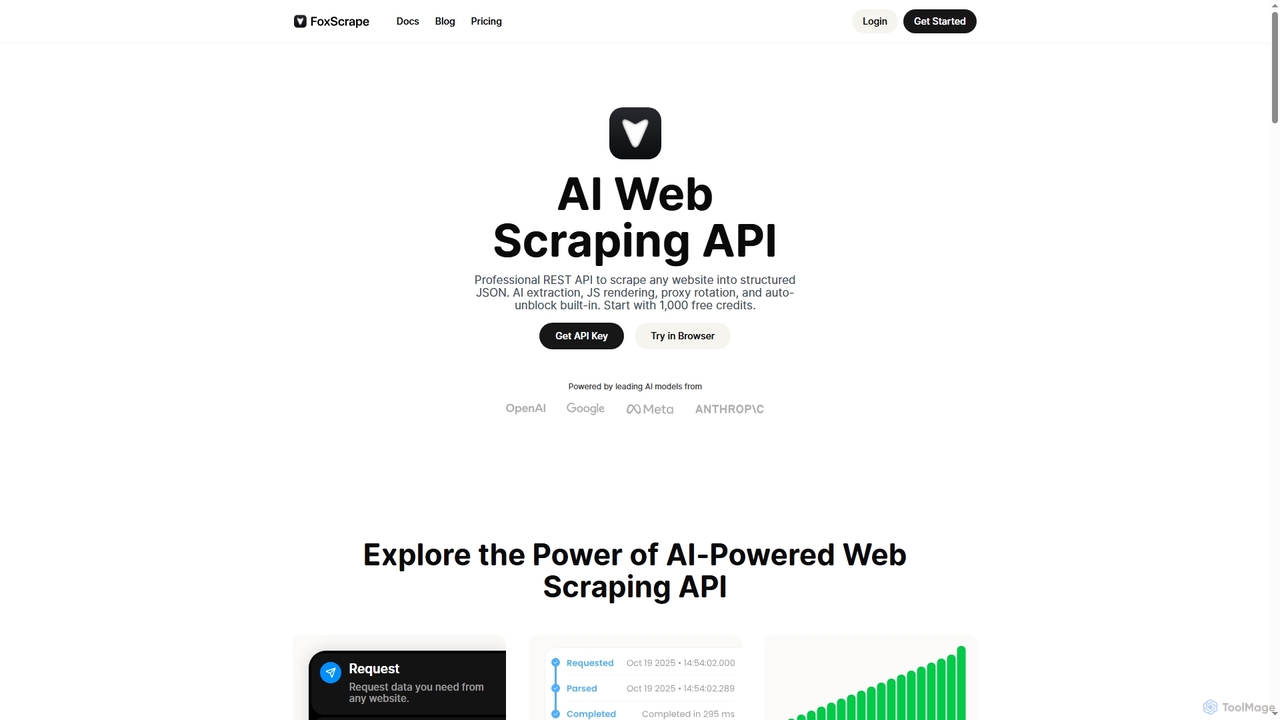
Foxscrape Resumen del producto

FoxScrape es una API REST de web scraping impulsada por IA para desarrolladores. Simplifica la extracción de datos convirtiendo cualquier sitio web en datos JSON estructurados mediante funciones como el análisis basado en IA a partir de inglés simple, la renderización de JavaScript para sitios dinámicos y la rotación automática de proxies para evitar bloqueos.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Browserless VS Foxscrape — Datos clave
Datos claveBrowserlessFoxscrape
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusExtracción de DatosExtracción de Datos
Audiencia y rolesAnalista de Datos · Científico de Datos · Ingeniero de DevOps · Gerente de Marketing · Gerente de Producto · Ingeniero de QA · Desarrollador de SoftwareAnalista de Negocios · Analista de Datos · Científico de Datos · Gerente de Marketing · Gerente de Producto · Desarrollador de Software
CategoríasExtracción de Datos · Web Scraping · AutomatizaciónExtracción de Datos · API · Automatización
Added15 sept 20255 nov 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Browserless

Browserless es una plataforma integral basada en la nube que proporciona instancias de navegador sin cabeza para una amplia gama of tareas de automatización web y extracción de datos. Está diseñada para resolver los desafíos comunes que enfrentan los desarrolladores al trabajar con navegadores sin cabeza a escala, como la gestión de infraestructura, problemas de rendimiento y la evasión de sofisticados sistemas de detección de bots. Al ofrecer un robusto conjunto de navegadores gestionados, Browserless permite a los desarrolladores y empresas centrarse en su lógica principal en lugar de en las complejidades de desplegar y mantener sistemas de automatización de navegadores.

El servicio cuenta con la confianza de miles de empresas, desde startups hasta grandes corporaciones, por su fiabilidad, escalabilidad y características avanzadas. Ofrece tanto servicios gestionados en la nube como soluciones empresariales autoalojadas, proporcionando flexibilidad para diferentes necesidades de seguridad y cumplimiento, incluida la conformidad con SOC 2 Tipo II.

Cómo usar Browserless

Browserless ofrece múltiples formas de integrar sus servicios en tu flujo de trabajo, haciéndolo accesible para diversos niveles de habilidad y requisitos de proyecto:

  1. Conectar con Puppeteer o Playwright: La forma más fácil de empezar es conectando tus scripts existentes de Puppeteer o Playwright. En lugar de lanzar una instancia de navegador local, simplemente cambias el método de conexión para que apunte a un punto final WebSocket de Browserless. Esto requiere cambios mínimos en el código y escala instantáneamente tus automatizaciones existentes.
  2. Usar APIs REST: Para tareas comunes como generar PDFs, tomar capturas de pantalla o extraer contenido HTML, Browserless proporciona APIs REST sencillas. Puedes realizar una solicitud cURL o usar cualquier cliente HTTP para realizar estas acciones sin escribir complejos scripts de automatización de navegador.
  3. Aprovechar BrowserQL: Para casos de uso avanzados, especialmente aquellos que implican eludir detectores de bots difíciles (como Cloudflare), Browserless ofrece BrowserQL. Este es un lenguaje de automatización e IDE de última generación diseñado para dejar mínimas huellas digitales. Puedes escribir consultas concisas para realizar acciones complejas como hacer clic en botones, resolver CAPTCHAs y extraer datos estructurados, todo mientras pareces más humano para los sistemas de detección.
  4. Automatizaciones Híbridas: Browserless admite flujos de trabajo híbridos donde puedes transmitir una sesión de navegador a un iframe. Esto es útil para tareas que requieren intervención manual, como resolver un CAPTCHA complejo, introducir códigos 2FA o gestionar inicios de sesión OAuth dentro de un script automatizado.

Características principales de Browserless

  • BrowserQL: Un lenguaje de consulta e IDE propietario construido desde cero para eludir los detectores de bots más avanzados minimizando las huellas digitales del navegador.
  • Navegador como Servicio (BaaS): Un conjunto escalable y gestionado de miles de navegadores, que se encarga de todos los aspectos de la infraestructura como actualizaciones de versión, balanceo de carga y gestión de recursos.
  • Evasión de Detección de Bots y CAPTCHA: Tecnología especializada para resolver automáticamente CAPTCHAs (reCAPTCHA, hCaptcha) y superar servicios de bloqueo de bots como Cloudflare.
  • Integración con Puppeteer y Playwright: Compatibilidad perfecta con las dos bibliotecas de automatización de navegadores más populares.
  • APIs REST: Puntos finales sencillos para tareas comunes como generación de PDF, capturas de pantalla y scraping de contenido.
  • Gestión de Sesiones y Reconexiones: La capacidad de mantener vivas las sesiones del navegador y reconectarse a ellas, lo que reduce significativamente el uso de proxies y evita comprobaciones repetitivas de bots.
  • Soluciones de Nivel Empresarial: Opciones de autoalojamiento, despliegues en nube privada, configuraciones de máquina personalizadas (incluidas GPUs), SSO, soporte dedicado y cumplimiento de SOC 2 Tipo II.
  • Monitorización y Depuración: Un panel de control fácil de usar que proporciona métricas sobre solicitudes, estado de los workers (CPU/memoria) y un depurador para ver la ejecución de los scripts en tiempo real.

Casos de uso para Browserless

Browserless es versátil y se puede aplicar a numerosos escenarios:

  • Web Scraping y Extracción de Datos: Recopilación de datos de sitios web dinámicos y con mucho JavaScript, plataformas de comercio electrónico (p. ej., Walmart, eBay), listados de bienes raíces (Zillow) y bolsas de trabajo (Indeed).
  • Pruebas de Software Automatizadas: Ejecución de pruebas de extremo a extremo para aplicaciones web a escala, integrándose con frameworks como Laravel Dusk sin la necesidad de gestionar una compleja Selenium Grid.
  • Ingesta de Datos para IA y LLM: Potenciar agentes de IA (p. ej., usando LangChain o CrewAI) con acceso web en tiempo real para recopilar datos frescos para entrenar modelos de lenguaje grandes o realizar investigaciones automatizadas.
  • Generación de Informes: Generación automática de PDFs y capturas de pantalla de paneles de control, informes de análisis o facturas desde aplicaciones web.
  • Monitorización de Precios y Competencia: Seguimiento de precios de productos, niveles de inventario y estrategias de la competencia en varios minoristas en línea.

Ventajas de Browserless

Usar Browserless proporciona varias ventajas clave:

  • Reducción de la Carga Operativa: Elimina la necesidad de un equipo dedicado para construir, desplegar y mantener una compleja infraestructura de automatización de navegadores.
  • Tasas de Éxito Mejoradas: Sus avanzadas técnicas de evasión de bots, particularmente con BrowserQL, conducen a mayores tasas de éxito en el scraping de sitios web protegidos.
  • Escalabilidad bajo Demanda: Escala sin esfuerzo desde unas pocas sesiones concurrentes hasta miles, manejando picos de tráfico sin degradación del rendimiento.
  • Eficiencia de Costos: Características como las reconexiones de sesión pueden reducir los costos de proxy hasta en un 90%. El modelo de precios basado en unidades es predecible y rentable.
  • Enfocado en el Desarrollador: Diseñado por desarrolladores para desarrolladores, con excelente documentación, SDKs y soporte técnico receptivo.

Precios y planes

Browserless ofrece un modelo de precios flexible basado en unidades para adaptarse a diferentes necesidades:

  • Plan Gratuito: Incluye 1,000 unidades al mes, 1 navegador concurrente máximo y acceso al editor de BrowserQL. No se requiere tarjeta de crédito.
  • Plan de Prototipado: Comienza en $25/mes (facturado anualmente) por 20,000 unidades y 3 navegadores concurrentes. Ideal para pequeños proyectos y pruebas.
  • Plan de Inicio: Comienza en $140/mes (facturado anualmente) por 180,000 unidades y 20 navegadores concurrentes, adecuado para aplicaciones en crecimiento.
  • Plan de Escala: Comienza en $350/mes (facturado anualmente) por 500,000 unidades y 50 navegadores concurrentes, diseñado para operaciones de alto volumen.
  • Plan Empresarial: Precios personalizados para usuarios que necesitan millones de unidades, despliegues privados, autoalojamiento, características avanzadas como infraestructura de GPU, SSO y un gestor de cuentas técnico dedicado.

Una "Unidad" corresponde a hasta 30 segundos de tiempo de navegador. Las sesiones más largas consumen unidades adicionales. Las unidades también se utilizan para proxies residenciales y resoluciones de CAPTCHA exitosas.

Foxscrape

FoxScrape proporciona una API REST profesional diseñada para agilizar el proceso de web scraping para los desarrolladores. Permite a los usuarios extraer datos estructurados de cualquier sitio web y recibirlos en un formato JSON limpio. La plataforma está diseñada para ser potente pero fácil de usar, dirigida tanto a principiantes como a profesionales experimentados. Utiliza miles de instancias de Chrome sin cabeza para garantizar que las solicitudes de la API se comporten como un usuario real, eludiendo las medidas anti-bot comunes y extrayendo datos de forma fiable a escala.

Cómo usar Foxscrape

Para usar FoxScrape, los desarrolladores pueden comenzar obteniendo una clave de API gratuita que incluye 1,000 créditos. La integración es sencilla: realice una llamada a la API REST al punto final de FoxScrape, incluyendo su clave de API en el encabezado 'Authorization' y la URL de destino como parámetro. Para sitios web dinámicos construidos con frameworks como React o Vue, simplemente habilite el parámetro 'render_js'. Para una extracción inteligente, describa los datos requeridos en inglés simple, y la IA se encargará del análisis sin necesidad de selectores CSS o XPath.

Características principales de Foxscrape

  • Scraping con IA: Extrae datos utilizando indicaciones en inglés simple, adaptándose automáticamente a los cambios de diseño del sitio web.
  • Renderización de JavaScript: Renderiza completamente sitios web modernos y dinámicos y aplicaciones de una sola página (SPA) utilizando Chrome sin cabeza.
  • Rotación automática de proxies: Utiliza un gran grupo de proxies premium distribuidos geográficamente para evitar prohibiciones de IP, CAPTCHAs y límites de velocidad.
  • Salida de datos estructurados: Analiza el contenido HTML y devuelve datos limpios y estructurados en formato JSON.
  • API de capturas de pantalla: Captura capturas de pantalla de página completa o parciales de sitios web con opciones personalizables.
  • API de scraping de SERP: Funcionalidad especializada para extraer resultados de motores de búsqueda como Google, Bing y otros a escala.

Casos de uso para Foxscrape

FoxScrape es ideal para una variedad de tareas de extracción de datos. Los desarrolladores y analistas de datos pueden usarlo para el monitoreo de precios en sitios de comercio electrónico, la recopilación de listados de bienes raíces, la agregación de reseñas de clientes, la realización de investigaciones de mercado extrayendo datos de la competencia y la extracción de resultados de motores de búsqueda para análisis de SEO. Su capacidad para manejar sitios complejos también lo hace adecuado para extraer datos de portales financieros, redes sociales y sitios de noticias.

Ventajas de Foxscrape

La principal ventaja de FoxScrape es su inteligencia y fiabilidad. La extracción impulsada por IA elimina la necesidad de selectores CSS frágiles, lo que hace que los scrapers sean más resistentes a las actualizaciones de los sitios web. La rotación de proxies incorporada y la renderización a nivel de navegador garantizan altas tasas de éxito y evitan el bloqueo. Ofrece una solución todo en uno que combina un scraper, un renderizador y un administrador de proxies en una única API escalable, ahorrando a los desarrolladores un tiempo y esfuerzo significativos en comparación con la construcción y el mantenimiento de una configuración propia.

Precios y planes

FoxScrape ofrece un modelo de precios transparente con una prueba gratuita. Los nuevos usuarios reciben 1,000 créditos de API gratuitos sin necesidad de una tarjeta de crédito.

  • Plan Starter: $20/mes por 150,000 créditos de API, 20 solicitudes concurrentes y acceso a todas las funciones principales, incluido el AI Scraper, la renderización de JavaScript, los proxies y las capturas de pantalla.
  • Plan Pro: $79/mes por 1,000,000 de créditos de API, 100 solicitudes concurrentes, soporte prioritario y todas las funciones Pro.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de DatosAutomatización
Solo Browserless
Web Scraping
Solo Foxscrape
API

Etiquetas

Compartido
APIExtracción de datosWeb scraping
Solo Browserless
Detección de botsAutomatización de navegadorResolución de captchaminería de datosNavegador headlessPlaywrightPuppeteer
Solo Foxscrape
Raspado de datos con IAautomatizaciónherramienta para desarrolladoresRenderizado JavaScriptJSONRotación de proxyAPI RESTRaspado de SERP

Audiencia y roles

Compartido
Analista de DatosCientífico de DatosGerente de MarketingGerente de ProductoDesarrollador de Software
Solo Browserless
Ingeniero de DevOpsIngeniero de QA
Solo Foxscrape
Analista de Negocios

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Browserless monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
242.1K
Duración media
1:17
Páginas por visita
2.45
Tasa de rebote
56.01%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 126.9K
  • 2026-01: 150.9K
  • 2026-02: 150.8K
  • 2026-03: 157.8K
  • 2026-04: 148.9K
  • 2026-05: 242.1K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil28.09%68K
🇺🇸United States26.55%64.3K
🇨🇭Switzerland23.8%57.6K
🇨🇦Canada11.55%28K
🇪🇸Spain10.01%24.2K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo81.79%198K
Referido13.74%33.3K
Correo electrónico4.47%10.8K

Palabras clave

browserlessbrowserless apibrowserless iomemory leak fixplaywright vs selenium

Foxscrape monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
1.6K
Duración media
0:00
Páginas por visita
1.04
Tasa de rebote
37.11%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: Sin verificar
  • 2026-01: 0
  • 2026-02: 0
  • 2026-03: 321
  • 2026-04: 1.8K
  • 2026-05: 1.6K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil27.03%439
🇨🇭Switzerland25.81%419
🇮🇳India25.7%417
🇦🇹Austria15.65%254
🇺🇸United States5.81%94

Palabras clave

apify commpetetorelixir scrapperhow to scrape data from a websitenimblewaynimbleway proxies

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Browserless

Valoración
Sin verificar
Comentarios
0
Favoritos
178
Me gusta
165

Foxscrape

Valoración
Sin verificar
Comentarios
0
Favoritos
187
Me gusta
189

Browserless vs Foxscrape · Preguntas frecuentes

What do Browserless and Foxscrape have in common?
Both tools are listed under Extracción de Datos、Automatización. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Browserless and Foxscrape free?
Listed pricing models: Browserless — Freemium; Foxscrape — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Browserless and Foxscrape?
The primary listed category is Extracción de Datos for Browserless, and Extracción de Datos for Foxscrape. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Foxscrape · Preguntas frecuentes

¿Puede la API de Foxscrape manejar sitios con mucho JavaScript y aplicaciones de una sola página?

Sí, Foxscrape está diseñado para extraer datos de sitios web modernos. Al habilitar el parámetro `render_js` en su solicitud de API, el servicio utiliza instancias de Chrome sin cabeza para renderizar completamente cualquier sitio construido con frameworks como React, Vue o Angular, lo que le permite extraer contenido dinámico.

¿Cómo integro la API de web scraping de Foxscrape en mi aplicación?

Puede integrar Foxscrape realizando solicitudes HTTP a su punto final de API REST. Según la documentación, debe incluir su clave de API en el encabezado `Authorization` como un token Bearer (por ejemplo, `Authorization: Bearer YOUR_API_KEY`). La documentación proporciona ejemplos para cURL y la API `fetch` de JavaScript para que pueda comenzar rápidamente.

¿Cómo evita Foxscrape ser bloqueado durante el scraping?

Foxscrape emplea un sistema de rotación automática de proxies que utiliza un gran grupo de proxies premium distribuidos geográficamente. Esta función rota automáticamente las direcciones IP para sus solicitudes, reduciendo significativamente las posibilidades de encontrar límites de velocidad, CAPTCHAs y prohibiciones de IP de los sitios web de destino.

¿Qué sucede si una solicitud de API falla?

La API de Foxscrape utiliza códigos de estado HTTP estándar para indicar el resultado de una solicitud. Según la documentación, una solicitud exitosa devuelve un código de estado `200`. Los errores se indican con códigos como `400` para solicitudes incorrectas (parámetros faltantes/inválidos), `401` para una clave de API no válida o `500` para un error interno del servidor.

¿Cuáles son los planes de precios disponibles para Foxscrape?

Foxscrape ofrece dos planes de pago principales: el plan Starter por $20/mes para 150,000 créditos de API y 20 solicitudes concurrentes, y el plan Pro por $79/mes para 1,000,000 de créditos de API y 100 solicitudes concurrentes. También hay una prueba gratuita que proporciona 1,000 créditos de API a los nuevos usuarios sin requerir una tarjeta de crédito.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas