

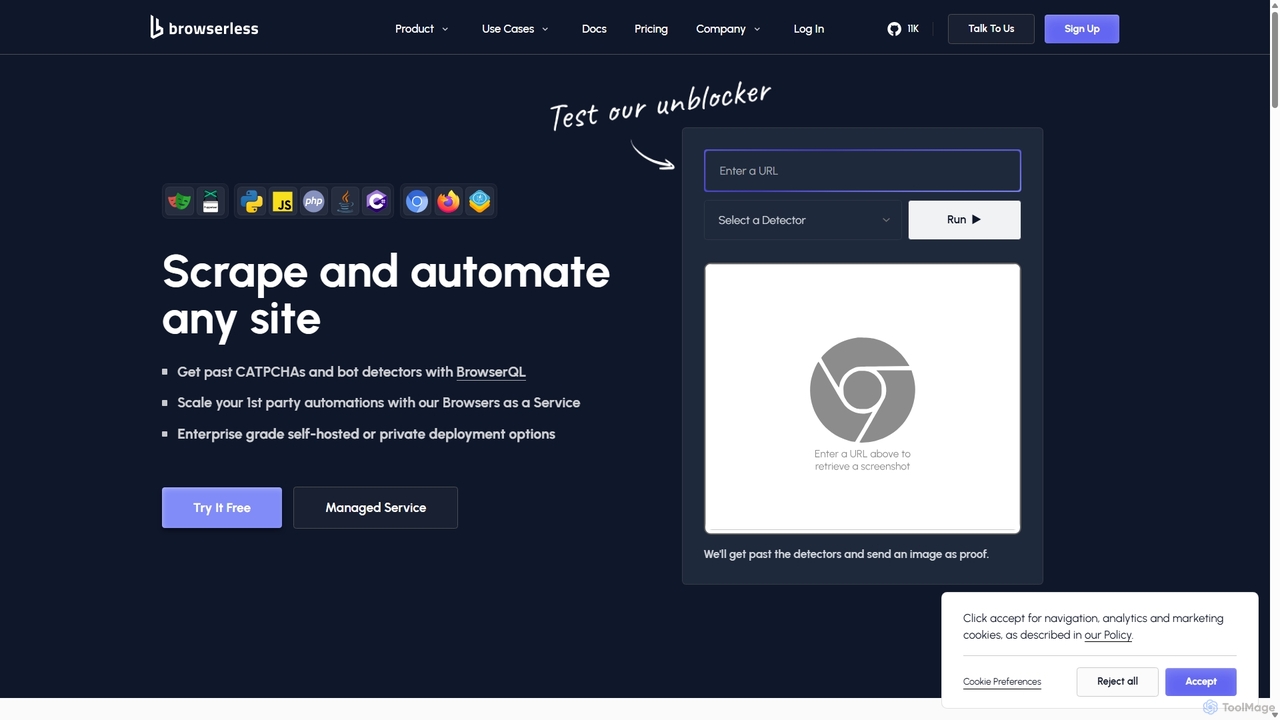
Browserless Overview
Browserless es una plataforma integral basada en la nube que proporciona instancias de navegador sin cabeza para una amplia gama of tareas de automatización web y extracción de datos. Está diseñada para resolver los desafíos comunes que enfrentan los desarrolladores al trabajar con navegadores sin cabeza a escala, como la gestión de infraestructura, problemas de rendimiento y la evasión de sofisticados sistemas de detección de bots. Al ofrecer un robusto conjunto de navegadores gestionados, Browserless permite a los desarrolladores y empresas centrarse en su lógica principal en lugar de en las complejidades de desplegar y mantener sistemas de automatización de navegadores.
El servicio cuenta con la confianza de miles de empresas, desde startups hasta grandes corporaciones, por su fiabilidad, escalabilidad y características avanzadas. Ofrece tanto servicios gestionados en la nube como soluciones empresariales autoalojadas, proporcionando flexibilidad para diferentes necesidades de seguridad y cumplimiento, incluida la conformidad con SOC 2 Tipo II.
Cómo usar Browserless
Browserless ofrece múltiples formas de integrar sus servicios en tu flujo de trabajo, haciéndolo accesible para diversos niveles de habilidad y requisitos de proyecto:
- Conectar con Puppeteer o Playwright: La forma más fácil de empezar es conectando tus scripts existentes de Puppeteer o Playwright. En lugar de lanzar una instancia de navegador local, simplemente cambias el método de conexión para que apunte a un punto final WebSocket de Browserless. Esto requiere cambios mínimos en el código y escala instantáneamente tus automatizaciones existentes.
- Usar APIs REST: Para tareas comunes como generar PDFs, tomar capturas de pantalla o extraer contenido HTML, Browserless proporciona APIs REST sencillas. Puedes realizar una solicitud cURL o usar cualquier cliente HTTP para realizar estas acciones sin escribir complejos scripts de automatización de navegador.
- Aprovechar BrowserQL: Para casos de uso avanzados, especialmente aquellos que implican eludir detectores de bots difíciles (como Cloudflare), Browserless ofrece BrowserQL. Este es un lenguaje de automatización e IDE de última generación diseñado para dejar mínimas huellas digitales. Puedes escribir consultas concisas para realizar acciones complejas como hacer clic en botones, resolver CAPTCHAs y extraer datos estructurados, todo mientras pareces más humano para los sistemas de detección.
- Automatizaciones Híbridas: Browserless admite flujos de trabajo híbridos donde puedes transmitir una sesión de navegador a un iframe. Esto es útil para tareas que requieren intervención manual, como resolver un CAPTCHA complejo, introducir códigos 2FA o gestionar inicios de sesión OAuth dentro de un script automatizado.
Características principales de Browserless
- BrowserQL: Un lenguaje de consulta e IDE propietario construido desde cero para eludir los detectores de bots más avanzados minimizando las huellas digitales del navegador.
- Navegador como Servicio (BaaS): Un conjunto escalable y gestionado de miles de navegadores, que se encarga de todos los aspectos de la infraestructura como actualizaciones de versión, balanceo de carga y gestión de recursos.
- Evasión de Detección de Bots y CAPTCHA: Tecnología especializada para resolver automáticamente CAPTCHAs (reCAPTCHA, hCaptcha) y superar servicios de bloqueo de bots como Cloudflare.
- Integración con Puppeteer y Playwright: Compatibilidad perfecta con las dos bibliotecas de automatización de navegadores más populares.
- APIs REST: Puntos finales sencillos para tareas comunes como generación de PDF, capturas de pantalla y scraping de contenido.
- Gestión de Sesiones y Reconexiones: La capacidad de mantener vivas las sesiones del navegador y reconectarse a ellas, lo que reduce significativamente el uso de proxies y evita comprobaciones repetitivas de bots.
- Soluciones de Nivel Empresarial: Opciones de autoalojamiento, despliegues en nube privada, configuraciones de máquina personalizadas (incluidas GPUs), SSO, soporte dedicado y cumplimiento de SOC 2 Tipo II.
- Monitorización y Depuración: Un panel de control fácil de usar que proporciona métricas sobre solicitudes, estado de los workers (CPU/memoria) y un depurador para ver la ejecución de los scripts en tiempo real.
Casos de uso para Browserless
Browserless es versátil y se puede aplicar a numerosos escenarios:
- Web Scraping y Extracción de Datos: Recopilación de datos de sitios web dinámicos y con mucho JavaScript, plataformas de comercio electrónico (p. ej., Walmart, eBay), listados de bienes raíces (Zillow) y bolsas de trabajo (Indeed).
- Pruebas de Software Automatizadas: Ejecución de pruebas de extremo a extremo para aplicaciones web a escala, integrándose con frameworks como Laravel Dusk sin la necesidad de gestionar una compleja Selenium Grid.
- Ingesta de Datos para IA y LLM: Potenciar agentes de IA (p. ej., usando LangChain o CrewAI) con acceso web en tiempo real para recopilar datos frescos para entrenar modelos de lenguaje grandes o realizar investigaciones automatizadas.
- Generación de Informes: Generación automática de PDFs y capturas de pantalla de paneles de control, informes de análisis o facturas desde aplicaciones web.
- Monitorización de Precios y Competencia: Seguimiento de precios de productos, niveles de inventario y estrategias de la competencia en varios minoristas en línea.
Ventajas de Browserless
Usar Browserless proporciona varias ventajas clave:
- Reducción de la Carga Operativa: Elimina la necesidad de un equipo dedicado para construir, desplegar y mantener una compleja infraestructura de automatización de navegadores.
- Tasas de Éxito Mejoradas: Sus avanzadas técnicas de evasión de bots, particularmente con BrowserQL, conducen a mayores tasas de éxito en el scraping de sitios web protegidos.
- Escalabilidad bajo Demanda: Escala sin esfuerzo desde unas pocas sesiones concurrentes hasta miles, manejando picos de tráfico sin degradación del rendimiento.
- Eficiencia de Costos: Características como las reconexiones de sesión pueden reducir los costos de proxy hasta en un 90%. El modelo de precios basado en unidades es predecible y rentable.
- Enfocado en el Desarrollador: Diseñado por desarrolladores para desarrolladores, con excelente documentación, SDKs y soporte técnico receptivo.
Precios y planes
Browserless ofrece un modelo de precios flexible basado en unidades para adaptarse a diferentes necesidades:
- Plan Gratuito: Incluye 1,000 unidades al mes, 1 navegador concurrente máximo y acceso al editor de BrowserQL. No se requiere tarjeta de crédito.
- Plan de Prototipado: Comienza en $25/mes (facturado anualmente) por 20,000 unidades y 3 navegadores concurrentes. Ideal para pequeños proyectos y pruebas.
- Plan de Inicio: Comienza en $140/mes (facturado anualmente) por 180,000 unidades y 20 navegadores concurrentes, adecuado para aplicaciones en crecimiento.
- Plan de Escala: Comienza en $350/mes (facturado anualmente) por 500,000 unidades y 50 navegadores concurrentes, diseñado para operaciones de alto volumen.
- Plan Empresarial: Precios personalizados para usuarios que necesitan millones de unidades, despliegues privados, autoalojamiento, características avanzadas como infraestructura de GPU, SSO y un gestor de cuentas técnico dedicado.
Una "Unidad" corresponde a hasta 30 segundos de tiempo de navegador. Las sesiones más largas consumen unidades adicionales. Las unidades también se utilizan para proxies residenciales y resoluciones de CAPTCHA exitosas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 126.9K
- 2026-1: 150.9K
- 2026-2: 150.8K
- 2026-3: 157.8K
- 2026-4: 148.9K
- 2026-5: 242.1K
Geography
Top 5 countries / regions
- 🇧🇷Brasil28.1%
- 🇺🇸Estados Unidos26.6%
- 🇨🇭Suiza23.8%
- 🇨🇦Canadá11.6%
- 🇪🇸España10.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.8% |
Referral | 13.7% |
Email | 4.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| browserless | $3.04 |
| browserless api | $0.00 |
| browserless io | $5.97 |
| memory leak fix | $2.60 |
| playwright vs selenium | $2.37 |
Browserless Videos on YouTube

browserless
browserless


browserless


Latent Space TV (see @LatentSpacePod for Pod)
Browserless Alternatives
Scrappey
Scrappey es una API avanzada de web scraping diseñada para que los desarrolladores extraigan datos de cualquier sitio web sin esfuerzo. Gestiona todas las complejidades como proxies rotativos, navegadores sin cabeza y eludir medidas anti-bot como Cloudflare y CAPTCHAs. Con una alta tasa de éxito y un modelo simple de pago por uso, Scrappey agiliza la recopilación de datos para diversas aplicaciones.
Extracción de Datos
Crawlbase
Crawlbase es una plataforma de web crawling y extracción de datos impulsada por IA para desarrolladores y empresas. Ofrece un conjunto de herramientas, incluyendo una API de Crawling y un Proxy Inteligente, para extraer datos de forma anónima de cualquier sitio web a escala, eludiendo bloqueos y CAPTCHAs con una alta tasa de éxito. Simplifica la recopilación de datos para SEO, investigación de mercado, inteligencia de comercio electrónico y entrenamiento de modelos de IA.
Extracción de Datos
Foxscrape
FoxScrape es una API REST de web scraping impulsada por IA para desarrolladores. Simplifica la extracción de datos convirtiendo cualquier sitio web en datos JSON estructurados mediante funciones como el análisis basado en IA a partir de inglés simple, la renderización de JavaScript para sitios dinámicos y la rotación automática de proxies para evitar bloqueos.
Extracción de Datos
Apify
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.
Recopilación de Datos
FetchFox
FetchFox es una herramienta de web scraping impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web usando simples indicaciones de texto. Elimina la necesidad de codificación compleja o selectores CSS, manejando automáticamente las medidas anti-bot. Disponible como API, biblioteca de JavaScript y extensión de Chrome, está diseñada para que tanto desarrolladores como usuarios no técnicos automaticen la recopilación de datos sin esfuerzo.
Extracción de DatosBrowserless Categories
Browserless Jobs
Browserless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Scrappey
Scrappey es una API avanzada de web scraping diseñada para que los desarrolladores extraigan datos de cualquier sitio web sin esfuerzo. Gestiona todas las complejidades como proxies rotativos, navegadores sin cabeza y eludir medidas anti-bot como Cloudflare y CAPTCHAs. Con una alta tasa de éxito y un modelo simple de pago por uso, Scrappey agiliza la recopilación de datos para diversas aplicaciones.
Extracción de Datos
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
AutomatizaciónCrawlbase
Crawlbase es una plataforma de web crawling y extracción de datos impulsada por IA para desarrolladores y empresas. Ofrece un conjunto de herramientas, incluyendo una API de Crawling y un Proxy Inteligente, para extraer datos de forma anónima de cualquier sitio web a escala, eludiendo bloqueos y CAPTCHAs con una alta tasa de éxito. Simplifica la recopilación de datos para SEO, investigación de mercado, inteligencia de comercio electrónico y entrenamiento de modelos de IA.
Extracción de Datos
Zyte
Zyte es una plataforma integral de web scraping que ofrece una API full-stack y servicios de extracción de datos. Simplifica la adquisición de datos gestionando proxies, navegadores sin cabeza y sistemas avanzados anti-bloqueo. Impulsado por IA, Zyte entrega datos web fiables y estructurados a escala para empresas de comercio electrónico, investigación de mercado y más.
Inteligencia de MercadoFoxscrape
FoxScrape es una API REST de web scraping impulsada por IA para desarrolladores. Simplifica la extracción de datos convirtiendo cualquier sitio web en datos JSON estructurados mediante funciones como el análisis basado en IA a partir de inglés simple, la renderización de JavaScript para sitios dinámicos y la rotación automática de proxies para evitar bloqueos.
Extracción de Datos
Browserman
Browserman es una plataforma avanzada de automatización de navegadores diseñada para potenciar a asistentes de IA como Claude, ChatGPT, Gemini y Grok en la gestión de operaciones de redes sociales. Ofrece soporte multiplataforma y multicuentas, una robusta API REST y una integración nativa del Protocolo de Contexto de Modelo (MCP) para flujos de trabajo de automatización fluidos, escalables y seguros.
Integración
Skyvern
Skyvern es una plataforma de automatización de navegadores impulsada por IA que utiliza visión por computadora y lenguaje natural para automatizar flujos de trabajo web complejos. Puede manejar la extracción de datos, el envío de formularios, la recuperación de facturas y más en cualquier sitio web, adaptándose dinámicamente a los cambios sin necesidad de scripting tradicional.
API
ManyPI
ManyPI es una plataforma moderna de recopilación de datos que transforma cualquier sitio web en una API de tipo seguro. Simplifica la extracción de datos estructurados con definición de esquema, extracción de datos y transformación de registros integrados, lo que permite a desarrolladores y equipos técnicos recopilar datos web de forma fiable a escala.
3D
Hyperbrowser
Hyperbrowser es una plataforma de Navegador como Servicio (BaaS) diseñada para agentes de IA y desarrolladores. Proporciona navegadores en la nube escalables y ultrarrápidos para automatizar tareas web, extraer datos y permitir interacciones web impulsadas por IA. Con funciones como navegación sigilosa, resolución automática de captchas y API amigables para desarrolladores, potencia flujos de trabajo complejos sin límites.
Extracción de Datos Web
Octoparse
Octoparse es una potente herramienta de web scraping sin código que permite a cualquiera extraer datos de sitios web sin programar. Cuenta con un diseñador de flujo de trabajo visual, un asistente con IA para una configuración fácil y cientos de plantillas predefinidas para sitios populares. Con automatización en la nube, rotación de IP y resolución de CAPTCHA, Octoparse maneja tareas complejas de scraping de manera eficiente, convirtiendo páginas web en datos estructurados para la generación de leads, investigación de mercado y más.
Extracción de Datos Web
Crawlora
Crawlora es una plataforma de web scraping sin código impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web sin esfuerzo. Su interfaz inteligente de apuntar y hacer clic simplifica la extracción de datos, permitiéndote convertir páginas web en datos estructurados (CSV, JSON) sin escribir una sola línea de código. Ideal para investigación de mercado, generación de leads y monitoreo de precios.
Extracción de Datos
BrowserBook
BrowserBook es un entorno de desarrollo integrado (IDE) impulsado por IA, diseñado para construir, implementar y escalar automatizaciones de navegador deterministas. Simplifica tareas complejas de automatización web, ofreciendo velocidad, estabilidad y ahorro de costos al combinar la generación de código por IA con una ejecución de scripts confiable. Ideal para agentes de IA, web scraping, pruebas de UI y flujos de trabajo específicos de la industria en salud y finanzas.
Desarrollo de Agente IA
Browserbase
Browserbase proporciona una infraestructura en la nube escalable para ejecutar y gestionar navegadores sin cabeza (headless). Está diseñado para que los desarrolladores potencien agentes de IA, automaticen flujos de trabajo web complejos y realicen extracción de datos a gran escala sin gestionar la infraestructura subyacente.
Extracción de Datos Web
ScrapingBee
ScrapingBee es una potente API de web scraping que maneja navegadores sin cabeza y rotación de proxies para evitar ser bloqueado. Cuenta con un innovador extractor impulsado por IA que le permite describir los datos que necesita en lenguaje sencillo, eliminando la necesidad de selectores CSS complejos. Ideal para desarrolladores, especialistas en marketing y analistas de datos para tareas como monitoreo de precios, generación de leads y análisis de SERP.
Extracción de Datos
Rtrvr
Rtrvr es un agente de IA avanzado diseñado para automatizar tareas web complejas utilizando lenguaje natural. Navega por sitios web, extrae datos, rellena formularios y ejecuta flujos de trabajo, transformando operaciones tediosas en conversaciones sencillas.
Automatización Web
Browserless Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.