

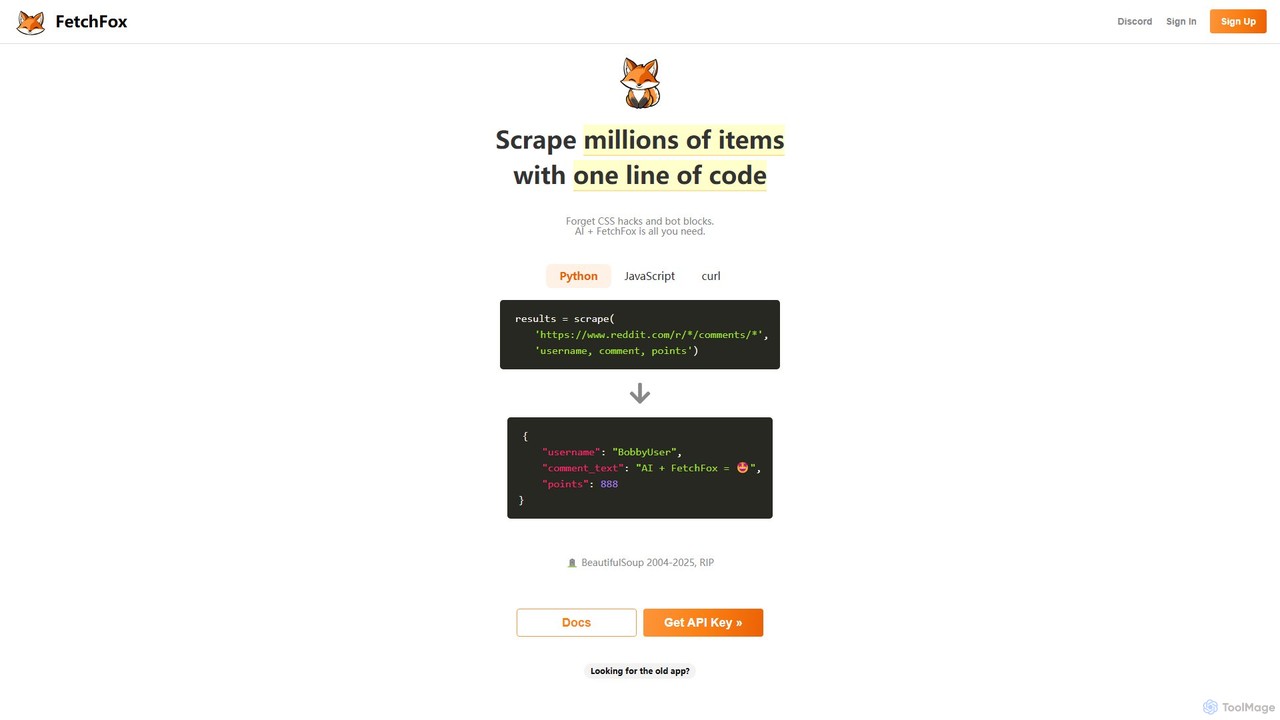
FetchFox Overview
FetchFox es una revolucionaria plataforma de web scraping impulsada por IA, diseñada para simplificar y automatizar el proceso de extracción de datos de la web. Cambia fundamentalmente la forma en que los usuarios abordan el web scraping al reemplazar la codificación compleja, los selectores CSS y el mantenimiento de scripts frágiles con indicaciones simples y en lenguaje natural. Ya sea que seas un desarrollador que necesita integrar datos en una aplicación o un usuario de negocios que busca recopilar inteligencia de mercado, FetchFox ofrece una solución robusta y accesible.
El principio central de FetchFox es su motor de IA, que entiende de manera inteligente la estructura y el contenido de una página web. Los usuarios simplemente describen los datos que desean extraer, y la IA se encarga del resto. Esto incluye navegar por las páginas, identificar los puntos de datos relevantes y estructurar la salida en un formato limpio y utilizable como JSON. La plataforma está diseñada para ser resiliente, adaptándose automáticamente a los cambios en el diseño del sitio web y eludiendo tecnologías anti-scraping comunes como CAPTCHAs y bloqueos de IP, que son grandes obstáculos para los métodos de scraping tradicionales.
Cómo usar FetchFox
FetchFox ofrece formas flexibles de usar su servicio, atendiendo a las diferentes necesidades de los usuarios:
1. Para Desarrolladores (API y Bibliotecas):
- Obtén una Clave de API: Regístrate en el sitio web de FetchFox para recibir tu clave de API única.
- Intégralo con tu código: Usa las bibliotecas oficiales de Python o JavaScript (npm install fetchfox) para una integración perfecta, o realiza solicitudes cURL directas al endpoint de la API.
- Define tu trabajo de scrape: En tu solicitud, especifica el/los sitio(s) web objetivo usando `start_urls` y un `pattern` de URL para rastrear múltiples páginas.
- Escribe una indicación en lenguaje natural: La parte más crucial es el parámetro `template`. Aquí, describes los campos de datos que necesitas, por ejemplo: "Extrae el nombre del producto, el precio, la calificación del cliente y el texto de las tres primeras reseñas."
- Ejecuta y recibe los datos: Ejecuta tu script para iniciar el trabajo de scraping. FetchFox procesará la solicitud y devolverá los datos extraídos en un formato JSON estructurado.
2. Para Usuarios No Técnicos (Extensión de Chrome):
- Instala la Extensión: Añade la extensión de FetchFox a tu navegador Chrome desde la Chrome Web Store.
- Navega y Activa: Ve a la página web de la que quieres extraer datos. Abre la extensión e introduce tu clave de API.
- Introduce una Indicación: En la interfaz de la extensión, escribe un comando simple que describa lo que quieres recopilar, como "lista todos los títulos de trabajo y nombres de empresas en esta página."
- Inicia el Scraping: Pulsa el botón 'Go'. FetchFox analizará la página, extraerá la información solicitada y te permitirá descargar los resultados, generalmente como un archivo CSV.
Características principales de FetchFox
- Scraping con Lenguaje Natural Impulsado por IA: No se necesitan selectores XPath o CSS. Simplemente dile a la IA qué datos necesitas en un inglés sencillo.
- Evasión Avanzada de Anti-Bots: Navega de forma inteligente a través de medidas anti-scraping, incluyendo contenido dinámico, CAPTCHAs y gestión de proxies.
- Acceso Multiplataforma: Usa la potente API, las convenientes bibliotecas de Python/JavaScript o la extensión de Chrome sin código y fácil de usar.
- Salida de Datos Estructurados: Entrega automáticamente datos JSON limpios y bien estructurados, ahorrándote tiempo en la limpieza y el análisis de datos.
- Rastreo Escalable: Extrae sin esfuerzo millones de elementos de sitios web completos definiendo patrones de URL para que el rastreador los siga.
- Trae Tu Propia Clave (BYOK): Una opción para usar tu clave de API personal de OpenAI, que puede reducir costos y proporciona una asignación de elementos gratuitos más generosa.
Casos de uso para FetchFox
FetchFox es versátil y se puede aplicar en diversas industrias y roles:
- Ventas y Generación de Leads: Extrae información de directorios de empresas, LinkedIn Sales Navigator o redes profesionales para construir listas de leads específicas con nombres, cargos, empresas y detalles de contacto.
- Investigación de Mercado y Competencia: Agrega información de productos, precios y reseñas de clientes de sitios de comercio electrónico como Amazon o eBay para analizar tendencias de mercado y estrategias de la competencia.
- Agregación de Datos Financieros: Recopila datos de sitios de noticias financieras, plataformas de mercado de valores o protocolos DeFi para análisis de inversiones y entrenamiento de modelos.
- Investigación Académica y Científica: Reúne grandes conjuntos de datos de diversas fuentes en línea, publicaciones o registros públicos para estudios académicos.
- Análisis Inmobiliario: Recopila listados de propiedades, precios y detalles de agentes de sitios web inmobiliarios para monitorear las condiciones del mercado.
Ventajas de FetchFox
La principal ventaja de FetchFox es su radical simplicidad y poder. Democratiza el web scraping, haciéndolo accesible a usuarios sin conocimientos técnicos. Para los desarrolladores, acelera significativamente el proceso de desarrollo al abstraer los aspectos más tediosos y desafiantes del scraping. Su resiliencia a los cambios en los sitios web significa menos tiempo dedicado al mantenimiento de scripts rotos y más tiempo enfocado en utilizar los datos. La combinación de un potente motor de IA y una infraestructura robusta lo convierte en una herramienta altamente eficiente y confiable para cualquier tarea de extracción de datos.
Precios y planes
FetchFox emplea un modelo de precios transparente y directo de pago por uso.
- Nivel Gratuito: Los nuevos usuarios obtienen sus primeros 1,000 elementos extraídos de forma gratuita. Un 'elemento' corresponde a una fila de datos (por ejemplo, los detalles de un producto).
- Precio Estándar: Después del nivel gratuito, el costo es una tarifa plana de $1 por cada 1,000 elementos.
- Bono Trae Tu Propia Clave (BYOK): Si eliges usar tu propia clave de API de OpenAI, recibes 10,000 elementos adicionales de forma gratuita. Esta puede ser una opción más rentable para usuarios con cuentas de OpenAI existentes.
- Planes Personalizados: Para usuarios con necesidades de scraping a gran escala o requisitos complejos, FetchFox ofrece planes empresariales personalizados. Los interesados pueden contactar a su equipo de ventas para una consulta.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 2.7K
- 2026-1: 1.9K
- 2026-2: 771
- 2026-3: 1.0K
- 2026-4: 14.8K
- 2026-5: 40.3K
Geography
Top 5 countries / regions
- 🇮🇳India45.8%
- 🇺🇸Estados Unidos44.9%
- 🇪🇸España9.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| fetch fox | $0.00 |
| fetchfox ai | $0.00 |
| fetchfoxai | $0.00 |
| fetchfox.ia | $0.00 |
| founding engineer equity | $0.00 |
FetchFox Alternatives
instantapi
instantapi es una API de web scraping impulsada por IA, diseñada para la simplicidad y la velocidad. Permite a los usuarios extraer datos estructurados de cualquier sitio web con una sola llamada a la API, eliminando la necesidad de codificación compleja o configuración manual. Ideal para desarrolladores, analistas de datos y empresas que necesitan una extracción de datos rápida, asequible y fiable sin las molestias de los raspadores web tradicionales.
Extracción de Datos
Apify
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.
Recopilación de Datos
WebScraping.AI
WebScraping.AI es una API avanzada para desarrolladores que simplifica el web scraping usando IA. Cuenta con proxies rotativos, renderizado de JavaScript y geolocalización para evadir bloqueos y acceder a contenido dinámico. Su principal fortaleza radica en sus herramientas impulsadas por LLM, que pueden extraer datos no estructurados, generar resúmenes y responder preguntas directamente desde páginas web, agilizando la recopilación de datos para cualquier proyecto.
Extracción de Datos
Simplescraper
Simplescraper es una potente herramienta de web scraping que extrae datos de cualquier sitio web en segundos. Ofrece una extensión de Chrome fácil de usar para la selección de datos sin código, automatización basada en la nube para scraping a gran escala y una innovadora función de IA (AI Enhance) para obtener información mediante simples indicaciones. Convierte sitios web en datos estructurados (CSV, JSON) o APIs instantáneas, e intégralo con herramientas como Google Sheets y Airtable.
Extracción de Datos Web
Crawlbase
Crawlbase es una plataforma de web crawling y extracción de datos impulsada por IA para desarrolladores y empresas. Ofrece un conjunto de herramientas, incluyendo una API de Crawling y un Proxy Inteligente, para extraer datos de forma anónima de cualquier sitio web a escala, eludiendo bloqueos y CAPTCHAs con una alta tasa de éxito. Simplifica la recopilación de datos para SEO, investigación de mercado, inteligencia de comercio electrónico y entrenamiento de modelos de IA.
Extracción de DatosFetchFox Categories
FetchFox Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
instantapi
instantapi es una API de web scraping impulsada por IA, diseñada para la simplicidad y la velocidad. Permite a los usuarios extraer datos estructurados de cualquier sitio web con una sola llamada a la API, eliminando la necesidad de codificación compleja o configuración manual. Ideal para desarrolladores, analistas de datos y empresas que necesitan una extracción de datos rápida, asequible y fiable sin las molestias de los raspadores web tradicionales.
Extracción de DatosSimplescraper
Simplescraper es una potente herramienta de web scraping que extrae datos de cualquier sitio web en segundos. Ofrece una extensión de Chrome fácil de usar para la selección de datos sin código, automatización basada en la nube para scraping a gran escala y una innovadora función de IA (AI Enhance) para obtener información mediante simples indicaciones. Convierte sitios web en datos estructurados (CSV, JSON) o APIs instantáneas, e intégralo con herramientas como Google Sheets y Airtable.
Extracción de Datos Web
hystruct
hystruct es una herramienta de web scraping impulsada por IA que simplifica la extracción de datos. Permite a los usuarios convertir fácilmente contenido web no estructurado en datos estructurados utilizando esquemas predefinidos o personalizados, sin necesidad de programar. Con integraciones como Zapier, automatiza flujos de trabajo para investigación de mercado, generación de leads y más. Está diseñado para todos, desde principiantes hasta equipos empresariales.
Raspado
webscrapeai
WebscrapeAI es una plataforma sin código, impulsada por IA, diseñada para automatizar la recopilación de datos web. Simplemente proporcione una URL y especifique los datos que necesita, y la IA se encarga de todo el proceso de scraping. Admite sitios web dinámicos, scraping masivo, integración de proxy y ofrece una API para desarrolladores, haciendo que la extracción de datos sea rápida, precisa y accesible para todos.
Extracción de Datos Web
Curlent
Curlent es una plataforma de web scraping y extracción de datos impulsada por IA que automatiza la recopilación de datos estructurados de cualquier sitio web. Maneja de forma inteligente contenido dinámico, medidas anti-bot y diseños complejos, proporcionando datos limpios y listos para usar a través de una potente API.
Raspado
MrScraper
MrScraper es una herramienta de web scraping sin código impulsada por IA que permite a los usuarios extraer datos estructurados de cualquier sitio web sin esfuerzo. Automatiza el proceso de recopilación de datos, eludiendo medidas anti-bot como CAPTCHAs y bloqueos de IP, lo que la hace ideal para inteligencia de precios, investigación de mercado y generación de leads.
Extracción de Datos Web
ScrapeComfort
ScrapeComfort es una aplicación de escritorio sin código y con IA para un web scraping sin esfuerzo. Aprovecha ChatGPT para permitirte extraer datos de cualquier sitio web usando simples comandos de texto plano, eliminando la necesidad de habilidades técnicas como selectores CSS o XPaths. Está diseñado para usuarios de todos los niveles para automatizar la recopilación de datos para investigación de mercado, generación de leads y análisis de datos.
RaspadoApify
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.
Recopilación de Datos
Octoparse
Octoparse es una potente herramienta de web scraping sin código que permite a cualquiera extraer datos de sitios web sin programar. Cuenta con un diseñador de flujo de trabajo visual, un asistente con IA para una configuración fácil y cientos de plantillas predefinidas para sitios populares. Con automatización en la nube, rotación de IP y resolución de CAPTCHA, Octoparse maneja tareas complejas de scraping de manera eficiente, convirtiendo páginas web en datos estructurados para la generación de leads, investigación de mercado y más.
Extracción de Datos Web
ParseHub
ParseHub es una potente herramienta de web scraping sin código que permite a los usuarios extraer datos de cualquier sitio web con una sencilla interfaz de apuntar y hacer clic. Está diseñada para manejar sitios complejos y dinámicos con JavaScript, AJAX, formularios y scroll infinito. Los datos se pueden recopilar de forma programada, exportar como JSON/Excel o acceder a ellos a través de una API, lo que la hace ideal para la generación de leads, investigación de mercado y agregación de datos.
Extracción de Datos Web
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización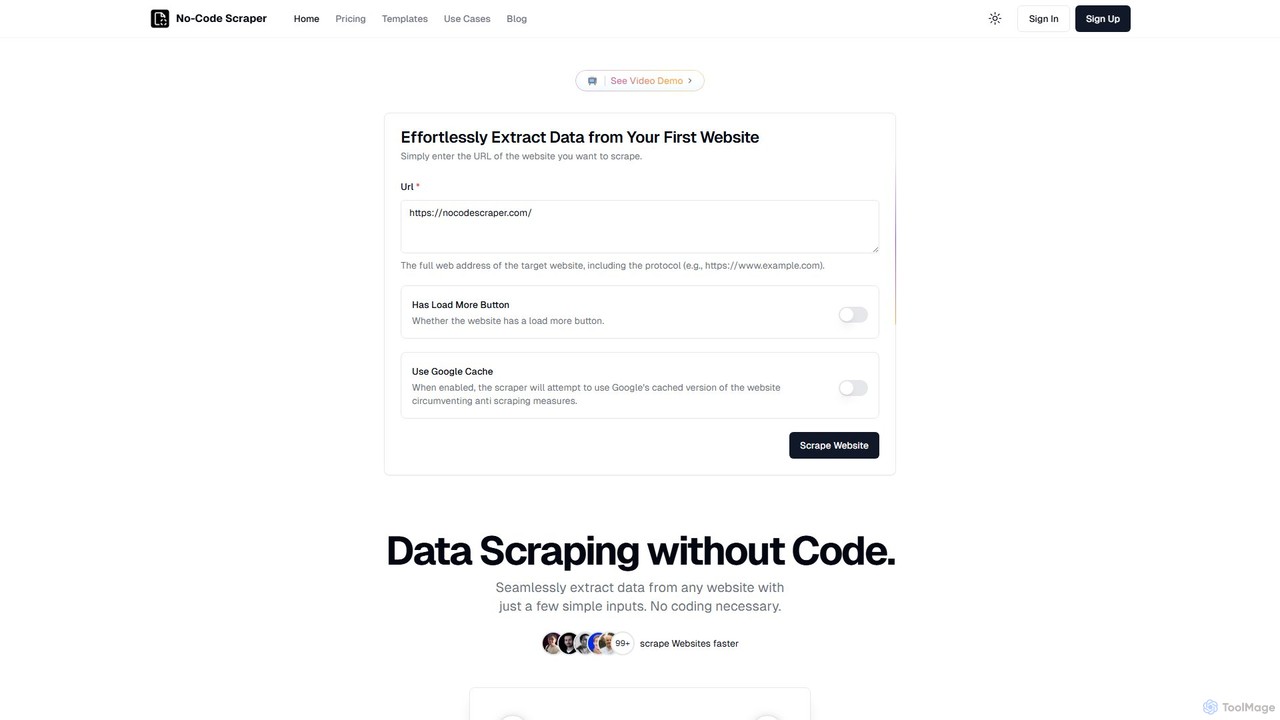
No-Code Scraper
No-Code Scraper es una plataforma impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web sin escribir una sola línea de código. Utiliza grandes modelos de lenguaje para automatizar la extracción, limpieza y estructuración de datos, haciendo que el web scraping sea accesible, fiable y eficiente para todos.
Extracción de Datos Web
GetOData
Un directorio completo para descubrir, comparar y utilizar más de 4,000 API preconstruidas y raspadores web sin código. Extraiga datos estructurados de sitios web para investigación de mercado, generación de leads y automatización de procesos sin escribir ningún código.
Análisis
Crawlora
Crawlora es una plataforma de web scraping sin código impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web sin esfuerzo. Su interfaz inteligente de apuntar y hacer clic simplifica la extracción de datos, permitiéndote convertir páginas web en datos estructurados (CSV, JSON) sin escribir una sola línea de código. Ideal para investigación de mercado, generación de leads y monitoreo de precios.
Extracción de Datos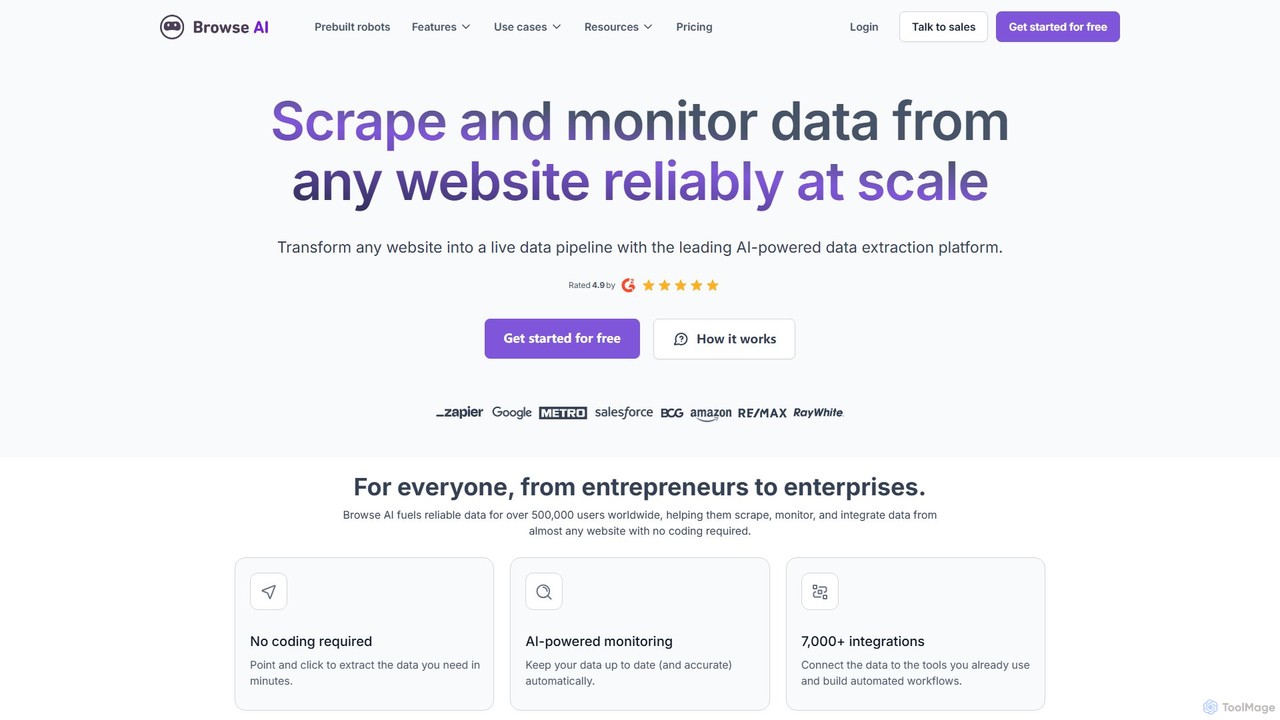
Browse AI
Browse AI es una plataforma sin código que permite a los usuarios extraer y monitorear datos de cualquier sitio web. Entrena fácilmente un robot para raspar información, convertir sitios web en hojas de cálculo o API, y rastrear cambios automáticamente. Está diseñado para especialistas en marketing, investigadores y desarrolladores para automatizar la recopilación de datos sin escribir código, ofreciendo robots preconstruidos e integraciones fluidas con herramientas como Google Sheets y Zapier.
Extracción de Datos Web
FetchFox Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.