ToolMage
Iniciar sesión

AI TOOL COMPARISON

Crawlbase vs FetchFox

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

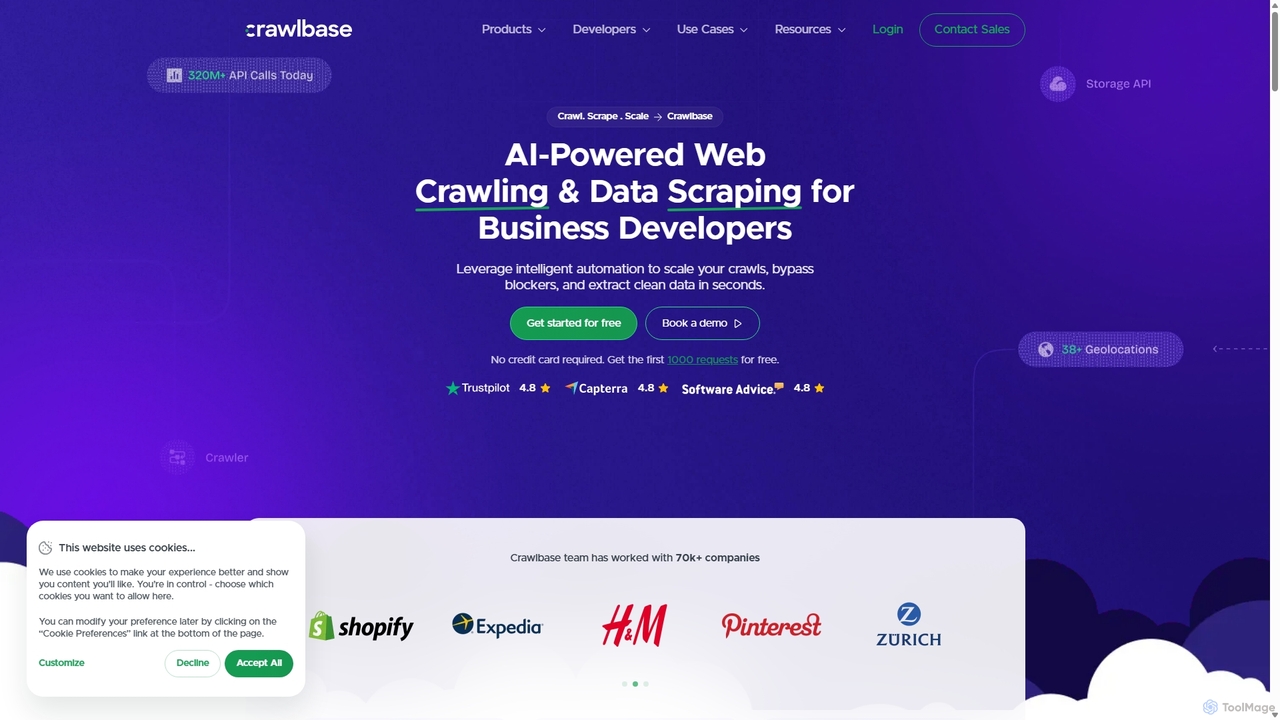
Crawlbase Resumen del producto

Crawlbase es una plataforma de web crawling y extracción de datos impulsada por IA para desarrolladores y empresas. Ofrece un conjunto de herramientas, incluyendo una API de Crawling y un Proxy Inteligente, para extraer datos de forma anónima de cualquier sitio web a escala, eludiendo bloqueos y CAPTCHAs con una alta tasa de éxito. Simplifica la recopilación de datos para SEO, investigación de mercado, inteligencia de comercio electrónico y entrenamiento de modelos de IA.

Preview

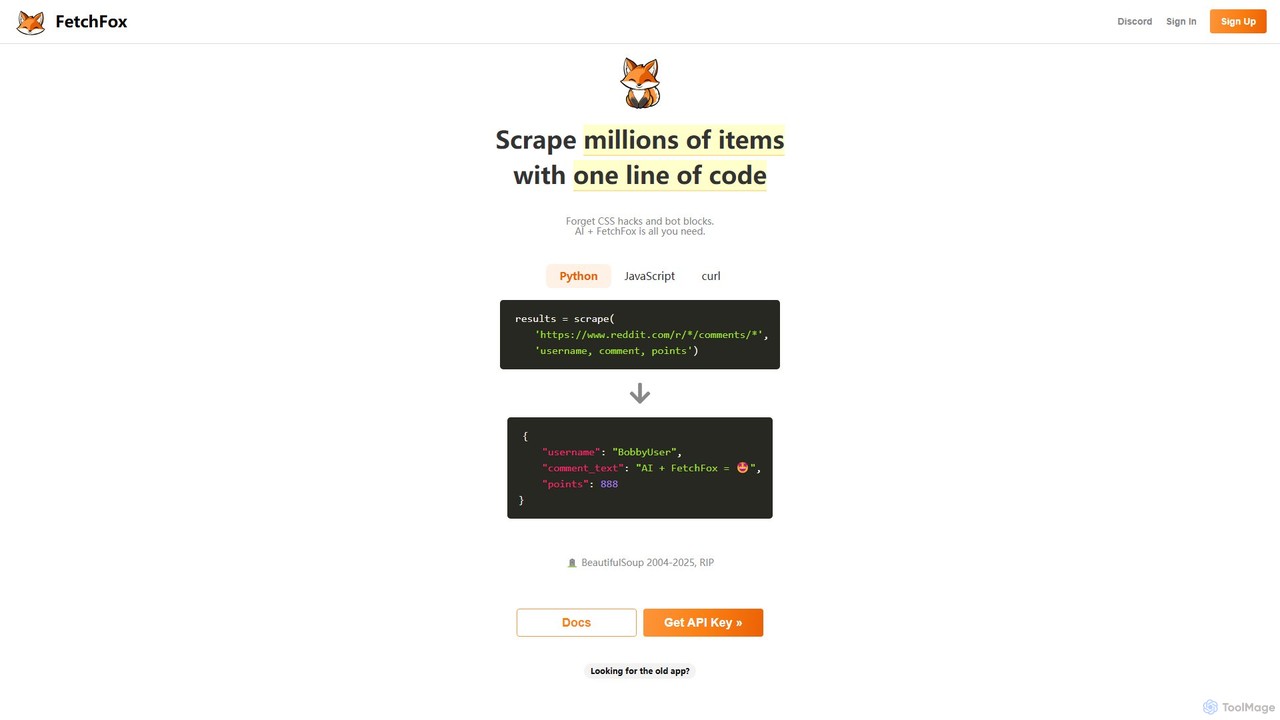
FetchFox Resumen del producto

FetchFox es una herramienta de web scraping impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web usando simples indicaciones de texto. Elimina la necesidad de codificación compleja o selectores CSS, manejando automáticamente las medidas anti-bot. Disponible como API, biblioteca de JavaScript y extensión de Chrome, está diseñada para que tanto desarrolladores como usuarios no técnicos automaticen la recopilación de datos sin esfuerzo.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Crawlbase VS FetchFox — Datos clave
Datos claveCrawlbaseFetchFox
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusExtracción de DatosExtracción de Datos
Audiencia y rolesPropietario de Negocio · Analista de Datos · Gerente de Marketing · Gerente de Producto · Investigador · Representante de Ventas · Especialista en SEO · Desarrollador de SoftwareSin verificar
CategoríasExtracción de Datos · Web Scraping · Generación de LeadsExtracción de Datos · Web Scraping · Generación de Leads · Automatización
Added11 sept 202513 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Crawlbase

Crawlbase es una plataforma integral, impulsada por IA, diseñada para democratizar el acceso a los datos web. Permite a desarrolladores, científicos de datos y empresas rastrear y extraer datos de internet a gran escala, transformando contenido web no estructurado en datos limpios y estructurados. Al encargarse de la compleja infraestructura de proxies, automatización de navegadores y sistemas anti-bot, Crawlbase permite a los usuarios centrarse únicamente en la utilización de los datos. La plataforma se basa en millones de proxies residenciales y de centros de datos rotativos en todo el mundo, garantizando un acceso anónimo y sin restricciones a sitios web como Amazon, LinkedIn, Google y más, con un tiempo de actividad garantizado del 99.9%.

Cómo usar Crawlbase

Integrar Crawlbase en tu flujo de trabajo está diseñado para ser sencillo y se puede hacer en minutos:

  1. Crear una Cuenta: Regístrate para obtener una cuenta gratuita de Crawlbase. Recibirás un token de API para la autenticación. El plan inicial incluye 1,000 solicitudes gratuitas para probar el servicio sin necesidad de tarjeta de crédito.
  2. Elegir la Herramienta Adecuada: Selecciona el producto apropiado para tus necesidades. Utiliza la API de Crawling para solicitudes de datos síncronas en tiempo real. Para proyectos a gran escala y continuos, el Crawler asíncrono es más rentable. Si necesitas una pasarela de proxy simple para tu aplicación, el Proxy Inteligente es la opción ideal.
  3. Realizar una Petición a la API: Realiza una llamada de API simple al endpoint de Crawlbase, pasando tu token de API y la URL de destino que deseas extraer. Puedes incluir varios parámetros para habilitar la renderización de JavaScript, establecer geolocalizaciones o utilizar extractores de datos específicos.
  4. Recibir los Datos: Crawlbase procesa la solicitud, navegando a través de bloqueos, proxies y CAPTCHAs. Luego, devuelve el contenido HTML completo de la página o, si se utiliza un extractor específico (como el de Amazon), proporciona los datos en un formato JSON estructurado.

Características principales de Crawlbase

  • API de Crawling: Una API potente y fácil de usar que obtiene el contenido de las páginas web en tiempo real. Admite la renderización de JavaScript para sitios web dinámicos e incluye extractores integrados para sitios populares como Amazon, proporcionando datos estructurados directamente.
  • El Crawler: Una solución de rastreo asíncrona diseñada para proyectos masivos de extracción de datos. Utiliza callbacks para entregar datos a tus servidores, ahorrando costos, ancho de banda e intentos de reintento para grandes volúmenes de URLs.
  • Proxy Inteligente: Una solución de proxy rotativo que proporciona acceso a millones de IPs de centros de datos y residenciales. Se puede integrar fácilmente en cualquier aplicación o script que requiera un proxy fiable para evitar ser bloqueado.
  • Tecnología Anti-Bloqueo con IA: Algoritmos sofisticados y modelos de aprendizaje automático que manejan automáticamente los bloqueos de IP, la huella digital del navegador, los CAPTCHAs y otras medidas anti-extracción, asegurando una alta tasa de éxito.
  • Almacenamiento en la Nube: Una característica conveniente que te permite mover tus datos rastreados y extraídos directamente al almacenamiento seguro en la nube de Crawlbase, simplificando tu canal de datos.
  • Geolocalización Global: Accede a contenido web de más de 30 países diferentes, lo que te permite realizar búsquedas localizadas y recopilar datos específicos de la región.

Casos de uso para Crawlbase

Crawlbase es versátil y soporta una amplia gama de actividades empresariales basadas en datos:

  • Comercio Electrónico y Minorista: Monitorea los precios de la competencia, rastrea la disponibilidad de productos, agrega reseñas de clientes y analiza datos de productos de plataformas como Amazon, eBay y Walmart para optimizar las estrategias de ventas.
  • Investigación de Mercado: Recopila grandes cantidades de datos para el análisis de tendencias de mercado, el análisis de sentimientos de redes sociales y foros, y la identificación de nuevas oportunidades de negocio.
  • Generación de Leads: Automatiza el proceso de recopilación de información de contacto y detalles de empresas de redes profesionales como LinkedIn, directorios en línea y sitios web corporativos.
  • IA y Aprendizaje Automático: Proporciona conjuntos de datos estructurados de alta calidad para entrenar IA generativa y grandes modelos de lenguaje (LLMs). La API puede recopilar eficientemente los enormes volúmenes de datos de texto e imágenes necesarios.
  • Monitoreo de SEO: Rastrea las clasificaciones de palabras clave en diferentes motores de búsqueda y ubicaciones, analiza las estrategias de SEO de la competencia y realiza auditorías de sitios completas sin ser bloqueado.

Ventajas de Crawlbase

Crawlbase ofrece una ventaja competitiva significativa al abstraer las complejidades de la extracción de datos web. En lugar de construir y mantener una infraestructura interna costosa y frágil, los usuarios se benefician de una solución fiable, escalable y rentable. Las ventajas clave de la plataforma incluyen su masiva red de proxies, su alta tasa de éxito (más del 99%), su garantía de tiempo de actividad del 99.9% y su soporte experto 24/7. Su enfoque centrado en el desarrollador garantiza una fácil integración y una documentación robusta, mientras que su compromiso con el cumplimiento (GDPR y CCPA) proporciona tranquilidad a las empresas.

Precios y planes

Crawlbase opera con un modelo freemium flexible y transparente. Los nuevos usuarios pueden comenzar con un plan gratuito que incluye 1,000 solicitudes gratuitas, lo que les permite probar completamente las capacidades de la plataforma sin proporcionar una tarjeta de crédito. Después de la prueba gratuita, los precios se basan en un sistema de pago por uso, donde los costos se determinan por el número de solicitudes realizadas y las características utilizadas (por ejemplo, solicitudes estándar vs. solicitudes con JavaScript habilitado). Para las empresas con grandes necesidades de datos, Crawlbase ofrece planes Empresariales a medida que vienen con precios personalizados, gestión de cuentas dedicada y soporte premium para satisfacer los requisitos específicos del proyecto.

FetchFox

FetchFox es una revolucionaria plataforma de web scraping impulsada por IA, diseñada para simplificar y automatizar el proceso de extracción de datos de la web. Cambia fundamentalmente la forma en que los usuarios abordan el web scraping al reemplazar la codificación compleja, los selectores CSS y el mantenimiento de scripts frágiles con indicaciones simples y en lenguaje natural. Ya sea que seas un desarrollador que necesita integrar datos en una aplicación o un usuario de negocios que busca recopilar inteligencia de mercado, FetchFox ofrece una solución robusta y accesible.

El principio central de FetchFox es su motor de IA, que entiende de manera inteligente la estructura y el contenido de una página web. Los usuarios simplemente describen los datos que desean extraer, y la IA se encarga del resto. Esto incluye navegar por las páginas, identificar los puntos de datos relevantes y estructurar la salida en un formato limpio y utilizable como JSON. La plataforma está diseñada para ser resiliente, adaptándose automáticamente a los cambios en el diseño del sitio web y eludiendo tecnologías anti-scraping comunes como CAPTCHAs y bloqueos de IP, que son grandes obstáculos para los métodos de scraping tradicionales.

Cómo usar FetchFox

FetchFox ofrece formas flexibles de usar su servicio, atendiendo a las diferentes necesidades de los usuarios:

1. Para Desarrolladores (API y Bibliotecas):

  • Obtén una Clave de API: Regístrate en el sitio web de FetchFox para recibir tu clave de API única.
  • Intégralo con tu código: Usa las bibliotecas oficiales de Python o JavaScript (npm install fetchfox) para una integración perfecta, o realiza solicitudes cURL directas al endpoint de la API.
  • Define tu trabajo de scrape: En tu solicitud, especifica el/los sitio(s) web objetivo usando `start_urls` y un `pattern` de URL para rastrear múltiples páginas.
  • Escribe una indicación en lenguaje natural: La parte más crucial es el parámetro `template`. Aquí, describes los campos de datos que necesitas, por ejemplo: "Extrae el nombre del producto, el precio, la calificación del cliente y el texto de las tres primeras reseñas."
  • Ejecuta y recibe los datos: Ejecuta tu script para iniciar el trabajo de scraping. FetchFox procesará la solicitud y devolverá los datos extraídos en un formato JSON estructurado.

2. Para Usuarios No Técnicos (Extensión de Chrome):

  • Instala la Extensión: Añade la extensión de FetchFox a tu navegador Chrome desde la Chrome Web Store.
  • Navega y Activa: Ve a la página web de la que quieres extraer datos. Abre la extensión e introduce tu clave de API.
  • Introduce una Indicación: En la interfaz de la extensión, escribe un comando simple que describa lo que quieres recopilar, como "lista todos los títulos de trabajo y nombres de empresas en esta página."
  • Inicia el Scraping: Pulsa el botón 'Go'. FetchFox analizará la página, extraerá la información solicitada y te permitirá descargar los resultados, generalmente como un archivo CSV.

Características principales de FetchFox

  • Scraping con Lenguaje Natural Impulsado por IA: No se necesitan selectores XPath o CSS. Simplemente dile a la IA qué datos necesitas en un inglés sencillo.
  • Evasión Avanzada de Anti-Bots: Navega de forma inteligente a través de medidas anti-scraping, incluyendo contenido dinámico, CAPTCHAs y gestión de proxies.
  • Acceso Multiplataforma: Usa la potente API, las convenientes bibliotecas de Python/JavaScript o la extensión de Chrome sin código y fácil de usar.
  • Salida de Datos Estructurados: Entrega automáticamente datos JSON limpios y bien estructurados, ahorrándote tiempo en la limpieza y el análisis de datos.
  • Rastreo Escalable: Extrae sin esfuerzo millones de elementos de sitios web completos definiendo patrones de URL para que el rastreador los siga.
  • Trae Tu Propia Clave (BYOK): Una opción para usar tu clave de API personal de OpenAI, que puede reducir costos y proporciona una asignación de elementos gratuitos más generosa.

Casos de uso para FetchFox

FetchFox es versátil y se puede aplicar en diversas industrias y roles:

  • Ventas y Generación de Leads: Extrae información de directorios de empresas, LinkedIn Sales Navigator o redes profesionales para construir listas de leads específicas con nombres, cargos, empresas y detalles de contacto.
  • Investigación de Mercado y Competencia: Agrega información de productos, precios y reseñas de clientes de sitios de comercio electrónico como Amazon o eBay para analizar tendencias de mercado y estrategias de la competencia.
  • Agregación de Datos Financieros: Recopila datos de sitios de noticias financieras, plataformas de mercado de valores o protocolos DeFi para análisis de inversiones y entrenamiento de modelos.
  • Investigación Académica y Científica: Reúne grandes conjuntos de datos de diversas fuentes en línea, publicaciones o registros públicos para estudios académicos.
  • Análisis Inmobiliario: Recopila listados de propiedades, precios y detalles de agentes de sitios web inmobiliarios para monitorear las condiciones del mercado.

Ventajas de FetchFox

La principal ventaja de FetchFox es su radical simplicidad y poder. Democratiza el web scraping, haciéndolo accesible a usuarios sin conocimientos técnicos. Para los desarrolladores, acelera significativamente el proceso de desarrollo al abstraer los aspectos más tediosos y desafiantes del scraping. Su resiliencia a los cambios en los sitios web significa menos tiempo dedicado al mantenimiento de scripts rotos y más tiempo enfocado en utilizar los datos. La combinación de un potente motor de IA y una infraestructura robusta lo convierte en una herramienta altamente eficiente y confiable para cualquier tarea de extracción de datos.

Precios y planes

FetchFox emplea un modelo de precios transparente y directo de pago por uso.

  • Nivel Gratuito: Los nuevos usuarios obtienen sus primeros 1,000 elementos extraídos de forma gratuita. Un 'elemento' corresponde a una fila de datos (por ejemplo, los detalles de un producto).
  • Precio Estándar: Después del nivel gratuito, el costo es una tarifa plana de $1 por cada 1,000 elementos.
  • Bono Trae Tu Propia Clave (BYOK): Si eliges usar tu propia clave de API de OpenAI, recibes 10,000 elementos adicionales de forma gratuita. Esta puede ser una opción más rentable para usuarios con cuentas de OpenAI existentes.
  • Planes Personalizados: Para usuarios con necesidades de scraping a gran escala o requisitos complejos, FetchFox ofrece planes empresariales personalizados. Los interesados pueden contactar a su equipo de ventas para una consulta.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de DatosWeb ScrapingGeneración de Leads
Solo Crawlbase
No hay datos verificados
Solo FetchFox
Automatización

Etiquetas

Compartido
APIExtracción de datosminería de datosGeneración de leadsWeb scraping
Solo Crawlbase
Datos de entrenamiento de IARastreadorDatos de e-commerceProxyHerramientas de SEO
Solo FetchFox
Raspador de IAautomatizaciónHerramientas para desarrolladoresinvestigación de mercadoNo-code

Audiencia y roles

Compartido
No hay datos verificados
Solo Crawlbase
Propietario de NegocioAnalista de DatosGerente de MarketingGerente de ProductoInvestigadorRepresentante de VentasEspecialista en SEODesarrollador de Software
Solo FetchFox
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Crawlbase monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
32.4K
Duración media
0:19
Páginas por visita
2
Tasa de rebote
38.17%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 82.1K
  • 2026-01: 74.4K
  • 2026-02: 50K
  • 2026-03: 46.3K
  • 2026-04: 35.7K
  • 2026-05: 32.4K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇩🇪Germany25.96%8.4K
🇷🇺Russia22.56%7.3K
🇻🇳Vietnam18.35%5.9K
🇳🇬Nigeria17.5%5.7K
🇺🇸United States15.63%5.1K

Palabras clave

apifycrawlbasedeviantart scraperwebscraping at scaleпрокси в 2026 году бесплатно

FetchFox monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
40.3K
Duración media
5:28
Páginas por visita
4.08
Tasa de rebote
57.8%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.7K
  • 2026-01: 1.9K
  • 2026-02: 771
  • 2026-03: 1K
  • 2026-04: 14.8K
  • 2026-05: 40.3K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India45.78%18.5K
🇺🇸United States44.91%18.1K
🇪🇸Spain9.31%3.8K

Palabras clave

fetch foxfetchfox aifetchfoxaifetchfox.iafounding engineer equity

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Crawlbase

Valoración
Sin verificar
Comentarios
0
Favoritos
187
Me gusta
195

FetchFox

Valoración
Sin verificar
Comentarios
0
Favoritos
149
Me gusta
149

Crawlbase vs FetchFox · Preguntas frecuentes

What do Crawlbase and FetchFox have in common?
Both tools are listed under Extracción de Datos、Web Scraping、Generación de Leads. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Crawlbase and FetchFox free?
Listed pricing models: Crawlbase — Freemium; FetchFox — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Crawlbase and FetchFox?
The primary listed category is Extracción de Datos for Crawlbase, and Extracción de Datos for FetchFox. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas