Crawly
Extracción de Datos Web
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Extracción de Datos Web
Extracción de Datos Web
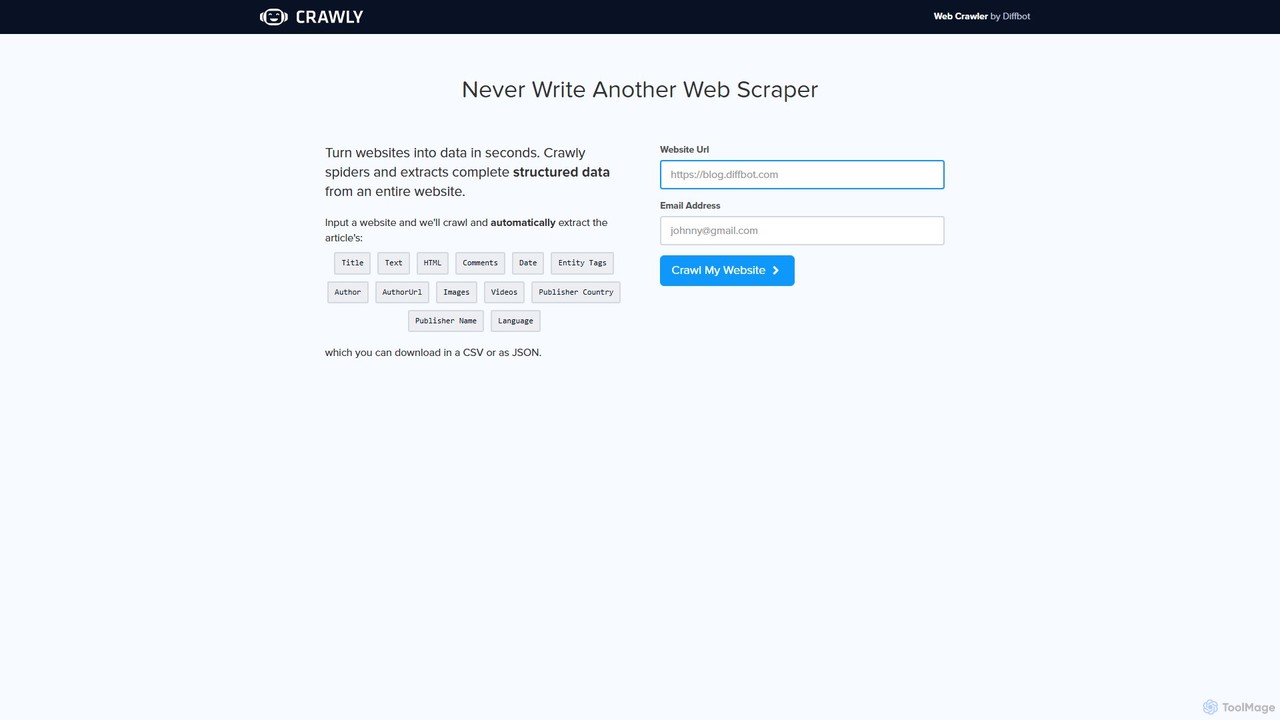
Crawly es un rastreador web impulsado por IA de Diffbot que extrae automáticamente datos estructurados de sitios web completos. Simplemente introduce una URL y Crawly rastrea el sitio para obtener información clave como artículos, productos y discusiones, convirtiéndola en datos limpios en JSON o CSV sin necesidad de codificar.
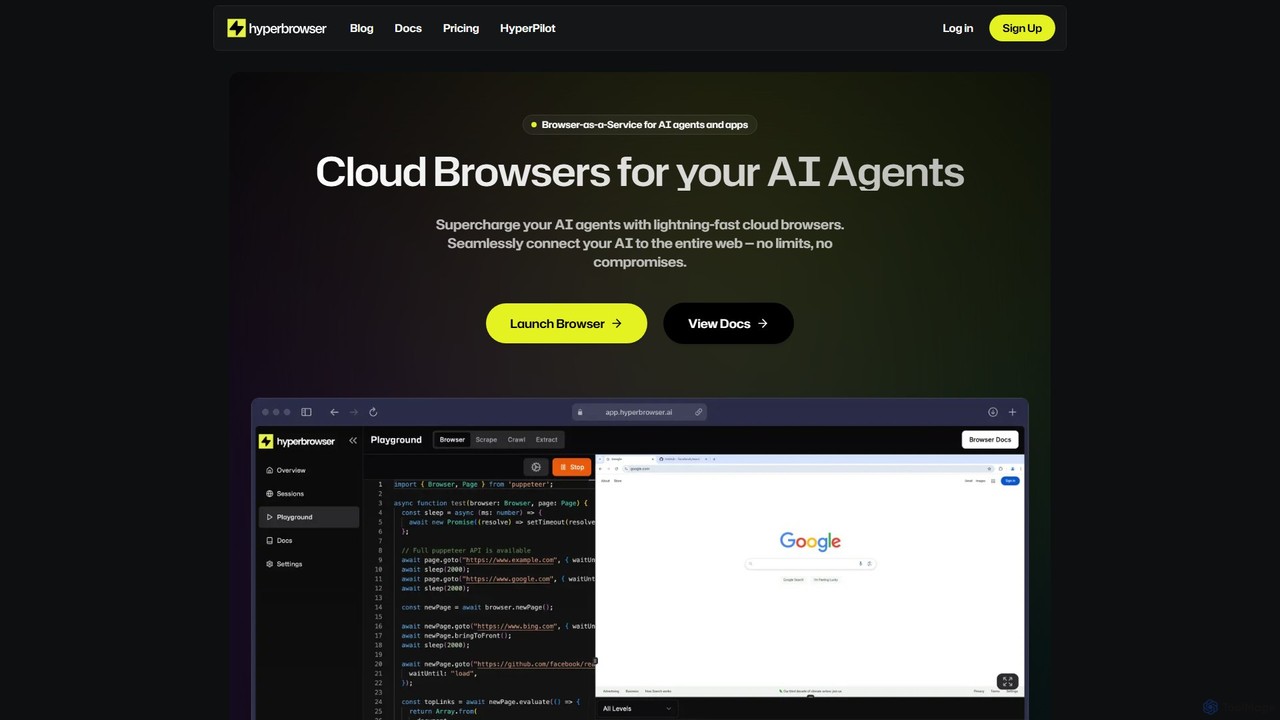
Hyperbrowser es una plataforma de Navegador como Servicio (BaaS) diseñada para agentes de IA y desarrolladores. Proporciona navegadores en la nube escalables y ultrarrápidos para automatizar tareas web, extraer datos y permitir interacciones web impulsadas por IA. Con funciones como navegación sigilosa, resolución automática de captchas y API amigables para desarrolladores, potencia flujos de trabajo complejos sin límites.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Datos clave | Crawly | Hyperbrowser |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Extracción de Datos Web | Extracción de Datos Web |
| Audiencia y roles | Sin verificar | Sin verificar |
| Categorías | Extracción de Datos Web · API · Investigación de Mercado · Automatización | Extracción de Datos Web · API · Automatización |
| Added | 10 ago 2025 | 5 ago 2025 |
| Actualizado | 19 nov 2026 | 19 nov 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Crawly es un potente e inteligente rastreador web desarrollado por Diffbot, líder en la extracción de datos impulsada por IA. Está diseñado para eliminar por completo los desafíos manuales y técnicos del web scraping. En lugar de escribir código complejo o usar selectores frágiles que se rompen con las actualizaciones del sitio web, Crawly aprovecha la inteligencia artificial avanzada, incluyendo la visión por computadora y el procesamiento del lenguaje natural, para entender e interpretar las páginas web como lo haría un humano. Esto le permite identificar y extraer automáticamente datos completos y estructurados de un sitio web entero con solo una URL como entrada.
La promesa central de Crawly es 'convertir sitios web en datos en segundos'. Navega a través de un sitio web, siguiendo enlaces y analizando la estructura de cada página para diferenciar entre varios tipos de contenido como artículos, productos, discusiones y galerías de imágenes. Los datos extraídos se organizan luego en un formato limpio y estructurado, listo para su uso inmediato en aplicaciones, análisis de datos o modelos de aprendizaje automático.
Usar Crawly está diseñado para ser increíblemente simple y accesible para todos, independientemente de su habilidad técnica. El proceso implica solo unos pocos pasos:
Crawly es una herramienta versátil adecuada para una amplia gama de aplicaciones:
La principal ventaja de Crawly es su simplicidad y potencia. Democratiza la extracción de datos web, permitiendo a los no desarrolladores realizar tareas que normalmente requerirían un equipo de ingenieros. Ahorra inmensas cantidades de tiempo y recursos al automatizar todo el proceso de scraping. Además, su enfoque impulsado por la IA garantiza una mayor precisión y una mayor resiliencia que los métodos tradicionales, proporcionando un flujo confiable de datos de alta calidad. Al ser un producto de Diffbot, está respaldado por tecnología de nivel empresarial en la que confían las principales corporaciones de todo el mundo.
Crawly ofrece un rastreo de prueba gratuito directamente desde su página de inicio, permitiendo a los usuarios probar sus capacidades introduciendo una URL y una dirección de correo electrónico. Esto está diseñado para proporcionar una muestra de los datos estructurados que la herramienta puede producir. Para necesidades más extensas, como el rastreo a gran escala, la extracción frecuente de datos o el acceso a la API para uso programático, los usuarios normalmente se suscribirían al conjunto completo de herramientas ofrecido por su empresa matriz, Diffbot. Los precios de Diffbot son escalonados, con planes disponibles para startups, empresas y grandes corporaciones, que ofrecen diferentes niveles de llamadas a la API y características.
Hyperbrowser es una potente plataforma de Navegador como Servicio (BaaS) diseñada para conectar agentes y aplicaciones de IA a toda la web. Proporciona a los desarrolladores acceso a una flota de navegadores en la nube de alta velocidad, seguros y escalables, eliminando las complejidades de gestionar instancias de navegador locales. Este servicio está diseñado específicamente para tareas exigentes como el web scraping a gran escala, la automatización de navegadores y la habilitación de agentes de IA sofisticados para interactuar con sitios web como lo haría un humano. Al ofrecer navegadores sin cabeza en contenedores aislados, Hyperbrowser garantiza la fiabilidad, la seguridad y el máximo rendimiento para cualquier proyecto, desde la simple extracción de datos hasta flujos de trabajo automatizados complejos y de misión crítica.
Empezar con Hyperbrowser es un proceso sencillo diseñado para desarrolladores. Primero, te registras en el sitio web para crear una cuenta y obtener tu clave de API única. Puedes empezar con el generoso plan gratuito que no requiere tarjeta de crédito. Una vez que tienes tu clave, puedes integrar Hyperbrowser en tu aplicación utilizando sus SDKs amigables para desarrolladores para Python y NodeJS, o haciendo peticiones cURL directas a su API. La plataforma proporciona documentación clara y ejemplos de código, incluyendo integraciones con frameworks de IA populares como OpenAI Tools y Anthropic Tools. Por ejemplo, puedes lanzar una sesión de navegador, asignar una tarea a un agente de IA (p. ej., 'Pide Fideos al Ajo de Burma Love en Doordash'), y hacer que Hyperbrowser gestione toda la interacción web, devolviendo el resultado estructurado.
Hyperbrowser es versátil y se puede aplicar a una amplia gama de escenarios. Sus principales casos de uso incluyen: Web Scraping a Gran Escala, donde los usuarios pueden extraer y estructurar datos de millones de páginas, como raspar resultados de búsqueda de Google o sitios de comercio electrónico como Shopify sin ser bloqueados. Otra aplicación clave es potenciar Agentes Web de IA, permitiéndoles realizar acciones complejas como reservar citas, realizar compras o llevar a cabo análisis competitivos detallados. También es invaluable para Pruebas de Software Automatizadas, permitiendo a los desarrolladores ejecutar pruebas de extremo a extremo en entornos de navegador reales a escala. Además, las empresas lo utilizan para Investigación de Mercado y Análisis Competitivo al automatizar la recopilación de datos sobre precios, productos y estrategias de marketing de la competencia.
La principal ventaja de Hyperbrowser es su capacidad para proporcionar una automatización de navegador escalable, fiable e indetectable. La plataforma garantiza un 99.9% de tiempo de actividad, lo que la hace adecuada para aplicaciones de misión crítica. Sus tiempos de lanzamiento de navegador ultrarrápidos, por debajo del segundo, permiten una rápida escalabilidad bajo demanda. La tolerancia a fallos y los mecanismos de auto-recuperación incorporados aseguran que los flujos de trabajo sean resilientes y fiables. Lo más importante es que sus capacidades sigilosas avanzadas y la resolución automática de captchas aumentan significativamente la tasa de éxito de las tareas de automatización web que de otro modo serían bloqueadas por medidas anti-bot.
Hyperbrowser ofrece una estructura de precios flexible y transparente con un modelo freemium para adaptarse a diferentes necesidades.
Plan Gratuito: $0/mes, incluye 1,000 créditos, 1 navegador concurrente, 7 días de retención de datos y modo sigiloso básico.
Plan Startup: $30/mes (más uso), incluye 30,000 créditos, 25 navegadores concurrentes, 30 días de retención de datos, resolución automática de captchas y modo sigiloso básico.
Plan Scale: $100/mes (más uso), incluye 100,000 créditos, 100 navegadores concurrentes, 30 días de retención de datos, resolución automática de captchas y modo sigiloso avanzado.
Plan Enterprise: Precios personalizados para necesidades de alto volumen, ofreciendo más de 250 navegadores concurrentes, más de 180 días de retención de datos, soporte premium y opciones de cumplimiento como HIPAA/SOC 2.
El uso se factura a $0.001 por crédito, $0.10 por hora de navegador y $10 por GB de datos de proxy.
La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.
El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 43.97% | 31.4K |
| 🇮🇳India | 28.23% | 20.2K |
| 🇻🇳Vietnam | 12.18% | 8.7K |
| 🇧🇷Brazil | 8.2% | 5.9K |
| 🇩🇪Germany | 7.42% | 5.3K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Directo | 91.73% | 65.5K |
| Referido | 7.22% | 5.2K |
| Correo electrónico | 1.05% | 750 |
Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.