ToolMage
Iniciar sesión

AI TOOL COMPARISON

Hyperbrowser vs webscrapeai

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Hyperbrowser Resumen del producto

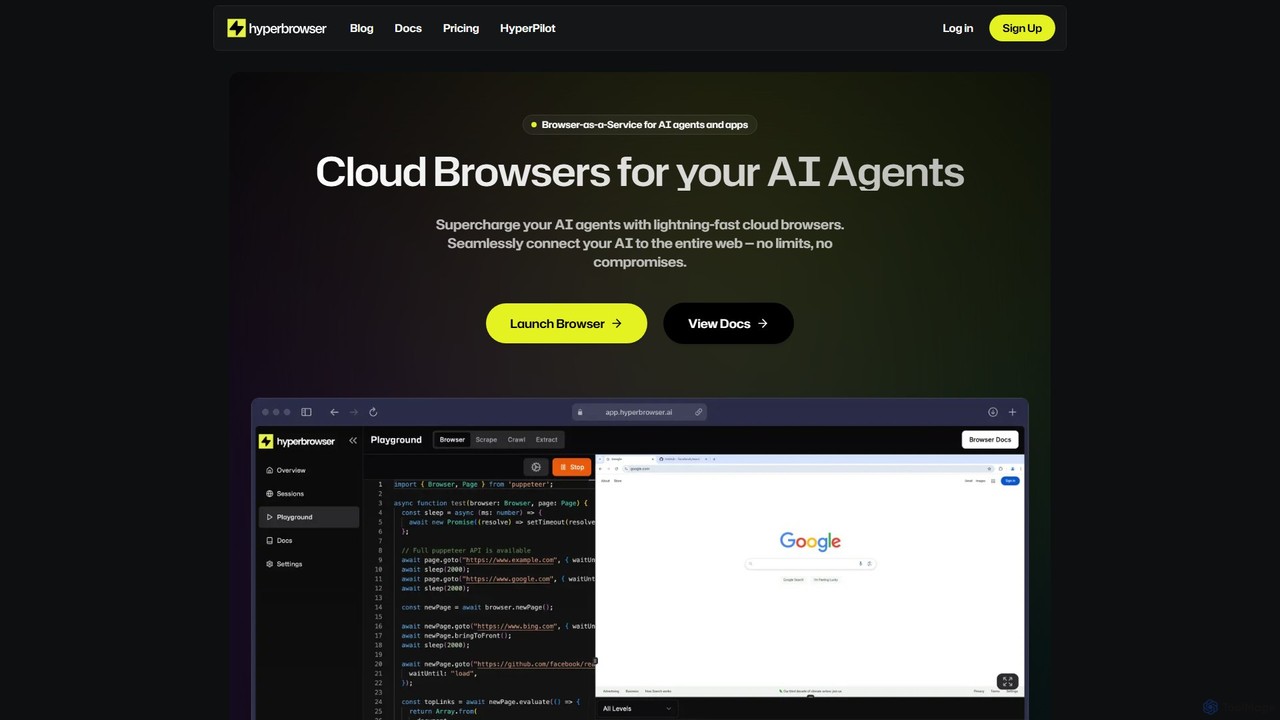
Hyperbrowser es una plataforma de Navegador como Servicio (BaaS) diseñada para agentes de IA y desarrolladores. Proporciona navegadores en la nube escalables y ultrarrápidos para automatizar tareas web, extraer datos y permitir interacciones web impulsadas por IA. Con funciones como navegación sigilosa, resolución automática de captchas y API amigables para desarrolladores, potencia flujos de trabajo complejos sin límites.

Preview

webscrapeai Resumen del producto

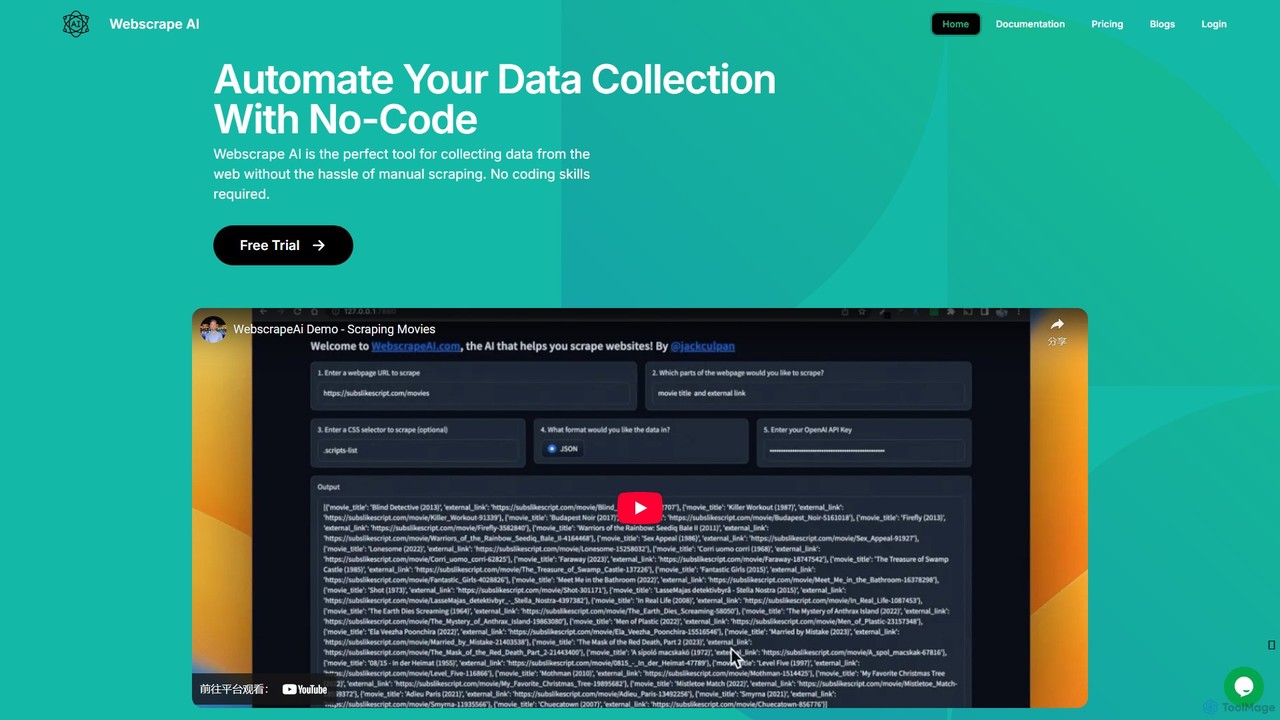
WebscrapeAI es una plataforma sin código, impulsada por IA, diseñada para automatizar la recopilación de datos web. Simplemente proporcione una URL y especifique los datos que necesita, y la IA se encarga de todo el proceso de scraping. Admite sitios web dinámicos, scraping masivo, integración de proxy y ofrece una API para desarrolladores, haciendo que la extracción de datos sea rápida, precisa y accesible para todos.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Hyperbrowser VS webscrapeai — Datos clave
Datos claveHyperbrowserwebscrapeai
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusExtracción de Datos WebExtracción de Datos Web
Audiencia y rolesSin verificarSin verificar
CategoríasExtracción de Datos Web · API · AutomatizaciónExtracción de Datos Web · API · Generación de Leads · Automatización
Added5 ago 202511 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Hyperbrowser

Hyperbrowser es una potente plataforma de Navegador como Servicio (BaaS) diseñada para conectar agentes y aplicaciones de IA a toda la web. Proporciona a los desarrolladores acceso a una flota de navegadores en la nube de alta velocidad, seguros y escalables, eliminando las complejidades de gestionar instancias de navegador locales. Este servicio está diseñado específicamente para tareas exigentes como el web scraping a gran escala, la automatización de navegadores y la habilitación de agentes de IA sofisticados para interactuar con sitios web como lo haría un humano. Al ofrecer navegadores sin cabeza en contenedores aislados, Hyperbrowser garantiza la fiabilidad, la seguridad y el máximo rendimiento para cualquier proyecto, desde la simple extracción de datos hasta flujos de trabajo automatizados complejos y de misión crítica.

Cómo usar Hyperbrowser

Empezar con Hyperbrowser es un proceso sencillo diseñado para desarrolladores. Primero, te registras en el sitio web para crear una cuenta y obtener tu clave de API única. Puedes empezar con el generoso plan gratuito que no requiere tarjeta de crédito. Una vez que tienes tu clave, puedes integrar Hyperbrowser en tu aplicación utilizando sus SDKs amigables para desarrolladores para Python y NodeJS, o haciendo peticiones cURL directas a su API. La plataforma proporciona documentación clara y ejemplos de código, incluyendo integraciones con frameworks de IA populares como OpenAI Tools y Anthropic Tools. Por ejemplo, puedes lanzar una sesión de navegador, asignar una tarea a un agente de IA (p. ej., 'Pide Fideos al Ajo de Burma Love en Doordash'), y hacer que Hyperbrowser gestione toda la interacción web, devolviendo el resultado estructurado.

Características principales de Hyperbrowser

  • Navegadores en la Nube Escalables: Ejecuta más de 1,000 navegadores concurrentes sin degradación del rendimiento, lanzándose en menos de 500ms para una escalabilidad instantánea.
  • Automatización Avanzada de Navegadores: Automatiza cualquier tarea basada en navegador, incluyendo web scraping complejo, pruebas automatizadas y rellenado de formularios en múltiples sitios.
  • Integración con Agentes de IA: Conéctate sin problemas con agentes de IA de frameworks como OpenAI y Anthropic, permitiéndoles navegar por la web, recopilar datos e interactuar con aplicaciones web para completar tareas.
  • Resolución Automática de Captchas: El manejo de captchas integrado resuelve automáticamente varios tipos de captchas (incluyendo reCAPTCHA) para asegurar que tus flujos de trabajo de automatización se ejecuten sin interrupciones.
  • Navegación Sigilosa (Stealth): Opera en modo sigiloso avanzado para eludir sistemas sofisticados de detección de bots, asegurando altas tasas de éxito para la recopilación de datos y la automatización.
  • Gestión Robusta de Sesiones: Gestiona sesiones de navegador con funciones como registro, depuración, aislamiento seguro de recursos y la capacidad de reutilizar perfiles de usuario para evitar inicios de sesión repetidos.
  • API Amigable para Desarrolladores: Una API simple y potente con SDKs oficiales para Python y NodeJS, que hace que la integración en tu pila tecnológica existente sea fluida y eficiente.

Casos de uso para Hyperbrowser

Hyperbrowser es versátil y se puede aplicar a una amplia gama de escenarios. Sus principales casos de uso incluyen: Web Scraping a Gran Escala, donde los usuarios pueden extraer y estructurar datos de millones de páginas, como raspar resultados de búsqueda de Google o sitios de comercio electrónico como Shopify sin ser bloqueados. Otra aplicación clave es potenciar Agentes Web de IA, permitiéndoles realizar acciones complejas como reservar citas, realizar compras o llevar a cabo análisis competitivos detallados. También es invaluable para Pruebas de Software Automatizadas, permitiendo a los desarrolladores ejecutar pruebas de extremo a extremo en entornos de navegador reales a escala. Además, las empresas lo utilizan para Investigación de Mercado y Análisis Competitivo al automatizar la recopilación de datos sobre precios, productos y estrategias de marketing de la competencia.

Ventajas de Hyperbrowser

La principal ventaja de Hyperbrowser es su capacidad para proporcionar una automatización de navegador escalable, fiable e indetectable. La plataforma garantiza un 99.9% de tiempo de actividad, lo que la hace adecuada para aplicaciones de misión crítica. Sus tiempos de lanzamiento de navegador ultrarrápidos, por debajo del segundo, permiten una rápida escalabilidad bajo demanda. La tolerancia a fallos y los mecanismos de auto-recuperación incorporados aseguran que los flujos de trabajo sean resilientes y fiables. Lo más importante es que sus capacidades sigilosas avanzadas y la resolución automática de captchas aumentan significativamente la tasa de éxito de las tareas de automatización web que de otro modo serían bloqueadas por medidas anti-bot.

Precios y planes

Hyperbrowser ofrece una estructura de precios flexible y transparente con un modelo freemium para adaptarse a diferentes necesidades.
Plan Gratuito: $0/mes, incluye 1,000 créditos, 1 navegador concurrente, 7 días de retención de datos y modo sigiloso básico.
Plan Startup: $30/mes (más uso), incluye 30,000 créditos, 25 navegadores concurrentes, 30 días de retención de datos, resolución automática de captchas y modo sigiloso básico.
Plan Scale: $100/mes (más uso), incluye 100,000 créditos, 100 navegadores concurrentes, 30 días de retención de datos, resolución automática de captchas y modo sigiloso avanzado.
Plan Enterprise: Precios personalizados para necesidades de alto volumen, ofreciendo más de 250 navegadores concurrentes, más de 180 días de retención de datos, soporte premium y opciones de cumplimiento como HIPAA/SOC 2.
El uso se factura a $0.001 por crédito, $0.10 por hora de navegador y $10 por GB de datos de proxy.

webscrapeai

WebscrapeAI es una herramienta potente e intuitiva diseñada para revolucionar la forma en que los usuarios recopilan datos de la web. Aprovechando la inteligencia artificial avanzada, ofrece una solución completamente sin código para el web scraping, haciéndola accesible para empresas, investigadores e individuos, independientemente de sus habilidades técnicas. La plataforma está construida para manejar las complejidades de los sitios web modernos, automatizando el proceso de extracción de datos para ahorrarle tiempo y esfuerzo.

El principio fundamental de WebscrapeAI es la simplicidad. Los usuarios pueden comenzar a hacer scraping en solo unos pocos pasos sin escribir una sola línea de código. El motor impulsado por IA analiza inteligentemente las estructuras de los sitios web para identificar y extraer los datos solicitados con alta precisión. Ya sea que necesite raspar una sola página o miles de URLs en masa, WebscrapeAI proporciona una solución escalable y rentable.

Cómo usar webscrapeai

Usar WebscrapeAI es un proceso optimizado diseñado para la eficiencia y la facilidad de uso:

  1. Introduzca la URL: Comience proporcionando la URL exacta del sitio web que desea raspar.
  2. Especifique los requisitos de datos: Use una entrada simple, similar a una línea de comandos, para decirle a la IA qué datos desea extraer (por ejemplo, "Quiero extraer todos los nombres de productos, precios y valoraciones").
  3. Genere el esquema: La IA analizará el sitio web y generará automáticamente un esquema de datos basado en su comando. Puede revisar y modificar este esquema manualmente si es necesario para asegurarse de que coincida perfectamente con sus requisitos.
  4. Ejecute el Scraper: Una vez confirmado el esquema, haga clic en el botón "Ejecutar Web Scraper". El modelo de IA comenzará el proceso de extracción. Para planes avanzados, puede configurar ajustes como proxies, encabezados personalizados e instrucciones de JavaScript (por ejemplo, para hacer clic en botones, desplazarse o esperar a que se carguen los elementos) antes de ejecutar.
  5. Descargue los datos: Una vez finalizado el scraping, puede descargar los datos extraídos en su formato preferido, incluyendo CSV, JSON o texto sin formato.
  6. Integración de API: Para los desarrolladores, WebscrapeAI ofrece una API REST. Al realizar una solicitud HTTP con su clave de API, URL y comando de datos, puede integrar el scraping automatizado directamente en sus aplicaciones.

Características principales de webscrapeai

  • Scraping impulsado por IA: Utiliza IA avanzada para comprender las estructuras de los sitios web y extraer datos basados en comandos de lenguaje natural, eliminando la necesidad de configurar selectores manualmente.
  • Interfaz sin código: Una plataforma fácil de usar que no requiere habilidades de programación para operar.
  • Scraping masivo: El plan Bulk permite a los usuarios raspar datos de múltiples URLs simultáneamente, ideal para proyectos de recopilación de datos a gran escala.
  • Manejo de sitios web dinámicos: Los planes Pro y Bulk admiten la ejecución de JavaScript, lo que permite al scraper interactuar con páginas dinámicas, hacer clic en botones, manejar el desplazamiento infinito y esperar a que se cargue el contenido.
  • Soporte de proxy: Los usuarios pueden integrar sus propios proxies para gestionar su huella de IP, evitar bloqueos y acceder a contenido geo-restringido.
  • Encabezados personalizados: Establezca encabezados de solicitud personalizados (por ejemplo, User-Agent) para imitar el comportamiento real del navegador y obtener acceso a versiones específicas del sitio web.
  • Múltiples formatos de exportación: Exporte los datos recopilados como CSV para hojas de cálculo, JSON para aplicaciones o texto simple.
  • API para desarrolladores: Una API robusta está disponible para integrar las capacidades de WebscrapeAI en aplicaciones y flujos de trabajo personalizados.
  • Soporte de paginación: Maneja automáticamente el raspado de datos a través de múltiples páginas.

Casos de uso para webscrapeai

WebscrapeAI es versátil y se puede aplicar en diversas industrias:

  • Investigación de mercado: Recopile precios de la competencia, detalles de productos y reseñas de clientes para analizar tendencias y estrategias de mercado.
  • Generación de leads: Extraiga información de contacto (correos electrónicos, números de teléfono, perfiles sociales) de directorios de empresas y redes profesionales.
  • Comercio electrónico: Monitoree los precios de los productos, la disponibilidad de stock y las novedades en sitios de comercio electrónico como Amazon.
  • Agregación de contenido: Reúna artículos, noticias y publicaciones de diversas fuentes para un centro de contenido o un agregador de noticias.
  • Análisis financiero: Raspe datos del mercado de valores, estados financieros y listados de bienes raíces para análisis y decisiones de inversión.
  • Investigación académica: Recopile grandes conjuntos de datos de fuentes en línea para estudios científicos e investigación en ciencias sociales.

Ventajas de webscrapeai

WebscrapeAI ofrece varias ventajas clave:

  • Facilidad de uso: El enfoque sin código reduce significativamente la barrera de entrada para el web scraping.
  • Precisión: Los algoritmos avanzados de IA garantizan que los datos recopilados sean precisos y fiables.
  • Ahorro de tiempo: Automatiza un proceso tradicionalmente manual y que consume mucho tiempo, liberando tiempo valioso para el análisis y otras tareas.
  • Rentable: Ofrece planes de precios asequibles adecuados para empresas de todos los tamaños, desde startups hasta grandes corporaciones.
  • Velocidad: Emplea métodos de última generación para garantizar una rápida recopilación de datos.
  • Flexibilidad: Altamente personalizable con soporte para proxies, encabezados e instrucciones de JS para abordar escenarios de scraping complejos.

Precios y planes

WebscrapeAI ofrece varios planes de suscripción, disponibles mensualmente o con un descuento por facturación anual. Todos los planes incluyen funcionalidad sin código y soporte en vivo.

  • Prueba gratuita: Hay una prueba gratuita disponible para que los usuarios prueben las capacidades de la plataforma.
  • Plan WebScrapeAI: $27/mes. Incluye 250 URLs por mes. Ideal para tareas básicas de scraping de una sola URL.
  • Plan WebScrapeAI Pro: $47/mes. Incluye 500 URLs por mes. Agrega soporte de proxy, espera de carga / ejecución de JS y otras funciones de scraping adicionales para sitios web dinámicos.
  • Plan WebScrapeAI Bulk: $87/mes. Incluye 1000 URLs por mes. Contiene todas las características del plan Pro, más la capacidad de raspar URLs en masa y soporte para paginación.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de Datos WebAPIAutomatización
Solo Hyperbrowser
No hay datos verificados
Solo webscrapeai
Generación de Leads

Etiquetas

Compartido
APIExtracción de datosWeb scraping
Solo Hyperbrowser
Agente de IAAutomatización de navegadorResolución de captchaHerramientas para desarrolladoresNavegador headlessNavegación sigilosa
Solo webscrapeai
Raspador de IAautomatizaciónCSVRecopilación de datosJSONGeneración de leadsinvestigación de mercadoNo-code

Audiencia y roles

Compartido
No hay datos verificados
Solo Hyperbrowser
No hay datos verificados
Solo webscrapeai
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Hyperbrowser monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
71.4K
Duración media
0:38
Páginas por visita
2.21
Tasa de rebote
40.26%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 34.5K
  • 2026-01: 71.4K
  • 2026-02: 66.8K
  • 2026-03: 67.3K
  • 2026-04: 56.7K
  • 2026-05: 71.4K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States43.97%31.4K
🇮🇳India28.23%20.2K
🇻🇳Vietnam12.18%8.7K
🇧🇷Brazil8.2%5.9K
🇩🇪Germany7.42%5.3K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo91.73%65.5K
Referido7.22%5.2K
Correo electrónico1.05%750

Palabras clave

hyper agenthyperagenthyper browserhyperbrowserhyperbrowser ai

webscrapeai monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
352
Duración media
0:00
Páginas por visita
1.03
Tasa de rebote
32.99%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 3.6K
  • 2026-01: 622
  • 2026-02: 460
  • 2026-03: 1.2K
  • 2026-04: 227
  • 2026-05: 352

Palabras clave

google webdriver for web scrappinghttps error 444scrapper yiwebscrapewebscraper

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Hyperbrowser

Valoración
Sin verificar
Comentarios
0
Favoritos
153
Me gusta
162

webscrapeai

Valoración
Sin verificar
Comentarios
0
Favoritos
156
Me gusta
182

Hyperbrowser vs webscrapeai · Preguntas frecuentes

What do Hyperbrowser and webscrapeai have in common?
Both tools are listed under Extracción de Datos Web、API、Automatización. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Hyperbrowser and webscrapeai free?
Listed pricing models: Hyperbrowser — Freemium; webscrapeai — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Hyperbrowser and webscrapeai?
The primary listed category is Extracción de Datos Web for Hyperbrowser, and Extracción de Datos Web for webscrapeai. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas