ToolMage
Iniciar sesión

AI TOOL COMPARISON

Runpod vs Tensorfuse

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Runpod Resumen del producto

Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.

Preview

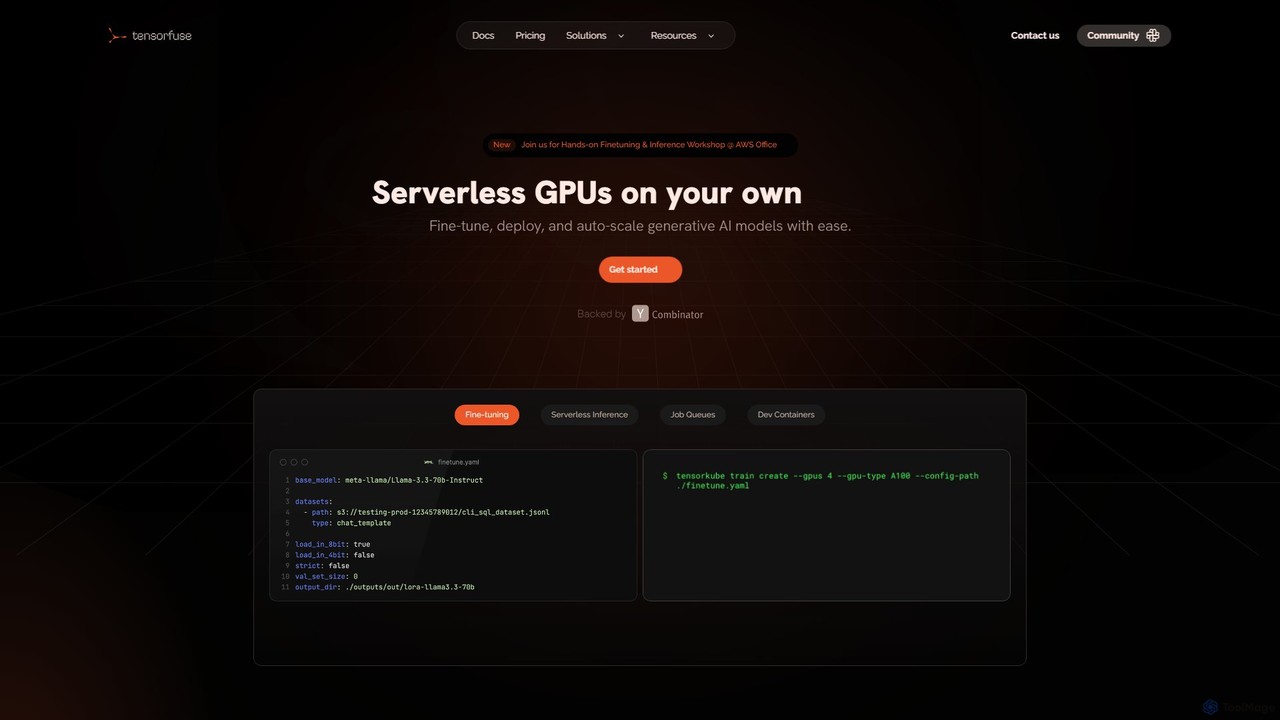
Tensorfuse Resumen del producto

Tensorfuse es una plataforma de GPU sin servidor que permite a los desarrolladores ajustar, desplegar y autoescalar modelos de IA generativa en su propia nube de AWS. Simplifica la gestión de la infraestructura, ofreciendo características como inferencia sin servidor, colas de trabajos y contenedores de desarrollo para acelerar el desarrollo, reducir costes y eliminar la sobrecarga de DevOps.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Runpod VS Tensorfuse — Datos clave
Datos claveRunpodTensorfuse
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusAprendizaje AutomáticoDespliegue
Audiencia y rolesSin verificarSin verificar
CategoríasAprendizaje Automático · Computación en la Nube · AutomatizaciónDespliegue · MLOps · Computación en la Nube
Added6 ago 202515 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Runpod

Runpod es una plataforma de nube de IA de extremo a extremo diseñada para eliminar las complejidades de construir, entrenar e implementar modelos de IA. Proporciona a los desarrolladores, investigadores y empresas una solución optimizada, potente y rentable para todas sus necesidades de computación de IA/ML. Al ofrecer acceso bajo demanda a una amplia gama de GPUs a través de una red global de centros de datos, Runpod permite a los usuarios pasar de la idea a una aplicación lista para producción sin los típicos dolores de cabeza de la gestión de infraestructura, el escalado y los altos costos.

La plataforma está construida para constructores, centrándose en la velocidad, la flexibilidad y la eficiencia. Ya sea que esté ajustando un gran modelo de lenguaje, sirviendo inferencia en tiempo real para una aplicación o ejecutando simulaciones de cómputo intensivo, Runpod proporciona las herramientas y la infraestructura necesarias para hacerlo a escala. Su objetivo es ser la columna vertebral computacional para la próxima generación de empresas de IA, permitiéndoles centrarse en la innovación en lugar de en la infraestructura.

Cómo usar Runpod

Usar Runpod implica un flujo de trabajo sencillo diseñado para un desarrollo e implementación rápidos:

  1. Elija un Servicio: Seleccione entre GPU Cloud para desarrollo interactivo y tareas de larga duración, o Serverless para puntos finales de inferencia escalables y bajo demanda.
  2. Seleccione una Plantilla: Inicie su proyecto eligiendo entre una amplia gama de plantillas preconstruidas para marcos y aplicaciones populares como PyTorch, TensorFlow, Stable Diffusion y varios LLMs.
  3. Inicie un Pod: Ponga en marcha un entorno habilitado para GPU, conocido como 'Pod', en menos de un minuto. Puede personalizar el tipo de GPU, vCPUs, RAM y almacenamiento para satisfacer sus necesidades específicas.
  4. Conéctese y Construya: Acceda a su Pod a través de SSH o Jupyter Lab para instalar dependencias, cargar su código y comenzar a entrenar o construir su aplicación.
  5. Gestione Datos: Utilice Volúmenes Persistentes o Volúmenes de Red compatibles con S3 para almacenar sus conjuntos de datos, modelos y datos de contenedores. Una ventaja clave es la ausencia de tarifas de entrada o salida por la transferencia de datos.
  6. Implemente y Escale: Para cargas de trabajo de producción, implemente su modelo como un punto final sin servidor. La función de autoescalado de Runpod gestionará automáticamente el número de trabajadores de GPU (de 0 a miles) según la demanda en tiempo real, asegurando que solo pague por el cómputo que utiliza.

Características principales de Runpod

  • Computación de GPU Escalable: Acceda a una amplia variedad de GPUs, desde RTX 4090 de consumo hasta H100 y B200 de nivel empresarial, disponibles tanto en una Community Cloud rentable como en una Secure Cloud de alta seguridad.
  • GPUs sin Servidor: Implemente modelos como puntos finales de API que se escalan automáticamente desde cero para manejar cualquier carga de trabajo, eliminando los costos de inactividad.
  • Tecnología FlashBoot: Logre un escalado ultrarrápido con tiempos de arranque en frío inferiores a 200 ms, asegurando que su aplicación siempre sea receptiva.
  • Almacenamiento Persistente: Almacenamiento compatible con S3 sin tarifas de entrada/salida, lo que le permite ejecutar pipelines de IA completos, desde la ingesta de datos hasta la implementación, sin problemas.
  • Plantillas Preconstruidas: Una rica biblioteca de plantillas para configurar instantáneamente entornos para entrenamiento, inferencia y más, reduciendo significativamente el tiempo de configuración.
  • Infraestructura Global: Implemente cargas de trabajo en más de 8 regiones en todo el mundo para un rendimiento de baja latencia y fiabilidad global.
  • Orquestación y Monitoreo Integrados: La plataforma maneja la cola y distribución de tareas automáticamente, y proporciona registros, monitoreo y métricas en tiempo real sin requerir marcos personalizados.

Casos de uso para Runpod

Runpod es versátil y admite una amplia gama de aplicaciones:

  • Servicio de Inferencia: Implemente y sirva inferencia para modelos de generación de imágenes, texto y audio a cualquier escala con baja latencia.
  • Ajuste Fino de Modelos: Entrene y ajuste modelos personalizados en sus conjuntos de datos específicos de manera eficiente y rentable.
  • Agentes de IA: Construya y aloje sistemas inteligentes y autónomos basados en agentes y flujos de trabajo complejos.
  • Tareas de Cómputo Intensivo: Ejecute cargas de trabajo exigentes como renderizado 3D, simulaciones científicas y procesamiento de datos a gran escala.

Ventajas de Runpod

Runpod ofrece ventajas significativas sobre los proveedores de nube tradicionales:

  • Rentabilidad: Con facturación por segundo, precios de GPU competitivos y cero tarifas de salida de datos, los usuarios informan de ahorros de hasta el 90% en sus facturas de infraestructura.
  • Velocidad y Agilidad: Pase de la idea a la ejecución en segundos. El aprovisionamiento rápido de la plataforma, los arranques en frío mínimos y las capacidades de autoescalado aceleran el ciclo de vida del desarrollo.
  • Simplicidad: Abstraer la complejidad de la infraestructura permite a los equipos centrarse en su producto y características principales, no en DevOps.
  • Flexibilidad: Entornos altamente personalizables, incluidos modelos de GPU, comportamientos de escalado, límites de tiempo de inactividad y ubicaciones de centros de datos.
  • Fiabilidad: Servicio de nivel empresarial con un 99.9% de tiempo de actividad, conmutación por error integrada y seguridad robusta (SOC2, HIPAA, GDPR en proceso).

Precios y planes

Los precios de Runpod son transparentes y están diseñados para ser rentables.

  • GPU Cloud: Se factura por hora, con precios que varían según el tipo de GPU y si se encuentra en la Secure Cloud o en la Community Cloud más asequible. Por ejemplo, una RTX 4090 puede costar tan solo $0.69/h, mientras que una H100 SXM de gama alta cuesta alrededor de $2.69/h.
  • Serverless (Inferencia): Se factura por segundo de tiempo de procesamiento. El precio se escalona según el rendimiento de la GPU, con tarifas separadas para los trabajadores 'Flex' (precalentados) y 'Active'. Este modelo es muy eficiente para el tráfico variable.
  • Almacenamiento: El almacenamiento persistente de Pod tiene un precio de $0.10/GB/mes. El almacenamiento de Volumen de Red compatible con S3 es aún más barato, a $0.07/GB/mes por menos de 1TB. No hay tarifas de entrada o salida.
  • Reservas: Para cargas de trabajo a largo plazo, los usuarios pueden reservar capacidad con una tarifa de descuento hablando con el equipo de ventas.

Tensorfuse

Tensorfuse proporciona una potente plataforma para que desarrolladores y organizaciones gestionen GPUs sin servidor directamente en su propia infraestructura de nube de AWS. Está diseñada para agilizar todo el ciclo de vida de los modelos de IA generativa, desde el ajuste fino y la experimentación hasta el despliegue y el autoescalado en producción. Al abstraer las complejidades de Kubernetes, Docker y el aprovisionamiento de infraestructura, Tensorfuse permite a los equipos centrarse en la creación de aplicaciones de IA, reduciendo significativamente el tiempo de comercialización y los costes operativos.

La plataforma está construida para ofrecer lo mejor de ambos mundos: la simplicidad de una arquitectura sin servidor y la seguridad y el control de ejecutar en su nube privada. Esto significa que sus datos propietarios y los pesos de los modelos nunca abandonan sus buckets privados de S3, garantizando la máxima seguridad y cumplimiento. Tensorfuse está diseñado para la eficiencia, con un tiempo de ejecución de contenedores optimizado que permite arranques en frío rápidos para cargas de trabajo pesadas de GPU, permitiendo que los servicios escalen desde cero en segundos.

Cómo usar Tensorfuse

Empezar a usar Tensorfuse está diseñado para ser un proceso sencillo:

  1. Regístrese y conecte AWS: Comience registrándose en un plan (incluido un nivel gratuito 'Hacker') y conectando su cuenta de AWS. Tensorfuse configurará entonces los recursos necesarios dentro de su entorno de nube.
  2. Use Contenedores de Desarrollo para la Experimentación: Conecte su IDE local (como VS Code) directamente a una GPU en la nube utilizando los Contenedores de Desarrollo de Tensorfuse. Esto elimina la necesidad de SSH, copia de código y gestión de dependencias. Cualquier cambio en su código local se sincroniza instantáneamente, permitiendo una experimentación rápida en tiempo real.
  3. Ajuste Fino de Modelos: Utilice bibliotecas de entrenamiento populares como Axolotl, Unsloth o Hugging Face para ajustar modelos de código abierto en sus conjuntos de datos propietarios. También puede escribir bucles de entrenamiento personalizados. La plataforma se encarga del aprovisionamiento y la gestión de la GPU subyacente.
  4. Despliegue para Inferencia: Despliegue sus modelos entrenados o preentrenados como puntos finales sin servidor. Estos puntos finales se escalan automáticamente en función del tráfico entrante, desde cero para manejar una alta concurrencia, garantizando la eficiencia de costes y el rendimiento. Los modelos pueden exponerse como API compatibles con OpenAI.
  5. Gestione con Colas de Trabajos: Para tareas asíncronas como el procesamiento por lotes o la inferencia fuera de línea, utilice la función de Colas de Trabajos. Puede poner trabajos en cola programáticamente, definir parámetros de escalado mínimo y máximo para una asignación eficiente de recursos y supervisar su estado mediante un simple comando CLI.

Características principales de Tensorfuse

  • Inferencia Sin Servidor: Escala automáticamente los despliegues de GPU en respuesta al tráfico, con arranques en frío rápidos (iniciando contenedores en segundos) y la capacidad de escalar a cero para ahorrar costes.
  • Ajuste Fino Eficiente: Ajuste modelos de forma segura en sus datos privados utilizando el S3 de su nube. Ofrece una integración flexible con frameworks populares como Axolotl y Huggingface.
  • Colas de Trabajos: Despliegue y ponga en cola trabajos programáticamente para el procesamiento por lotes, con una asignación eficiente de recursos y control de costes mediante un escalado configurable.
  • Contenedores de Desarrollo: Conecte el código local a las GPU en la nube sin SSH para un desarrollo y experimentación rápidos e iterativos directamente desde su IDE favorito.
  • Inferencia Multi-LoRA: Soporte nativo para entrenar e intercambiar en caliente miles de adaptadores LoRA en una sola GPU, maximizando la utilización del hardware y reduciendo los costes de inferencia.
  • Amplio Soporte de Hardware: Ejecute cargas de trabajo en una variedad de hardware, incluyendo GPUs de NVIDIA (A10G, A100, H100), chips AWS Trainium/Inferentia, TPUs y FPGAs.
  • Seguridad en la Nube Privada: Todos los datos, conjuntos de datos y pesos de los modelos permanecen dentro de sus buckets privados de S3 de AWS, garantizando un control y seguridad totales.

Casos de uso para Tensorfuse

Tensorfuse es ideal para una amplia gama de aplicaciones de IA/ML:

  • Startups y Equipos Pequeños: Construya y despliegue rápidamente funciones impulsadas por IA sin un equipo de DevOps dedicado, pasando de la idea a la producción 20 veces más rápido.
  • Inferencia a Gran Escala: Sirva modelos de IA generativa para aplicaciones con tráfico irregular o impredecible, pagando solo por el cómputo que utiliza.
  • Ajuste Fino de Modelos Personalizados: Las empresas pueden ajustar modelos base como Llama o Mistral en sus datos propietarios para crear modelos especializados y de alto rendimiento para necesidades empresariales específicas.
  • Cargas de Trabajo de Procesamiento por Lotes: Ejecute eficientemente tareas que no son en tiempo real, como análisis de datos, generación de informes o inferencia fuera de línea a gran escala, utilizando el rentable sistema de cola de trabajos.
  • Investigación y Experimentación en ML: Los investigadores e ingenieros de ML pueden usar los Contenedores de Desarrollo para iterar rápidamente en los modelos sin esperar la configuración de la infraestructura.

Ventajas de Tensorfuse

Los usuarios eligen Tensorfuse por sus importantes beneficios, que incluyen una reducción reportada del 30% en el gasto de GPU en la nube y un tiempo de producción 20 veces más rápido. Elimina la necesidad de soluciones DevOps complejas y autogestionadas, liberando recursos de ingeniería. La plataforma proporciona el rendimiento y la escalabilidad de un servicio gestionado con la seguridad y los beneficios de coste de ejecutar en su propia nube. Los testimonios destacan el excepcional y receptivo equipo de soporte, que ayuda con la migración y los problemas continuos, haciendo que el proceso de incorporación sea fluido y eficiente.

Precios y planes

Tensorfuse ofrece una estructura de precios por niveles para adaptarse a diferentes necesidades:

  • Hacker (Gratis): Para desarrolladores independientes y proyectos paralelos. Incluye 100 Horas de GPU Gestionadas (MGH), Inferencia Sin Servidor, Contenedores de Desarrollo y soporte comunitario.
  • Starter (249 $/mes): Para equipos pequeños. Incluye 2.000 MGH, todas las características de Hacker, más Ajuste Fino, GitHub Actions, Dominios Personalizados y soporte privado en Slack. Hay disponible una prueba gratuita de 14 días.
  • Growth (799 $/mes): Para startups en crecimiento. Incluye 5.000 MGH, todas las características de Starter, más Trabajos por Lotes y Colas de Trabajos, Entornos, inferencia Multi-LoRA y soporte premium. Hay disponible una prueba gratuita de 14 días.
  • Enterprise (Personalizado): Para grandes organizaciones que necesitan funciones avanzadas. Incluye MGH personalizado con descuentos por volumen, todas las características de Growth, más Control de Acceso Basado en Roles (RBAC), SSO, seguridad de nivel empresarial (SOC2, HIPAA) y soporte de ingeniería dedicado.
  • Oferta para Startups: Las startups en fase inicial con menos de 500.000 $ en financiación pueden ser elegibles para 10.000 horas de gestión de cómputo de GPU gratuitas durante 6 meses.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Computación en la Nube
Solo Runpod
Aprendizaje AutomáticoAutomatización
Solo Tensorfuse
DespliegueMLOps

Etiquetas

Compartido
Despliegue de Modelos de IAcomputación en la nubeAjuste finoInferencia
Solo Runpod
AutoescaladoHerramientas para desarrolladoresGPUinfraestructuraaprendizaje automáticoServerless
Solo Tensorfuse
AWSDockerIA generativaKubernetesMLOpsGPU sin servidor

Audiencia y roles

Compartido
No hay datos verificados
Solo Runpod
No hay datos verificados
Solo Tensorfuse
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Runpod monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
2.3M
Duración media
9:26
Páginas por visita
7.98
Tasa de rebote
31.98%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 1.6M
  • 2026-01: 1.9M
  • 2026-02: 1.9M
  • 2026-03: 2.4M
  • 2026-04: 2.3M
  • 2026-05: 2.3M

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States58.83%1.4M
🇮🇳India13.6%317.4K
🇩🇪Germany13.56%316.5K
🇧🇷Brazil7.44%173.7K
🇳🇬Nigeria6.57%153.3K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo78.77%1.8M
Referido20.03%467.5K
Correo electrónico1.2%28K

Palabras clave

run podrunpodrunpod passwordrunpod pricingrunpod serverless

Tensorfuse monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
6.7K
Duración media
1:01
Páginas por visita
1.8
Tasa de rebote
44.71%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.1K
  • 2026-01: 5.4K
  • 2026-02: 4.2K
  • 2026-03: 4.9K
  • 2026-04: 5.3K
  • 2026-05: 6.7K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States38.24%2.6K
🇻🇳Vietnam36.56%2.5K
🇮🇳India25.2%1.7K

Palabras clave

aws serverless gpubrew install aws clillama.cpp serverlessllm inference servers compared: vllm vs tgi vs sglang vs tritontensorfuse

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Runpod

Valoración
Sin verificar
Comentarios
0
Favoritos
146
Me gusta
166

Tensorfuse

Valoración
Sin verificar
Comentarios
0
Favoritos
170
Me gusta
144

Runpod vs Tensorfuse · Preguntas frecuentes

What do Runpod and Tensorfuse have in common?
Both tools are listed under Computación en la Nube. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Runpod and Tensorfuse free?
Listed pricing models: Runpod — Paid; Tensorfuse — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Runpod and Tensorfuse?
The primary listed category is Aprendizaje Automático for Runpod, and Despliegue for Tensorfuse. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas