

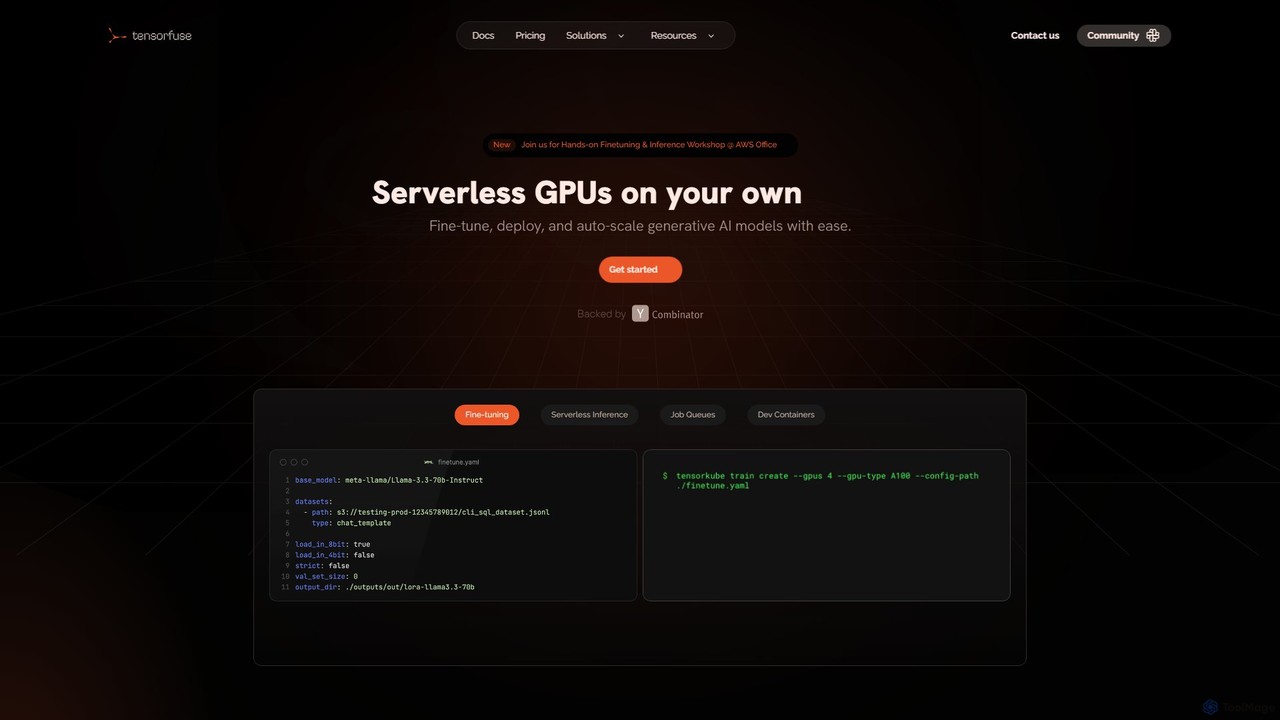
Tensorfuse Overview
Tensorfuse proporciona una potente plataforma para que desarrolladores y organizaciones gestionen GPUs sin servidor directamente en su propia infraestructura de nube de AWS. Está diseñada para agilizar todo el ciclo de vida de los modelos de IA generativa, desde el ajuste fino y la experimentación hasta el despliegue y el autoescalado en producción. Al abstraer las complejidades de Kubernetes, Docker y el aprovisionamiento de infraestructura, Tensorfuse permite a los equipos centrarse en la creación de aplicaciones de IA, reduciendo significativamente el tiempo de comercialización y los costes operativos.
La plataforma está construida para ofrecer lo mejor de ambos mundos: la simplicidad de una arquitectura sin servidor y la seguridad y el control de ejecutar en su nube privada. Esto significa que sus datos propietarios y los pesos de los modelos nunca abandonan sus buckets privados de S3, garantizando la máxima seguridad y cumplimiento. Tensorfuse está diseñado para la eficiencia, con un tiempo de ejecución de contenedores optimizado que permite arranques en frío rápidos para cargas de trabajo pesadas de GPU, permitiendo que los servicios escalen desde cero en segundos.
Cómo usar Tensorfuse
Empezar a usar Tensorfuse está diseñado para ser un proceso sencillo:
- Regístrese y conecte AWS: Comience registrándose en un plan (incluido un nivel gratuito 'Hacker') y conectando su cuenta de AWS. Tensorfuse configurará entonces los recursos necesarios dentro de su entorno de nube.
- Use Contenedores de Desarrollo para la Experimentación: Conecte su IDE local (como VS Code) directamente a una GPU en la nube utilizando los Contenedores de Desarrollo de Tensorfuse. Esto elimina la necesidad de SSH, copia de código y gestión de dependencias. Cualquier cambio en su código local se sincroniza instantáneamente, permitiendo una experimentación rápida en tiempo real.
- Ajuste Fino de Modelos: Utilice bibliotecas de entrenamiento populares como Axolotl, Unsloth o Hugging Face para ajustar modelos de código abierto en sus conjuntos de datos propietarios. También puede escribir bucles de entrenamiento personalizados. La plataforma se encarga del aprovisionamiento y la gestión de la GPU subyacente.
- Despliegue para Inferencia: Despliegue sus modelos entrenados o preentrenados como puntos finales sin servidor. Estos puntos finales se escalan automáticamente en función del tráfico entrante, desde cero para manejar una alta concurrencia, garantizando la eficiencia de costes y el rendimiento. Los modelos pueden exponerse como API compatibles con OpenAI.
- Gestione con Colas de Trabajos: Para tareas asíncronas como el procesamiento por lotes o la inferencia fuera de línea, utilice la función de Colas de Trabajos. Puede poner trabajos en cola programáticamente, definir parámetros de escalado mínimo y máximo para una asignación eficiente de recursos y supervisar su estado mediante un simple comando CLI.
Características principales de Tensorfuse
- Inferencia Sin Servidor: Escala automáticamente los despliegues de GPU en respuesta al tráfico, con arranques en frío rápidos (iniciando contenedores en segundos) y la capacidad de escalar a cero para ahorrar costes.
- Ajuste Fino Eficiente: Ajuste modelos de forma segura en sus datos privados utilizando el S3 de su nube. Ofrece una integración flexible con frameworks populares como Axolotl y Huggingface.
- Colas de Trabajos: Despliegue y ponga en cola trabajos programáticamente para el procesamiento por lotes, con una asignación eficiente de recursos y control de costes mediante un escalado configurable.
- Contenedores de Desarrollo: Conecte el código local a las GPU en la nube sin SSH para un desarrollo y experimentación rápidos e iterativos directamente desde su IDE favorito.
- Inferencia Multi-LoRA: Soporte nativo para entrenar e intercambiar en caliente miles de adaptadores LoRA en una sola GPU, maximizando la utilización del hardware y reduciendo los costes de inferencia.
- Amplio Soporte de Hardware: Ejecute cargas de trabajo en una variedad de hardware, incluyendo GPUs de NVIDIA (A10G, A100, H100), chips AWS Trainium/Inferentia, TPUs y FPGAs.
- Seguridad en la Nube Privada: Todos los datos, conjuntos de datos y pesos de los modelos permanecen dentro de sus buckets privados de S3 de AWS, garantizando un control y seguridad totales.
Casos de uso para Tensorfuse
Tensorfuse es ideal para una amplia gama de aplicaciones de IA/ML:
- Startups y Equipos Pequeños: Construya y despliegue rápidamente funciones impulsadas por IA sin un equipo de DevOps dedicado, pasando de la idea a la producción 20 veces más rápido.
- Inferencia a Gran Escala: Sirva modelos de IA generativa para aplicaciones con tráfico irregular o impredecible, pagando solo por el cómputo que utiliza.
- Ajuste Fino de Modelos Personalizados: Las empresas pueden ajustar modelos base como Llama o Mistral en sus datos propietarios para crear modelos especializados y de alto rendimiento para necesidades empresariales específicas.
- Cargas de Trabajo de Procesamiento por Lotes: Ejecute eficientemente tareas que no son en tiempo real, como análisis de datos, generación de informes o inferencia fuera de línea a gran escala, utilizando el rentable sistema de cola de trabajos.
- Investigación y Experimentación en ML: Los investigadores e ingenieros de ML pueden usar los Contenedores de Desarrollo para iterar rápidamente en los modelos sin esperar la configuración de la infraestructura.
Ventajas de Tensorfuse
Los usuarios eligen Tensorfuse por sus importantes beneficios, que incluyen una reducción reportada del 30% en el gasto de GPU en la nube y un tiempo de producción 20 veces más rápido. Elimina la necesidad de soluciones DevOps complejas y autogestionadas, liberando recursos de ingeniería. La plataforma proporciona el rendimiento y la escalabilidad de un servicio gestionado con la seguridad y los beneficios de coste de ejecutar en su propia nube. Los testimonios destacan el excepcional y receptivo equipo de soporte, que ayuda con la migración y los problemas continuos, haciendo que el proceso de incorporación sea fluido y eficiente.
Precios y planes
Tensorfuse ofrece una estructura de precios por niveles para adaptarse a diferentes necesidades:
- Hacker (Gratis): Para desarrolladores independientes y proyectos paralelos. Incluye 100 Horas de GPU Gestionadas (MGH), Inferencia Sin Servidor, Contenedores de Desarrollo y soporte comunitario.
- Starter (249 $/mes): Para equipos pequeños. Incluye 2.000 MGH, todas las características de Hacker, más Ajuste Fino, GitHub Actions, Dominios Personalizados y soporte privado en Slack. Hay disponible una prueba gratuita de 14 días.
- Growth (799 $/mes): Para startups en crecimiento. Incluye 5.000 MGH, todas las características de Starter, más Trabajos por Lotes y Colas de Trabajos, Entornos, inferencia Multi-LoRA y soporte premium. Hay disponible una prueba gratuita de 14 días.
- Enterprise (Personalizado): Para grandes organizaciones que necesitan funciones avanzadas. Incluye MGH personalizado con descuentos por volumen, todas las características de Growth, más Control de Acceso Basado en Roles (RBAC), SSO, seguridad de nivel empresarial (SOC2, HIPAA) y soporte de ingeniería dedicado.
- Oferta para Startups: Las startups en fase inicial con menos de 500.000 $ en financiación pueden ser elegibles para 10.000 horas de gestión de cómputo de GPU gratuitas durante 6 meses.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 10.1K
- 2026-1: 5.4K
- 2026-2: 4.2K
- 2026-3: 4.9K
- 2026-4: 5.3K
- 2026-5: 6.7K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos38.2%
- 🇻🇳Vietnam36.6%
- 🇮🇳India25.2%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws serverless gpu | $0.00 |
| brew install aws cli | $4.38 |
| llama.cpp serverless | $0.00 |
| llm inference servers compared: vllm vs tgi vs sglang vs triton | $0.00 |
| tensorfuse | $18.26 |
Tensorfuse Alternatives

Baseten
Baseten es una plataforma de inferencia de grado de producción para desplegar, escalar y gestionar modelos de IA. Ofrece tiempos de ejecución de alto rendimiento, flujos de trabajo de desarrollador fluidos y opciones de despliegue flexibles (nube, autohospedado, híbrido). Ideal para equipos de ingeniería y ML que construyen aplicaciones de IA de misión crítica.
Despliegue
Hopsworks
Hopsworks es un AI Lakehouse en tiempo real y el Feature Store más avanzado de la industria. Está diseñado para MLOps, unificando datos y computación para construir y operar sistemas de IA fiables y en tiempo real. Soporta cualquier framework, nube o entorno on-premise, permitiendo un desarrollo de modelos más rápido y una reducción de costes significativa.
Base de datos
Runpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje Automático
Nebius
Nebius es una plataforma en la nube de alto rendimiento diseñada específicamente para IA y aprendizaje automático. Proporciona acceso a las últimas GPU de NVIDIA, clústeres escalables con redes InfiniBand y servicios totalmente gestionados como Kubernetes y Slurm, permitiendo el entrenamiento, ajuste fino e inferencia de modelos de IA a cualquier escala.
Aprendizaje Automático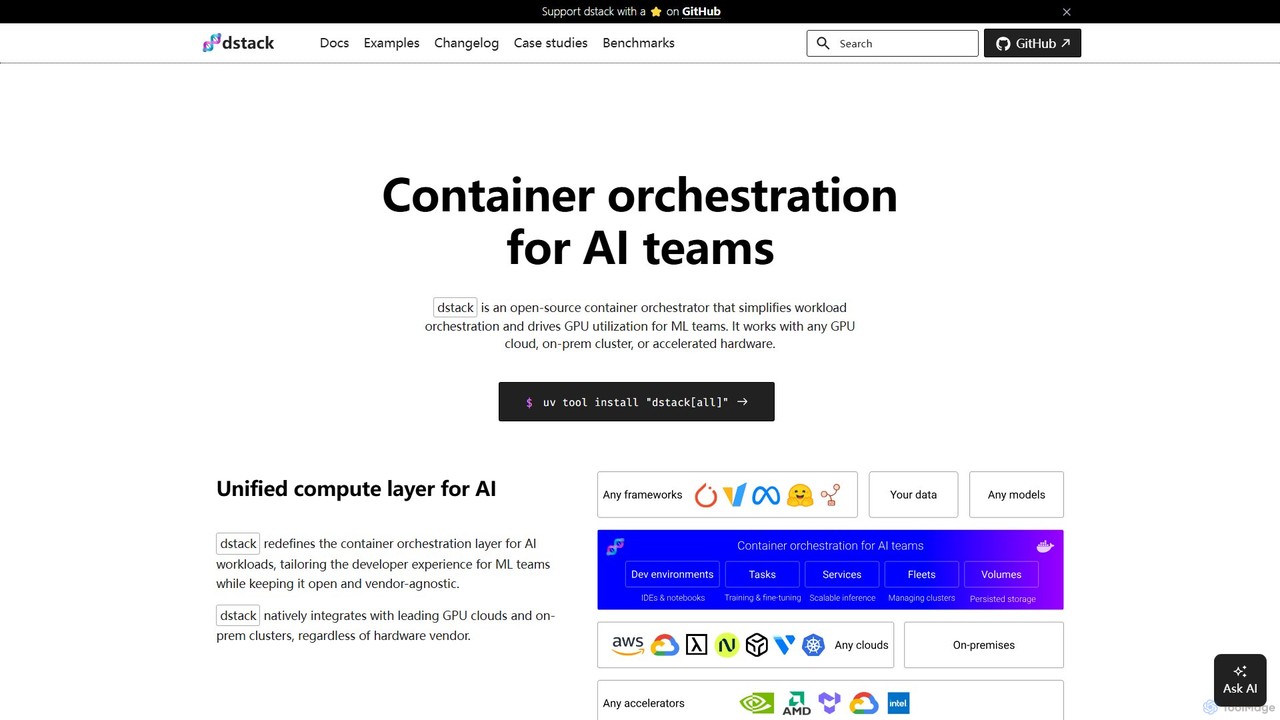
dstack
dstack es un orquestador de contenedores de código abierto diseñado para equipos de IA y ML. Simplifica la orquestación de cargas de trabajo y maximiza la utilización de GPU en cualquier proveedor de nube, clúster local o hardware acelerado. Proporciona una capa de cómputo unificada, agilizando el desarrollo, entrenamiento y despliegue de modelos.
OrquestaciónTensorfuse Categories
Tensorfuse Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Baseten
Baseten es una plataforma de inferencia de grado de producción para desplegar, escalar y gestionar modelos de IA. Ofrece tiempos de ejecución de alto rendimiento, flujos de trabajo de desarrollador fluidos y opciones de despliegue flexibles (nube, autohospedado, híbrido). Ideal para equipos de ingeniería y ML que construyen aplicaciones de IA de misión crítica.
DespliegueRunpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje AutomáticoNebius
Nebius es una plataforma en la nube de alto rendimiento diseñada específicamente para IA y aprendizaje automático. Proporciona acceso a las últimas GPU de NVIDIA, clústeres escalables con redes InfiniBand y servicios totalmente gestionados como Kubernetes y Slurm, permitiendo el entrenamiento, ajuste fino e inferencia de modelos de IA a cualquier escala.
Aprendizaje Automático
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatizacióndstack
dstack es un orquestador de contenedores de código abierto diseñado para equipos de IA y ML. Simplifica la orquestación de cargas de trabajo y maximiza la utilización de GPU en cualquier proveedor de nube, clúster local o hardware acelerado. Proporciona una capa de cómputo unificada, agilizando el desarrollo, entrenamiento y despliegue de modelos.
Orquestación
GPUX
GPUX es una plataforma de nube GPU descentralizada y sin servidor para una inferencia de modelos de IA rápida y asequible. Permite a los desarrolladores ejecutar modelos a través de API y a los propietarios de GPU ganar dinero contribuyendo con su hardware a una red P2P.
Despliegue de Modelo
CircleCI
CircleCI es una plataforma líder de integración continua y entrega continua (CI/CD) que automatiza el proceso de desarrollo de software. Permite a los equipos de ingeniería construir, probar y desplegar código de forma rápida, fiable y a escala, aumentando la productividad y la confianza en cada lanzamiento.
Gestión de Infraestructura
Together AI
Together AI es una plataforma en la nube líder para desarrolladores, que proporciona una infraestructura rápida y rentable para ejecutar, ajustar y entrenar modelos de IA generativa de código abierto. Ofrece una extensa biblioteca de más de 200 modelos, API de inferencia sin servidor, ajuste fino personalizable y clústeres de GPU dedicados, creando una solución integral para construir y escalar aplicaciones de IA.
Infraestructura de GPU
ComfyOnline
Una plataforma basada en la nube para ejecutar flujos de trabajo de ComfyUI en línea sin hardware costoso. Ofrece un entorno sin servidor, implementación de API con un solo clic para aplicaciones de IA y acceso de pago por uso a GPU de alto rendimiento como H100 y A100. Simplifica todo el proceso, desde la creación del flujo de trabajo hasta la implementación escalable.
API e Infraestructura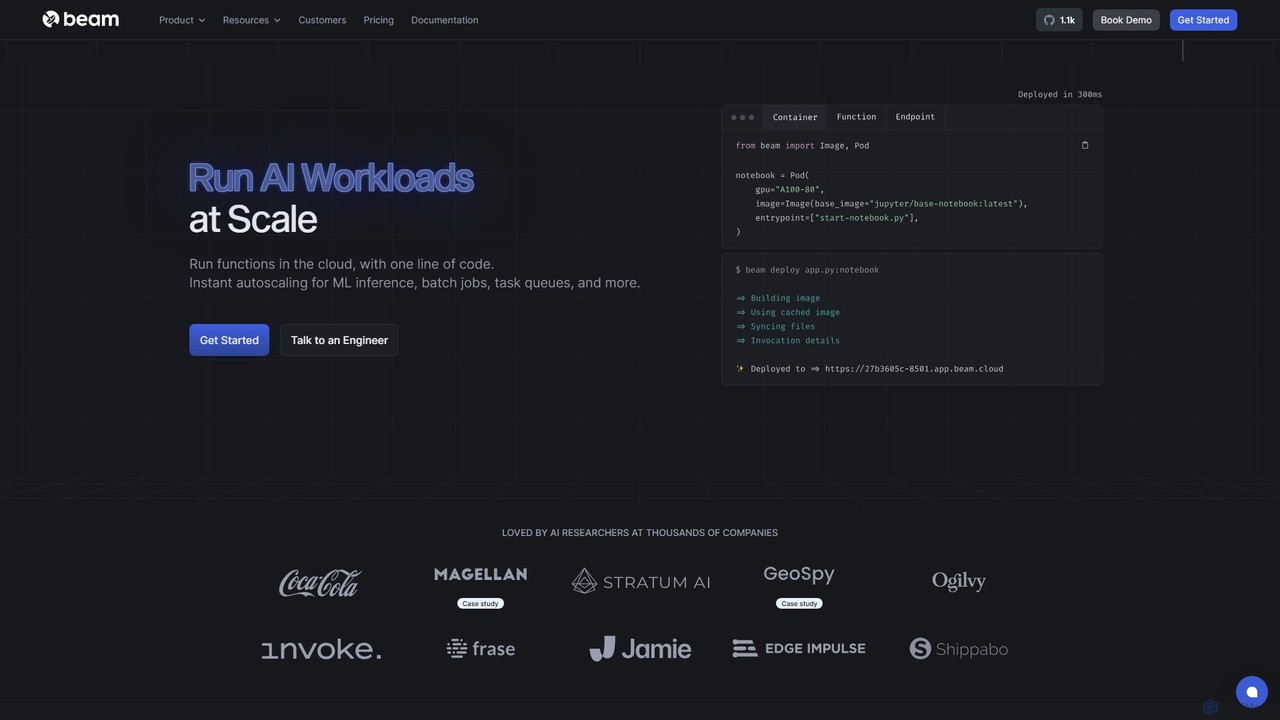
Beam
Beam es una plataforma en la nube sin servidor diseñada para que los desarrolladores ejecuten, escalen e implementen modelos y aplicaciones de IA/ML en GPU con facilidad. Ofrece autoescalado instantáneo, facturación por segundo y un flujo de trabajo optimizado, permitiéndole pasar del código a una API escalable en minutos sin gestionar una infraestructura compleja.
Aprendizaje Automático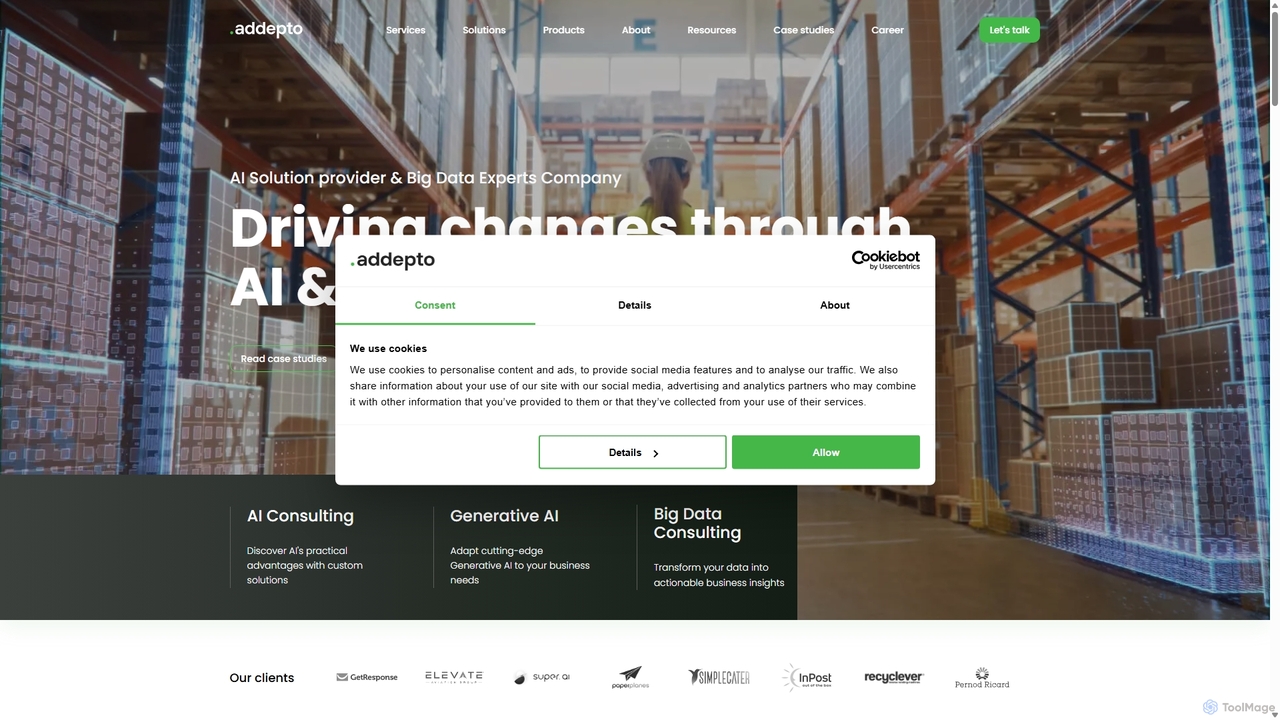
Addepto
Addepto es una empresa líder en desarrollo de IA y consultoría de Big Data que capacita a las empresas con soluciones de IA personalizadas. Se especializan en ciencia de datos, aprendizaje automático, MLOps y estrategia de IA generativa, ayudando a los clientes a transformar datos complejos en conocimientos accionables y una ventaja competitiva. Addepto ofrece servicios de extremo a extremo, desde la consulta inicial y la estrategia hasta el desarrollo, la implementación y el soporte continuo, garantizando soluciones a medida que impulsan resultados comerciales tangibles.
Consultoría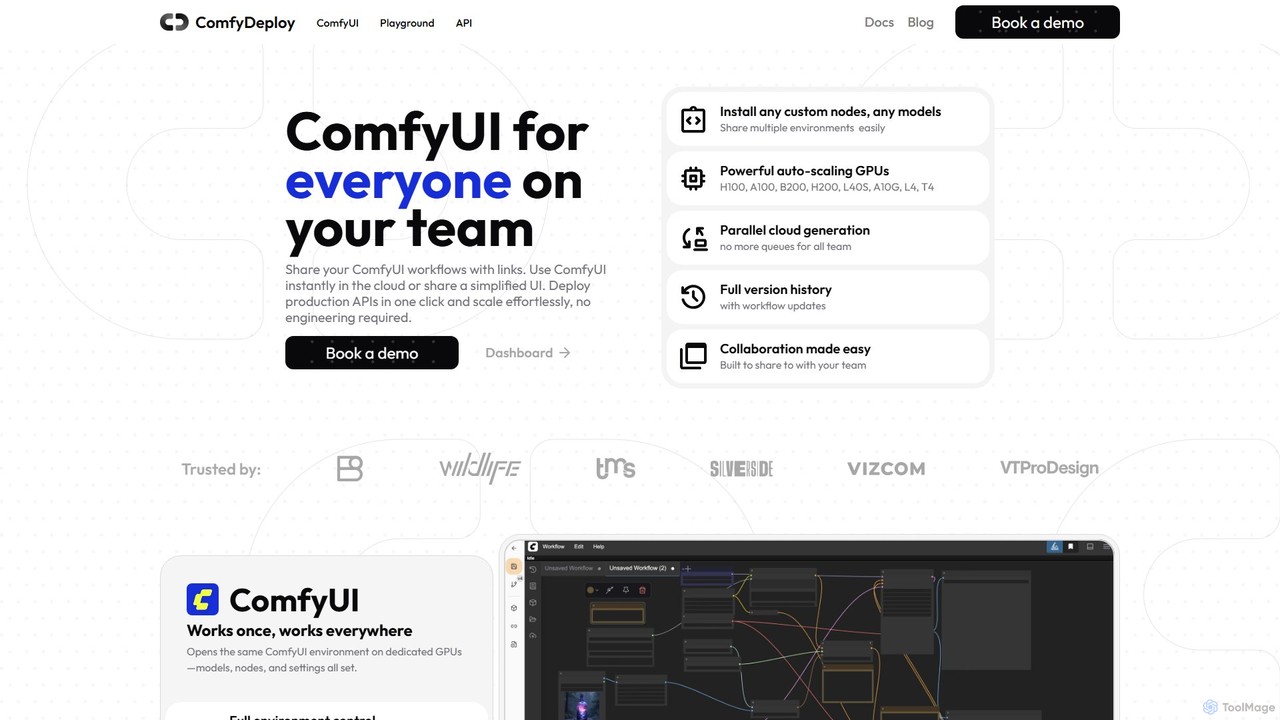
ComfyDeploy
ComfyDeploy es una plataforma en la nube para que los equipos construyan, compartan y escalen flujos de trabajo de ComfyUI. Permite el despliegue con un solo clic de API listas para producción, proporciona infraestructura de GPU con autoescalado y ofrece interfaces simplificadas para usuarios no técnicos. Colabore sin problemas, gestione nodos y modelos personalizados y convierta procesos creativos complejos en aplicaciones escalables sin sobrecarga de ingeniería.
Despliegue de Modelo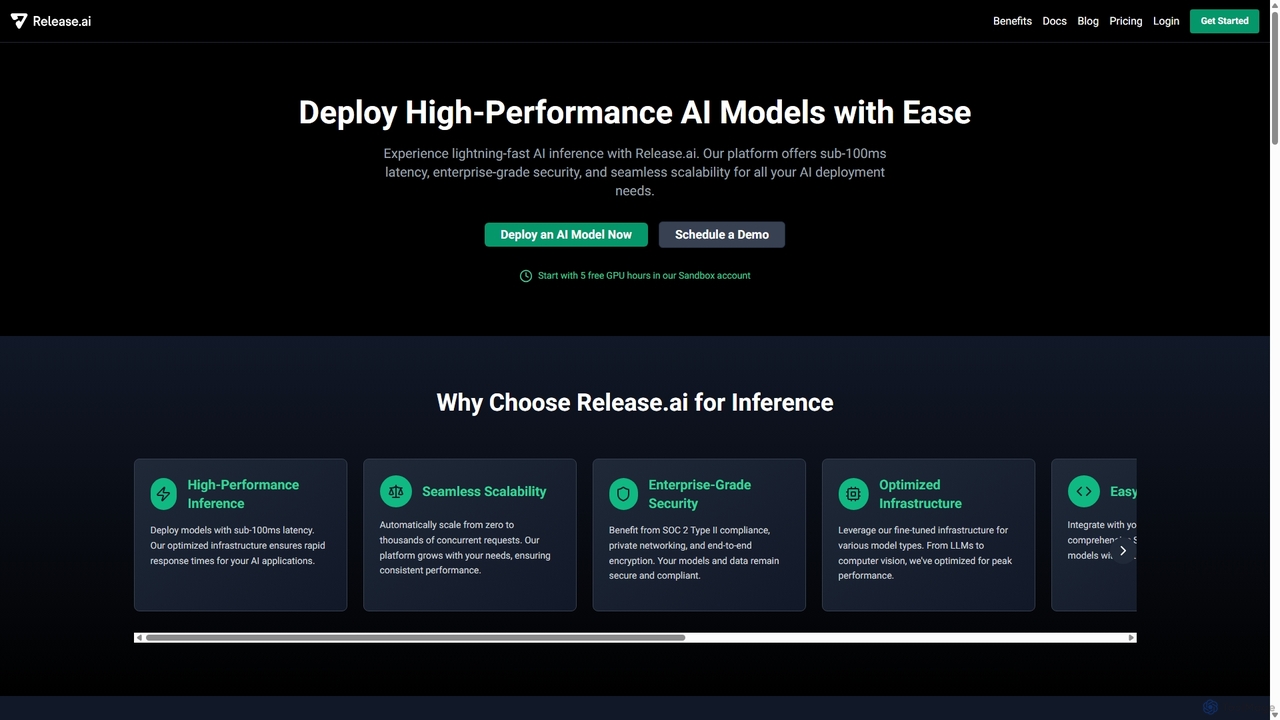
Release.ai
Release.ai es una plataforma de nivel empresarial para que los desarrolladores desplieguen, gestionen y escalen fácilmente modelos de IA de alto rendimiento. Ofrece una latencia de inferencia inferior a 100 ms, autoescalado sin interrupciones, seguridad robusta y una vasta biblioteca de modelos preoptimizados, permitiendo una rápida integración en cualquier flujo de trabajo de desarrollo con solo unas pocas líneas de código.
Plataforma como Servicio (PaaS)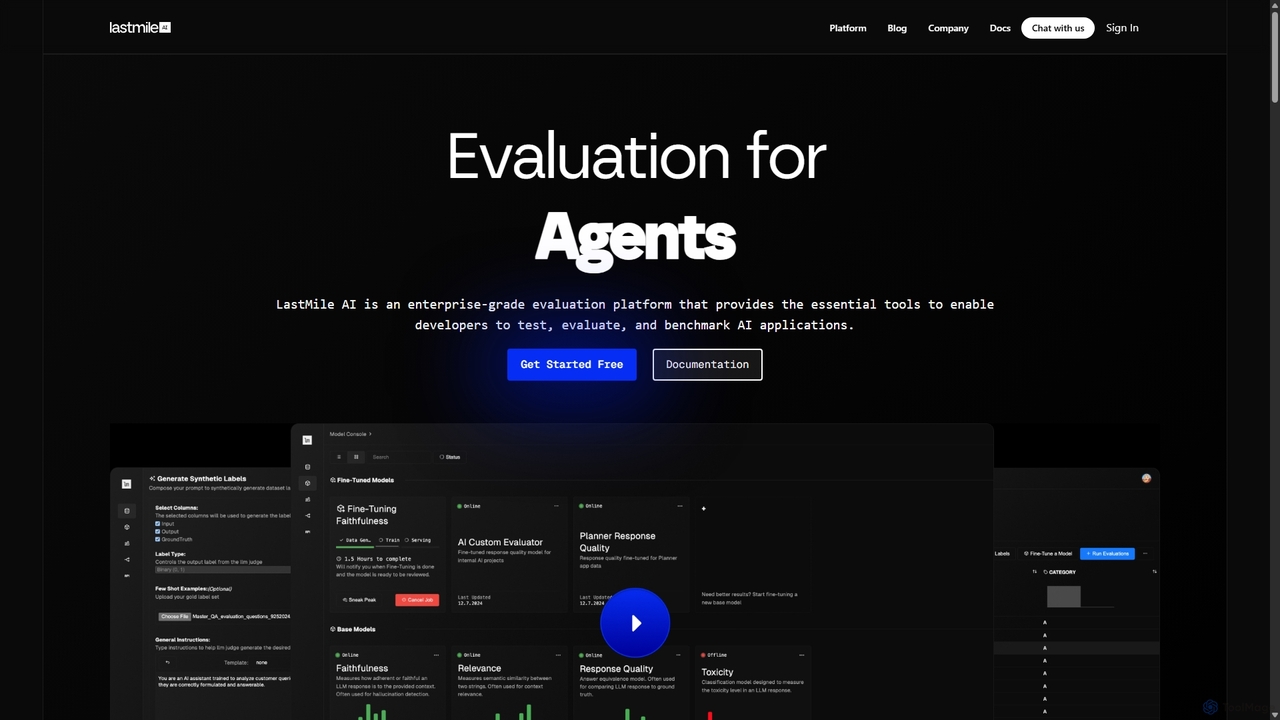
LastMile AI
LastMile AI es una plataforma de desarrollo de nivel empresarial para probar, evaluar y monitorear aplicaciones de IA generativa. Proporciona herramientas como AutoEval para el ajuste fino de evaluadores personalizados, la generación de datos sintéticos y el monitoreo en tiempo real para garantizar que los sistemas de IA sean fiables y estén listos para producción.
Evaluación de Modelos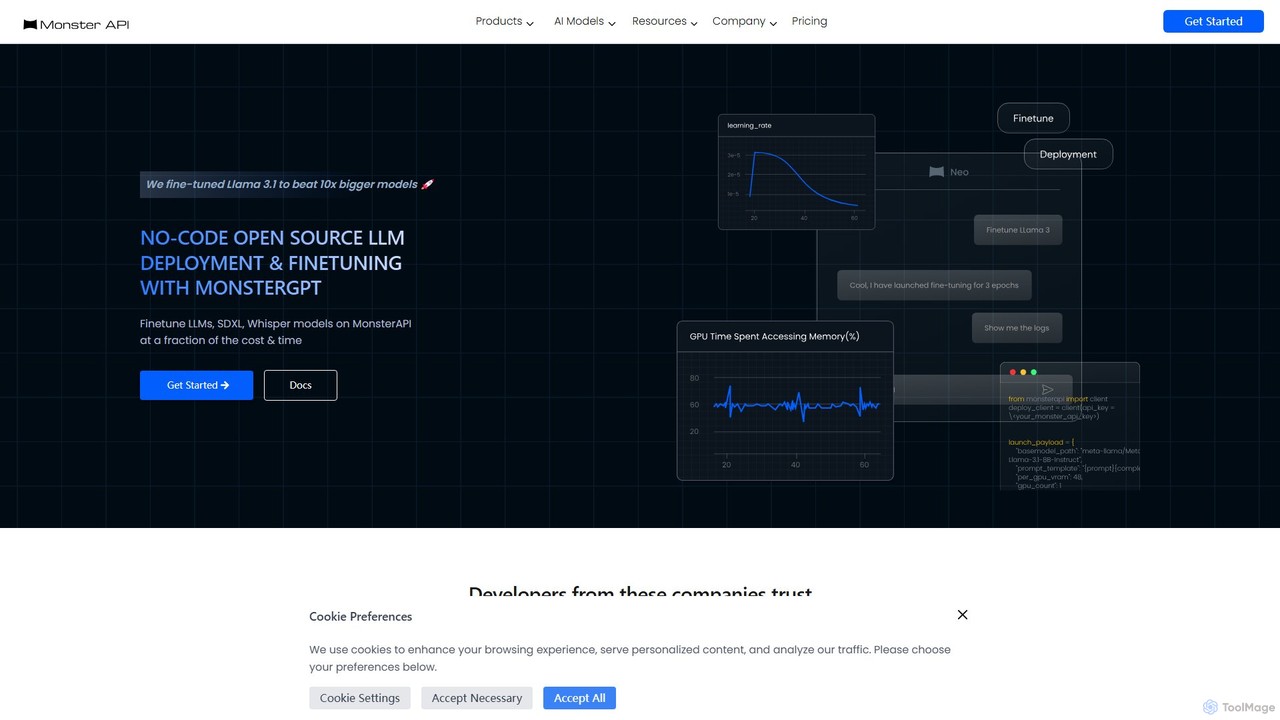
MonsterAPI
MonsterAPI es una plataforma centrada en el desarrollador que simplifica el ajuste fino y el despliegue de modelos de IA generativa de código abierto. Ofrece una interfaz de chat sin código, MonsterGPT, para gestionar tareas complejas, soportando modelos como Llama, SDXL y Whisper. La plataforma proporciona puntos finales de API escalables e infraestructura de GPU de nivel empresarial por una fracción del coste y tiempo habituales, haciendo la IA avanzada accesible para todos los desarrolladores.
Plataforma como Servicio (PaaS)
Tensorfuse Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.