ToolMage
Iniciar sesión

AI TOOL COMPARISON

Skrape vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Skrape Resumen del producto

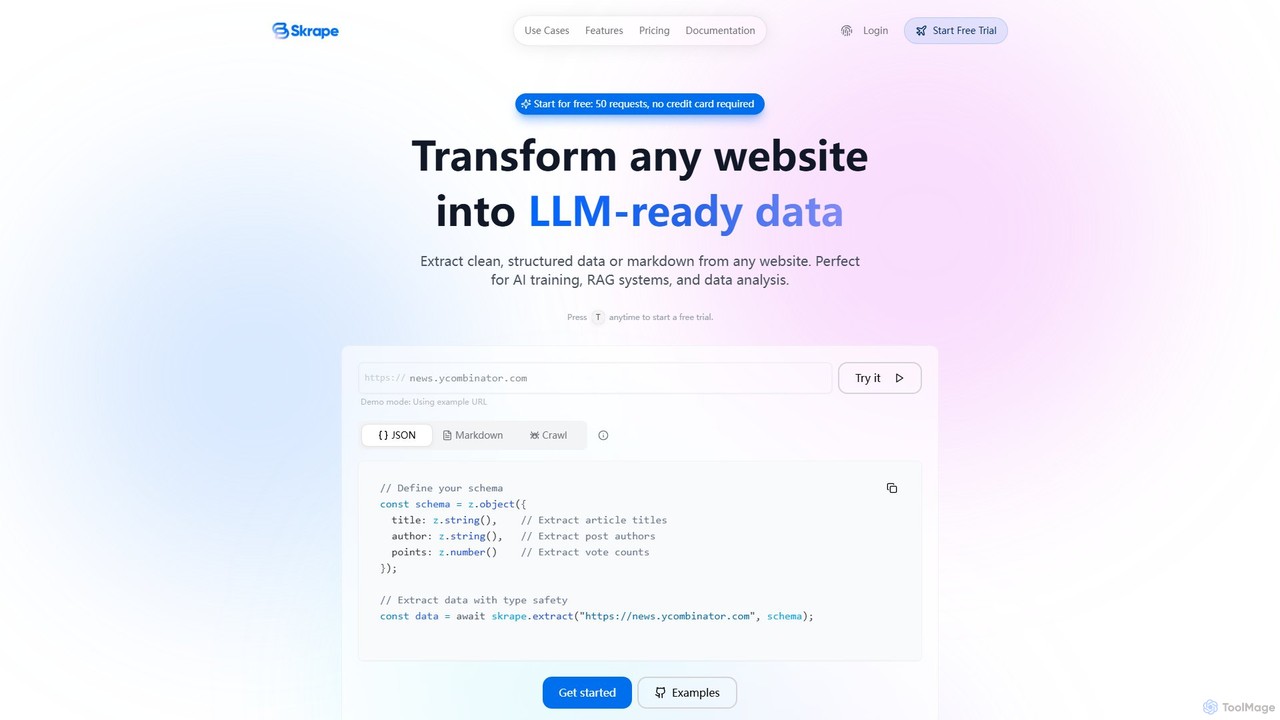
Skrape es una API de web scraping impulsada por LLM, diseñada para transformar cualquier sitio web en datos limpios, estructurados y listos para LLM. Simplifica la extracción de datos convirtiendo páginas web en JSON estructurado o markdown limpio, lo que lo hace ideal para el entrenamiento de IA, sistemas RAG y análisis de datos. Con características como el manejo de contenido dinámico y el rastreo inteligente, Skrape proporciona una solución fiable para que desarrolladores y empresas automaticen sus flujos de recopilación de datos.

Preview

Webcrawlerapi Resumen del producto

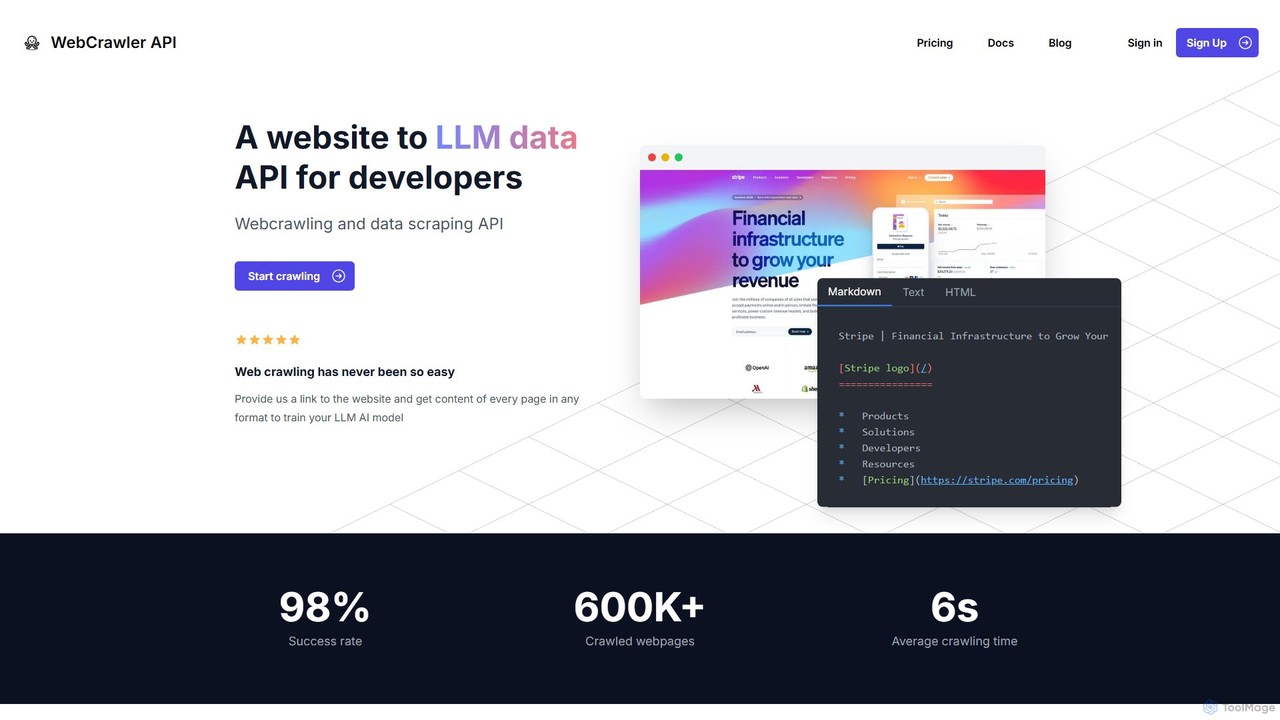
Webcrawlerapi es una potente API para que los desarrolladores rastreen sitios web y extraigan datos limpios sin esfuerzo. Simplifica el web scraping al gestionar el renderizado de JavaScript, las medidas anti-bot y el análisis de datos. Ideal para recopilar contenido estructurado como Markdown o texto para entrenar modelos de IA LLM o para sistemas de Generación Aumentada por Recuperación (RAG), ofrece una alta tasa de éxito y un modelo de precios simple de pago por uso.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Skrape VS Webcrawlerapi — Datos clave
Datos claveSkrapeWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusRaspadoExtracción de Datos
Audiencia y rolesSin verificarSin verificar
CategoríasRaspado · API · AutomatizaciónExtracción de Datos · API · Automatización
Added12 ago 20252 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Skrape

Skrape es una API de web scraping potente y amigable para desarrolladores que aprovecha los Modelos de Lenguaje Grandes (LLM) para extraer datos limpios y estructurados de cualquier sitio web. Está específicamente diseñada para agilizar el proceso de recopilación de datos para aplicaciones de IA modernas, como los sistemas de Generación Aumentada por Recuperación (RAG), el ajuste fino de modelos y el análisis de datos en profundidad. El servicio puede transformar páginas web complejas, incluidas aquellas con contenido dinámico renderizado por JavaScript, en markdown bien formateado o datos JSON estructurados según un esquema definido por el usuario.

La filosofía central de Skrape es simplificar la extracción de datos web. En lugar de lidiar con un análisis complejo de HTML, medidas anti-scraping o la gestión de proxies, los desarrolladores pueden utilizar una simple llamada a la API para obtener los datos que necesitan. La plataforma está construida para ser fiable y escalable, asegurando que los usuarios siempre reciban datos frescos y en tiempo real sin ningún tipo de caché.

Cómo usar Skrape

Usar Skrape es sencillo y está diseñado para una experiencia de desarrollador fluida. Aquí está el flujo de trabajo típico:

  1. Regístrate y obtén la clave de API: Primero, crea una cuenta en el sitio web de Skrape. Puedes comenzar con una prueba gratuita que proporciona 50 créditos sin necesidad de tarjeta de crédito. Al registrarte, recibirás una clave de API en tu panel de control.
  2. Autenticación: Todas las solicitudes de API deben autenticarse usando un Token Bearer. Debes incluir tu clave de API en el encabezado `Authorization` de tus solicitudes (por ejemplo, `Authorization: Bearer YOUR_API_KEY`).
  3. Elige un endpoint: Skrape ofrece varios endpoints de API según tus necesidades:
    • /api/markdown: Convierte una sola página web en markdown limpio.
    • /api/extract: Extrae datos JSON estructurados de una página web basándose en un esquema Zod que proporciones. Esto permite una extracción de datos precisa y con seguridad de tipos.
    • /api/crawl: Rastrea un sitio web completo, siguiendo enlaces para recopilar datos de múltiples páginas de manera eficiente.
  4. Realiza la llamada a la API: Usa tu cliente HTTP preferido o los SDKs oficiales de Skrape (disponibles para Node.js y Python) para realizar solicitudes a la API. Por ejemplo, para extraer datos, definirías la estructura de datos deseada como un esquema y la pasarías junto con la URL de destino al endpoint `/api/extract`.
  5. Procesa los resultados: La API devuelve los datos extraídos en el formato que solicitaste: markdown limpio o JSON estructurado. El servicio también admite el procesamiento de trabajos en segundo plano para tareas de larga duración, y puedes verificar el estado del trabajo a través del endpoint `/api/get-job`.

Características principales de Skrape

  • Extracción Inteligente impulsada por LLM: Define la estructura de datos que deseas usando un esquema, y la IA extraerá y formateará inteligentemente la información en JSON estructurado.
  • Rastreo Inteligente: Rastrea automáticamente sitios web completos, incluso aquellos sin sitemaps, respetando las reglas de `robots.txt` para garantizar un scraping ético.
  • Manejo de Contenido Dinámico: Soporta completamente la renderización de JavaScript, lo que le permite manejar Aplicaciones de Página Única (SPAs) y otro contenido dinámico con el que los scrapers tradicionales tienen dificultades.
  • Conversión a Markdown Limpio: Convierte cualquier página web en un markdown perfectamente formateado y limpio, ideal para sistemas RAG y bases de conocimiento.
  • Acciones de la API: Puede realizar acciones en una página como hacer clic en botones, desplazarse y esperar a que se cargue contenido específico antes de la extracción.
  • Datos en Tiempo Real: Skrape no almacena en caché el contenido, asegurando que siempre obtengas los datos más frescos y actualizados directamente de la fuente.
  • Amigable para Desarrolladores: Ofrece SDKs oficiales para Node.js y Python, documentación completa de la API y un formato consistente para el manejo de errores.

Casos de uso para Skrape

Skrape es versátil y se puede aplicar a una amplia gama de tareas de recopilación de datos:

  • Recopilación de Datos Lista para RAG: Transforma sitios web en conjuntos de datos limpios y estructurados con extracción automática de metadatos, perfectos para alimentar aplicaciones de Generación Aumentada por Recuperación.
  • Flujo de Datos para Entrenamiento de IA: Automatiza la recopilación de conjuntos de datos diversos, de alta calidad y multilingües para el ajuste fino de modelos de lenguaje y otras aplicaciones de IA.
  • Construcción de Bases de Conocimiento: Crea bases de conocimiento completas extrayendo documentación técnica, referencias de API, tutoriales y artículos de investigación de múltiples fuentes.
  • Monitoreo de Contenido de IA: Mantente al día con las últimas tendencias de la industria rastreando y recopilando noticias, investigaciones y blogs técnicos relacionados con la IA.
  • Datos para Evaluación de Modelos: Reúne datos del mundo real de diversos dominios para comparar y evaluar el rendimiento de tus LLMs.

Ventajas de Skrape

Skrape ofrece una ventaja significativa sobre los métodos tradicionales de web scraping. Sus principales ventajas incluyen su simplicidad, potencia y fiabilidad. El enfoque API-first abstrae las complejidades del web scraping, permitiendo a los desarrolladores centrarse en el uso de los datos. El uso de LLMs para la extracción proporciona una precisión y flexibilidad superiores en comparación con los frágiles métodos basados en selectores CSS. Además, su capacidad para manejar contenido dinámico y proporcionar una salida limpia y lista para usar ahorra un tiempo y esfuerzo de desarrollo considerables.

Precios y planes

Skrape ofrece un modelo de precios transparente y basado en créditos, diseñado para escalar con tus necesidades.

  • Prueba Gratuita: Comienza con 50 créditos gratuitos para probar el servicio. No se requiere tarjeta de crédito.
  • Plan Starter: $15/mes por 3,000 créditos. Ideal para proyectos pequeños y desarrolladores individuales.
  • Plan Growth: $50/mes por 10,000 créditos. Adecuado para equipos en crecimiento con mayores necesidades de uso. Incluye soporte prioritario.
  • Plan Pro: $250/mes por 50,000 créditos. Diseñado para empresas y equipos con altos volúmenes de requerimientos. Incluye soporte prioritario y límites de tasa personalizados.

Uso de Créditos:

  • HTML a Markdown: 1 crédito por página
  • Rastreo Web: 1 crédito por página
  • Extracción de Datos por IA: 5 créditos por página

Webcrawlerapi

Webcrawlerapi es una API especializada diseñada para agilizar el proceso de rastreo web y extracción de datos para desarrolladores. En una era en la que los datos son cruciales para entrenar grandes modelos de lenguaje (LLM) y potenciar aplicaciones de IA, el web scraping tradicional presenta desafíos significativos. Estos incluyen manejar contenido dinámico renderizado por JavaScript, eludir sofisticados sistemas anti-bot, gestionar proxies y limpiar HTML desordenado para convertirlo en formatos utilizables. Webcrawlerapi abstrae todas estas complejidades, proporcionando una interfaz simple pero potente para convertir cualquier sitio web en una fuente de datos estructurada.

Con una tasa de éxito reportada del 98% y un tiempo de rastreo promedio de solo 6 segundos, el servicio está diseñado para la eficiencia y la fiabilidad. Permite a los desarrolladores centrarse en la lógica principal de su aplicación en lugar de empantanarse en las complejidades de construir y mantener una infraestructura de rastreo escalable. Al proporcionar un enlace, los desarrolladores pueden recibir contenido limpio y listo para usar en formatos como Markdown, texto o HTML sin procesar, lo que lo hace perfecto para alimentar pipelines de entrenamiento de modelos de IA o bases de conocimiento para sistemas RAG.

Cómo usar Webcrawlerapi

Integrar Webcrawlerapi en tu proyecto está diseñado para ser sencillo. El proceso generalmente implica solo unas pocas líneas de código. Primero, necesitas registrarte en el sitio web de Webcrawlerapi para obtener tu clave de acceso única a la API. Luego, puedes usar una de sus bibliotecas de cliente proporcionadas para lenguajes de programación populares.

Por ejemplo, en un entorno de NodeJS, comenzarías instalando la biblioteca del cliente a través de npm: npm i webcrawlerapi-js. Luego, en tu código, importas la biblioteca, creas una nueva instancia del cliente con tu clave de API y llamas al método `crawl`. Este método toma parámetros como la `url` de destino, el `scrape_type` deseado (por ejemplo, 'markdown') y límites opcionales como `items_limit`. La API luego se encarga de todo el proceso de rastreo en segundo plano y devuelve una respuesta JSON estructurada con los datos extraídos. Patrones de integración simples similares están disponibles para Python, PHP y .NET, lo que lo hace accesible para una amplia gama de desarrolladores.

Características principales de Webcrawlerapi

  • Manejo Automatizado de Enlaces: La API descubre y gestiona de forma inteligente todos los enlaces internos de un sitio web, asegurando un rastreo completo mientras maneja automáticamente los duplicados y limpia las URL.
  • Renderizado Avanzado de JavaScript: Renderiza eficazmente contenido dinámico del lado del cliente utilizando un sistema estable y robusto, superando la inestabilidad y los problemas de memoria a menudo asociados con herramientas como Puppeteer o Playwright.
  • Evasión Robusta de Anti-Bot: Webcrawlerapi viene con mecanismos integrados para lidiar con CAPTCHAs, bloqueos de IP, límites de velocidad y otras defensas anti-bot comunes, asegurando una alta tasa de éxito.
  • Limpieza Automática de Datos: Incluye potentes reglas de análisis para convertir HTML crudo y complejo en formatos limpios y estructurados como Markdown o texto plano, ahorrando a los desarrolladores un tiempo significativo de post-procesamiento.
  • Infraestructura Escalable: El servicio gestiona una infraestructura distribuida de rastreadores y proxies, lo que te permite escalar tus esfuerzos de extracción de datos de unas pocas páginas a millones sin preocuparte por el hardware subyacente o la gestión de la red.
  • API y SDKs Amigables para Desarrolladores: Ofrece una API simple y bibliotecas de cliente oficiales para los principales lenguajes como NodeJS, Python, PHP y .NET, con documentación clara.

Casos de uso para Webcrawlerapi

Webcrawlerapi es versátil y se puede aplicar a una variedad de tareas intensivas en datos. Sus principales casos de uso giran en torno a la IA y el análisis de datos.

  • Recopilación de Datos para Entrenamiento de LLM: Rastrear sistemáticamente sitios web, blogs y foros para recopilar grandes cantidades de datos de texto de alta calidad y específicos de un dominio para entrenar o ajustar modelos de lenguaje grandes personalizados.
  • Generación Aumentada por Recuperación (RAG): Construir y mantener bases de conocimiento actualizadas para sistemas RAG. Rastrear documentación de productos, centros de ayuda o sitios de noticias para proporcionar a los LLM información precisa y en tiempo real para responder a las consultas de los usuarios.
  • Investigación de Mercado y Análisis Competitivo: Extraer automáticamente detalles de productos, información de precios, reseñas de clientes y contenido de marketing de los sitios web de la competencia para obtener información estratégica.
  • Agregación de Contenido: Potenciar agregadores de noticias, bolsas de trabajo o sitios de listados de bienes raíces rastreando regularmente múltiples fuentes y consolidando los datos en una plataforma unificada.

Ventajas de Webcrawlerapi

La principal ventaja de Webcrawlerapi es su simplicidad y eficiencia. Permite a los equipos de desarrollo externalizar toda la infraestructura de rastreo web y la carga de mantenimiento. Esto significa un tiempo de comercialización más rápido para los productos basados en datos. La alta tasa de éxito (98%) y las robustas características anti-bot aseguran que los pipelines de datos sean fiables. Además, su modelo de precios transparente y de pago por uso es altamente rentable, ya que solo pagas por las solicitudes exitosas, eliminando el riesgo y los gastos generales asociados con las suscripciones o la construcción de una solución interna.

Precios y planes

Webcrawlerapi emplea un modelo de precios de 'pago por uso' directo y transparente, evitando por completo las suscripciones y las tarifas ocultas. Los costos se calculan en función del número de páginas que rastreas con éxito cada mes. El servicio incluye trabajos de rastreo ilimitados, una red de proxy ilimitada y gestionada automáticamente, y soporte por correo electrónico en su precio. Para una estimación de costos clara, el sitio web proporciona una calculadora. Como ejemplo, rastrear 10,000 páginas en un mes costaría aproximadamente $20. Este modelo es ideal para proyectos de todos los tamaños, desde experimentos a pequeña escala hasta operaciones de datos a gran escala, ya que los costos escalan directamente con el uso. La plataforma también permite a los usuarios probar el servicio antes de realizar una compra, probablemente a través de una asignación de crédito gratuito para nuevas cuentas.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
APIAutomatización
Solo Skrape
Raspado
Solo Webcrawlerapi
Extracción de Datos

Etiquetas

Compartido
APIautomatizaciónRecopilación de datosExtracción de datosherramienta para desarrolladoresGeneración Aumentada por Recuperación
Solo Skrape
Entrenamiento de IAcontenido dinámicoJSONModelo de Lenguaje de Gran EscalaMarkdownWeb scraping
Solo Webcrawlerapi
Raspado de datosRenderizado JavaScriptEntrenamiento de LLMRastreo web

Audiencia y roles

Compartido
No hay datos verificados
Solo Skrape
No hay datos verificados
Solo Webcrawlerapi
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Skrape

Sin verificar

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
5.4K
Duración media
0:46
Páginas por visita
1.95
Tasa de rebote
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

Palabras clave

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Skrape

Valoración
Sin verificar
Comentarios
0
Favoritos
166
Me gusta
153

Webcrawlerapi

Valoración
Sin verificar
Comentarios
0
Favoritos
182
Me gusta
179

Skrape vs Webcrawlerapi · Preguntas frecuentes

What do Skrape and Webcrawlerapi have in common?
Both tools are listed under API、Automatización. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Skrape and Webcrawlerapi free?
Listed pricing models: Skrape — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Skrape and Webcrawlerapi?
The primary listed category is Raspado for Skrape, and Extracción de Datos for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas