infiniflow Overview
infiniflow proporciona la base de datos Infinity, una base de datos de código abierto y nativa de IA, diseñada desde cero para satisfacer las demandas de las aplicaciones modernas de Modelos de Lenguaje Grandes (LLM). Está diseñada para ofrecer un rendimiento de primer nivel, flexibilidad y facilidad de uso, permitiendo a los desarrolladores construir sistemas de IA sofisticados sin la complejidad de gestionar bases de datos tradicionales. Como base de datos vectorial especializada, su principal fortaleza radica en almacenar, indexar y consultar datos de alta dimensión como los embeddings, que son fundamentales para tareas de IA como la búsqueda semántica y la Generación Aumentada por Recuperación (RAG).
La arquitectura de infiniflow se centra en la simplicidad y la velocidad. Opera como un único binario sin dependencias externas, lo que simplifica drásticamente el proceso de despliegue. Ya sea incrustándolo directamente en una aplicación de Python o ejecutándolo como un servidor independiente a través de Docker, empezar es muy sencillo. Esto lo convierte en una opción ideal tanto para la creación rápida de prototipos como para entornos de producción escalables.
Cómo usar infiniflow
Usar infiniflow implica unos pocos pasos sencillos, principalmente a través de su SDK de Python. Aquí hay un flujo de trabajo general:
- Prerrequisitos: Asegúrese de que su sistema cumple con los requisitos: una CPU x86_64 con soporte AVX2, un SO compatible (Linux, Windows con WSL o macOS) y Python 3.10+.
- Despliegue: Elija su método de despliegue. Puede ejecutar el servidor Infinity usando Docker para una arquitectura cliente-servidor, desplegarlo directamente desde un binario, o incrustarlo en su aplicación de Python usando el `infinity-embedded-sdk` para una experiencia sin servidor. Para Docker, puede obtener la imagen y ejecutarla con un solo comando.
- Instalación: Instale la biblioteca cliente de Python usando pip:
pip install infinity-sdk. - Conectar y Operar:
- Conéctese a su instancia de Infinity usando la API de Python.
- Cree una base de datos y defina una tabla con un esquema específico, incluyendo columnas para tipos de datos estándar (enteros, cadenas) y tipos especializados como vectores (p. ej., `vector, 1024, float`).
- Inserte sus datos, incluyendo los embeddings vectoriales generados a partir de su contenido.
- Realice consultas. Puede ejecutar búsquedas vectoriales densas (`match_dense`), búsquedas de texto completo o potentes búsquedas híbridas que combinan ambas para lograr resultados más relevantes. - Integrar: Utilice los resultados recuperados en su aplicación de LLM, por ejemplo, para proporcionar contexto a un modelo de lenguaje para un pipeline RAG.
Características principales de infiniflow
- Rendimiento Increíblemente Rápido: Alcanza latencias de consulta tan bajas como 0.1 milisegundos en conjuntos de datos vectoriales de escala de millones y soporta hasta 15,000 consultas por segundo (QPS).
- Búsqueda Híbrida Potente: Soporta una combinación de embedding denso, embedding disperso, tensor y búsqueda de texto completo, junto con robustas capacidades de filtrado.
- Reclasificación Avanzada: Incluye soporte integrado para múltiples algoritmos de reclasificación como Reciprocal Rank Fusion (RRF), suma ponderada y ColBERT para mejorar la relevancia de los resultados de búsqueda.
- Soporte de Tipos de Datos Ricos: Maneja nativamente una amplia gama de tipos de datos, incluyendo cadenas, numéricos (entero, flotante) y vectores multidimensionales, proporcionando flexibilidad para modelos de datos complejos.
- Facilidad de Uso: Cuenta con una API de Python intuitiva que simplifica las operaciones de la base de datos y una arquitectura de binario único, sin dependencias, para un despliegue sin complicaciones.
Casos de uso para infiniflow
infiniflow es ideal para una variedad de aplicaciones impulsadas por IA:
- Generación Aumentada por Recuperación (RAG): Servir como la base de conocimientos de alta velocidad para los LLMs, recuperando documentos o fragmentos de datos relevantes para fundamentar las respuestas del modelo en información fáctica y reducir las alucinaciones.
- Motores de Búsqueda Semántica: Construir sistemas de búsqueda que entiendan el significado y el contexto de las consultas de los usuarios, yendo más allá de la simple coincidencia de palabras clave para ofrecer resultados más precisos.
- Sistemas de Preguntas y Respuestas y Chatbots con IA: Potenciar la IA conversacional buscando rápidamente en una vasta base de conocimientos para encontrar la información más relevante para responder a las preguntas de los usuarios.
- Sistemas de Recomendación: Encontrar y recomendar artículos similares (productos, artículos, música) comparando sus embeddings vectoriales en tiempo real.
Ventajas de infiniflow
Las principales ventajas de infiniflow provienen de su diseño especializado:
- Optimizado para el Rendimiento: Construido específicamente para las necesidades de baja latencia y alto rendimiento de las aplicaciones de IA.
- Amigable para el Desarrollador: La API simple y el proceso de despliegue fácil reducen el tiempo de desarrollo y la sobrecarga operativa.
- Flexible y Versátil: La búsqueda híbrida y el soporte de tipos de datos ricos permiten que se utilice para una amplia gama de tareas, no solo para la búsqueda de similitud vectorial.
- Código Abierto: Al ser un proyecto de código abierto, es de uso gratuito, transparente y se beneficia de las contribuciones y el apoyo de la comunidad a través de plataformas como GitHub y Discord.
Precios y planes
infiniflow es un proyecto de código abierto y es completamente gratuito. Puede descargar, desplegar y modificar el software sin ninguna tarifa de licencia. El soporte se proporciona a través de sus canales comunitarios, incluyendo GitHub para el seguimiento de problemas y contribuciones, y un servidor de Discord para discusiones y ayuda.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 6.5K
- 2026-1: 4.9K
- 2026-2: 2.2K
- 2026-3: 3.4K
- 2026-4: 2.5K
- 2026-5: 2.8K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos67.6%
- 🇮🇳India32.4%
Top keywords
| Keyword | Cost per click |
|---|---|
| infiniflow | $0.00 |
| infinisynapse | $0.00 |
| infinite数据库 | $0.00 |
| infinity ai api | $0.00 |
| infinity flow configurations | $0.00 |
infiniflow Alternatives
Weaviate
Weaviate es una base de datos vectorial de código abierto y nativa de IA diseñada para desarrolladores. Permite búsquedas vectoriales, por palabras clave e híbridas, escalables y de baja latencia. Ideal para crear aplicaciones de IA como búsqueda semántica, motores de recomendación y sistemas de Generación Aumentada por Recuperación (RAG), se integra perfectamente con modelos populares de aprendizaje automático para almacenar y consultar datos basados en su significado semántico.
Base de Datos Vectorial
SvectorDB
SvectorDB es una base de datos vectorial sin servidor diseñada para desarrolladores. Simplifica la creación de aplicaciones de IA como motores de recomendación, búsqueda semántica y sistemas RAG con precios de pago por uso, actualizaciones instantáneas y vectorizadores integrados. Pasa del prototipo a la producción con solo unas pocas líneas de código.
Búsqueda Vectorial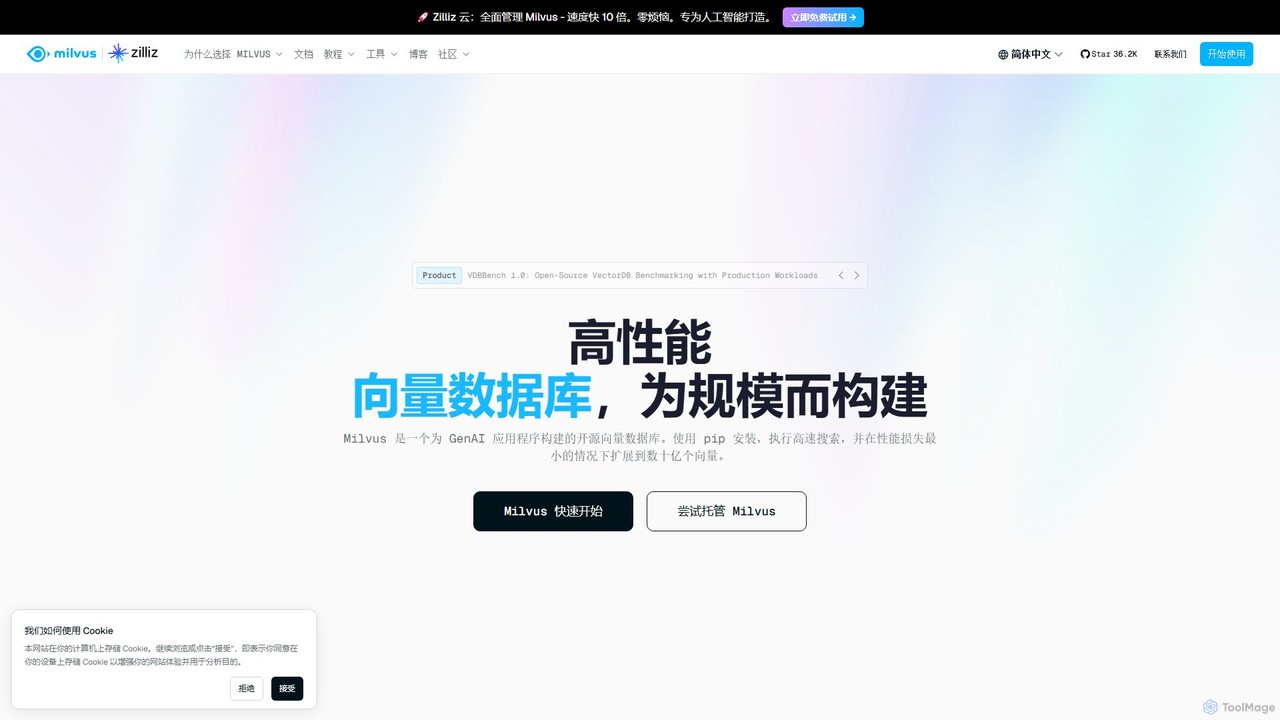
Milvus
Milvus es una base de datos vectorial de código abierto y alto rendimiento creada para aplicaciones de IA. Permite a los desarrolladores gestionar y buscar miles de millones de vectores de alta dimensión con una latencia mínima. Ideal para construir sistemas escalables como la generación aumentada por recuperación (RAG), motores de recomendación y búsqueda semántica, Milvus ofrece opciones de despliegue flexibles, desde prototipos locales hasta clústeres distribuidos a gran escala.
Aprendizaje Automático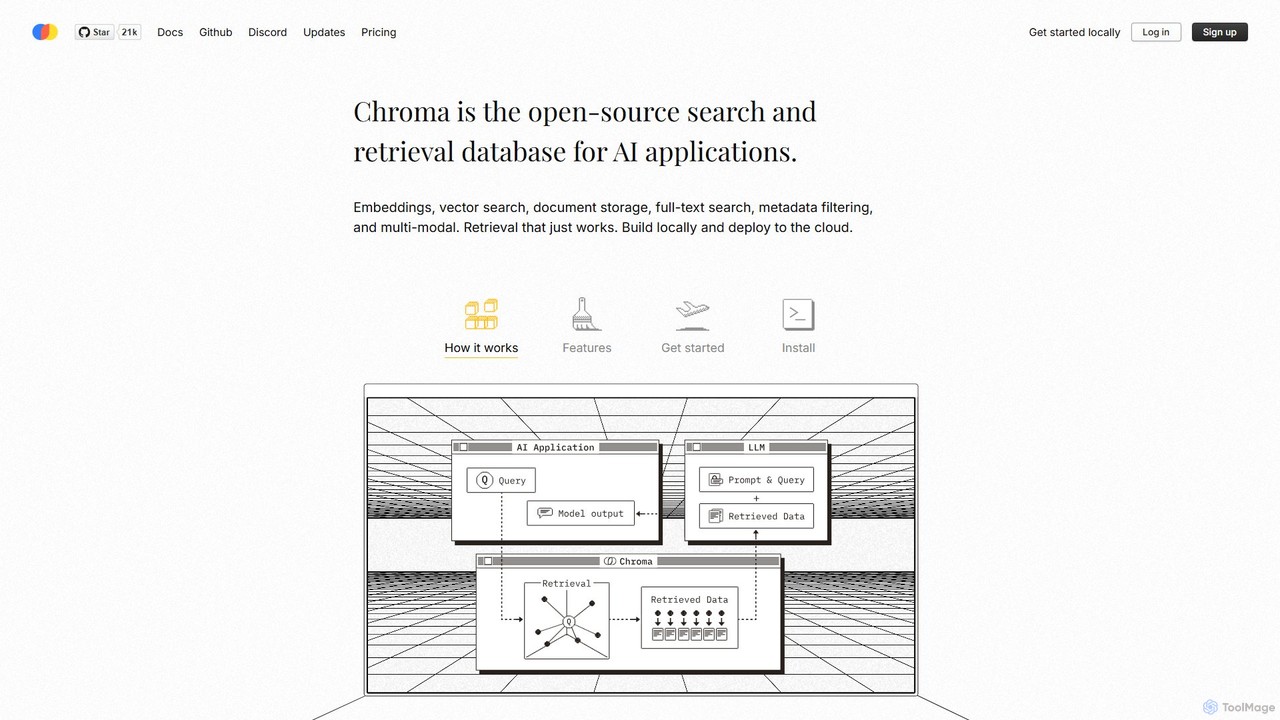
Chroma
Chroma es la base de datos de recuperación de código abierto y nativa de IA, diseñada para construir potentes aplicaciones de IA con Generación Aumentada por Recuperación (RAG). Simplifica el almacenamiento y la búsqueda de embeddings, documentos y metadatos, ofreciendo búsqueda vectorial, búsqueda de texto completo y una plataforma en la nube escalable y sin servidor. Está construida para ser fácil de usar, rentable y potente, desde el desarrollo local hasta la producción a gran escala.
Base de Datos Vectorial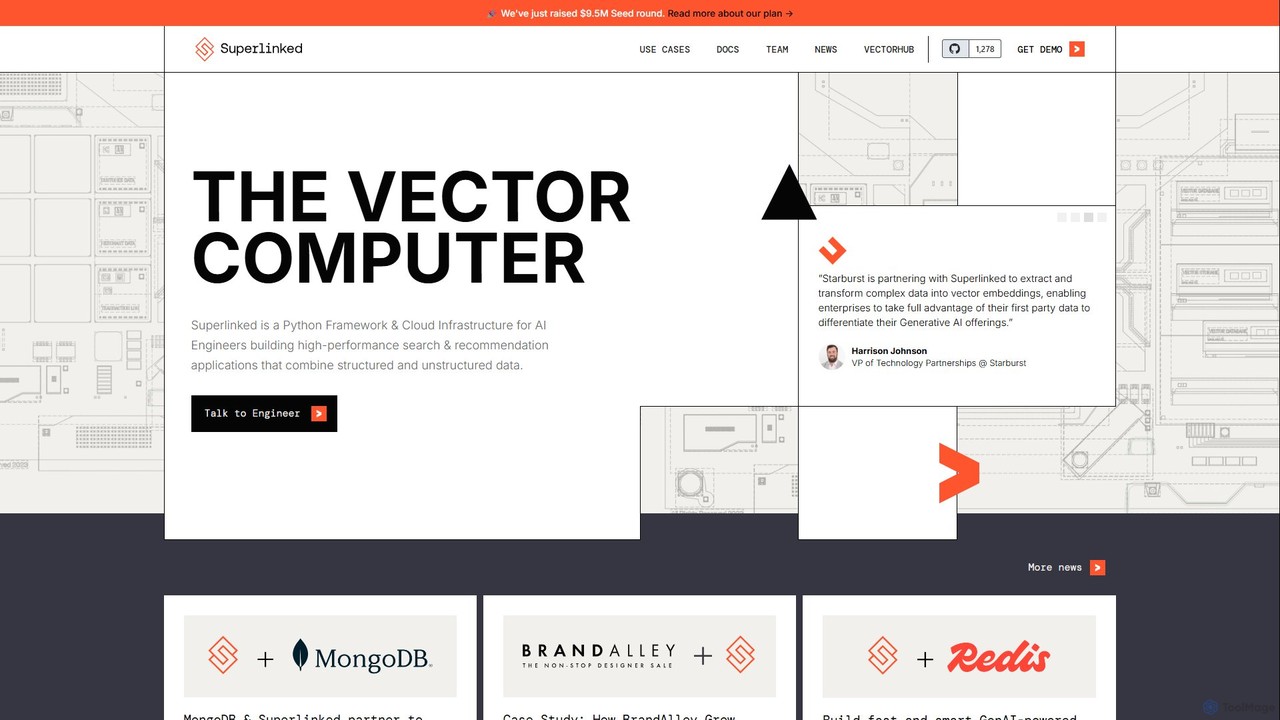
Superlinked
Superlinked es un framework de Python e infraestructura en la nube, conocido como El Computador Vectorial, diseñado para ingenieros de IA. Permite la creación de aplicaciones de búsqueda y recomendación de alto rendimiento combinando eficazmente datos estructurados y no estructurados en embeddings vectoriales multimodales.
Búsqueda Vectorialinfiniflow Categories
infiniflow Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.
Related AI tools
Weaviate
Weaviate es una base de datos vectorial de código abierto y nativa de IA diseñada para desarrolladores. Permite búsquedas vectoriales, por palabras clave e híbridas, escalables y de baja latencia. Ideal para crear aplicaciones de IA como búsqueda semántica, motores de recomendación y sistemas de Generación Aumentada por Recuperación (RAG), se integra perfectamente con modelos populares de aprendizaje automático para almacenar y consultar datos basados en su significado semántico.
Base de Datos VectorialMilvus
Milvus es una base de datos vectorial de código abierto y alto rendimiento creada para aplicaciones de IA. Permite a los desarrolladores gestionar y buscar miles de millones de vectores de alta dimensión con una latencia mínima. Ideal para construir sistemas escalables como la generación aumentada por recuperación (RAG), motores de recomendación y búsqueda semántica, Milvus ofrece opciones de despliegue flexibles, desde prototipos locales hasta clústeres distribuidos a gran escala.
Aprendizaje AutomáticoChroma
Chroma es la base de datos de recuperación de código abierto y nativa de IA, diseñada para construir potentes aplicaciones de IA con Generación Aumentada por Recuperación (RAG). Simplifica el almacenamiento y la búsqueda de embeddings, documentos y metadatos, ofreciendo búsqueda vectorial, búsqueda de texto completo y una plataforma en la nube escalable y sin servidor. Está construida para ser fácil de usar, rentable y potente, desde el desarrollo local hasta la producción a gran escala.
Base de Datos Vectorial
Qdrant
Qdrant es una base de datos vectorial de código abierto y un motor de búsqueda por similitud de alto rendimiento construido en Rust. Está diseñado para potenciar la próxima generación de aplicaciones de IA gestionando y buscando eficientemente miles de millones de vectores de alta dimensión. Con características avanzadas como filtrado enriquecido, almacenamiento de payloads y varios métodos de cuantización, Qdrant permite a los desarrolladores construir soluciones escalables y rentables para la búsqueda semántica, sistemas de recomendación y Generación Aumentada por Recuperación (RAG).
Búsqueda Vectorial
LanceDB
LanceDB es un lakehouse multimodal nativo de IA y de código abierto, diseñado para construir y escalar aplicaciones de IA. Proporciona una plataforma unificada para almacenar, buscar y gestionar datos complejos como texto, imágenes, voz y vectores. Ideal para RAG, búsqueda semántica y entrenamiento de modelos, LanceDB ofrece búsqueda híbrida ultrarrápida, escalabilidad masiva a petabytes y ahorros de costos significativos, convirtiéndolo en una base poderosa para la IA de nivel empresarial.
Base de Datos Vectorial
Vanna.AI
Vanna.AI es un agente SQL de IA personalizado y de código abierto que transforma preguntas en lenguaje natural en consultas SQL precisas. Utiliza un modelo de Generación Aumentada por Recuperación (RAG) entrenado en el esquema de su base de datos específica, documentación y consultas pasadas para lograr una alta precisión en conjuntos de datos complejos. Está diseñado para la seguridad, la flexibilidad y la fácil integración en cualquier aplicación, capacitando a usuarios técnicos y no técnicos para obtener información de sus datos sin esfuerzo.
Inteligencia de Negocio
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
MyScale
MyScale es una base de datos vectorial de alto rendimiento que combina de forma única la búsqueda vectorial con la potencia de SQL. Está diseñada para crear aplicaciones avanzadas de IA como RAG, búsqueda semántica y sistemas de recomendación, simplificando la pila tecnológica al permitir a los desarrolladores ejecutar consultas híbridas sobre vectores y datos estructurados utilizando una única interfaz familiar.
Base de Datos Vectorial
PostgresML
PostgresML es una potente extensión de código abierto que integra el aprendizaje automático y la IA directamente en su base de datos PostgreSQL. Permite la inferencia acelerada por GPU, la búsqueda vectorial y pipelines RAG completos utilizando simples comandos SQL, eliminando el movimiento de datos y simplificando la pila de MLOps para aplicaciones de IA escalables y de alto rendimiento.
MLOps
Meilisearch
Meilisearch es un motor de búsqueda de código abierto, ultrarrápido y potenciado por IA. Está diseñado para que los desarrolladores integren fácilmente capacidades de búsqueda avanzadas, incluyendo búsqueda de texto completo, semántica e híbrida, en cualquier sitio web o aplicación. Ofrece una experiencia de desarrollador excepcional con potentes APIs y SDKs.
Base de datos
phidata
phidata es un framework de Python de código abierto para construir Asistentes de IA autónomos. Simplifica la integración de LLMs con memoria, bases de conocimiento y herramientas externas, permitiendo a los desarrolladores crear potentes aplicaciones de IA con estado fácilmente.
Frameworks
ragie
Ragie es una plataforma de RAG-as-a-Service totalmente gestionada y diseñada para desarrolladores. Simplifica el proceso de construir y desplegar aplicaciones de IA al encargarse de todo el pipeline de Generación Aumentada por Recuperación (Retrieval-Augmented Generation). Conecta tus fuentes de datos y utiliza una API sencilla para potenciar chatbots precisos y contextuales, búsqueda semántica y sistemas de gestión del conocimiento, sin la complejidad de administrar la infraestructura.
Aprendizaje Automático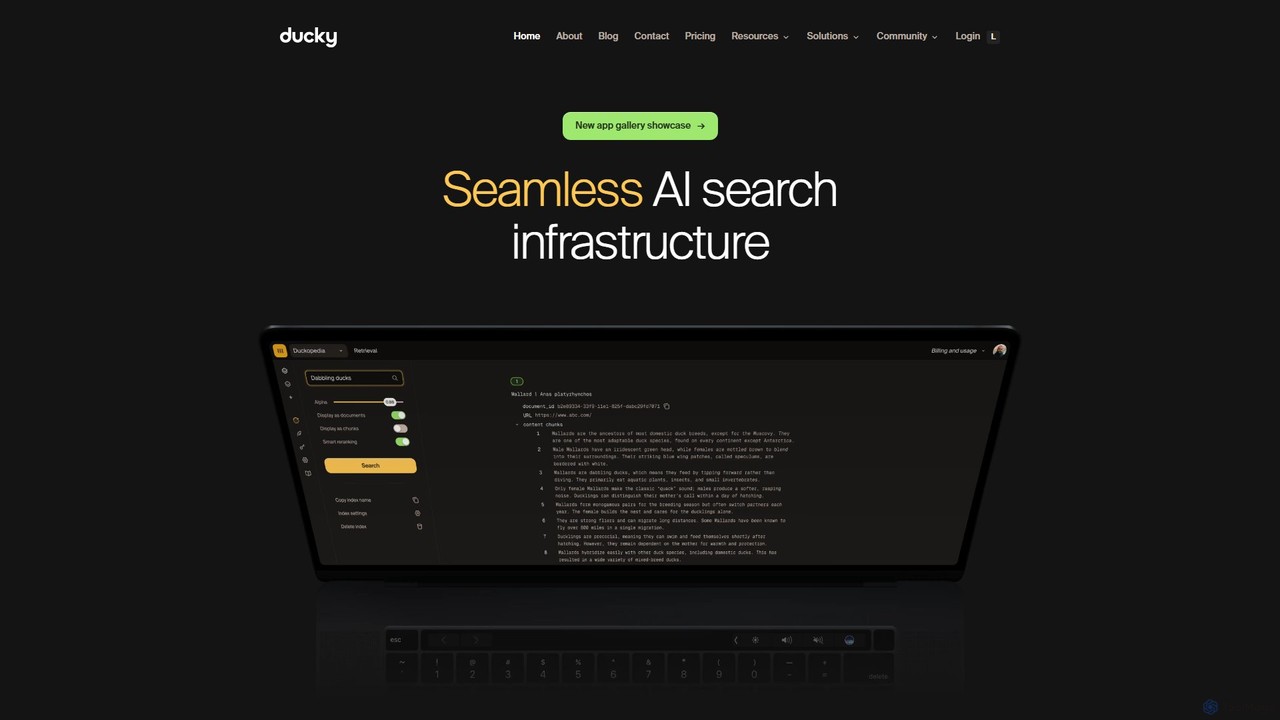
Ducky
Ducky es una infraestructura de búsqueda de IA totalmente gestionada y diseñada para desarrolladores. Simplifica la implementación de la Generación Aumentada por Recuperación (RAG) al encargarse de tareas complejas como la fragmentación de datos, la inserción (embedding) y la reclasificación. Con un sencillo SDK de Python, Ducky permite a los desarrolladores construir rápidamente capacidades de búsqueda semántica rápidas, precisas y escalables en sus aplicaciones, proporcionando respuestas de LLMs conscientes del contexto y sin alucinaciones.
Generación Aumentada por Recuperación
Agents-Flex
Agents-Flex es un framework de Java de código abierto para construir aplicaciones impulsadas por LLM. Como una alternativa ligera y elegante a LangChain, simplifica el desarrollo con una arquitectura altamente extensible. Soporta una amplia gama de LLMs, bases de datos vectoriales y características avanzadas como la llamada a funciones, RAG y orquestación de agentes. Su naturaleza agnóstica al framework y el bajo requisito de JDK (8+) lo convierten en una opción versátil para cualquier desarrollador de Java.
Operaciones de LLM
Unbody
Unbody es un stack de desarrollo nativo de IA, descrito como el "Supabase de la Era de la IA". Proporciona a los desarrolladores un backend modular y de código abierto con agentes integrados, almacenamiento vectorial y una API unificada. Esto permite la creación rápida y rentable de aplicaciones inteligentes y adaptables al transformar cualquier dato en una base de conocimiento consultable, eliminando la necesidad de sistemas fragmentados y complejos pipelines de IA.
Base de Datos Vectorial
infiniflow Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.