
Tensorlake Overview
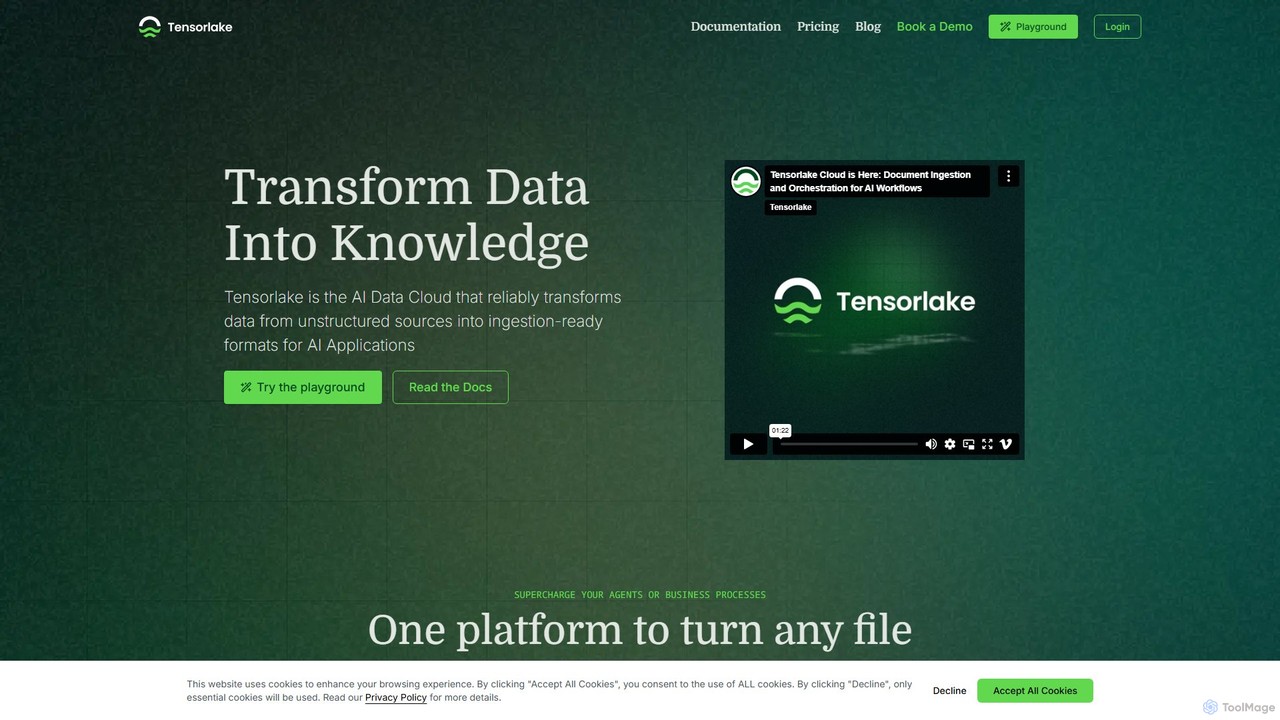
Tensorlake es una Nube de Datos de IA integral diseñada para cerrar la brecha entre los datos brutos no estructurados y las aplicaciones avanzadas de IA. Sirve como una plataforma unificada para que desarrolladores y empresas transformen de manera fiable datos complejos de diversas fuentes —incluyendo PDFs, imágenes, notas manuscritas y hojas de cálculo— en formatos estructurados y listos para la ingesta, como JSON o markdown. Este proceso es crucial para potenciar los Grandes Modelos de Lenguaje (LLM), mejorar los sistemas de Generación Aumentada por Recuperación (RAG) y automatizar flujos de trabajo empresariales críticos.
La plataforma se basa en dos pilares fundamentales: la API de Ingesta de Documentos y los Flujos de Trabajo sin Servidor (Serverless). La API de Ingesta de Documentos ofrece capacidades de análisis similares a las humanas, preservando el diseño original y el orden de lectura de los documentos mientras extrae información con alta precisión. Los Flujos de Trabajo sin Servidor permiten a los usuarios construir y desplegar pipelines de procesamiento de datos de extremo a extremo, totalmente gestionados, utilizando Python. Estos flujos de trabajo son altamente escalables, capaces de procesar millones de documentos, y rentables, ya que se escalan a cero cuando están inactivos.
Cómo usar Tensorlake
Usar Tensorlake implica un flujo de trabajo sencillo y centrado en el desarrollador:
- Subir o Conectar Datos: Comience subiendo archivos directamente a través de la API o conectando sus fuentes de datos existentes. La plataforma admite una amplia gama de tipos de archivo.
- Llamar a la API para el Procesamiento: Utilice la API de Ingesta de Documentos para procesar sus archivos. Puede usar el endpoint 'Parse' para la conversión general de documentos o el endpoint 'Extract' con un esquema Pydantic definido para extraer datos específicos y estructurados en formato JSON.
- Construir Flujos de Trabajo Personalizados (Opcional): Para transformaciones de datos más complejas, utilice los Flujos de Trabajo sin Servidor de Tensorlake. Escriba funciones en Python para definir los pasos de su pipeline de datos, como la limpieza, el enriquecimiento y el enrutamiento de los datos extraídos a sus bases de datos u otros sistemas.
- Recuperar Datos Procesados: Acceda a los datos transformados y estructurados instantáneamente después de que se complete el trabajo o configure un webhook para notificaciones asíncronas. La salida está optimizada para su uso en aplicaciones de IA.
- Integrar con IA/LLMs: Alimente los datos estructurados de alta calidad en sus pipelines RAG, agentes de IA u otros modelos de aprendizaje automático para mejorar su precisión y capacidades.
Características principales de Tensorlake
- API de Ingesta de Documentos: Analiza cualquier tipo de archivo, desde notas manuscritas hasta hojas de cálculo complejas, preservando el diseño y el contexto.
- Extracción de Datos Estructurados: Convierte contenido no estructurado en fragmentos limpios de JSON o markdown utilizando esquemas de Python personalizados para una extracción de alta precisión.
- Flujos de Trabajo sin Servidor: Construya, despliegue y escale pipelines de procesamiento de datos basados en Python sin gestionar ninguna infraestructura. Los flujos de trabajo se escalan automáticamente según la demanda.
- Optimización para RAG: Produce fragmentos de datos estructurados enriquecidos con metadatos, optimizados específicamente para mejorar la precisión y relevancia de los sistemas de Generación Aumentada por Recuperación.
- Escalabilidad Masiva: Diseñado para procesar más de 100,000 documentos por cliente al día y manejar 10,000 eventos por segundo con una latencia extremadamente baja.
- Detección de Firmas: Una función integrada para identificar automáticamente la presencia o ausencia de firmas en los documentos, permitiendo activadores de automatización inteligentes.
- Seguro y Colaborativo: Proporciona Control de Acceso Basado en Roles (RBAC), espacios de nombres para la protección de datos y registros detallados para una visibilidad y cumplimiento completos.
Casos de uso para Tensorlake
Tensorlake es ideal para aplicaciones de alto riesgo donde la precisión de los datos es primordial:
- Sistemas RAG Avanzados: Construya pipelines de recuperación sofisticados para LLMs combinando la búsqueda semántica con filtros estructurados derivados del contenido del documento (p. ej., tablas, figuras, metadatos).
- Automatización de Servicios Financieros: Procese solicitudes de préstamos, documentos de auditoría fiscal y estados financieros para extraer información clave y automatizar la toma de decisiones.
- Gestión de Datos de Salud: Digitalice y estructure expedientes de pacientes, informes de laboratorio y artículos de investigación médica para su análisis y cumplimiento.
- Legal y Cumplimiento: Analice contratos, escrituras de propiedad y documentos legales para extraer cláusulas, identificar riesgos y garantizar el cumplimiento.
- Cadena de Suministro y Logística: Procese documentos de comercio global, facturas y conocimientos de embarque para agilizar las operaciones y mejorar la visibilidad.
Ventajas de Tensorlake
Tensorlake ofrece una ventaja competitiva significativa:
- Precisión Inigualable: Sus capacidades de análisis y extracción estructurada similares a las humanas entregan datos de alta calidad, minimizando errores en los modelos de IA.
- Desarrollo Simplificado: El enfoque de código primero y orientado a la API simplifica la creación de pipelines de datos complejos, permitiendo a los equipos construir más rápido.
- Escalabilidad Rentable: La arquitectura sin servidor y los precios transparentes de pago por uso aseguran que solo pague por lo que usa, lo que hace que la escalabilidad sea económica.
- Plataforma de Extremo a Extremo: Proporciona una solución única y unificada para la ingesta, estructuración y orquestación, eliminando la necesidad de pipelines frágiles y con múltiples herramientas.
- Flexibilidad: Se integra sin problemas con herramientas populares como LangChain y Qdrant para mejorar las pilas de IA existentes.
Precios y planes
Tensorlake ofrece un modelo de precios transparente y basado en el uso, sin tarifas ocultas por almacenamiento o ancho de banda.
- Ingesta de Documentos: Una tarifa simple y bajo demanda de $0.01 por página.
- Flujos de Trabajo sin Servidor: Facturado por segundo según los recursos de cómputo consumidos:
- Nvidia H100: $0.0009/s
- Nvidia A100: $0.0005/s
- CPU (1 vCPU): $0.00004/s
- Memoria (DDR4): $0.00009/GB/s
- On-Premise: Planes empresariales personalizados disponibles para su despliegue en su propia red. Contacte a ventas para más detalles.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 6.9K
- 2026-1: 50.0K
- 2026-2: 61.4K
- 2026-3: 46.7K
- 2026-4: 46.4K
- 2026-5: 31.5K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos55.2%
- 🇳🇬Nigeria15.5%
- 🇻🇳Vietnam11.4%
- 🇮🇩Indonesia9.3%
- 🇮🇳India8.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.3% |
Referral | 8.3% |
Email | 6.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| opencode omo claude ekvivalent | $0.00 |
| opencode with everything claude code, direct use | $0.00 |
| tensorlaek | $0.00 |
| tensorlake | $6.31 |
| tensorlake documentation | $0.00 |
Tensorlake Alternatives
ScrapeGraphAI
ScrapeGraphAI es una API de web scraping impulsada por IA que transforma sitios web no estructurados en datos JSON limpios y estructurados utilizando simples indicaciones en lenguaje natural. Diseñado para desarrolladores, agentes de IA y flujos de trabajo automatizados, simplifica la extracción de datos sin código complejo.
Análisis
boundaryml
boundaryml (BAML) es un lenguaje de programación y un conjunto de herramientas especializado para que los desarrolladores extraigan datos estructurados de Modelos de Lenguaje Grandes (LLMs) de forma fiable. Transforma la compleja ingeniería de prompts en un proceso simplificado, similar al código, garantizando salidas con seguridad de tipos y corrección de errores en diversos LLMs y lenguajes de programación como Python y TypeScript. Está diseñado para mejorar la fiabilidad, reducir costes y acelerar los ciclos de desarrollo de aplicaciones de IA.
API
Eventual
Eventual está construyendo el futuro de la infraestructura de datos con Daft, un motor de consulta de código abierto y alto rendimiento para datos multimodales. Permite a los ingenieros procesar imágenes, vídeo, audio y texto a escala de petabytes con la simplicidad de SQL, acelerando drásticamente los flujos de trabajo de IA y ML sin necesidad de profundos conocimientos en sistemas distribuidos.
Aprendizaje Automático
Apify
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.
Recopilación de Datos
Firecrawl
Firecrawl es una API de código abierto, orientada a desarrolladores, que convierte cualquier sitio web en datos limpios y listos para LLM. Gestiona todas las complejidades del web scraping, incluyendo la renderización de JavaScript, la rotación de proxies y los límites de tasa, permitiéndole potenciar aplicaciones de IA, agentes y sistemas RAG con contenido web fiable. Ofrece funcionalidades de scraping, crawling y búsqueda a través de una API sencilla.
Recopilación de DatosTensorlake Categories
Tensorlake Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
ScrapeGraphAI
ScrapeGraphAI es una API de web scraping impulsada por IA que transforma sitios web no estructurados en datos JSON limpios y estructurados utilizando simples indicaciones en lenguaje natural. Diseñado para desarrolladores, agentes de IA y flujos de trabajo automatizados, simplifica la extracción de datos sin código complejo.
Análisisboundaryml
boundaryml (BAML) es un lenguaje de programación y un conjunto de herramientas especializado para que los desarrolladores extraigan datos estructurados de Modelos de Lenguaje Grandes (LLMs) de forma fiable. Transforma la compleja ingeniería de prompts en un proceso simplificado, similar al código, garantizando salidas con seguridad de tipos y corrección de errores en diversos LLMs y lenguajes de programación como Python y TypeScript. Está diseñado para mejorar la fiabilidad, reducir costes y acelerar los ciclos de desarrollo de aplicaciones de IA.
APIApify
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.
Recopilación de DatosFirecrawl
Firecrawl es una API de código abierto, orientada a desarrolladores, que convierte cualquier sitio web en datos limpios y listos para LLM. Gestiona todas las complejidades del web scraping, incluyendo la renderización de JavaScript, la rotación de proxies y los límites de tasa, permitiéndole potenciar aplicaciones de IA, agentes y sistemas RAG con contenido web fiable. Ofrece funcionalidades de scraping, crawling y búsqueda a través de una API sencilla.
Recopilación de Datos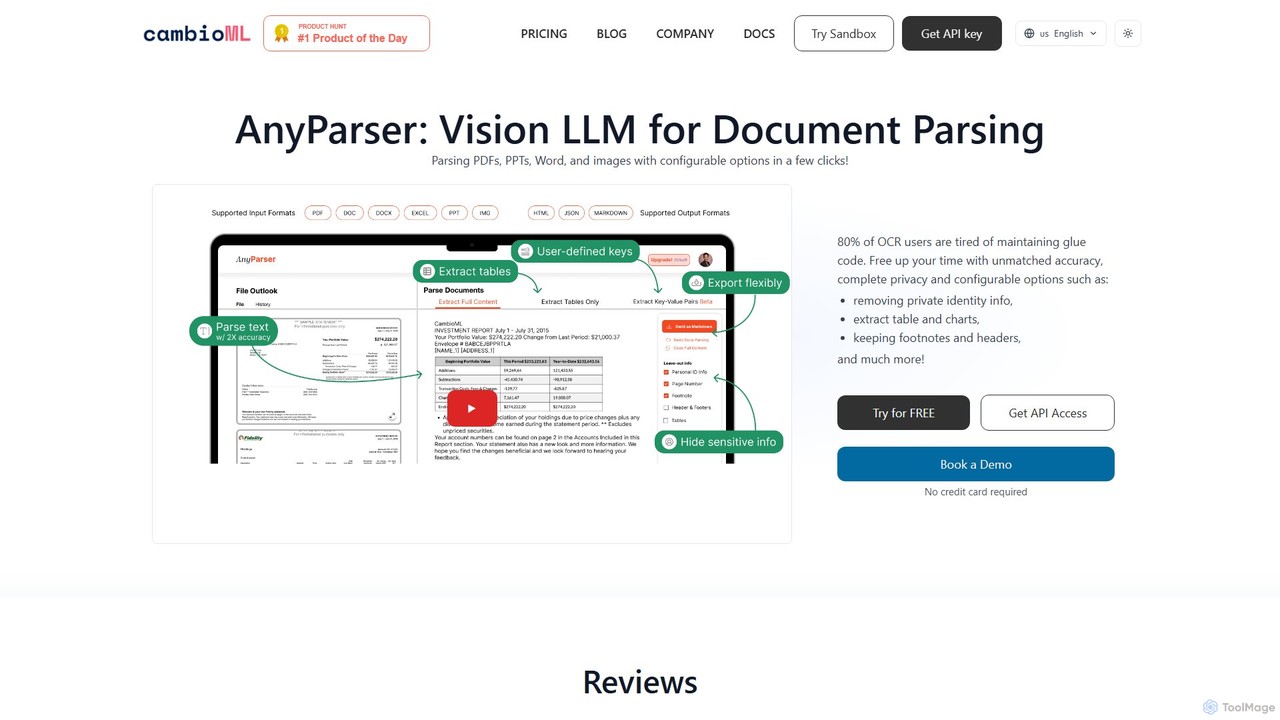
CambioML
CambioML ofrece la API AnyParser, un potente LLM de Visión diseñado para el análisis de documentos de alta precisión. Extrae texto, tablas, gráficos y pares clave-valor de PDF, imágenes y documentos de Office. Con funciones como la redacción de PII, salidas configurables y procesamiento en tiempo real, es ideal para desarrolladores y empresas de finanzas, investigación y análisis de datos para automatizar los flujos de trabajo de extracción de datos garantizando la privacidad y la eficiencia.
Extracción de Datos
Ducky
Ducky es una infraestructura de búsqueda de IA totalmente gestionada y diseñada para desarrolladores. Simplifica la implementación de la Generación Aumentada por Recuperación (RAG) al encargarse de tareas complejas como la fragmentación de datos, la inserción (embedding) y la reclasificación. Con un sencillo SDK de Python, Ducky permite a los desarrolladores construir rápidamente capacidades de búsqueda semántica rápidas, precisas y escalables en sus aplicaciones, proporcionando respuestas de LLMs conscientes del contexto y sin alucinaciones.
Generación Aumentada por Recuperación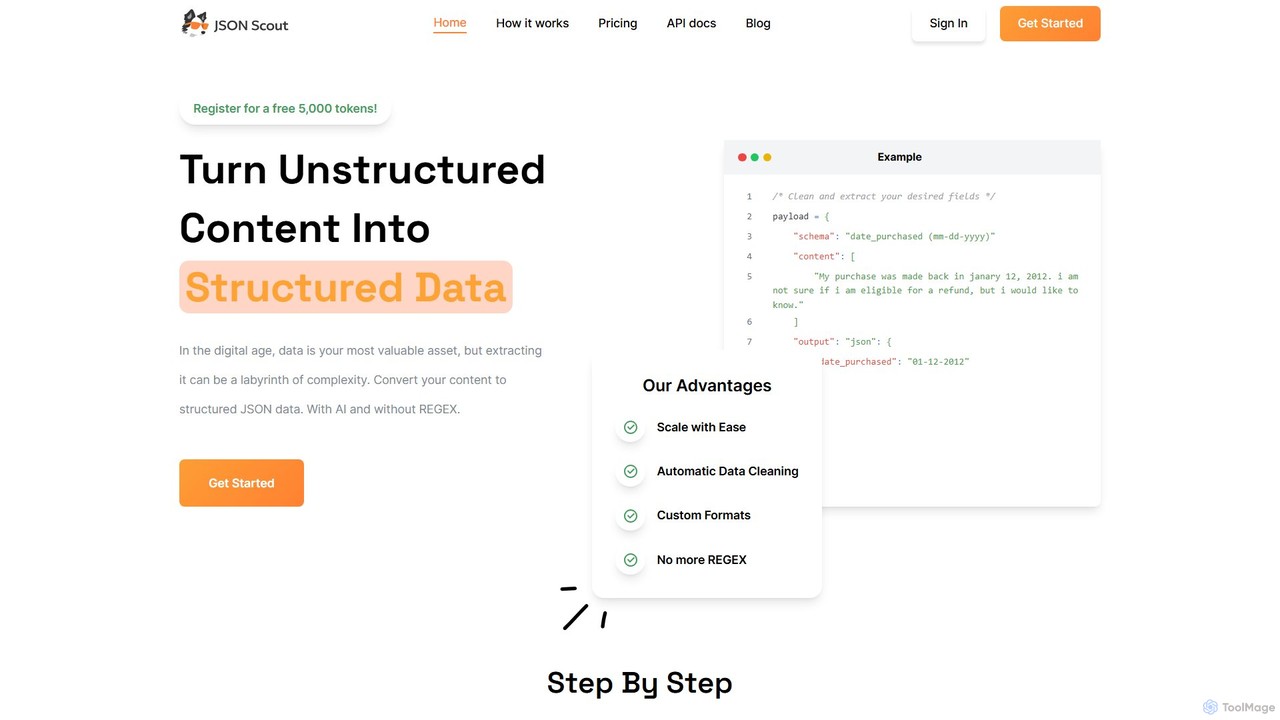
JSON Scout
JSON Scout es una API para desarrolladores impulsada por IA que transforma contenido de texto y audio no estructurado en datos JSON estructurados. Aprovecha los Grandes Modelos de Lenguaje (LLM) como GPT-4o para eliminar la necesidad de expresiones regulares (REGEX) complejas, ahorrando tiempo de desarrollo y mejorando la precisión en la extracción de datos.
Procesamiento de Datos
vocode
Vocode es una plataforma de código abierto para construir, desplegar y escalar agentes de IA de voz hiperrealistas. Proporciona a los desarrolladores un marco central y una API de nivel empresarial para crear sofisticadas aplicaciones de LLM basadas en voz para tareas como servicio al cliente automatizado, llamadas de ventas y sistemas de respuesta de voz interactiva (IVR).
Bot de voz
Modal
Modal es una plataforma de infraestructura sin servidor de alto rendimiento para desarrolladores de IA y ML. Permite ejecutar funciones de Python en la nube con una sola línea de código, proporcionando acceso instantáneo a GPUs, escalado automático de cero a miles de contenedores y precios por segundo. Elimine la sobrecarga de la infraestructura y céntrese en construir y desplegar aplicaciones de computación intensiva como la IA generativa, el procesamiento por lotes y el análisis de datos.
Despliegue de Modelo
Exa
Exa es un motor de búsqueda y API nativo de IA diseñado para LLMs. Proporciona datos web de alta calidad y en tiempo real a través de búsqueda semántica, rastreo de contenido y capacidades de investigación agéntica para potenciar aplicaciones de IA, reducir alucinaciones y descubrir conocimientos que los motores de búsqueda tradicionales no pueden.
Motor de Búsqueda
Jina AI
Jina AI proporciona una plataforma de Fundación de Búsqueda de vanguardia, ofreciendo un conjunto de potentes APIs para embeddings multimodales, reclasificación y extracción de datos. Está diseñada para que desarrolladores y empresas construyan IA generativa de alta calidad, RAG (Generación Aumentada por Recuperación) y aplicaciones de búsqueda avanzada con capacidades multilingües y multimodales.
Modelo de Lenguaje
Langflow
Langflow es una interfaz de usuario (UI) visual de código abierto para construir y desplegar aplicaciones de IA. Cuenta con una interfaz de arrastrar y soltar para encadenar LLMs, agentes y herramientas, permitiendo la creación rápida de prototipos y el despliegue de flujos de trabajo complejos como RAG y sistemas multiagente. Admite amplias integraciones y ofrece opciones tanto autoalojadas como en la nube.
Low-code No-code
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
supermemory
supermemory es una API de memoria e infraestructura para la era de la IA, diseñada para que los desarrolladores construyan LLMs con memoria persistente y a largo plazo. Supera la limitación de la ventana de contexto finita, permitiendo la creación de agentes de IA inteligentes y conscientes del contexto, chatbots y aplicaciones que recuerdan interacciones pasadas e información a través de diversas plataformas.
LLM
phidata
phidata es un framework de Python de código abierto para construir Asistentes de IA autónomos. Simplifica la integración de LLMs con memoria, bases de conocimiento y herramientas externas, permitiendo a los desarrolladores crear potentes aplicaciones de IA con estado fácilmente.
Frameworks
Tensorlake Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.