
Unsloth Overview
Unsloth es una revolucionaria biblioteca de IA de código abierto diseñada para resolver dos de los mayores desafíos en la personalización de Modelos de Lenguaje Grandes (LLMs): la velocidad de entrenamiento y el consumo de memoria. Desarrollada por un equipo dedicado, Unsloth redefine la eficiencia del ajuste fino empleando optimizaciones matemáticas derivadas manualmente y kernels de GPU escritos a mano. Este enfoque innovador permite a desarrolladores, investigadores y empresas entrenar modelos como Llama, Mistral y Gemma hasta 30 veces más rápido que con métodos estándar como Flash Attention 2, y con una asombrosa reducción del 90% en el uso de memoria. Esto significa que tareas que antes llevaban un mes ahora pueden completarse en solo 24 horas, y se pueden ajustar modelos potentes en una sola GPU de consumo.
La magia central de Unsloth reside en su profunda optimización a nivel de hardware. En lugar de depender de bibliotecas genéricas de alto nivel, los creadores de Unsloth han vuelto a los principios fundamentales, reescribiendo los pasos de mayor carga computacional del proceso de entrenamiento para maximizar la eficiencia de la GPU. Esto no solo resulta en un entrenamiento más rápido, sino también en velocidades de inferencia significativamente más rápidas (hasta 2x), lo que permite un despliegue más rápido de los modelos ajustados. Unsloth está diseñado para la escalabilidad, funcionando excepcionalmente en GPUs individuales, sistemas multi-GPU e incluso clústeres multi-nodo para tareas a nivel empresarial.
Cómo usar Unsloth
Usar Unsloth está diseñado para ser sencillo para cualquiera familiarizado con el ecosistema de Python y Hugging Face. El proceso típicamente incluye estos pasos:
- Instalación: Instala la biblioteca Unsloth en tu entorno de Python, generalmente con un simple comando pip. La biblioteca está disponible como freeware de código abierto.
- Importación y Carga del Modelo: En tu script de entrenamiento, importa `FastLanguageModel` de Unsloth. En lugar de cargar un modelo directamente desde `transformers` de Hugging Face, usas la función de Unsloth para cargar el modelo base. Esta función aplica automáticamente todos los parches de rendimiento y optimizaciones necesarios. Puedes especificar el nombre del modelo (p. ej., 'unsloth/llama-3-8b-Instruct-bnb-4bit') y el tipo de datos (p. ej., cuantización de 4 bits) durante este paso.
- Añadir Adaptadores LoRA: Unsloth simplifica el proceso de añadir adaptadores de Adaptación de Rango Bajo (LoRA) al modelo. Puedes configurar los parámetros de LoRA (como `r`, `lora_alpha`, `target_modules`) y aplicarlos al modelo con una sola línea de código.
- Preparación de Datos: Prepara tu conjunto de datos de entrenamiento como lo harías normalmente para una tarea de ajuste fino de Hugging Face.
- Entrenamiento: Usa el `SFTTrainer` de Hugging Face o una clase de entrenamiento similar, pasándole tu modelo optimizado con Unsloth, el conjunto de datos y los argumentos de entrenamiento. Unsloth se integra perfectamente con este flujo de trabajo, acelerando automáticamente los pasos de retropropagación y optimización.
- Inferencia: Una vez completado el entrenamiento, puedes usar el modelo ajustado para la inferencia, que también se beneficia de las mejoras de velocidad de Unsloth.
Características principales de Unsloth
- Aumento Extremo de Velocidad: Entrenamiento y ajuste fino hasta 30 veces más rápidos en comparación con implementaciones estándar como Flash Attention 2.
- Reducción Masiva de Memoria: Reduce el uso de VRAM hasta en un 90%, permitiendo el ajuste fino de grandes modelos en GPUs de consumo (como Tesla T4 o incluso la serie GeForce RTX).
- Kernels de GPU Escritos a Mano: Las operaciones matemáticas centrales están optimizadas manualmente para el máximo rendimiento del hardware, superando las capacidades de las bibliotecas genéricas.
- Amplio Soporte de Modelos: Soporta nativamente una amplia gama de LLMs de código abierto populares, incluyendo Llama 1/2/3, Mistral, Gemma, Qwen, DeepSeek y más.
- Soporte de Cuantización: Soporte completo para el ajuste fino LoRA de 4 y 16 bits, haciendo el entrenamiento aún más eficiente en memoria.
- Escalabilidad: Optimizado para configuraciones de una sola GPU, multi-GPU (hasta 8) y multi-nodo (Enterprise).
- Inferencia Más Rápida: Ofrece velocidades de inferencia hasta 2 veces más rápidas después del entrenamiento, haciendo más eficiente el despliegue del modelo.
- Mejora de la Precisión: El plan Enterprise ofrece características que pueden aumentar la precisión del modelo hasta en un 30% en ciertas tareas.
Casos de uso para Unsloth
Unsloth es una herramienta versátil para cualquiera que trabaje con LLMs:
- Startups de IA: Construir e iterar en modelos personalizados y especializados para aplicaciones de nicho sin incurrir en costos masivos de computación en la nube.
- Investigadores Académicos: Acelerar los ciclos de investigación y ejecutar más experimentos con presupuestos de hardware universitarios limitados.
- Equipos de MLOps Empresariales: Reducir drásticamente el costo y el tiempo de entrenamiento de modelos internos para tareas como soporte al cliente, análisis de documentos o generación de código.
- Desarrolladores Individuales y Aficionados: Experimentar y aprender sobre el ajuste fino de LLMs en ordenadores personales, reduciendo la barrera de entrada al desarrollo de IA de vanguardia.
- Científicos de Datos: Ajustar rápidamente modelos en conjuntos de datos específicos para extraer conocimientos o construir herramientas predictivas para la inteligencia de negocios.
Ventajas de Unsloth
La principal ventaja de Unsloth es su eficiencia inigualable. Al abordar los cuellos de botella centrales de velocidad y memoria, democratiza el acceso a la potente personalización de la IA. Esto conduce a un ahorro de costos significativo en hardware de GPU y servicios en la nube. Su naturaleza de código abierto fomenta la transparencia y la mejora impulsada por la comunidad, mientras que la integración perfecta con el ecosistema de Hugging Face asegura que sea fácil de adoptar para cualquiera que ya esté en el campo. En última instancia, Unsloth empodera a los usuarios para lograr más con menos, convirtiendo lo que antes era un proceso intensivo en recursos en uno rápido y accesible.
Precios y planes
Unsloth opera con un modelo freemium con tres niveles distintos:
- Gratis: Esta es la versión freeware de código abierto de Unsloth. Proporciona un aumento de velocidad de 2x, una reducción del 60% de VRAM y soporta configuraciones de una sola GPU. Es perfecto para individuos y proyectos a pequeña escala, soportando el ajuste fino LoRA de 4 y 16 bits para modelos como Mistral, Gemma y Llama.
- Unsloth Pro: Dirigido a profesionales y equipos, este plan ofrece un aumento de velocidad de 2.5x por GPU, una reducción del 80% de VRAM y un soporte multi-GPU mejorado (hasta 8 GPUs). Este plan es adecuado para cualquier caso de uso que requiera más potencia y eficiencia. El precio está disponible contactando al equipo de Unsloth.
- Unsloth Enterprise: El nivel de rendimiento definitivo para operaciones a gran escala. Desbloquea un entrenamiento hasta 32 veces más rápido, una reducción del 90% de VRAM, soporte multi-nodo y un aumento de precisión de hasta el 30%. También incluye soporte para el entrenamiento completo del modelo (no solo LoRA), una inferencia 5 veces más rápida y soporte al cliente dedicado. El precio está disponible contactando al equipo de Unsloth.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 426.2K
- 2026-1: 574.8K
- 2026-2: 698.3K
- 2026-3: 1.3M
- 2026-4: 1.6M
- 2026-5: 1.1M
Geography
Top 5 countries / regions
- 🇨🇳China43.4%
- 🇺🇸Estados Unidos30.2%
- 🇮🇳India11.4%
- 🇰🇷Corea del Sur7.9%
- 🇩🇪Alemania7.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 64.9% |
Referral | 34.0% |
Email | 1.1% |
Top keywords
| Keyword | Cost per click |
|---|---|
| kimi k2.6 | $0.00 |
| qwen3.5 | $0.00 |
| unsloth | $2.86 |
| unsloth ai | $3.35 |
| unsloth studio | $2.57 |
Unsloth Videos on YouTube

Byte Goose AI.



Docker

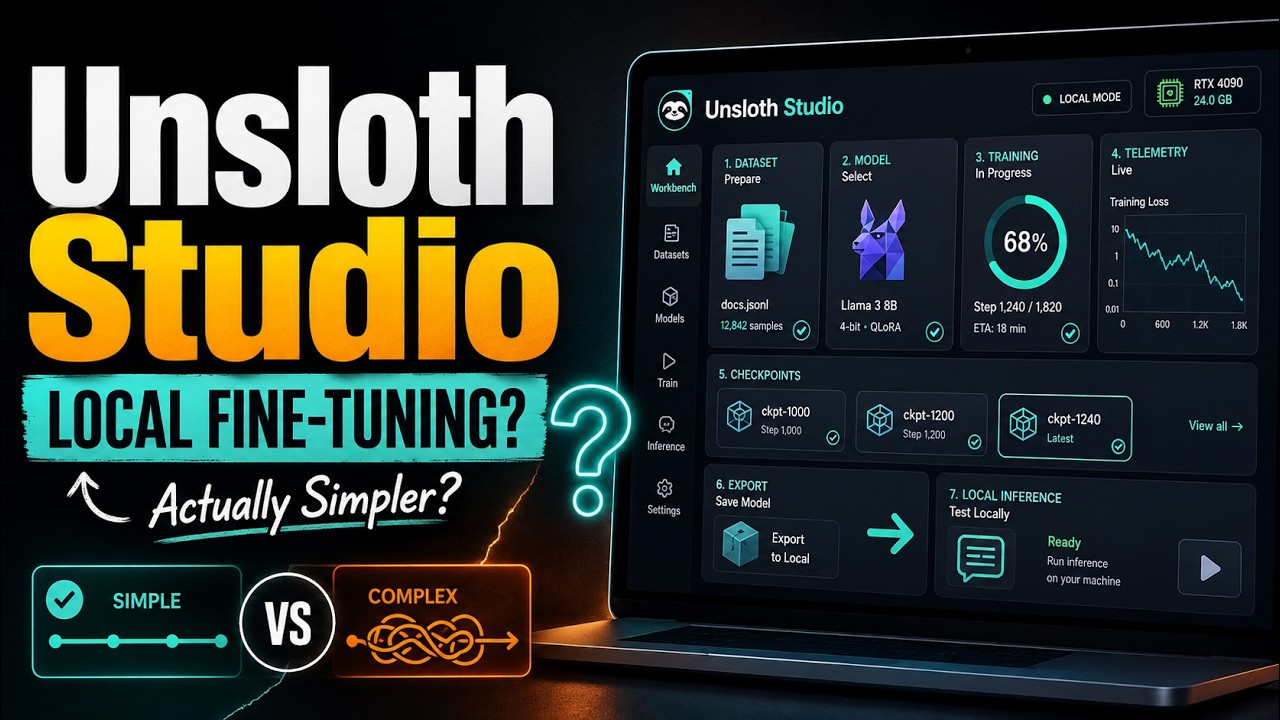
Unsloth Alternatives
xTuring
xTuring es una biblioteca de Python de código abierto diseñada para simplificar el proceso de construcción, ajuste fino y control de Grandes Modelos de Lenguaje (LLM). Proporciona una interfaz fácil de usar para que desarrolladores e investigadores personalicen modelos de IA para datos y aplicaciones específicas con alta eficiencia y personalización.
Entrenamiento de Modelo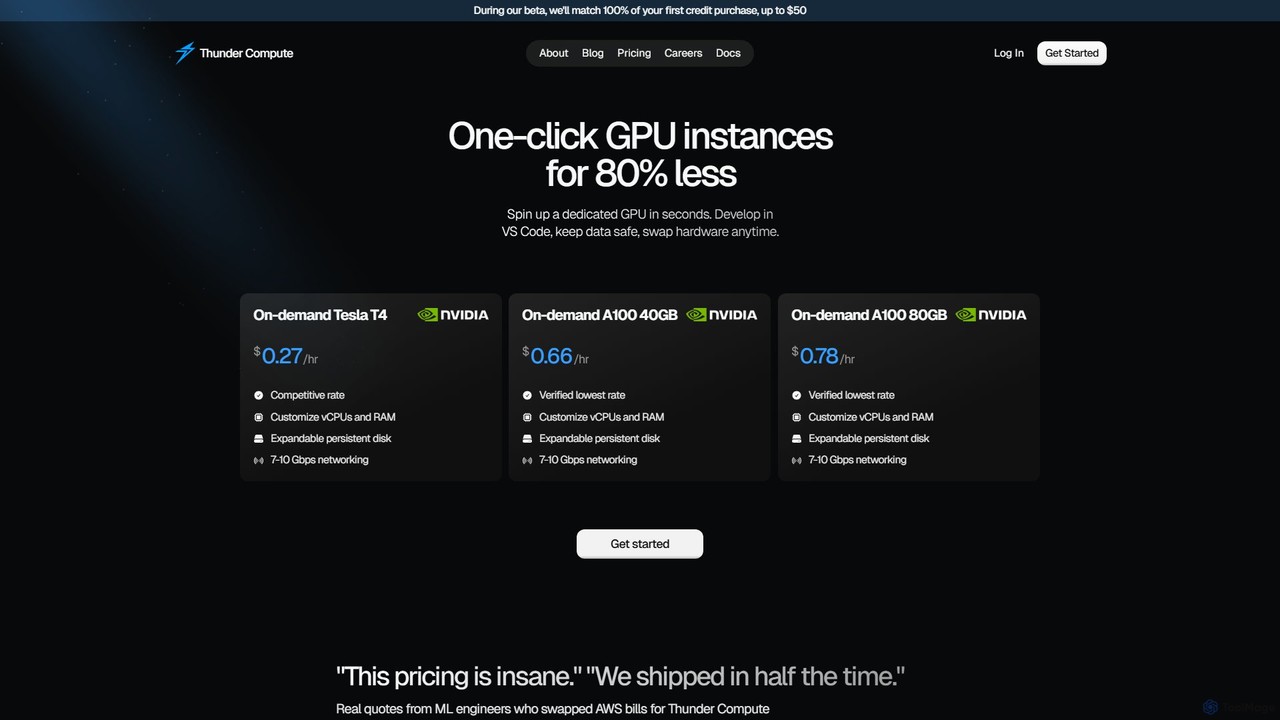
thundercompute
Thunder Compute ofrece una plataforma en la nube de GPU de costo ultrabajo diseñada para desarrolladores de IA y aprendizaje automático. Proporciona instancias de GPU bajo demanda como la NVIDIA A100 y T4 a precios hasta un 80% más bajos que los principales proveedores de la nube. Con características como configuración con un solo clic, integración con VS Code y escalabilidad perfecta, simplifica drásticamente el flujo de trabajo de desarrollo, desde la creación de prototipos hasta la producción, permitiendo a los desarrolladores centrarse en construir modelos en lugar de gestionar la infraestructura.
Aprendizaje Automático
Predibase
Predibase es una plataforma de desarrollo de extremo a extremo para el ajuste fino y el servicio eficientes de Modelos de Lenguaje Grandes (LLM) de código abierto. Permite a los usuarios construir modelos de IA personalizados que superan a grandes modelos propietarios como GPT-4 en tareas específicas, al tiempo que reducen significativamente los costos y la latencia de inferencia. La plataforma cuenta con técnicas avanzadas como el Ajuste Fino por Refuerzo (RFT) y LoRAX para un servicio de alta velocidad y múltiples modelos.
Aprendizaje Automático
Fluidstack
Fluidstack es una plataforma líder de nube de IA que proporciona clústeres de GPU dedicados de alto rendimiento para entrenar y servir modelos de IA de frontera. Ofrece un despliegue rápido de miles de GPUs, servicios totalmente gestionados con soporte experto 24/7 y precios transparentes con cero tarifas de egreso, capacitando a los equipos de IA para escalar sin fricciones de infraestructura.
Soluciones Empresariales
Nebius
Nebius es una plataforma en la nube de alto rendimiento diseñada específicamente para cargas de trabajo exigentes de IA y Machine Learning. Proporciona acceso escalable a las últimas GPUs de NVIDIA, desde instancias únicas hasta clústeres masivos, complementado con un conjunto de servicios gestionados y un AI Studio integrado para agilizar todo el ciclo de vida de ML, desde el entrenamiento hasta la inferencia.
Nube GPUUnsloth Categories
Unsloth Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
xTuring
xTuring es una biblioteca de Python de código abierto diseñada para simplificar el proceso de construcción, ajuste fino y control de Grandes Modelos de Lenguaje (LLM). Proporciona una interfaz fácil de usar para que desarrolladores e investigadores personalicen modelos de IA para datos y aplicaciones específicas con alta eficiencia y personalización.
Entrenamiento de Modelo
Ludwig
Ludwig es un framework de deep learning de código abierto y bajo código que simplifica la construcción y el entrenamiento de modelos de IA personalizados. Usando configuraciones declarativas en YAML, los usuarios pueden crear fácilmente modelos complejos, incluyendo LLMs, para aprendizaje multimodal y multitarea sin necesidad de código repetitivo. Está diseñado para la escalabilidad, la preparación para producción y se integra con herramientas populares como HuggingFace y MLFlow.
Entrenamiento de Modelo
FinetuneDB
FinetuneDB es una plataforma todo en uno de ajuste fino (fine-tuning) de IA para desarrolladores. Simplifica todo el flujo de trabajo para crear Modelos de Lenguaje Grandes (LLMs) personalizados, desde la construcción de conjuntos de datos de alta calidad y el ajuste de modelos como Llama 3 y GPT-4o mini, hasta el despliegue y la evaluación continua en una única plataforma segura.
Llmopsthundercompute
Thunder Compute ofrece una plataforma en la nube de GPU de costo ultrabajo diseñada para desarrolladores de IA y aprendizaje automático. Proporciona instancias de GPU bajo demanda como la NVIDIA A100 y T4 a precios hasta un 80% más bajos que los principales proveedores de la nube. Con características como configuración con un solo clic, integración con VS Code y escalabilidad perfecta, simplifica drásticamente el flujo de trabajo de desarrollo, desde la creación de prototipos hasta la producción, permitiendo a los desarrolladores centrarse en construir modelos en lugar de gestionar la infraestructura.
Aprendizaje AutomáticoPredibase
Predibase es una plataforma de desarrollo de extremo a extremo para el ajuste fino y el servicio eficientes de Modelos de Lenguaje Grandes (LLM) de código abierto. Permite a los usuarios construir modelos de IA personalizados que superan a grandes modelos propietarios como GPT-4 en tareas específicas, al tiempo que reducen significativamente los costos y la latencia de inferencia. La plataforma cuenta con técnicas avanzadas como el Ajuste Fino por Refuerzo (RFT) y LoRAX para un servicio de alta velocidad y múltiples modelos.
Aprendizaje Automático
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
Ollama
Ollama es un potente marco de código abierto para ejecutar grandes modelos de lenguaje (LLMs) como Llama 3, Mistral y Gemma localmente en tu propio hardware. Disponible para macOS, Windows y Linux, simplifica la configuración y gestión de modelos de código abierto, permitiendo un desarrollo y uso de IA privado, sin conexión y rentable.
Aprendizaje Automático
GPT4All
GPT4All es un chatbot de IA gratuito, de código abierto y centrado en la privacidad que ejecuta potentes modelos de lenguaje localmente en tu escritorio. Funciona sin conexión, garantizando que tus datos nunca salgan de tu dispositivo, y te permite chatear con tus propios documentos de forma segura.
Aprendizaje Automático
GreenNode
GreenNode es un proveedor integral de infraestructura en la nube para IA, que ofrece soluciones de GPU NVIDIA de alto rendimiento para startups y empresas. Proporciona acceso instantáneo a recursos de vanguardia como las GPU H100, infraestructura escalable y soporte experto del AI Lab. Centrado en la rentabilidad y el rendimiento, GreenNode ayuda a acelerar el entrenamiento, el ajuste fino y la inferencia de modelos, con una fuerte presencia en el Sudeste Asiático.
Entrenamiento de Modelo
EntryPoint AI
EntryPoint AI es una plataforma sin código diseñada para simplificar el ajuste fino (fine-tuning) de grandes modelos de lenguaje (LLM). Permite a los usuarios gestionar conjuntos de datos, entrenar, evaluar e implementar modelos de IA personalizados de proveedores como OpenAI sin escribir código. La plataforma ayuda a mejorar la calidad, velocidad y previsibilidad del modelo para tareas empresariales específicas, haciendo que la personalización avanzada de IA sea accesible para equipos de cualquier tamaño.
Gestión de Datos
Metrics Help
Metrics Help es una herramienta web de código abierto para profesionales de machine learning. Funciona como una guía completa y un analizador interactivo para métricas de entrenamiento de ML. Los usuarios pueden pegar registros de entrenamiento para obtener explicaciones instantáneas de métricas clave como precisión, pérdida y perplejidad, ayudando en el análisis de rendimiento y la depuración de modelos.
Entrenamiento de Modelo
hyperficient
hyperficient es una herramienta de IA de código abierto para desarrolladores e ingenieros de ML que automatiza la búsqueda de las estrategias de ajuste fino (fine-tuning) más eficientes para redes neuronales. Reduce significativamente los costos computacionales, el tiempo de GPU y el esfuerzo manual, permitiendo un rendimiento óptimo del modelo con recursos limitados.
Bibliotecas
TensorFlow
TensorFlow es una plataforma de código abierto de extremo a extremo para el aprendizaje automático desarrollada por Google. Proporciona un ecosistema completo y flexible de herramientas, bibliotecas y recursos comunitarios que permite a investigadores y desarrolladores crear e implementar aplicaciones impulsadas por ML. Desde principiantes hasta expertos, TensorFlow ofrece API intuitivas de alto nivel para la creación sencilla de modelos y potentes API de bajo nivel para la investigación avanzada, lo que permite la implementación en servidores, dispositivos de borde y navegadores.
Frameworks
Label Studio
Label Studio es una versátil plataforma de etiquetado de datos de código abierto diseñada para una amplia gama de tipos de datos. Permite a los usuarios anotar imágenes, texto, audio, video y datos de series temporales para afinar LLMs, preparar datos de entrenamiento para machine learning y validar modelos de IA con retroalimentación humana en el ciclo.
Datos de Entrenamiento
Forefront
Forefront es una plataforma para desarrolladores para construir con IA de código abierto. Simplifica la ejecución, el ajuste fino y el despliegue de grandes modelos de lenguaje (LLM) en tus datos privados, ofreciendo una alternativa escalable, segura y rentable a las plataformas de código cerrado. Sé dueño de tus datos, tus modelos y tu IA.
Grandes Modelos de Lenguaje
Unsloth Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.