ToolMage
Connexion

Best 1 Apprentissage Automatique AI tools for Vision par ordinateur

Popular Apprentissage Automatique AI tools in Vision par ordinateur include Unitlab, helping you work more efficiently.

Unitlab
Paid

Unitlab

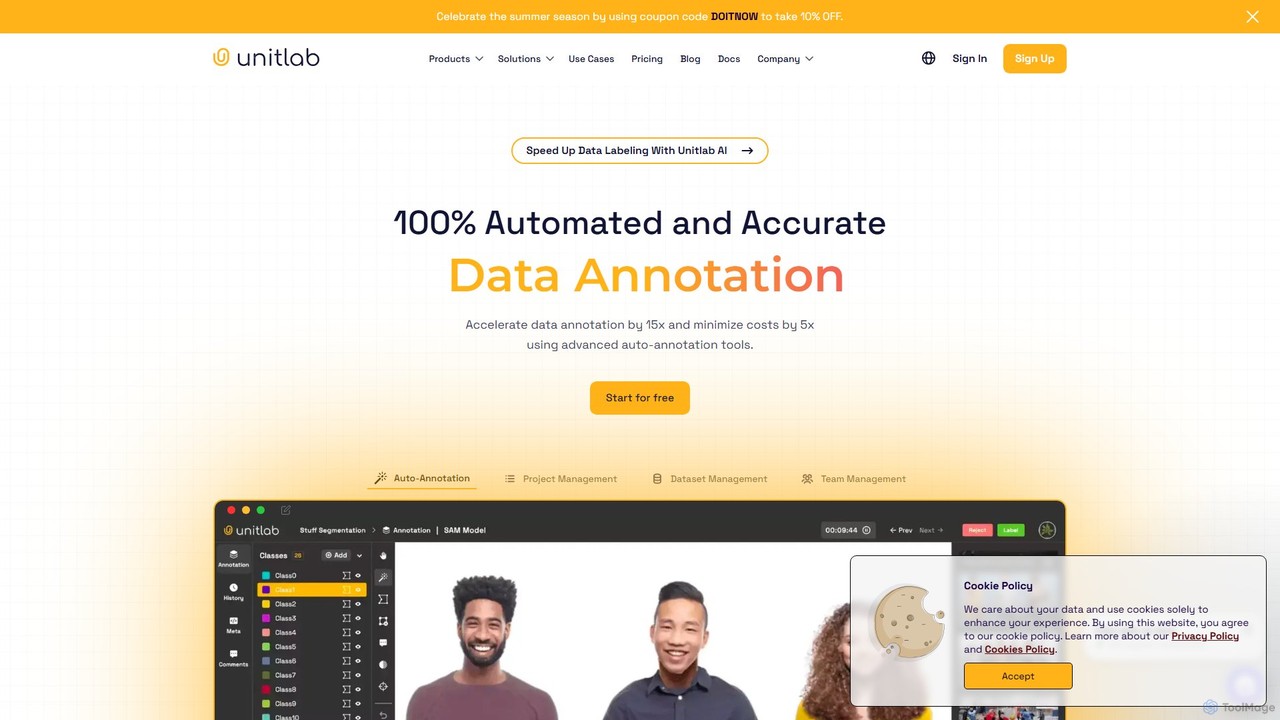
Unitlab est une plateforme d'annotation de données rationalisée conçue pour les projets de vision par ordinateur. Elle fournit une suite complète d'outils pour l'annotation de données, la gestion de jeux de données et la gestion de modèles. La plateforme prend en charge divers types d'annotation et propose un étiquetage assisté par l'IA pour accélérer les flux de travail, ce qui la rend idéale pour des secteurs comme la santé, l'agriculture, la robotique et la conduite autonome.

Gestion des Ensembles de Données
Visits 11.1KFavorites 149Likes 139

About Apprentissage Automatique

Les outils d'Apprentissage Automatique pour la vision par ordinateur sont des plateformes et des cadres spécialisés pour construire, entraîner et déployer des modèles qui permettent aux ordinateurs d'interpréter et de comprendre les informations visuelles. Ces outils utilisent des algorithmes tels que les réseaux de neurones profonds pour apprendre des motifs à partir de grands ensembles de données d'images et de vidéos, automatisant ainsi la création de capacités de vision sophistiquées. Ils permettent aux développeurs et aux scientifiques des données de dépasser les API pré-construites et de créer des solutions personnalisées pour des tâches de reconnaissance visuelle uniques, telles que la détection d'objets, la segmentation d'images et l'analyse faciale. Cette approche offre une plus grande flexibilité et une précision accrue pour des besoins métiers spécifiques.

Fonctionnalités Clés

  • Entraînement et Affinage de Modèles : Fournit des environnements pour entraîner des modèles personnalisés à partir de zéro ou adapter des modèles pré-entraînés à de nouvelles données.
  • Annotation et Gestion de Données : Inclut des outils pour étiqueter des images et des vidéos (par ex., boîtes englobantes, polygones) afin de créer des ensembles de données d'entraînement.
  • Optimisation des Hyperparamètres : Automatise le processus de recherche des meilleures configurations de modèle pour maximiser les performances.
  • Déploiement et Gestion de Modèles : Facilite l'empaquetage et le déploiement de modèles entraînés sous forme d'API évolutives ou pour des appareils en périphérie (edge).
  • Suivi des Expérimentations : Enregistre et compare différentes exécutions d'entraînement, modèles et résultats pour garantir la reproductibilité.

Cas d'Utilisation

Ces outils sont essentiels pour les organisations dans des secteurs comme la fabrication pour le contrôle qualité automatisé, la santé pour l'analyse d'images médicales (par ex., détection d'anomalies sur les radiographies), la vente au détail pour la gestion des stocks via la détection d'objets, et l'automobile pour le développement de systèmes de perception pour les véhicules autonomes. Ils sont utilisés par les ingénieurs en apprentissage automatique et les scientifiques des données pour construire des systèmes de vision propriétaires adaptés à des exigences opérationnelles spécifiques.

Comment Choisir

Lors de la sélection d'un outil d'Apprentissage Automatique pour la vision par ordinateur, tenez compte des cadres pris en charge (par ex., TensorFlow, PyTorch), de la facilité d'annotation et de prétraitement des données, et de l'évolutivité de l'infrastructure d'entraînement. Évaluez les options de déploiement de modèles, telles que les API basées sur le cloud, le support de l'informatique en périphérie (edge computing) et l'intégration avec les pipelines MLOps. Évaluez également l'expertise technique requise et le modèle de tarification de la plateforme, qu'il soit basé sur les heures de calcul ou un abonnement.

Apprentissage Automatique use cases

1

Automatisation du Contrôle Qualité dans la Fabrication

Un ingénieur de fabrication doit identifier les produits défectueux sur une chaîne de montage à grande vitesse. En utilisant une plateforme d'apprentissage automatique, il collecte des images de produits conformes et défectueux pour créer un ensemble de données étiquetées. Il entraîne ensuite un modèle de classification d'images personnalisé pour distinguer les deux catégories avec une grande précision. Le modèle entraîné est déployé sur un appareil en périphérie (edge) avec une caméra positionnée au-dessus du tapis roulant. Ce système signale ou retire automatiquement les produits défectueux en temps réel, réduisant les coûts d'inspection manuelle de plus de 90% et améliorant considérablement la constance de la qualité du produit.

2

Développement d'un Modèle d'Analyse d'Images Médicales Personnalisé

Un scientifique des données dans un institut de recherche en santé est chargé de créer un modèle pour détecter les signes précoces d'une maladie spécifique à partir de scanners IRM. Les outils prêts à l'emploi manquent de la spécificité requise. En utilisant une plateforme d'apprentissage automatique, l'équipe annote un grand ensemble de données de scanners anonymisés, marquant les régions d'intérêt. Ils expérimentent diverses architectures d'apprentissage profond, comme U-Net, en suivant les performances de chaque expérience. Le modèle de segmentation final, très précis, est intégré dans le flux de travail des radiologues comme une aide au diagnostic, aidant à identifier des motifs subtils manqués par l'œil humain et pouvant conduire à un diagnostic plus précoce du patient.

3

Construction d'un Système de Perception pour un Robot Autonome

Un ingénieur en robotique développe un robot d'entrepôt qui doit naviguer dans les allées et identifier les palettes. Il utilise une plateforme d'apprentissage automatique pour entraîner un modèle de détection d'objets. Le processus consiste à annoter des milliers d'images de l'environnement de l'entrepôt avec des boîtes englobantes autour des palettes, des étagères et des obstacles. Il affine un modèle pré-entraîné comme YOLO sur cet ensemble de données personnalisé pour atteindre des performances en temps réel. Le modèle est ensuite déployé sur l'ordinateur de bord du robot, lui permettant de percevoir son environnement, de localiser les palettes cibles et de naviguer en toute sécurité, automatisant ainsi une partie critique du flux de travail logistique.

4

Analyse du Comportement des Clients dans les Magasins de Détail

Un analyste du commerce de détail souhaite comprendre les schémas de circulation des clients en magasin pour optimiser l'agencement. En utilisant une plateforme d'apprentissage automatique et les enregistrements des caméras de sécurité existantes, il entraîne un modèle pour détecter les personnes et suivre leurs mouvements. La plateforme aide à gérer le grand ensemble de données vidéo et à suivre les expériences pour différents algorithmes de suivi. Le modèle résultant génère des cartes de chaleur anonymisées et des données de cheminement, révélant les zones à fort trafic et les parcours clients courants. Cette vision basée sur les données permet aux directeurs de magasin de placer stratégiquement les produits à forte marge et d'améliorer l'expérience d'achat globale sans matériel de suivi intrusif.

5

Création de Segmentation Sémantique pour l'Imagerie Satellitaire

Un analyste SIG travaillant pour une agence environnementale surveille la déforestation. L'analyse manuelle des images satellites est lente et inefficace. Il utilise une plateforme d'apprentissage automatique pour construire un modèle de segmentation sémantique. L'équipe étiquette méticuleusement divers types de couverture terrestre (forêt, eau, zones urbaines) sur les photos satellites. Ils entraînent un modèle capable de classer automatiquement chaque pixel d'une nouvelle image satellite. Ce processus automatisé permet à l'agence d'analyser de vastes zones géographiques rapidement, de suivre les changements de la couverture forestière dans le temps avec une grande précision et de générer des rapports précis pour l'élaboration des politiques.

6

Affinage d'un Modèle pour la Reconnaissance de Produits de Niche

Une startup développe une application mobile pour identifier des marques spécifiques de baskets à partir d'une photo. Les API de reconnaissance d'images à usage général ne parviennent pas à distinguer les modèles similaires. L'équipe de développement utilise une plateforme d'apprentissage automatique pour affiner un modèle de vision pré-entraîné puissant. Ils collectent et étiquettent un ensemble de données de milliers d'images de baskets. Les outils de la plateforme simplifient le processus de ré-entraînement des dernières couches du modèle sur ces données spécifiques. Le modèle spécialisé qui en résulte atteint plus de 95% de précision sur leurs produits cibles, offrant un avantage concurrentiel essentiel pour leur application.

Apprentissage Automatique FAQ

Que sont les outils d'Apprentissage Automatique dans le contexte de la Vision par Ordinateur ?

Les outils d'Apprentissage Automatique pour la Vision par Ordinateur sont des plateformes qui fournissent l'infrastructure de bout en bout pour construire des modèles de vision personnalisés. Contrairement aux API simples qui offrent des fonctions pré-construites, ces outils vous donnent le contrôle sur l'ensemble du cycle de vie du modèle. Cela inclut l'annotation des données, la sélection des architectures de modèles (comme les CNN ou les Vision Transformers), l'entraînement du modèle sur vos données spécifiques et son déploiement pour votre application. Ils sont utilisés lorsque vous avez besoin d'une plus grande précision ou d'une capacité non disponible dans les services de vision par ordinateur standard.

Comment choisir la bonne plateforme de ML pour mon projet de vision par ordinateur ?

Le choix de la bonne plateforme dépend de plusieurs facteurs. Considérez les points suivants :

  • Compétence Technique : Certaines plateformes offrent des interfaces low-code/no-code pour des tâches plus simples, tandis que d'autres nécessitent de solides connaissances en programmation et en ML.
  • Complexité du Projet : Pour des tâches standard comme la classification, une plateforme plus simple peut suffire. Pour des tâches complexes comme la segmentation sémantique ou la vision 3D, vous aurez besoin d'un outil plus puissant et flexible.
  • Besoins en Données : Évaluez les capacités d'annotation, d'augmentation et de gestion des données de la plateforme.
  • Cible de Déploiement : Assurez-vous que la plateforme prend en charge le déploiement dans votre environnement cible, que ce soit le cloud, une application mobile ou un appareil en périphérie.
  • Coût : Comparez les modèles de tarification, qui peuvent être basés sur l'utilisation (heures de GPU), le nombre d'utilisateurs ou les fonctionnalités.
Quelle est la différence entre l'utilisation d'une API de Vision par Ordinateur pré-construite et une plateforme d'Apprentissage Automatique ?

La différence essentielle réside dans la personnalisation et le contrôle. Une API de Vision par Ordinateur pré-construite (par exemple, pour la détection d'objets générale) est un service prêt à l'emploi qui fonctionne bien pour les tâches courantes mais offre une flexibilité limitée. Une plateforme d'Apprentissage Automatique, en revanche, est une boîte à outils. Elle vous permet de construire un modèle hautement spécialisé, entraîné sur vos propres données. Utilisez une API pour la rapidité et la commodité sur des problèmes standard. Utilisez une plateforme de ML lorsque vous devez résoudre un problème visuel unique, que vous avez besoin d'une précision supérieure à celle qu'un modèle général peut fournir, ou que vous devez détenir la propriété intellectuelle du modèle résultant.

Dois-je être un scientifique des données pour utiliser ces outils d'apprentissage automatique ?

Pas nécessairement, mais cela dépend de l'outil. Le domaine évolue avec des plateformes plus conviviales dotées de capacités d'apprentissage automatique automatisé (AutoML). Ces outils low-code ou no-code peuvent automatiser des tâches telles que la sélection de modèles et l'optimisation des hyperparamètres, les rendant accessibles aux développeurs ou aux experts du domaine ayant moins d'expérience en ML. Cependant, pour construire des modèles très complexes et de pointe ou pour une personnalisation approfondie, une solide expérience en apprentissage automatique, en programmation (comme Python) et dans les cadres d'apprentissage profond est généralement requise.

Quelles sont les étapes clés de la construction d'un modèle de CV avec ces outils ?

La construction d'un modèle de vision par ordinateur personnalisé implique généralement un processus clair et itératif soutenu par ces plateformes :

  1. Collecte et Préparation des Données : Rassembler et organiser vos images ou vidéos.
  2. Annotation des Données : Étiqueter vos données avec précision (par ex., dessiner des boîtes englobantes autour des objets). C'est l'une des étapes les plus critiques.
  3. Entraînement du Modèle : Choisir une architecture de modèle et l'entraîner sur votre ensemble de données étiquetées. Cela implique de définir des paramètres et de laisser l'algorithme apprendre.
  4. Évaluation : Tester les performances du modèle entraîné sur un ensemble de données distinct pour voir ses performances.
  5. Déploiement : Rendre le modèle entraîné disponible pour une utilisation dans votre application, via une API ou sur un appareil.
  6. Surveillance et Réentraînement : Surveiller en continu les performances du modèle dans le monde réel et le réentraîner avec de nouvelles données pour maintenir la précision.