ToolMage
Connexion

Best 2 Génération de Données AI tools for Données

Popular Génération de Données AI tools in Données include ezML et Neosync, helping you work more efficiently.

Neosync
Freemium

Neosync

Neosync est une plateforme open-source pour l'anonymisation de données et la génération de données synthétiques. Elle aide les développeurs et les data scientists à créer des ensembles de données sûrs, conformes à la confidentialité et réalistes pour les tests, le développement et l'entraînement de modèles d'IA, tout en garantissant l'intégrité référentielle entre les bases de données.

Génération de Données
Visits 6.5KFavorites 117Likes 119
ezML
Paid

ezML

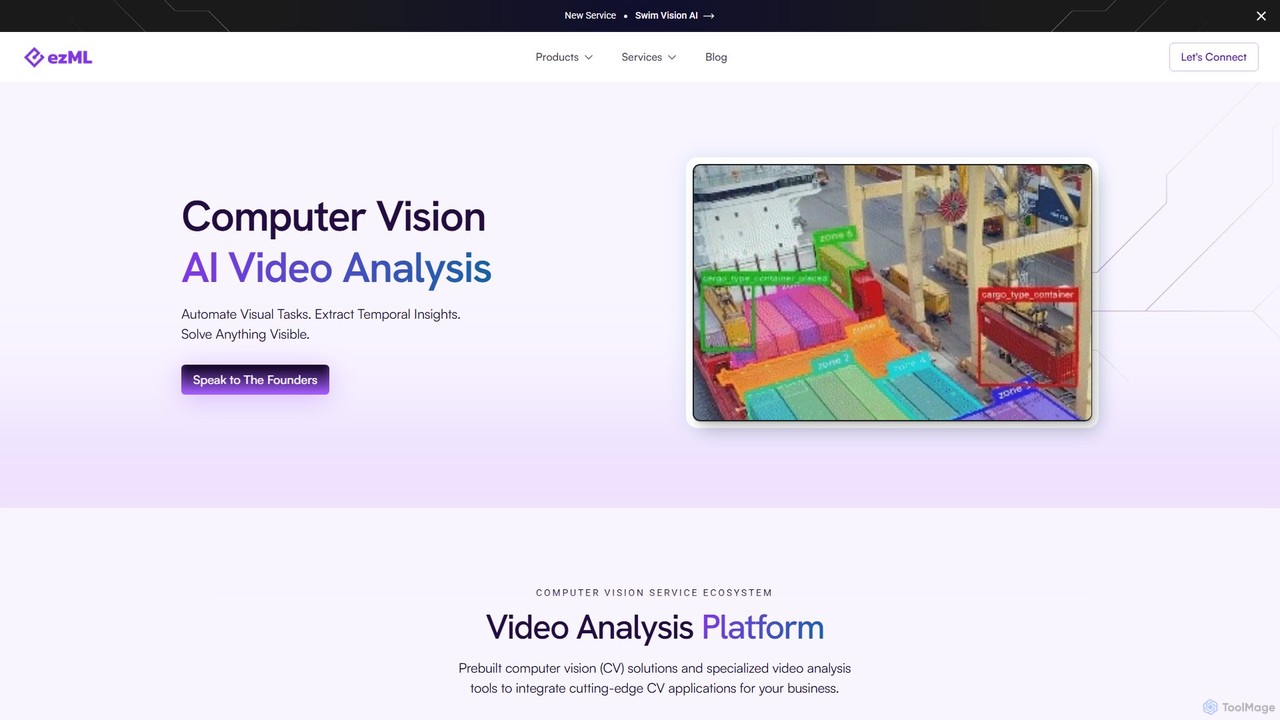
ezML est une plateforme de vision par ordinateur de niveau entreprise spécialisée dans l'analyse vidéo avancée. Elle offre une suite d'outils comprenant des modèles pré-construits, la recherche multimodale, la génération de données synthétiques et des solutions de CV personnalisées. Avec un fort accent sur l'analyse sportive, comme son IA Swim Vision, ezML aide les entreprises à automatiser les tâches visuelles, à extraire des informations approfondies des données vidéo et à déployer des applications de CV performantes et évolutives.

Génération de Données
Visits 8.5KFavorites 130Likes 142

About Génération de Données

Les outils de Génération de Données sont des solutions basées sur l'IA qui créent de nouveaux ensembles de données synthétiques. Ces outils exploitent des algorithmes avancés, incluant souvent les réseaux génératifs antagonistes (GANs) ou les auto-encodeurs variationnels (VAEs), pour produire des données qui imitent les propriétés statistiques et les motifs des données du monde réel. Ils sont cruciaux pour pallier la rareté des données, améliorer la confidentialité et générer des ensembles de données diversifiés et non biaisés pour l'entraînement et le test des modèles d'apprentissage automatique. En simulant des distributions de données complexes, ils permettent un développement robuste sans dépendre uniquement de données réelles sensibles ou limitées.

Fonctionnalités Clés

  • Création de Données Synthétiques: Génère des points de données réalistes et statistiquement similaires à travers diverses modalités comme les images, le texte ou les données tabulaires.
  • Préservation de la Confidentialité: Crée des données qui conservent leur utilité analytique tout en anonymisant ou en protégeant les informations sensibles.
  • Augmentation de Données: Étend les ensembles de données existants avec des variations diverses pour améliorer la robustesse et la capacité de généralisation du modèle.
  • Atténuation des Biais: Génère des ensembles de données équilibrés pour réduire les biais inhérents présents dans les données du monde réel, conduisant à des modèles d'IA plus justes.
  • Paramètres Personnalisables: Offre des contrôles pour spécifier les caractéristiques des données, le volume, la distribution et les scénarios spécifiques de génération.

Scénarios d'Application

Les outils de Génération de Données sont largement adoptés par les ingénieurs en apprentissage automatique, les scientifiques des données et les testeurs de logiciels. Ils sont essentiels pour entraîner des modèles d'IA robustes dans des domaines où les données sont rares, créer des données de test réalistes pour les applications sans compromettre la confidentialité, et produire des ensembles de données anonymisés pour la conformité dans des industries réglementées comme la santé et la finance.

Comment Choisir

Lors de la sélection d'un outil de Génération de Données, tenez compte du type et de la fidélité des données requises, en vous assurant qu'il peut produire des données suffisamment réalistes pour votre cas d'utilisation. Évaluez ses fonctionnalités de confidentialité et de sécurité pour les informations sensibles, et estimez sa scalabilité et ses performances pour générer efficacement de grands volumes de données. Enfin, vérifiez les options de personnalisation pour contrôler les caractéristiques des données et les scénarios spécifiques.

Génération de Données use cases

1

Générer des Données d'Image Synthétiques pour l'Entraînement de Modèles d'IA

Les ingénieurs en apprentissage automatique ont besoin de vastes quantités de données d'images diverses pour entraîner les modèles de vision par ordinateur, mais la collecte de données réelles est coûteuse et souvent soumise à des restrictions de confidentialité. Les outils de génération de données peuvent créer automatiquement des millions d'images synthétiques avec des arrière-plans, des éclairages, des poses et des caractéristiques variés, basées sur un petit ensemble d'images réelles ou des descriptions spécifiques. Cela résout non seulement la rareté des données, mais améliore également la généralisation et la robustesse du modèle dans les applications du monde réel en introduisant de la diversité, accélérant considérablement le cycle de développement du modèle.

2

Créer des Données de Test de Transactions Clients Conformément à la Confidentialité

Les institutions financières ont besoin de vastes quantités de données de transactions clients pour les tests fonctionnels et de performance lors du développement de nouveaux produits ou systèmes. Cependant, l'utilisation de données clients réelles présente des risques stricts de conformité en matière de confidentialité. Les outils de génération de données peuvent produire des données de transactions synthétiques entièrement anonymes avec la même structure et les mêmes caractéristiques que les données de transactions existantes, basées sur leurs motifs statistiques. Cela permet aux équipes de développement de mener des tests complets dans un environnement sécurisé et conforme, évitant les risques de fuite de données tout en garantissant l'efficacité des tests.

3

Automatiser la Génération de Données de Comportement Utilisateur pour les Tests Logiciels

Les testeurs de logiciels doivent simuler divers comportements d'interaction utilisateur au sein d'une application pour les tests d'interface utilisateur (UI) et d'expérience utilisateur (UX). La création manuelle de ces chemins de comportement complexes prend du temps et ne couvre souvent pas tous les cas limites. Les outils de génération de données peuvent produire automatiquement des données synthétiques simulant une série d'actions utilisateur comme les clics, les saisies et la navigation, basées sur des modèles de comportement utilisateur prédéfinis ou des journaux historiques. Cela augmente considérablement la couverture et l'efficacité des tests, aidant à découvrir les bogues potentiels et les goulots d'étranglement de performance.

4

Étendre les Ensembles de Données Textuelles à Faibles Ressources pour Améliorer les Performances des Modèles NLP

Les modèles de Traitement du Langage Naturel (NLP) sont souvent confrontés à un manque de données dans les langues à faibles ressources ou des domaines spécifiques (par exemple, juridique, médical), ce qui entraîne des performances médiocres. Les créateurs de contenu ou les chercheurs en IA peuvent utiliser des outils de génération de données pour produire de grands volumes de données textuelles synthétiques grammaticalement correctes et sémantiquement cohérentes, basées sur une petite quantité de texte source et de règles linguistiques. Ces données peuvent être utilisées pour pré-entraîner ou affiner les modèles NLP, atténuant efficacement la rareté des données et améliorant considérablement la précision des tâches comme la traduction, l'analyse des sentiments et les systèmes de questions-réponses dans des environnements linguistiques à faibles ressources.

5

Générer des Données de Simulation de Capteurs Diversifiées pour les Systèmes de Conduite Autonome

Le développement de véhicules autonomes nécessite des quantités massives de données de capteurs (par exemple, radar, lidar, caméras) pour entraîner les modèles de perception et de prise de décision. La collecte de données du monde réel est extrêmement coûteuse et peine à couvrir tous les scénarios extrêmes ou rares. Les outils de génération de données peuvent simuler des environnements de trafic complexes, des conditions météorologiques et des obstacles, produisant des données de capteurs synthétiques réalistes. Cela permet aux ingénieurs de tester et de valider en toute sécurité et efficacement les algorithmes de conduite autonome dans des environnements virtuels, accélérant l'itération technologique et améliorant la sécurité.

6

Remplir les Données Manquantes ou Équilibrer les Ensembles de Données pour Réduire le Biais du Modèle

De nombreux ensembles de données réels souffrent de données manquantes ou d'un déséquilibre de classes, ce qui peut entraîner des modèles d'IA biaisés ou sous-performants. Les analystes de données et les scientifiques des données peuvent utiliser des outils de génération de données pour remplir intelligemment les valeurs manquantes ou générer des données synthétiques pour les classes minoritaires en se basant sur les modèles de distribution de données existants. En créant des ensembles de données plus complets et équilibrés, ces outils réduisent efficacement les biais dans l'entraînement du modèle et améliorent l'équité et la précision prédictive des modèles, ce qui est particulièrement crucial dans des domaines comme le diagnostic médical ou l'évaluation des risques financiers.

Génération de Données FAQ

Que sont les outils de Génération de Données par IA ?

Les outils de Génération de Données par IA sont des applications logicielles qui exploitent l'intelligence artificielle, comme les modèles génératifs, pour créer de nouvelles données synthétiques. Ces outils produisent des données qui imitent statistiquement les données du monde réel, répondant à des défis tels que la rareté des données, les préoccupations de confidentialité et le besoin de jeux de données diversifiés. Ils sont principalement utilisés pour entraîner des modèles d'apprentissage automatique, tester des logiciels et permettre le partage de données dans des environnements sensibles.

En quoi les outils de Génération de Données diffèrent-ils des outils d'Augmentation de Données ?

Les outils de Génération de Données créent des points de données entièrement nouveaux à partir de zéro, basés sur des motifs appris à partir de données existantes. Par exemple, générer une image synthétique complètement nouvelle d'un chat. L'Augmentation de Données, en revanche, modifie les données réelles existantes pour créer des variations, comme faire pivoter une image, ajouter du bruit ou changer des synonymes de texte. Bien que les deux étendent les ensembles de données, la génération crée de nouvelles instances, tandis que l'augmentation transforme celles qui existent déjà. La génération de données peut être considérée comme une forme plus avancée d'expansion de données.

Quels types de données les outils de Génération de Données par IA peuvent-ils créer ?

Les outils de Génération de Données par IA sont très polyvalents et peuvent créer un large éventail de types de données. Cela inclut les données tabulaires (par exemple, registres financiers, données démographiques des clients), les données d'images (par exemple, visages, objets, scanners médicaux, images satellite), les données textuelles (par exemple, avis de produits, articles, extraits de code), les données audio (par exemple, parole, sons environnementaux) et les données de séries temporelles (par exemple, lectures de capteurs, cours boursiers). L'essentiel est que les données générées maintiennent les propriétés statistiques et le réalisme de leurs homologues du monde réel.

Quels sont les principaux avantages de l'utilisation de données synthétiques générées par l'IA ?

Les principaux avantages de l'utilisation de données synthétiques générées par l'IA sont nombreux. Premièrement, cela améliore la confidentialité des données en fournissant des ensembles de données réalistes sans exposer d'informations réelles sensibles, ce qui est crucial pour la conformité. Deuxièmement, cela résout la rareté des données, permettant aux développeurs d'entraîner des modèles robustes même lorsque les données réelles sont limitées. Troisièmement, cela aide à atténuer les biais en permettant la création d'ensembles de données équilibrés. De plus, les données synthétiques peuvent être générées plus rapidement et de manière plus rentable que la collecte et l'annotation de données réelles, et elles offrent des environnements sûrs pour tester des systèmes complexes.

Les données synthétiques générées par l'IA sont-elles aussi bonnes que les données réelles pour l'entraînement des modèles ?

Les données synthétiques générées par l'IA peuvent être aussi bonnes, voire supérieures, aux données réelles pour l'entraînement des modèles dans des contextes spécifiques. Pour les tâches où la confidentialité des données est primordiale ou les données réelles sont rares, les données synthétiques offrent une alternative viable et souvent préférée. Leur qualité dépend fortement de la sophistication du modèle de génération et de la complexité des données réelles qu'il imite. Bien que les données synthétiques puissent ne pas capturer toutes les nuances ou les cas extrêmes des données réelles, elles excellent à fournir des ensembles de données diversifiés, non biaisés et évolutifs, ce qui les rend très efficaces pour améliorer la robustesse et la généralisation du modèle, surtout lorsqu'elles sont utilisées conjointement avec des données réelles.