ToolMage
Connexion

Best 1 Gestion des données AI tools for Outils pour développeurs

Popular Gestion des données AI tools in Outils pour développeurs include JSON Formatter, helping you work more efficiently.

JSON Formatter
Free

JSON Formatter

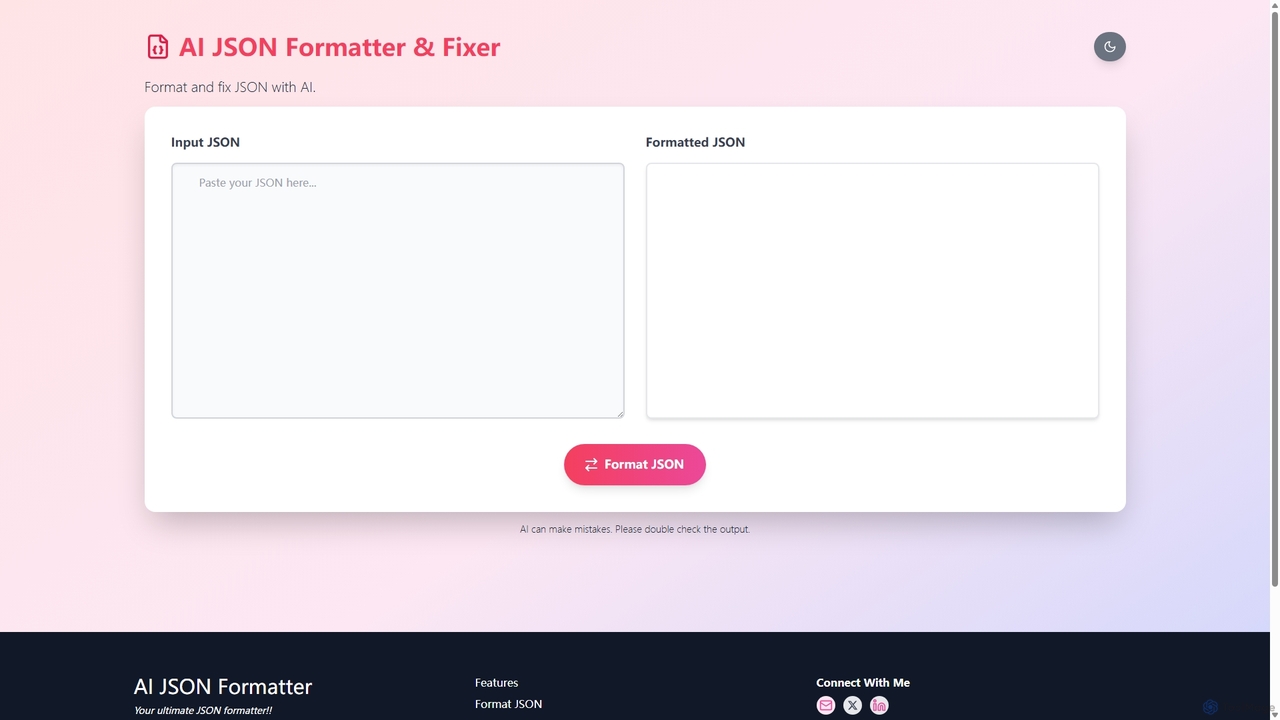
Un outil en ligne alimenté par l'IA pour formater, valider et réparer les données JSON. Il offre un formatage instantané, une correction d'erreurs intelligente et des capacités de téléversement de fichiers, le rendant essentiel pour les développeurs pour déboguer et gérer efficacement le JSON.

Assistant de code
Visits 6.5KFavorites 127Likes 130

About Gestion des données

Les outils de Gestion des données IA sont une catégorie spécialisée d'utilitaires pour développeurs conçus pour automatiser et rationaliser le traitement d'ensembles de données complexes. Ils exploitent des algorithmes d'apprentissage automatique pour des tâches telles que le nettoyage des données, la transformation, l'ingénierie des fonctionnalités et la validation, constituant une partie essentielle du cycle de vie MLOps. Ces outils sont fondamentaux pour préparer des données de haute qualité pour les modèles d'apprentissage automatique, accélérer les cycles de développement et garantir l'intégrité des données dans les applications basées sur l'IA. En identifiant intelligemment les schémas et les anomalies, ils réduisent considérablement l'effort manuel généralement requis pour la préparation des données.

Fonctionnalités Clés

  • Nettoyage Automatisé des Données : Identifie et corrige intelligemment les erreurs, les incohérences et les valeurs manquantes dans les ensembles de données.
  • Transformation Intelligente des Données : Convertit les formats de données, normalise les valeurs et encode les variables catégorielles en fonction du contexte des données.
  • Ingénierie des Fonctionnalités par IA : Génère et sélectionne automatiquement des fonctionnalités pertinentes à partir de données brutes pour améliorer les performances des modèles d'apprentissage automatique.
  • Détection d'Anomalies : Utilise des modèles d'IA pour détecter les valeurs aberrantes et les schémas inhabituels qui pourraient indiquer des problèmes de qualité des données ou des événements critiques.
  • Génération de Données Synthétiques : Crée des ensembles de données artificiels et statistiquement représentatifs pour les tests, la formation et la préservation de la confidentialité.

Cas d'Utilisation

Ces outils sont principalement utilisés par les data scientists, les ingénieurs en apprentissage automatique et les ingénieurs de données. Les scénarios courants incluent la préparation de données d'entraînement pour un nouveau modèle prédictif, la construction de pipelines de données robustes et adaptatifs pour des applications en temps réel, ou le nettoyage de données textuelles non structurées à grande échelle pour des tâches de traitement du langage naturel (NLP).

Comment Choisir

Lors de la sélection d'un outil de Gestion des données IA, tenez compte de sa compatibilité avec les sources de données (bases de données, API, formats de fichiers), de sa capacité à gérer votre volume de données et de ses capacités d'intégration avec votre pile MLOps existante (par exemple, TensorFlow, PyTorch, plateformes cloud). Évaluez également le niveau d'automatisation par rapport au besoin de définir des règles personnalisées pour vous assurer qu'il correspond au flux de travail et à l'expertise technique de votre équipe.

Gestion des données use cases

1

Préparation des Données d'Entraînement pour un Modèle de Machine Learning

Un ingénieur en Machine Learning est chargé de construire un modèle de détection de fraude. Les données de transaction brutes sont incohérentes, avec des valeurs manquantes, des formats de devise variés et des champs de texte bruités. En utilisant un outil de Gestion des données IA, l'ingénieur automatise le processus d'imputation des valeurs manquantes basé sur des modèles statistiques, de standardisation de toutes les valeurs monétaires en une seule devise et de nettoyage des descriptions textuelles. L'outil suggère et génère également de nouvelles fonctionnalités, telles que la « fréquence des transactions par heure ». Il en résulte un ensemble de données propre et de haute qualité créé en quelques heures au lieu de jours, améliorant considérablement la précision du modèle final et réduisant l'effort de prétraitement manuel de plus de 80%.

2

Automatisation de Pipelines de Données Résilients

Un ingénieur de données est responsable de la maintenance d'un pipeline ETL/ELT qui ingère des données de diverses API tierces dans un entrepôt de données. Ces API présentent fréquemment des dérives de schéma ou fournissent des données avec des formats inattendus. Au lieu d'écrire des scripts fragiles basés sur des règles, l'ingénieur déploie un outil de Gestion des données IA. L'outil détecte automatiquement les changements de schéma, adapte la logique de transformation à la volée et utilise la détection d'anomalies pour mettre en quarantaine les mauvaises données avant qu'elles ne contaminent l'entrepôt. Cela crée un pipeline plus résilient et auto-réparateur qui nécessite beaucoup moins d'intervention manuelle et garantit une plus grande fiabilité des données pour l'analyse en aval.

3

Nettoyage de Texte non Structuré pour l'Analyse NLP

Un data scientist doit analyser des milliers d'avis clients pour en extraire le sentiment et les sujets clés. Le texte brut est rempli de fautes de frappe, d'argot et de balises HTML non pertinentes. Nettoyer ces données manuellement serait extrêmement chronophage. En utilisant un outil de Gestion des données IA, il applique des modèles pré-construits pour des tâches telles que la correction orthographique, la suppression des mots vides et la reconnaissance d'entités nommées. L'outil traite l'ensemble du corpus d'avis, produisant un texte propre et structuré, prêt à être utilisé dans un modèle d'analyse de sentiments. Cela accélère le calendrier du projet de plusieurs semaines à quelques jours et améliore la précision des informations issues du NLP.

4

Génération de Données Synthétiques pour des Tests Conformes à la Confidentialité

Une équipe de développement d'une entreprise de technologie de la santé doit tester son nouveau logiciel de gestion des patients. L'utilisation de données réelles de patients n'est pas une option en raison de réglementations strictes sur la confidentialité comme le HIPAA. L'équipe utilise un outil de Gestion des données IA doté de capacités de génération de données synthétiques. Ils fournissent à l'outil le schéma et les propriétés statistiques de leurs données réelles. L'outil génère alors un grand ensemble de données artificielles de dossiers de patients qui imite les distributions et les relations du monde réel sans contenir aucune information personnelle réelle. Cela permet à l'équipe d'assurance qualité d'effectuer des tests robustes à grande échelle tout en restant pleinement conforme aux lois sur la confidentialité.

5

Standardisation de Données Produits E-commerce Hétérogènes

Un analyste de données e-commerce doit fusionner les catalogues de produits de plusieurs fournisseurs. Chaque fournisseur fournit des données dans des formats différents, avec des conventions de nommage incohérentes (par exemple, 'Color' vs 'Colour') et des structures d'attributs variées. En utilisant un outil de Gestion des données IA, l'analyste peut intelligemment mapper et standardiser ces champs hétérogènes. L'IA de l'outil reconnaît les similitudes sémantiques pour fusionner correctement les attributs et utilise des algorithmes de clustering pour regrouper les produits similaires, identifiant les doublons potentiels. Ce processus crée un catalogue de produits maître unifié et propre, ce qui améliore directement la précision de la recherche sur le site et l'expérience de navigation du client.

6

Validation des Flux de Données de Capteurs IoT en Temps Réel

Un développeur IoT construit un système de maintenance prédictive pour des machines industrielles, qui repose sur un flux constant de données de capteurs (température, vibration, pression). Ces données peuvent être bruitées ou contenir des lectures erronées en raison d'un dysfonctionnement du capteur. Un outil de Gestion des données IA est implémenté dans le flux de données pour effectuer une validation en temps réel. Il utilise des modèles entraînés pour identifier les lectures anormales qui sortent des plages ou des schémas de fonctionnement attendus. L'outil peut automatiquement marquer, filtrer ou même corriger ces valeurs aberrantes avant qu'elles ne soient transmises au modèle prédictif, évitant ainsi les fausses alarmes et garantissant la fiabilité des alertes de maintenance.

Gestion des données FAQ

Que sont les outils de Gestion des données IA ?

Les outils de Gestion des données IA sont des logiciels spécialisés pour les développeurs qui utilisent l'intelligence artificielle pour automatiser et améliorer les tâches de préparation des données. Contrairement aux scripts traditionnels ou aux outils ETL qui reposent sur des règles explicites, ces outils peuvent apprendre des modèles de données pour nettoyer, transformer, valider et même générer des fonctionnalités à partir d'ensembles de données complexes de manière intelligente. Ils sont conçus pour accélérer la partie la plus chronophage du flux de travail de l'apprentissage automatique : la préparation de données de haute qualité.

En quoi les outils de Gestion des données IA diffèrent-ils des outils ETL traditionnels ?

La différence clé réside dans l'intelligence et l'adaptabilité. Les outils ETL (Extraire, Transformer, Charger) traditionnels fonctionnent sur des règles rigides et prédéfinies par un développeur. Si le format des données change, les règles ne fonctionnent plus. Les outils de Gestion des données IA sont plus dynamiques. Ils utilisent l'apprentissage automatique pour :

  • Inférence de règles : Suggérer automatiquement des transformations en fonction du contenu des données.
  • Adaptation à la dérive : Gérer les changements de schéma ou de modèles de données sans intervention manuelle.
  • Détection d'anomalies subtiles : Trouver des valeurs aberrantes complexes que les systèmes simples basés sur des règles manqueraient.
  • Automatisation de l'ingénierie des fonctionnalités : Créer de nouvelles variables prédictives, une tâche qui dépasse le cadre de la plupart des outils ETL.
Essentiellement, ils passent d'une approche basée sur des commandes à une approche basée sur l'apprentissage, réduisant la maintenance manuelle.

Qui sont les principaux utilisateurs des outils de Gestion des données IA ?

Les principaux utilisateurs sont des professionnels techniques qui travaillent directement avec les données pour construire des applications ou des modèles. Cela inclut :

  • Data Scientists : Pour nettoyer les données et effectuer de l'ingénierie de fonctionnalités afin d'améliorer la précision des modèles.
  • Ingénieurs en Machine Learning : Pour créer des pipelines de données robustes et automatisés dans le cadre des pratiques MLOps.
  • Ingénieurs de Données : Pour construire des processus ETL/ELT résilients et adaptatifs nécessitant moins de maintenance.
  • Développeurs de Logiciels : Pour générer des données synthétiques pour les tests ou gérer des validations de données complexes au sein des applications.
Ces outils ne sont généralement pas conçus pour les analystes métier non techniques, car ils nécessitent souvent une certaine compréhension des structures de données et des flux de travail de développement.

Comment choisir le bon outil de Gestion des données IA ?

Le choix du bon outil dépend de vos besoins spécifiques. Considérez ces facteurs clés :

  • Sources et Formats de Données : Assurez-vous que l'outil dispose de connecteurs pour vos bases de données, API, et prend en charge les types de fichiers que vous utilisez (par ex., Parquet, JSON, CSV).
  • Scalabilité : L'outil peut-il gérer le volume et la vélocité de vos données ? Vérifiez s'il prend en charge le traitement distribué (comme Spark).
  • Intégration : Dans quelle mesure s'intègre-t-il à votre écosystème de développement existant ? Recherchez des intégrations avec les plateformes MLOps, les services cloud (AWS, GCP, Azure) et les dépôts de code.
  • Cas d'Utilisation Spécifique : Certains outils excellent dans le traitement de texte non structuré, tandis que d'autres sont meilleurs pour les données tabulaires ou la génération de données synthétiques. Faites correspondre les points forts de l'outil à votre tâche principale.
Commencez par évaluer les outils par rapport à une tâche de préparation de données spécifique et représentative de l'un de vos projets.

Les outils de Gestion des données IA peuvent-ils traiter des données non structurées comme le texte et les images ?

Oui, de nombreux outils avancés de Gestion des données IA sont spécifiquement conçus pour traiter des données non structurées ou semi-structurées. Pour le texte, ils offrent des fonctionnalités telles que le nettoyage basé sur le NLP (correction des fautes de frappe, suppression des mots vides), la reconnaissance d'entités et la modélisation de sujets. Pour les images, ils peuvent aider à des tâches comme l'étiquetage automatique, le redimensionnement ou l'identification de problèmes de qualité (par exemple, le flou). Cette capacité est un avantage significatif par rapport aux outils de données traditionnels qui sont souvent limités aux données structurées et tabulaires. Lors du choix d'un outil, vérifiez ses capacités spécifiques pour le type de données non structurées avec lequel vous travaillez.