ToolMage
Connexion

Best 5 Bibliothèques et Frameworks AI tools for Outils pour développeurs

Popular Bibliothèques et Frameworks AI tools in Outils pour développeurs include Pydantic, Fast.ai, VisActor, reachat et EnergeticAI, helping you work more efficiently.

Fast.ai
Free

Fast.ai

Fast.ai est un institut de recherche dédié à rendre l'apprentissage profond accessible à tous. Il propose des cours gratuits, une bibliothèque logicielle open-source (fastai), des recherches de pointe et une communauté dynamique, permettant aux codeurs de tous horizons de devenir des praticiens de l'apprentissage profond.

Apprentissage Automatique
Visits 421.4KFavorites 168Likes 160
EnergeticAI
Free

EnergeticAI

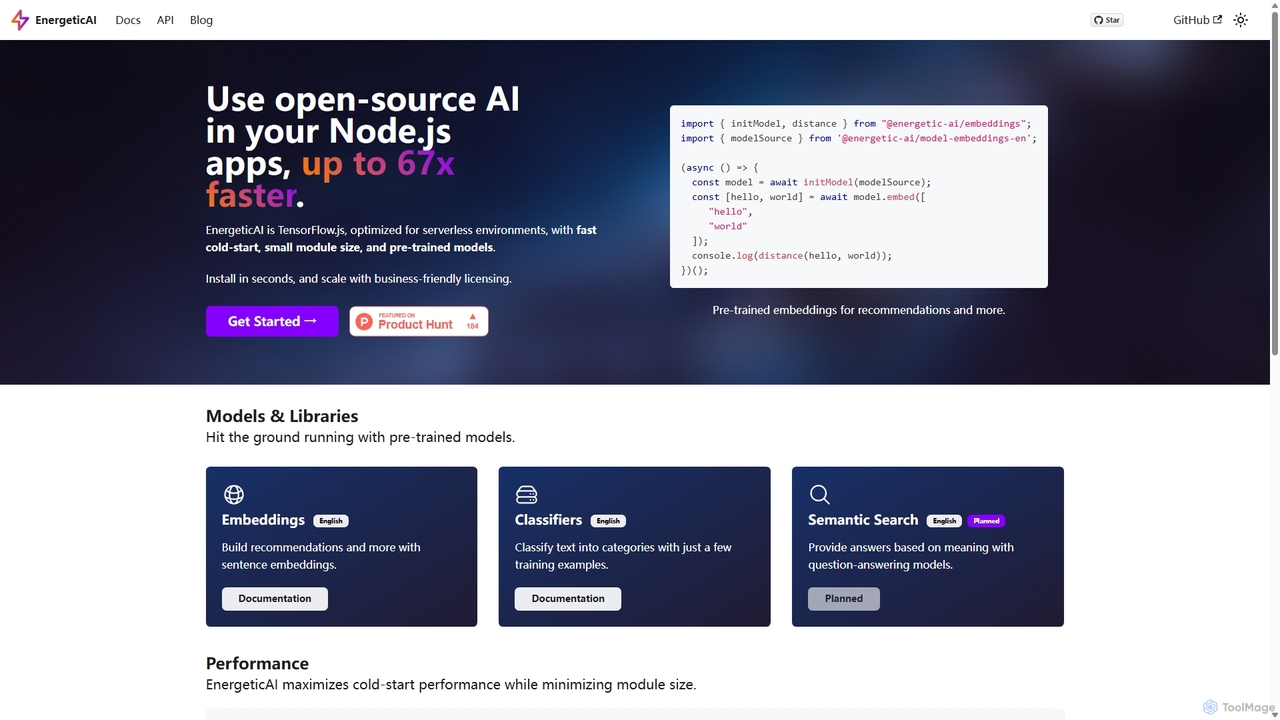
EnergeticAI est une bibliothèque Node.js open-source pour intégrer des modèles d'IA dans des applications, spécifiquement optimisée pour les environnements sans serveur (serverless). Elle offre une alternative haute performance et à faible latence à TensorFlow.js standard, avec une taille de module minimale et des temps de démarrage à froid rapides. Avec des modèles pré-entraînés pour les embeddings et la classification de texte few-shot, les développeurs peuvent facilement créer des fonctionnalités telles que la recherche sémantique, les recommandations et la catégorisation de contenu sans dépendre d'API tierces, garantissant la confidentialité des données et le contrôle des coûts.

Bibliothèques et Frameworks
Visits 7.3KFavorites 151Likes 140
Pydantic
Freemium

Pydantic

Pydantic est une plateforme complète pour les développeurs, offrant une validation de données puissante, des outils de développement IA et une solution d'observabilité full-stack. Elle permet un développement d'applications plus rapide et plus robuste en Python et dans d'autres langages en exploitant les indications de type pour la validation des données à l'exécution et en fournissant des informations approfondies du développement local à la production.

Débogage et Tests
Visits 541.4KFavorites 134Likes 125
VisActor
Free

VisActor

VisActor est une solution de visualisation intelligente, open-source et axée sur la narration, développée par ByteDance. Elle fournit une suite complète d'outils, incluant VChart et VTable, pour transformer les données en récits visuels captivants. Grâce à son composant alimenté par l'IA, VMind, elle simplifie la création de graphiques et permet des présentations de données dynamiques et multiplateformes.

Bibliothèques et Frameworks
Visits 29.3KFavorites 149Likes 141
reachat
Free

reachat

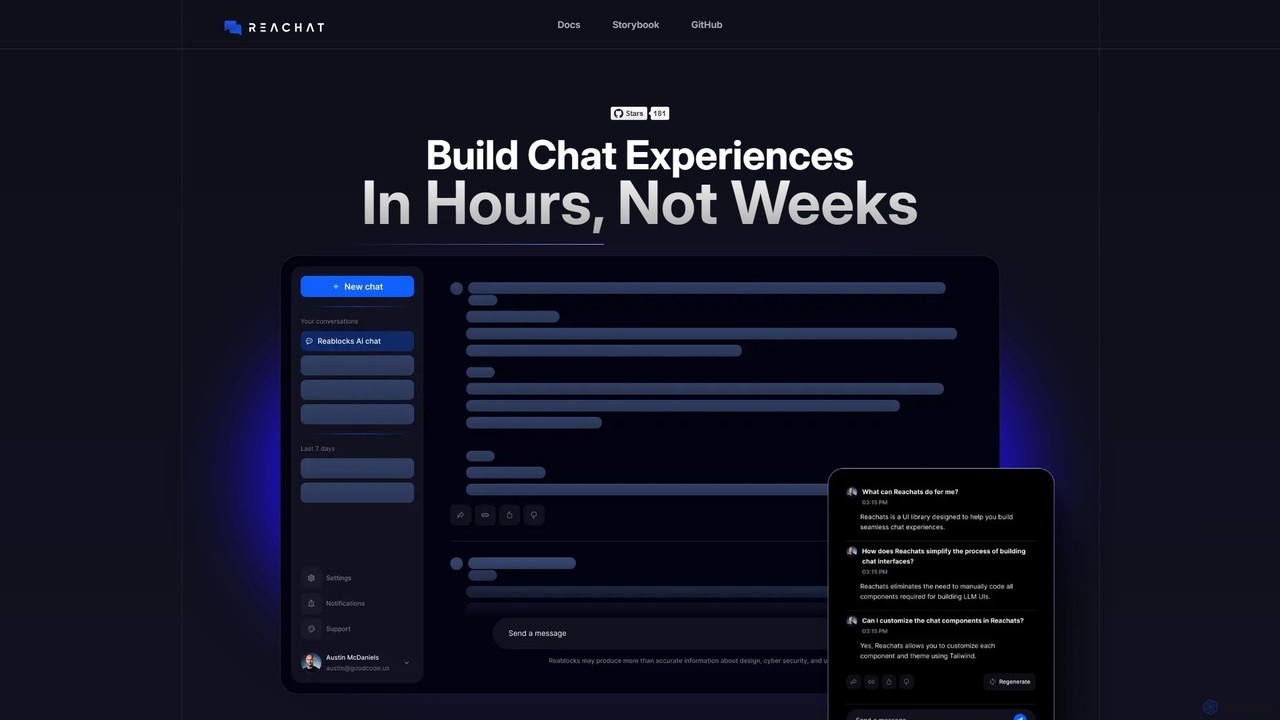
reachat est une bibliothèque de composants ReactJS open-source conçue pour les développeurs afin de créer rapidement des interfaces de chat IA sophistiquées. Elle fournit des composants hautement personnalisables et indépendants du backend, permettant l'intégration de n'importe quel LLM et prenant en charge les médias riches pour des expériences utilisateur améliorées. Créez des interfaces utilisateur de chat prêtes pour la production en quelques heures, et non en quelques semaines.

Développement de chatbot
Visits 10.2KFavorites 134Likes 122

About Bibliothèques et Frameworks

Les Bibliothèques et Frameworks d'IA sont des boîtes à outils fondamentales qui fournissent aux développeurs du code pré-écrit, des fonctions et un environnement structuré pour construire, entraîner et déployer des modèles d'apprentissage automatique. Ces outils abstraient les opérations mathématiques complexes et les interactions matérielles de bas niveau, offrant des API de haut niveau pour définir les réseaux de neurones et les pipelines de traitement de données. En les utilisant, les développeurs peuvent accélérer considérablement le cycle de vie du développement, du prototypage à la production, tout en tirant parti de performances optimisées pour des tâches telles que la vision par ordinateur et le traitement du langage naturel. Ils constituent l'épine dorsale essentielle du développement d'applications d'IA modernes au sein de l'écosystème plus large des Outils pour Développeurs.

Fonctionnalités Clés

  • Architectures Prédéfinies : Fournit un accès à des architectures de modèles testées et optimisées comme les Transformers, les CNN et les RNN.
  • Différenciation Automatique : Calcule automatiquement les gradients pour les paramètres du modèle, ce qui est essentiel pour entraîner les réseaux de neurones par rétropropagation.
  • Accélération Matérielle : Inclut un support intégré pour les GPU et les TPU afin de réduire considérablement les temps d'entraînement et d'inférence des modèles.
  • Outils d'Optimisation et de Déploiement de Modèles : Offre des utilitaires pour quantifier, élaguer et empaqueter les modèles pour un déploiement efficace sur des serveurs, des appareils mobiles ou en périphérie.
  • API de Gestion de Données : Propose des chargeurs de données et des pipelines de transformation efficaces pour gérer de manière transparente des ensembles de données à grande échelle.

Cas d'Utilisation

Ces outils sont indispensables pour les chercheurs en IA, les ingénieurs en apprentissage automatique et les scientifiques des données. Ils sont utilisés pour créer des applications allant des systèmes de reconnaissance d'images dans l'industrie et la santé aux modèles de langage sophistiqués pour les chatbots et la génération de contenu. Dans la finance, ils alimentent les systèmes de trading algorithmique et de détection de fraude.

Comment Choisir

Lors de la sélection d'une bibliothèque ou d'un framework d'IA, tenez compte des besoins spécifiques du projet. Les facteurs clés incluent la richesse de l'écosystème et le soutien de la communauté, l'équilibre entre la facilité d'utilisation (API de haut niveau) et la flexibilité (contrôle de bas niveau), la robustesse de ses outils de déploiement en production et le support du langage de programmation principal (par ex. Python, C++, JavaScript).

Bibliothèques et Frameworks use cases

1

Développer un Modèle de Reconnaissance d'Image Personnalisé

Un ingénieur en apprentissage automatique dans une entreprise de commerce électronique doit construire un système pour catégoriser automatiquement les nouvelles images de produits. En utilisant un framework d'apprentissage profond comme TensorFlow ou PyTorch, l'ingénieur peut s'appuyer sur un Réseau de Neurones Convolutif (CNN) pré-entraîné comme base. Il affine ensuite ce modèle sur l'ensemble de données de produits spécifiques de l'entreprise. Les utilitaires de chargement de données du framework traitent efficacement des milliers d'images, et ses capacités d'accélération GPU réduisent le temps d'entraînement de plusieurs semaines à quelques jours seulement, aboutissant à un modèle de catégorisation de haute précision prêt pour la production.

2

Créer un Chatbot de Service Client Sensible au Contexte

Un développeur est chargé de créer un chatbot pour le portail de support d'une entreprise SaaS. Au lieu de construire un modèle de langage à partir de zéro, il utilise une bibliothèque comme Hugging Face Transformers. Cela donne accès à de puissants modèles pré-entraînés comme BERT ou GPT. Le développeur peut affiner l'un de ces modèles sur la base de connaissances de l'entreprise et les anciens tickets de support. Le framework gère la logique complexe de tokenisation et d'inférence du modèle, permettant au développeur de se concentrer sur la logique métier et l'interface utilisateur de l'application, livrant ainsi un chatbot utile et sensible au contexte en une fraction du temps.

3

Créer un Système d'Analyse Prédictive pour la Prévision des Ventes

Un scientifique des données souhaite prédire les futures tendances des ventes pour une chaîne de vente au détail. Il utilise une bibliothèque comme scikit-learn, qui offre une large gamme d'algorithmes d'apprentissage automatique classiques. Il peut rapidement expérimenter différents modèles tels que la Régression Linéaire, la Forêt Aléatoire ou le Gradient Boosting sur les données de ventes historiques. La bibliothèque fournit des outils pour le prétraitement des données, l'ingénierie des fonctionnalités et l'évaluation des modèles. Cela permet au scientifique des données d'itérer rapidement et d'identifier le modèle le plus performant, fournissant des prévisions de ventes trimestrielles précises aux parties prenantes de l'entreprise sans avoir à implémenter les algorithmes manuellement.

4

Accélérer la Recherche et le Prototypage en IA

Un chercheur en IA dans une université développe une nouvelle architecture de réseau de neurones. L'utilisation d'un framework flexible comme JAX ou PyTorch permet un prototypage rapide. Au lieu d'écrire un code complexe de calcul de gradient, il peut définir la passe avant du modèle, et la différenciation automatique du framework s'occupe du reste. Cela lui permet de tester de nouvelles idées, de modifier des architectures et de mener des expériences en quelques heures au lieu de semaines. L'intégration transparente du framework avec les bibliothèques de calcul scientifique rationalise davantage le processus de recherche, accélérant le chemin vers la publication et la découverte.

5

Déployer des Modèles d'IA sur des Appareils en Périphérie (Edge)

Un développeur IoT doit exécuter un modèle de détection d'objets en temps réel sur une caméra intelligente à faible consommation. Un grand modèle entraîné avec un framework standard serait trop lent et gourmand en ressources. Il utilise une bibliothèque spécialisée comme TensorFlow Lite ou ONNX Runtime pour convertir et optimiser le modèle entraîné. Ces outils appliquent des techniques comme la quantification (réduction de la précision numérique) et l'élagage pour créer un modèle plus petit et plus rapide. Le modèle léger qui en résulte peut être déployé directement sur le matériel de la caméra, permettant une inférence sur l'appareil avec une faible latence et sans nécessiter une connectivité cloud constante.

6

Entraîner un Modèle de Langage Distribué à Grande Échelle

Un laboratoire de recherche en IA vise à entraîner un modèle de fondation avec des centaines de milliards de paramètres. Entraîner un tel modèle sur une seule machine est impossible. L'équipe utilise un framework comme PyTorch combiné à une bibliothèque d'entraînement distribué comme DeepSpeed. Ces bibliothèques automatisent le processus complexe de division du modèle et des données sur des centaines ou des milliers de GPU dans un cluster. Elles gèrent des défis tels que l'optimisation de la mémoire, la communication efficace entre les nœuds et la tolérance aux pannes. Cela permet à l'équipe d'entraîner avec succès un modèle de pointe qui serait autrement infaisable sur le plan informatique.

Bibliothèques et Frameworks FAQ

Que sont les Bibliothèques et Frameworks d'IA ?

Les Bibliothèques et Frameworks d'IA sont des collections de code pré-écrit et d'outils qui simplifient et accélèrent le développement d'applications d'IA. Une bibliothèque offre généralement des fonctions spécifiques (par ex., scikit-learn pour les algorithmes classiques), tandis qu'un framework fournit une structure complète pour la construction et l'entraînement de modèles (par ex., TensorFlow, PyTorch). Ils gèrent des tâches sous-jacentes complexes comme les calculs mathématiques, l'optimisation matérielle et la différenciation automatique, permettant aux développeurs de se concentrer sur l'architecture du modèle et la logique de l'application plutôt que sur les détails d'implémentation de bas niveau.

Comment choisir le bon framework d'IA ?

Le choix du bon framework dépend des besoins de votre projet. Considérez ces facteurs :

  • Écosystème : Des frameworks comme TensorFlow et PyTorch ont de vastes écosystèmes avec une documentation complète, des tutoriels et des outils tiers pour la visualisation, le déploiement, etc.
  • Facilité d'utilisation vs Flexibilité : Les API de haut niveau comme Keras (qui fait partie de TensorFlow) sont plus faciles pour les débutants, tandis que des frameworks comme PyTorch offrent un contrôle plus granulaire, souvent préféré par les chercheurs.
  • Prêt pour la production : Évaluez les outils disponibles pour déployer des modèles en production. TensorFlow Serving et TorchServe sont des options robustes pour le déploiement côté serveur, tandis que TensorFlow Lite est idéal pour les appareils mobiles et en périphérie.
  • Support communautaire : Une communauté large et active signifie que vous pouvez facilement trouver des solutions aux problèmes et rester à jour avec les derniers développements.
Quelle est la différence entre une bibliothèque et un framework d'IA ?

La principale différence réside dans le concept d'"inversion de contrôle". Avec une bibliothèque, votre code a le contrôle et vous appelez des fonctions de la bibliothèque lorsque vous en avez besoin (par ex., appeler un algorithme spécifique de scikit-learn). Avec un framework, c'est le framework qui a le contrôle. Il fournit une structure et appelle votre code personnalisé à des points spécifiques (par ex., le graphe d'exécution de TensorFlow appelle la définition de votre modèle). En pratique, les lignes sont souvent floues en IA. Des frameworks comme PyTorch peuvent être utilisés de manière plus impérative, à la manière d'une bibliothèque, mais ils fournissent tout de même un écosystème complet pour l'ensemble du cycle de vie de l'apprentissage automatique.

Ai-je besoin de solides compétences en mathématiques pour utiliser les bibliothèques d'IA ?

Bien qu'une compréhension approfondie des mathématiques (algèbre linéaire, calcul, probabilités) soit cruciale pour développer de nouveaux algorithmes d'IA, ce n'est pas une condition préalable stricte pour *utiliser* les bibliothèques et frameworks existants. Ces outils abstraient la plupart des mathématiques complexes. Pour les rôles axés sur l'application, une compréhension conceptuelle du fonctionnement des modèles est plus importante que la capacité à implémenter les équations sous-jacentes à partir de zéro. Cependant, une base solide en mathématiques vous aidera à déboguer les modèles plus efficacement, à comprendre leurs limites et à choisir les bonnes architectures pour votre problème.

Les Bibliothèques et Frameworks d'IA sont-ils uniquement pour Python ?

Bien que Python soit le langage le plus dominant dans la communauté IA/ML en raison de sa simplicité et de son vaste écosystème, de nombreux frameworks majeurs ne s'y limitent pas. La plupart des moteurs principaux (comme le backend de TensorFlow et PyTorch) sont écrits dans des langages à haute performance comme le C++. Ils fournissent des API Python pour la facilité d'utilisation, mais offrent également des API pour d'autres langages :

  • C++ : Pour l'inférence à haute performance dans les environnements de production.
  • JavaScript : Pour exécuter des modèles directement dans le navigateur ou sur des serveurs Node.js (par ex., TensorFlow.js).
  • Java/Swift : Pour déployer des modèles sur des appareils mobiles Android et iOS.

Ainsi, bien que le développement et la recherche soient principalement basés sur Python, le déploiement implique souvent d'autres langages.