
ToolMage
Connexion

Best 1 Évaluation LLM AI tools for Outils pour développeurs

Popular Évaluation LLM AI tools in Outils pour développeurs include Cleanlab Chat, helping you work more efficiently.

Cleanlab Chat
Freemium

Cleanlab Chat

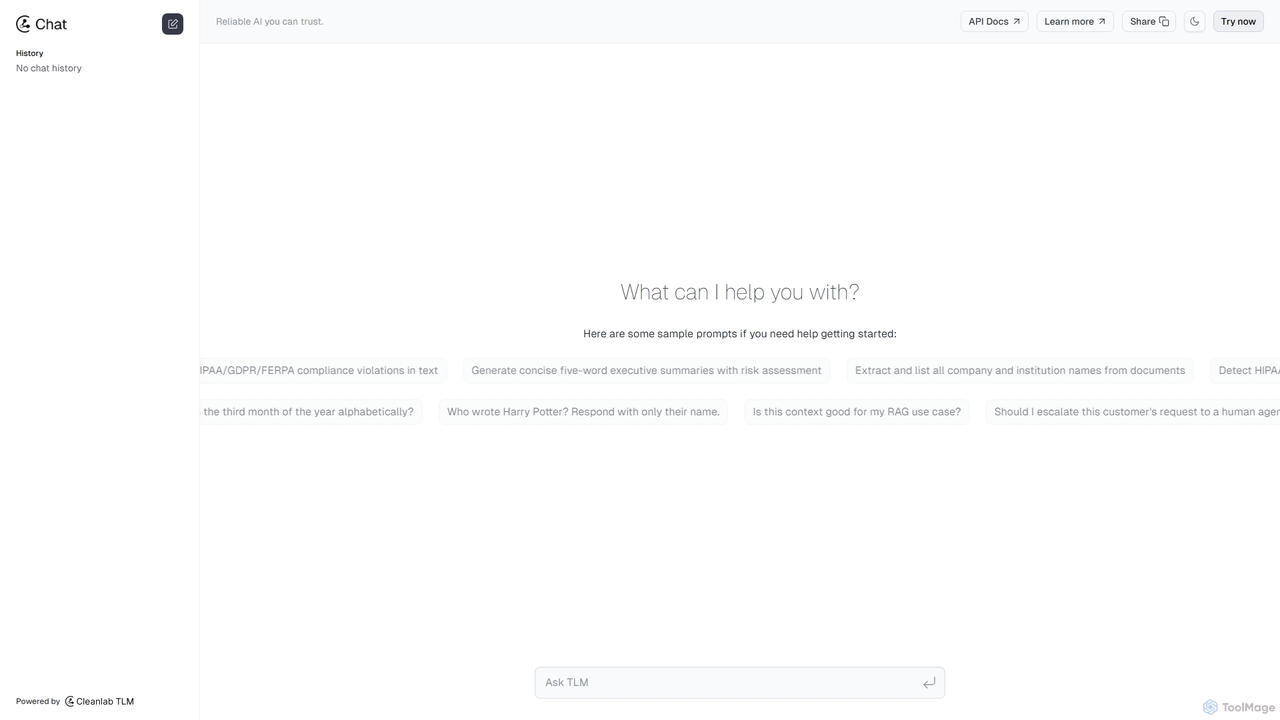
Cleanlab Chat est une interface de chat IA avancée, alimentée par le Modèle de Langage de Confiance (TLM) de Cleanlab. Elle est conçue pour des tâches de niveau entreprise, incluant l'évaluation de systèmes RAG, la détection d'hallucinations, la vérification de la conformité des données (HIPAA, RGPD) et l'analyse de texte fiable, garantissant précision et sécurité dans les applications professionnelles.

Évaluation LLM
Visits 6.6KFavorites 170Likes 163

About Évaluation LLM

Les outils d'Évaluation LLM sont une catégorie spécialisée d'utilitaires pour développeurs conçus pour mesurer, analyser et comparer systématiquement les performances des Grands Modèles de Langage (LLM). Ces plateformes fournissent des cadres pour exécuter des benchmarks standardisés, calculer des métriques clés et mener des évaluations qualitatives afin de garantir la fiabilité, la précision et la sécurité des modèles. Ils sont essentiels pour que les développeurs et les organisations valident le comportement des modèles avant le déploiement, surveillent les performances en production et prennent des décisions basées sur les données lors de la sélection ou de l'ajustement des modèles. Ce processus aide à identifier les faiblesses, les biais et les risques potentiels associés aux sorties des LLM.

Fonctionnalités Clés

  • Benchmarking Automatisé : Exécutez des modèles sur des ensembles de données académiques et industriels standards (par ex., MMLU, HellaSwag) pour obtenir des scores de performance comparables.
  • Calcul de Métriques : Calculez automatiquement des métriques quantitatives telles que la précision, la perplexité, les scores BLEU/ROUGE, les niveaux de toxicité et les indicateurs de biais.
  • Évaluation avec Intervention Humaine (HITL) : Fournissez des interfaces permettant aux évaluateurs humains de noter, classer ou comparer les sorties des modèles côte à côte pour une analyse qualitative.
  • Tests Adversariaux et Red Teaming : Sondez systématiquement les modèles à la recherche de vulnérabilités, de failles de sécurité et de comportements inattendus en générant des entrées difficiles ou malveillantes.
  • Suivi des Performances et des Coûts : Surveillez les métriques opérationnelles comme la latence, le débit et les coûts d'API pendant le processus d'évaluation pour évaluer la préparation à la production.

Cas d'Utilisation

Les outils d'Évaluation LLM sont cruciaux tout au long du cycle de vie du développement de l'IA. Ils sont utilisés par les ingénieurs ML pour les tests de régression après l'ajustement d'un modèle, par les équipes de sécurité de l'IA pour auditer les biais et la toxicité avant une sortie publique, et par les chefs de produit pour comparer différents modèles tiers (comme GPT vs Claude) pour une application spécifique. Ces outils sont également vitaux pour la surveillance continue afin de détecter la dégradation des performances ou la dérive du modèle dans les applications en direct.

Comment Choisir

Lors de la sélection d'un outil d'Évaluation LLM, tenez compte de sa prise en charge de divers modèles (API propriétaires et open-source), de l'étendue de ses benchmarks et métriques intégrés, et de sa flexibilité pour définir des ensembles de données et des critères d'évaluation personnalisés. Évaluez également ses capacités d'intégration avec les pipelines MLOps (comme CI/CD), ses fonctionnalités pour le feedback humain collaboratif et sa capacité à gérer des tests à grande échelle. Le modèle de tarification — qu'il soit basé sur l'utilisation, le nombre d'utilisateurs ou les fonctionnalités — est un autre facteur important.

Évaluation LLM use cases

1

Sélection du meilleur LLM pour un chatbot de service client

Une équipe produit d'une entreprise de commerce électronique doit choisir le LLM le plus adapté pour son nouvel agent de service client IA. Ils utilisent une plateforme d'évaluation de LLM pour comparer trois candidats : GPT-4o, Claude 3 Opus et un modèle Llama 3 affiné. L'équipe crée un ensemble de données d'évaluation personnalisé de 1 000 requêtes clients réelles, couvrant des sujets tels que le suivi des commandes, les retours et les questions sur les produits. L'outil automatise le processus d'exécution de chaque requête sur les trois modèles et calcule des métriques de précision, d'utilité et de respect du ton souhaité par l'entreprise. Des évaluateurs humains utilisent ensuite l'interface de comparaison côte à côte de la plateforme pour noter les réponses sur des qualités nuancées, menant à une décision étayée par des données.

2

Automatisation des tests de régression pour les mises à jour de modèles

Une entreprise de logiciels d'entreprise affine son modèle propriétaire de génération de code trimestriellement avec de nouvelles données. Pour éviter la dégradation des performances, leur équipe MLOps intègre un outil d'évaluation de LLM dans leur pipeline CI/CD. Après chaque exécution d'affinage, le pipeline déclenche automatiquement une tâche d'évaluation. Cette tâche exécute le modèle mis à jour sur un 'ensemble de données de référence' de 500 défis de programmation complexes avec des solutions optimales connues. L'outil mesure la correction du code, l'efficacité et le respect des guides de style. Si une métrique clé tombe en dessous d'un seuil prédéfini, la construction échoue et l'équipe est alertée, empêchant le déploiement d'un modèle défectueux en production.

3

Réalisation d'audits de sécurité et de biais de l'IA

Une entreprise de services financiers développe un LLM pour aider à résumer des documents réglementaires. Avant le déploiement, leur équipe de conformité et de sécurité de l'IA utilise un outil d'évaluation pour mener un audit approfondi. Ils utilisent les fonctionnalités de red teaming de l'outil pour générer des invites adverses conçues pour tester les biais liés aux caractéristiques protégées (par ex., âge, sexe) et pour sonder les vulnérabilités de sécurité, telles que les attaques par injection de prompt. La plateforme signale automatiquement les réponses toxiques, biaisées ou non conformes et génère un rapport détaillé. Cela permet à l'équipe de développement d'identifier et d'atténuer les risques de sécurité critiques avant que le modèle ne soit utilisé en interne.

4

Comparaison des stratégies d'ingénierie de prompt

Une équipe marketing utilise un LLM pour générer des textes publicitaires pour les réseaux sociaux. Pour trouver la structure de prompt la plus efficace, ils utilisent un outil d'évaluation pour tester A/B différentes techniques de prompting, telles que le zero-shot, le few-shot et la chaîne de pensée. Ils créent une suite de tests avec 100 descriptions de produits différentes. L'outil exécute chaque description via le LLM en utilisant cinq modèles de prompt différents. Les sorties sont ensuite notées automatiquement par rapport à une grille d'évaluation pour la créativité, la clarté et la cohérence de la voix de la marque. Cette approche systématique permet à l'équipe d'identifier le modèle de prompt qui produit de manière constante le texte de la plus haute qualité, optimisant ainsi leur flux de travail de création de contenu.

5

Surveillance des modèles de production pour la dérive de performance

Une entreprise de technologie juridique utilise un LLM pour alimenter une fonctionnalité de résumé de documents. Pour garantir que sa qualité reste élevée dans le temps, ils emploient un outil d'évaluation pour une surveillance continue. L'outil est configuré pour échantillonner 1% de toutes les requêtes de production et leurs résumés correspondants quotidiennement. Il calcule automatiquement les métriques ROUGE et BERTScore en comparant la sortie du LLM à un résumé de référence (lorsqu'il est disponible) ou à d'autres heuristiques. Un tableau de bord visualise ces métriques au fil du temps. Si le score ROUGE moyen baisse de plus de 5% en une semaine, une alerte est envoyée à l'équipe d'ingénierie, signalant une dérive potentielle du modèle et incitant à une enquête ou à un cycle de réentraînement.

6

Optimisation des coûts et de la latence dans les applications en temps réel

Un développeur construit une fonctionnalité de traduction en temps réel pour une application mobile et doit équilibrer la qualité, la vitesse et le coût. Il utilise un outil d'évaluation de LLM pour comparer un grand modèle de haute qualité (comme GPT-4) à un modèle plus petit, plus rapide et moins cher (comme un modèle open-source distillé). Il exécute une suite de tests de 2 000 phrases courantes sur les deux modèles. L'outil d'évaluation enregistre non seulement la précision de la traduction (en utilisant les scores BLEU), mais aussi la latence moyenne et le coût de l'API pour chaque modèle. Le rapport qui en résulte fournit une analyse claire des compromis, permettant au développeur de choisir le modèle qui atteint le seuil de qualité minimum pour ses utilisateurs tout en respectant les objectifs de budget et de latence.

Évaluation LLM FAQ

Que sont les outils d'Évaluation LLM ?

Les outils d'Évaluation LLM sont des plateformes logicielles spécialisées qui aident les développeurs, les chercheurs et les organisations à mesurer systématiquement les performances et la sécurité des Grands Modèles de Langage. Ils fournissent des cadres pour automatiser les tests, comparer différents modèles ou prompts, et analyser les sorties par rapport à des métriques définies. Leurs fonctions clés incluent l'exécution de benchmarks, le calcul de scores de précision et de fluidité, la détection de biais et de toxicité, et la facilitation du feedback humain. Ces outils sont essentiels pour garantir que les applications basées sur les LLM sont fiables, efficaces et sûres avant et après leur déploiement.

Comment choisir le bon outil d'Évaluation LLM ?

Le choix du bon outil dépend de vos besoins spécifiques. Considérez les facteurs suivants :

  • Support des Modèles : L'outil prend-il en charge les LLM que vous utilisez (par ex., OpenAI, Anthropic, modèles open-source comme Llama) ?
  • Métriques et Benchmarks : Offre-t-il les benchmarks et métriques standards pertinents pour votre cas d'utilisation (par ex., ROUGE pour le résumé, correction du code pour la génération) ?
  • Personnalisation : Pouvez-vous facilement télécharger vos propres ensembles de données privés et définir une logique ou des métriques d'évaluation personnalisées ?
  • Intégration : S'intègre-t-il bien à votre flux de travail MLOps existant, comme les pipelines CI/CD pour les tests automatisés ?
  • Fonctionnalités de Collaboration : Fournit-il une bonne interface utilisateur pour que les évaluateurs humains puissent donner un feedback qualitatif ?
  • Évolutivité et Coût : Peut-il gérer le volume d'évaluations dont vous avez besoin, et son modèle de tarification correspond-il à votre budget ?
Quelle est la différence entre l'évaluation automatisée et l'évaluation humaine pour les LLM ?

L'évaluation automatisée et l'évaluation humaine sont deux méthodes complémentaires pour évaluer les LLM. L'évaluation automatisée utilise des métriques calculables (comme BLEU, ROUGE, précision) pour noter rapidement les sorties du modèle par rapport à un ensemble de données de référence à grande échelle. C'est rapide, peu coûteux et objectif pour des tâches spécifiques. D'un autre côté, l'évaluation humaine implique que des personnes notent ou comparent les sorties du modèle en fonction de qualités subjectives comme la créativité, la cohérence, l'utilité ou le ton. Bien que plus lente et plus coûteuse, c'est la référence absolue pour capturer les aspects nuancés du langage que les métriques automatisées manquent souvent. La plupart des stratégies d'évaluation robustes utilisent des méthodes automatisées pour des tests rapides et larges, et le feedback humain pour une validation plus approfondie et qualitative.

Quelles sont les métriques couramment utilisées dans l'Évaluation LLM ?

Les métriques utilisées dépendent fortement de la tâche. Cependant, certaines des plus courantes incluent :

  • Précision (Accuracy) : Pour les tâches de classification ou de questions-réponses, mesure le pourcentage de prédictions correctes.
  • Perplexité (Perplexity) : Mesure à quel point un modèle de probabilité prédit bien un échantillon. Une perplexité plus faible indique généralement un meilleur modèle.
  • BLEU/ROUGE : Couramment utilisés pour la traduction et le résumé, ils comparent le chevauchement des n-grammes entre la sortie du modèle et un texte de référence.
  • Scores de Toxicité/Biais : Des classifieurs spécialisés sont utilisés pour noter les sorties pour le contenu préjudiciable, les stéréotypes ou d'autres biais.
  • Latence et Coût : Métriques opérationnelles qui mesurent le temps de réponse du modèle et le coût financier par inférence, cruciales pour les applications du monde réel.
Pourquoi l'évaluation continue des LLM en production est-elle importante ?

L'évaluation continue est cruciale car les performances d'un LLM ne sont pas statiques. Elles peuvent se dégrader avec le temps en raison d'un phénomène appelé 'dérive du modèle' (model drift), où les schémas des données d'entrée du monde réel changent et ne correspondent plus aux données sur lesquelles le modèle a été entraîné. Par exemple, un bot de service client pourrait rencontrer de nouveaux types de requêtes qu'il n'a pas été entraîné à gérer. La surveillance continue des métriques clés permet aux équipes de détecter cette dégradation des performances à un stade précoce, d'en identifier la cause (par ex., nouveaux sujets, changement de langage des utilisateurs) et de déclencher les actions nécessaires comme le réentraînement du modèle ou la mise à jour des prompts. Cela garantit que l'application reste fiable et efficace pour les utilisateurs longtemps après son lancement initial.