
Freemium
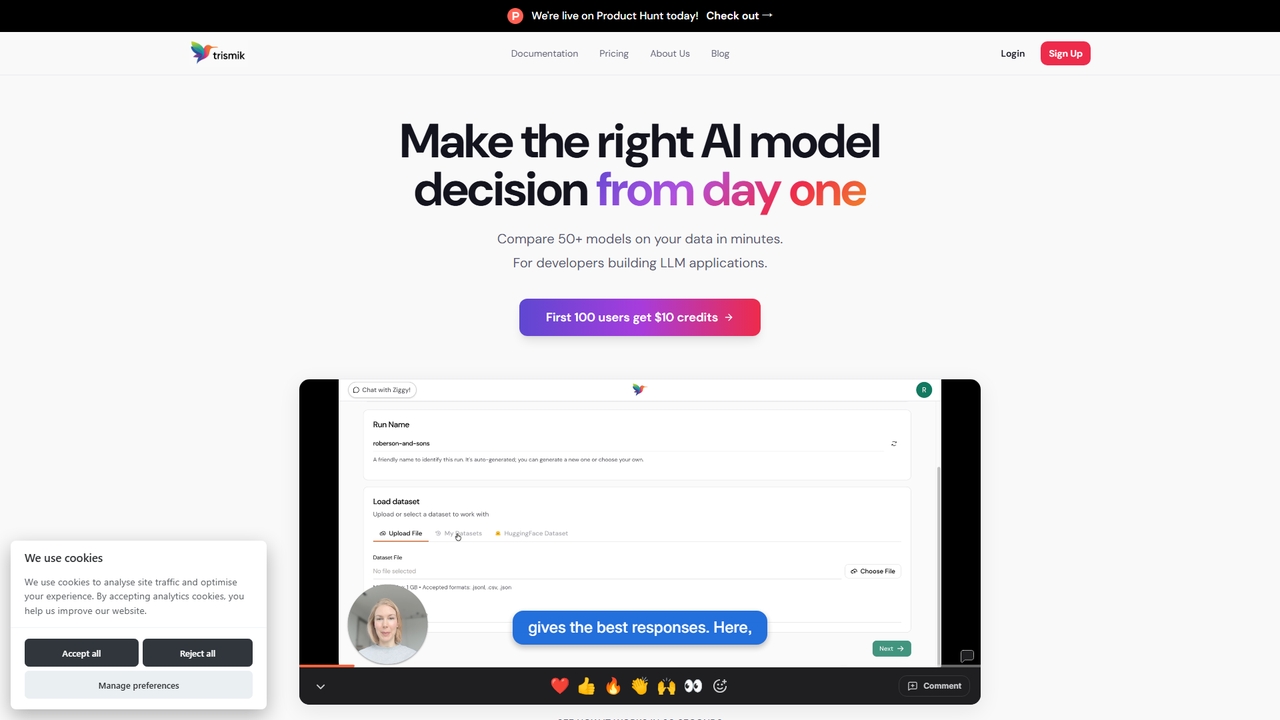
Trismik
Comparez plus de 50 LLM sur vos propres données en quelques minutes. Prenez des décisions de modèle fondées sur des preuves concernant la qualité, le coût et la vitesse.
Ai Model SelectionVisits 9.6KFavorites 50Likes 49
Popular Comparaison de Modèles AI tools in Outils pour développeurs include Trismik, Compare AI Models et Joythee AI, helping you work more efficiently.
Comparez plus de 50 LLM sur vos propres données en quelques minutes. Prenez des décisions de modèle fondées sur des preuves concernant la qualité, le coût et la vitesse.
Ai Model Selection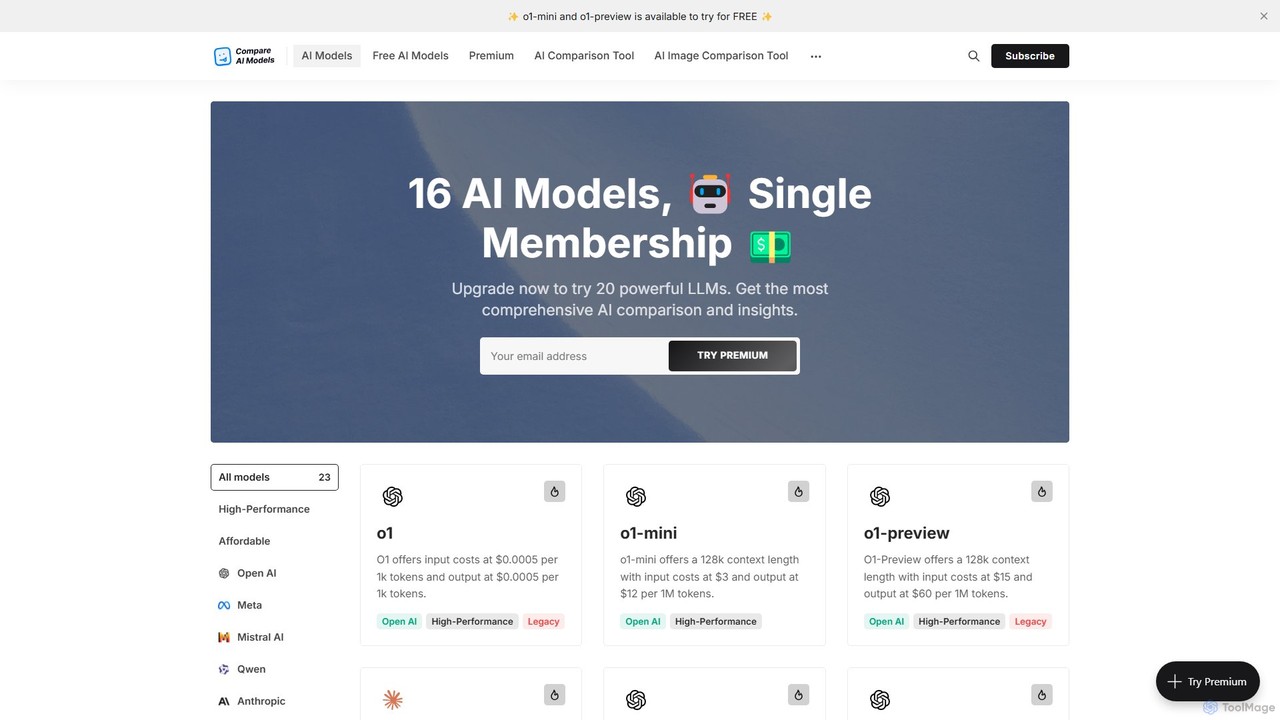
Une plateforme complète pour comparer plus de 20 des principaux grands modèles de langage (LLM). Elle offre des métriques détaillées sur les performances, la tarification des API, les fenêtres de contexte et les fonctionnalités, ainsi qu'un chat gratuit pour tester les modèles directement. Un outil essentiel pour les développeurs, les chercheurs et les entreprises pour trouver l'IA parfaite pour leurs besoins.
Annuaire LLM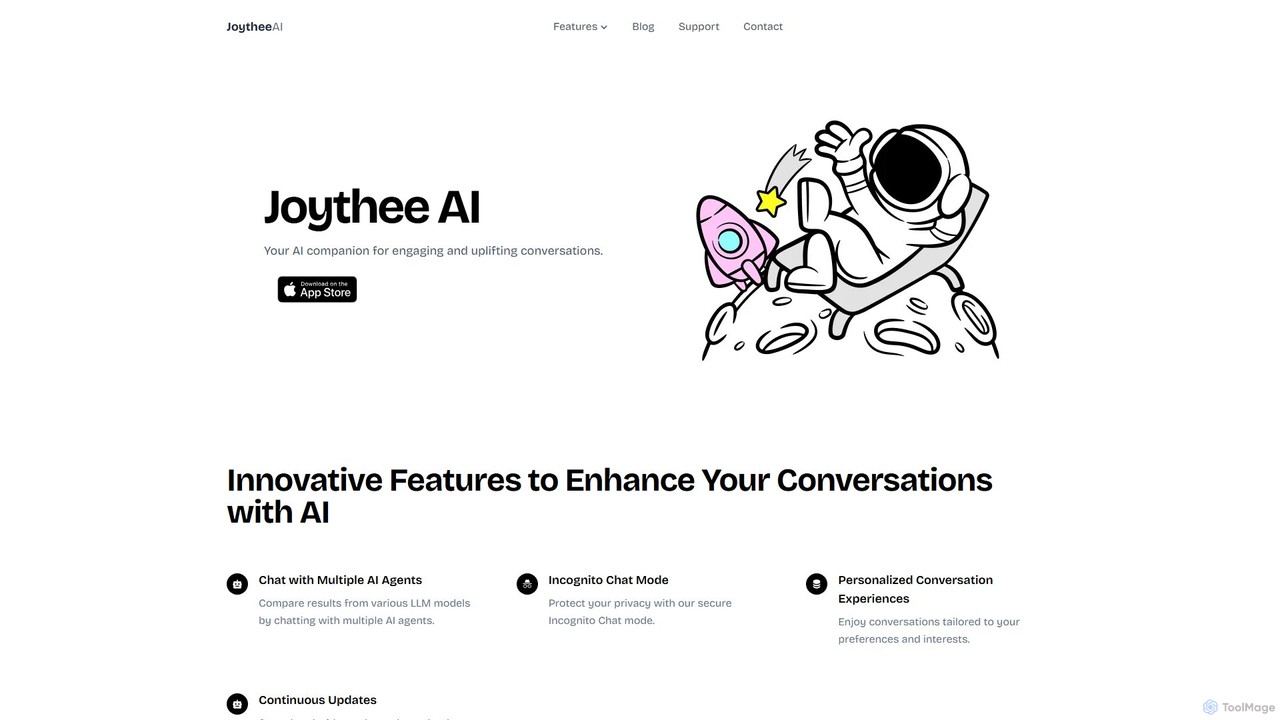
Joythee AI est une plateforme d'IA conversationnelle avancée qui vous permet de discuter avec plusieurs agents d'IA simultanément. Comparez les réponses de divers LLM dans une seule interface, profitez de conversations personnalisées et protégez votre vie privée avec un mode incognito. Idéal pour les particuliers, les équipes et les entreprises cherchant à améliorer leur productivité et leur créativité.
Comparaison de ModèlesLes outils de Comparaison de Modèles sont des plateformes spécialisées au sein de la boîte à outils des développeurs, conçues pour évaluer, benchmarker et comparer systématiquement les performances de différents modèles d'IA. Ces outils fournissent un environnement structuré pour exécuter des modèles tels que les LLM ou les générateurs d'images sur les mêmes entrées et jeux de données afin de mesurer leurs résultats de manière objective. Ils sont essentiels pour prendre des décisions basées sur les données, permettant aux développeurs et aux chercheurs de sélectionner le modèle le plus précis, le plus rentable et le plus efficace pour une application spécifique. En offrant une analyse comparative et des métriques quantitatives, ils rationalisent le processus de sélection de modèles, autrement complexe et chronophage.
Ces outils sont essentiels pour les développeurs d'IA, les ingénieurs MLOps et les chefs de produit tout au long du cycle de vie de développement et de maintenance. Ils sont utilisés lors de la sélection d'un modèle de base pour une nouvelle fonctionnalité, de l'évaluation de l'impact du fine-tuning ou de la réalisation de tests de régression après une mise à jour du modèle. Par exemple, une équipe construisant un chatbot de service client utiliserait ces outils pour comparer les capacités conversationnelles et les coûts des modèles d'OpenAI, d'Anthropic et de Google avant de s'engager.
Lors de la sélection d'un outil de Comparaison de Modèles, tenez compte de l'éventail des modèles pris en charge, y compris les API propriétaires et les options open-source. Évaluez les suites de benchmarks disponibles et la flexibilité pour créer des jeux de données d'évaluation personnalisés. Analysez ses capacités d'intégration avec votre flux de travail MLOps et vos pipelines CI/CD existants. Enfin, considérez les fonctionnalités de collaboration qui permettent aux membres de l'équipe d'examiner les résultats et les modèles de tarification qui s'adaptent à vos besoins d'évaluation.
Une équipe produit développe un nouveau chatbot de support client alimenté par l'IA. Ils utilisent un outil de comparaison de modèles pour évaluer GPT-4, Claude 3 Sonnet et Llama 3 70B. Ils créent un 'jeu de données de référence' de 100 requêtes clients courantes et testent les trois modèles avec. La plateforme offre une vue comparative des réponses, ainsi que des métriques automatisées sur l'utilité et le ton. Elle calcule également le coût moyen pour 1 000 conversations pour chaque modèle. Sur la base des résultats, ils choisissent Claude 3 Sonnet car il offre le meilleur équilibre entre la qualité conversationnelle et le coût opérationnel pour leur cas d'utilisation spécifique.
Un ingénieur ML a affiné un modèle open-source Mistral 7B sur des documents internes de l'entreprise pour une tâche de questions-réponses. Pour justifier le déploiement, il utilise un outil de comparaison pour benchmarker le modèle affiné par rapport au modèle de base Mistral 7B et à un modèle propriétaire comme GPT-4. Il télécharge un jeu de test de 50 questions techniques. L'outil mesure l'exactitude factuelle et la pertinence. Les résultats montrent que son modèle affiné surpasse le modèle de base de 30% en précision et est 10 fois moins cher que GPT-4, fournissant une preuve claire pour procéder au déploiement.
Une équipe MLOps gère une fonctionnalité de résumé qui dépend d'une API de modèle externe. Le fournisseur de l'API annonce une nouvelle version. Avant de basculer, l'équipe utilise une plateforme de comparaison de modèles pour exécuter sa suite de 500 documents de test sur les anciennes et nouvelles versions de l'API. La plateforme signale automatiquement tout résumé de la nouvelle version qui est significativement plus court, moins cohérent ou factuellement incorrect par rapport à la sortie de l'ancienne version. Ce test de régression automatisé empêche une dégradation de la qualité du service et assure une transition en douceur vers le modèle mis à jour.
Une agence de marketing doit sélectionner un modèle de génération d'images pour créer des visuels publicitaires. Ils utilisent un outil de comparaison pour tester DALL-E 3, Midjourney et Stable Diffusion avec 20 prompts différents liés aux produits de leur client. L'outil permet à leur équipe créative de noter chaque image générée sur une échelle de 1 à 5 pour l'adhérence au prompt, la qualité esthétique et l'alignement avec la marque. Les scores agrégés révèlent que si Midjourney produit les images les plus esthétiques, DALL-E 3 est supérieur pour incorporer avec précision les détails spécifiques du produit mentionnés dans les prompts, ce qui en fait le meilleur choix pour leurs besoins.
Un service d'agrégation de nouvelles utilise un LLM pour résumer des articles. Pour réduire les coûts, ils veulent trouver le modèle le moins cher qui maintient la qualité. À l'aide d'un outil de comparaison, ils testent cinq modèles différents, du haut de gamme GPT-4 aux alternatives open-source plus petites. Ils traitent 1 000 articles avec chacun et utilisent des scores ROUGE automatisés pour mesurer la qualité du résumé, tandis que l'outil suit le coût de chaque modèle. Ils découvrent qu'une version quantifiée d'un modèle Llama 3 8B fournit 95% de la qualité de GPT-4 pour seulement 10% du coût, ce qui entraîne des économies mensuelles significatives.
Un ingénieur de prompts est chargé de créer le prompt le plus efficace pour une fonctionnalité de génération de code. Au lieu de tester les prompts un par un, il utilise un outil de comparaison de modèles pour mettre en place une expérience matricielle. Il saisit trois variations de prompts différentes et les teste sur quatre modèles (par ex., GPT-4, Claude 3 Opus, Gemini Pro et un modèle de code spécialisé). La plateforme exécute les 12 combinaisons et présente les résultats dans une carte thermique, montrant quelle paire prompt-modèle produit le code le plus précis et efficace. Cela accélère le processus d'optimisation des prompts par dix.
Les outils de Comparaison de Modèles d'IA sont des plateformes logicielles spécialisées qui permettent aux développeurs et aux chercheurs d'évaluer et de benchmarker systématiquement plusieurs modèles d'IA les uns par rapport aux autres. Au lieu de tester manuellement chaque modèle, ces outils fournissent une interface unifiée pour exécuter les mêmes prompts ou jeux de données sur différents modèles (comme GPT-4, Claude 3 et Llama 3) simultanément. Ils mesurent et affichent des métriques clés telles que la qualité de la sortie, le coût, la latence et les performances sur des tests standardisés, permettant des décisions objectives et basées sur les données lors de la sélection du meilleur modèle pour une tâche spécifique.
Le choix du bon outil dépend de vos besoins spécifiques. Considérez les facteurs suivants :
La comparaison de modèles et la surveillance de modèles sont deux étapes distinctes du cycle de vie MLOps. La comparaison de modèles est une activité de pré-déploiement. Il s'agit de sélectionner le meilleur modèle parmi un ensemble de candidats avant sa mise en production. Vous comparez les modèles sur un jeu de données de test statique pour évaluer leurs capacités fondamentales. La surveillance de modèles est une activité de post-déploiement. Elle consiste à suivre les performances d'un modèle en direct en production, en surveillant les problèmes tels que la dérive des données, la dégradation des performances ou un comportement inattendu avec les données des utilisateurs du monde réel. En bref, la comparaison vous aide à choisir le bon modèle, tandis que la surveillance garantit que le modèle choisi reste correct.
Les métriques pour comparer les modèles d'IA peuvent être divisées en deux catégories principales :
Une évaluation complète utilise un mélange des deux pour obtenir une image complète des performances d'un modèle.
Les outils de Comparaison de Modèles sont précieux pour un éventail de professionnels impliqués dans la création de produits basés sur l'IA. Les utilisateurs clés incluent :