ToolMage
Connexion

AI TOOL COMPARISON

Datafold vs nao

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

Datafold Aperçu du produit

Datafold est une plateforme alimentée par l'IA pour les équipes d'ingénierie des données qui automatise les tests de qualité des données, la surveillance et les migrations. Elle utilise la comparaison de données (data diffing) pour comparer les ensembles de données, permettant une détection proactive des problèmes en CI/CD et garantissant une parité à 100 % lors de migrations de données complexes, accélérant les délais jusqu'à 6 fois.

Preview

nao Aperçu du produit

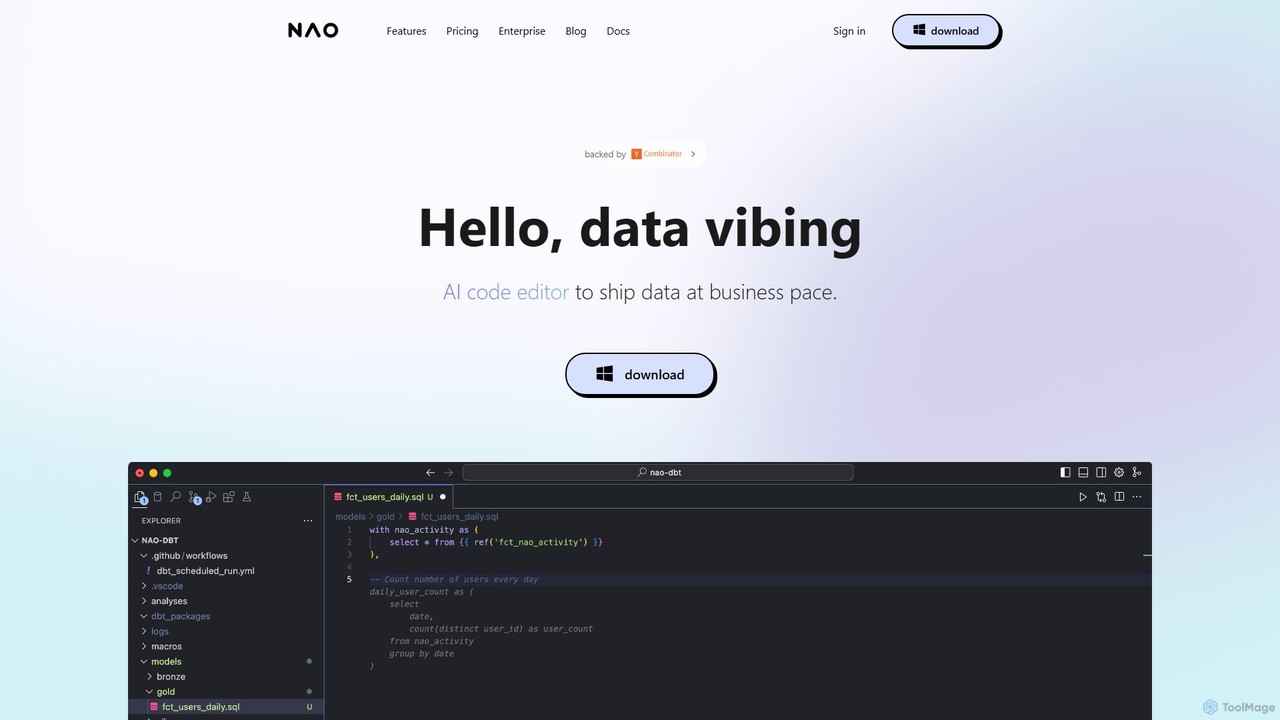
nao est un éditeur de code alimenté par l'IA conçu pour les équipes de données. Il simplifie la création de pipelines de données SQL et Python, les flux de travail dbt et l'analyse en se connectant nativement à votre entrepôt de données. Son agent intelligent fournit des suggestions de code tenant compte des données, des contrôles de qualité et des aperçus de différences instantanés pour vous aider à livrer les données plus rapidement et en toute sécurité.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Datafold VS nao — Données clés
Données clésDatafoldnao
Pricing modelPaidFreemium
Product typeWebApp
Primary focusAnalyseAnalyse
Publics et métiersNon vérifiéNon vérifié
CatégoriesAnalyse · Base de données · AutomatisationAnalyse · Base de données · Assistant de Code
Added11 août 20255 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Datafold

Datafold est une plateforme unifiée pour une qualité de données proactive, spécialement conçue pour renforcer les équipes d'ingénierie des données. Elle s'attaque aux aspects les plus critiques et les plus difficiles des flux de travail de données modernes : garantir l'intégrité absolue des données et rationaliser la modernisation de l'infrastructure de données. En exploitant la puissance de l'IA, des grands modèles de langage (LLM) avancés et de sa technologie propriétaire de "comparaison de données" (data diffing), Datafold automatise les tâches les plus sujettes aux erreurs et les plus chronophages. Cela permet aux équipes de créer des produits de données hautement fiables à un rythme beaucoup plus rapide.

La plateforme est fondée sur le principe que la qualité des données doit être une partie proactive et intégrante du cycle de vie du développement, et non une réflexion après coup réactive. Elle fournit les outils nécessaires aux entreprises pour dépasser les limites des systèmes hérités et construire en toute confiance une pile de données prête pour l'IA avec une vitesse et une précision inégalées.

Comment utiliser Datafold

Datafold s'intègre de manière transparente dans les flux de travail d'ingénierie des données existants, offrant une approche structurée et automatisée pour diverses tâches.

Pour les migrations de données :

  1. Planifier : Utilisez la lignée détaillée au niveau des colonnes pour cartographier toutes les dépendances de données et évaluer avec précision la complexité de la migration. Cela crée un plan directeur complet, rendant les délais du projet prévisibles et transparents.
  2. Traduire : L'Agent de Migration Datafold (DMA), piloté par l'IA, convertit automatiquement n'importe quel dialecte SQL ou logique de transformation basée sur une interface graphique dans la syntaxe du système cible (par exemple, migration d'Oracle PL/SQL vers Snowflake SQL). Il emploie une boucle de rétroaction intelligente pour affiner itérativement le code jusqu'à l'obtention d'une parité fonctionnelle parfaite.
  3. Valider : C'est là que la capacité principale de "comparaison de données" de Datafold excelle. Elle effectue une comparaison au niveau des valeurs de chaque enregistrement entre les systèmes hérité et nouveau, vérifiant automatiquement une précision des données de 100 % sans nécessiter d'échantillonnage manuel ou de scripts fastidieux.
  4. Livrer : Après une validation réussie, Datafold génère des rapports complets et des preuves de comparaison de données auditables. Cela fournit une preuve concrète de la parité des données, ce qui accélère l'approbation des parties prenantes et permet le démantèlement confiant du système hérité.

Pour les tests de qualité des données en CI/CD :

  1. Intégration : Connectez Datafold à votre système de contrôle de version, tel que GitHub ou GitLab.
  2. Tests automatisés : Lorsqu'un développeur ouvre une demande de tirage (pull request) contenant des modifications du code de transformation des données (par exemple, un modèle dbt), Datafold est automatiquement déclenché pour exécuter une comparaison de données entre les environnements de développement et de production.
  3. Examiner et déployer : Les résultats sont publiés sous forme de commentaire clair et concis dans la demande de tirage. Cela permet aux relecteurs de voir l'impact exact des modifications du code sur les données au niveau des valeurs, empêchant ainsi les problèmes de qualité des données d'atteindre la production.

Fonctionnalités principales de Datafold

  • Migration de données alimentée par l'IA (Agent de Migration Datafold - DMA) : Automatise l'ensemble du cycle de vie de la migration, de la traduction du code SQL entre des dialectes disparates à la validation complète de bout en bout. Il gère intelligemment les cas limites complexes, tels que les différences de traitement des types de données, les fonctions non déterministes et l'encodage des caractères, pour une migration jusqu'à 6 fois plus rapide.
  • Comparaison de données (Data Diffing) : Un puissant moteur de validation qui effectue des comparaisons efficaces au niveau des valeurs sur des ensembles de données entiers, même ceux contenant des milliards de lignes. Il identifie avec précision toute addition, suppression ou modification pour garantir une parité des données à 100 %.
  • Tests CI/CD proactifs : S'intègre directement dans le flux de travail de développement (test shift-left) pour tester le code de transformation des données avant le déploiement. Il inclut une analyse d'impact pour visualiser comment les changements affectent les tables en aval, les tableaux de bord de BI et les pipelines ETL inversés.
  • Surveillance et observabilité des données : Fournit une détection d'anomalies alimentée par le ML pour surveiller la santé des données en production. Les utilisateurs peuvent définir des moniteurs en tant que code (YAML) ou via l'interface utilisateur pour les métriques, les changements de schéma et les comparaisons programmées entre bases de données, avec des alertes en temps réel via Slack, PagerDuty et e-mail.
  • Lignée au niveau des colonnes : Fournit une carte complète des dépendances de données qui s'étend au-delà de l'entrepôt de données aux outils de BI (Tableau, Looker, Power BI) et à d'autres applications. C'est crucial pour l'analyse d'impact, l'analyse des causes profondes et la conformité.
  • Test de réplication des données : Valide en continu les données entre les systèmes source et cible dans les pipelines de réplication en cours, garantissant que les données critiques restent synchronisées et précises à tout moment.

Cas d'utilisation pour Datafold

  • Modernisation de la pile de données : Accélérez considérablement les migrations depuis des systèmes hérités (par exemple, Oracle, Teradata, SQL Server) vers des plateformes de données cloud modernes (par exemple, Snowflake, BigQuery, Databricks). Par exemple, Faire a migré plus de 5 000 tables de Redshift vers Snowflake six mois avant la date prévue en utilisant Datafold.
  • Développement et tests dbt : Optimisez les flux de travail dbt en testant automatiquement chaque demande de tirage, garantissant que les modifications apportées aux modèles dbt n'introduisent pas de régressions de la qualité des données.
  • Garantir la précision des tableaux de bord de BI : Utilisez la lignée au niveau des colonnes pour tracer les données de leur source jusqu'aux tableaux de bord de BI, en vous assurant que les rapports d'activité sont construits sur une base de données fiable et précise.
  • Validation des pipelines de réplication : Pour les organisations utilisant des outils d'ingestion de données comme Fivetran ou Airbyte, Datafold peut programmer des comparaisons de données régulières pour certifier que les données dans l'entrepôt de destination reflètent parfaitement la source.

Avantages de Datafold

  • Vitesse sans précédent : Réduit les délais de migration de plusieurs années à quelques semaines en automatisant les parties les plus laborieuses du processus.
  • Précision garantie : Va au-delà du simple comptage de lignes pour une validation exhaustive au niveau des valeurs, éliminant le risque de perte ou de corruption de données.
  • Augmentation de la vélocité des développeurs : Détecte les bogues de données tôt dans le pipeline CI/CD, permettant aux ingénieurs de livrer du code plus rapidement et avec plus de confiance.
  • Proactif, pas réactif : Met en œuvre une philosophie "shift-left" pour la qualité des données, prévenant les problèmes avant qu'ils ne puissent impacter les systèmes de production et les opérations commerciales.
  • Confiance et collaboration améliorées : Fournit une preuve auditable et indéniable de la qualité des données, ce qui renforce la confiance avec les parties prenantes et rationalise les approbations de projets.
  • Déploiement sécurisé et flexible : Offre plusieurs modèles de déploiement (SaaS, VPC à locataire unique, auto-hébergé) et est conforme aux principales normes telles que SOC2 Type II, GDPR et HIPAA.

Tarification et plans

Datafold propose une tarification personnalisée adaptée aux besoins uniques de chaque équipe. Le modèle de tarification est principalement basé sur le nombre d'utilisateurs et le volume de tables surveillées и testées. Bien que la plateforme soit généralement vendue comme une solution complète, des fonctionnalités spécifiques, telles que la conversion et la validation de migration unique ou la lignée au niveau des colonnes autonome, peuvent être achetées séparément. Pour obtenir un devis précis, les clients potentiels doivent contacter l'équipe de vente de Datafold en demandant une démonstration sur leur site officiel.

nao

nao est un éditeur de code IA révolutionnaire conçu dès le départ pour les professionnels des données. Il vise à accélérer l'ensemble du flux de travail des données, de l'écriture du code au déploiement des pipelines, en s'intégrant profondément à votre écosystème de données. Conçu pour les analystes de données, les ingénieurs analytiques, les scientifiques des données et les ingénieurs de données, nao agit comme un partenaire intelligent, comprenant le contexte de vos données pour vous aider à écrire un code non seulement syntaxiquement correct, mais aussi sémantiquement juste et sûr pour votre environnement de production.

Contrairement aux assistants de code IA génériques, nao se connecte directement à votre entrepôt de données (prenant en charge des plateformes comme Databricks, DuckDB, etc.). Cette intégration native permet à son IA d'être « consciente des données », fournissant des suggestions basées sur votre schéma réel, vos structures de table et vos noms de colonnes. Cela élimine les approximations et réduit considérablement les erreurs. Le cœur de nao est son puissant agent IA, qui va au-delà de la simple complétion de code pour devenir un gardien de la qualité de vos données.

Comment utiliser nao

Démarrer avec nao est un processus simple, conçu pour s'intégrer de manière transparente dans votre flux de travail existant :

  1. Télécharger et Installer : Commencez par télécharger gratuitement l'IDE nao depuis le site officiel. C'est une application autonome qui s'exécute sur votre machine locale.
  2. Connecter votre entrepôt de données : La première étape cruciale est de connecter nao à votre source de données. Cette connexion sécurisée permet à l'IA d'accéder aux métadonnées de votre schéma (pas à vos données réelles, qui restent locales) pour fournir une assistance contextuelle.
  3. Commencer à coder : Ouvrez une feuille de calcul SQL ou un script Python. Au fur et à mesure que vous tapez, l'IA de nao fournit une autocomplétion intelligente pour les requêtes SQL et les modèles dbt, consciente de vos tables et colonnes spécifiques.
  4. Tirer parti de l'agent IA : Utilisez l'onglet IA dédié pour interagir avec l'agent. Vous pouvez lui demander de générer des requêtes complexes, de créer des modèles dbt, d'écrire de la documentation ou d'ajouter des tests. L'agent comprend le contexte de votre projet, y compris les modèles dbt et le lignage au niveau de la colonne.
  5. Prévisualiser et comparer : Avant de valider toute modification, utilisez la fonction « Aperçu instantané des différences ». Cela vous montre l'impact direct que votre nouveau code aura sur les données, vous aidant à détecter les problèmes potentiels et à éviter de casser les tableaux de bord ou les rapports en aval.
  6. Exécuter les vérifications et déployer : L'agent peut exécuter des contrôles de qualité des données et vos tests existants pour valider votre code. Une fois que vous êtes confiant, vous pouvez livrer vos pipelines de données plus rapidement et avec une plus grande confiance.

Fonctionnalités principales de nao

  • Éditeur de code alimenté par l'IA : Optimisé pour SQL et Python avec autocomplétion intelligente, génération de code et capacités d'analyse conversationnelle.
  • Intégration native avec l'entrepôt de données : Se connecte directement à vos sources de données comme Databricks et DuckDB pour des suggestions d'IA tenant compte du schéma.
  • Agent IA avancé : Un agent polyvalent qui aide aux contrôles de qualité des données, aux différences de données instantanées, à l'exécution de tests et à la compréhension du lignage au niveau de la colonne.
  • Intégration profonde avec dbt : Prévisualisez les modèles dbt directement dans l'IDE, obtenez l'autocomplétion pour les colonnes du modèle et visualisez le graphique de lignage pour comprendre les dépendances.
  • Aperçu instantané des différences : Voyez l'impact de vos modifications de code sur les données en temps réel, évitant les conséquences involontaires.
  • Analyse et graphiques conversationnels : Interagissez avec vos données en utilisant le langage naturel pour générer des informations et des visualisations directement dans l'éditeur.
  • Sécurité de niveau entreprise : Vos données et votre code restent locaux. Rien n'est partagé avec un LLM sans autorisation explicite, et les plans d'entreprise offrent des options pour des LLM auto-hébergés afin de tout conserver dans votre infrastructure.
  • Environnement de développement unifié : Combine les outils que vous aimez — éditeur SQL, outil de transformation (dbt) et lignage BI — en un seul IDE cohérent.

Cas d'utilisation pour nao

nao est polyvalent et peut être appliqué à de nombreuses tâches liées aux données :

  • Développement accéléré de pipelines de données : Construisez et itérez rapidement sur des pipelines SQL et Python avec du code généré par l'IA et un retour d'information instantané.
  • Gestion robuste des flux de travail dbt : Créez, testez et documentez les modèles dbt plus efficacement. Comprenez l'impact des changements avec le lignage au niveau de la colonne et les aperçus de modèles.
  • Analyse de données complexe : Effectuez des analyses sophistiquées telles que l'analyse de distribution, de rétention, de conversion et de cause racine à l'aide de prompts conversationnels et d'outils de requête puissants.
  • Assurance qualité des données : Identifiez et corrigez de manière proactive les problèmes de qualité des données avant qu'ils n'affectent la production en utilisant les contrôles automatisés et les différences de données de l'agent.
  • Refactorisation de code sécurisée : Refactorisez en toute confiance des requêtes SQL complexes ou des modèles dbt, en utilisant l'aperçu instantané des différences pour vous assurer que le résultat reste cohérent.

Avantages de nao

nao offre des avantages significatifs par rapport aux éditeurs de code traditionnels et autres assistants IA :

  • Intelligence consciente des données : Contrairement à des outils comme Cursor, les suggestions de nao ne sont pas génériques ; elles sont adaptées à votre schéma de données spécifique, ce qui donne un code qui fonctionne correctement du premier coup.
  • Sécurité et fiabilité améliorées : L'accent mis sur les contrôles de qualité des données, les différences et l'analyse d'impact du lignage aide à prévenir les ruptures de données, protégeant vos tableaux de bord BI et vos rapports d'analyse.
  • Productivité accrue : En unifiant plusieurs outils dans un seul IDE et en automatisant les tâches répétitives, nao permet aux équipes de données de livrer les projets beaucoup plus rapidement.
  • Sécurité sans compromis : Avec un fort accent sur la confidentialité des données, nao garantit que vos données sensibles et votre code propriétaire sont sécurisés, offrant des contrôles de niveau entreprise pour une protection maximale.

Tarification et plans

nao propose une structure tarifaire flexible pour répondre à différents besoins :

  • Plan Starter : Gratuit. Ce plan comprend un essai de 15 jours des fonctionnalités Pro, une connexion de base à l'entrepôt de données, l'autocomplétion SQL, ainsi que les aperçus et le lignage dbt.
  • Plan Pro : 30 $ par utilisateur/mois. Comprend tout ce qui se trouve dans le plan Starter, plus l'onglet IA complet sur vos données, l'agent IA complet pour les flux de travail de données, la différence de données instantanée et le support direct.
  • Plan Entreprise : Tarification personnalisée. Ce plan comprend toutes les fonctionnalités Pro, plus une sécurité des données de niveau entreprise, l'option pour les LLM hébergés par l'entreprise, un espace de travail d'entreprise et une équipe de support dédiée.

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
AnalyseBase de données
Uniquement Datafold
Automatisation
Uniquement nao
Assistant de Code

Étiquettes

Commun
base de donnéesqualité des donnéesdbtSQL
Uniquement Datafold
automatisationCI/CDIngénierie des donnéesmigration de donnéesObservabilité des donnéesTest de donnéesValidation des données
Uniquement nao
Assistant IAIngénierie analytiqueÉditeur de codeanalyse de donnéesPipeline de donnéesOutils pour développeursPython

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement Datafold
Aucune donnée vérifiée
Uniquement nao
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Datafold monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
21K
Durée moyenne
1:16
Pages par visite
2.13
Taux de rebond
39.96%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 33.5K
  • 2026-01: 24.6K
  • 2026-02: 19.6K
  • 2026-03: 26.3K
  • 2026-04: 20.8K
  • 2026-05: 21K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.41%11.4K
🇻🇳Vietnam13.86%2.9K
🇮🇳India12.19%2.6K
🇹🇭Thailand10.7%2.2K
🇵🇰Pakistan8.84%1.9K

Sources de trafic

Source typePercentageEstimated visits
Direct94.33%19.8K
Référence5.67%1.2K

Mots-clés

data-diffdatafolddbt pythonnutrafol revenueopen source data warehouse

nao monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
19.1K
Durée moyenne
0:22
Pages par visite
1.73
Taux de rebond
40.34%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 4K
  • 2026-01: 17.9K
  • 2026-02: 24.2K
  • 2026-03: 22.6K
  • 2026-04: 17.3K
  • 2026-05: 19.1K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.42%10.4K
🇮🇳India18.31%3.5K
🇫🇷France10.18%1.9K
🇩🇪Germany9.04%1.7K
🇧🇷Brazil8.05%1.5K

Sources de trafic

Source typePercentageEstimated visits
Direct57.37%11K
Référence42.63%8.1K

Mots-clés

naonao datanao idenao labnao labs

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

Datafold

Note
Non vérifié
Commentaires
0
Favoris
183
J’aime
182

nao

Note
Non vérifié
Commentaires
0
Favoris
169
J’aime
148

Datafold vs nao · FAQ comparative

What do Datafold and nao have in common?
Both tools are listed under Analyse、Base de données. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Datafold and nao free?
Listed pricing models: Datafold — Paid; nao — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Datafold and nao?
The primary listed category is Analyse for Datafold, and Analyse for nao. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés