ToolMage
Connexion

AI TOOL COMPARISON

hystruct vs Skrape

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Aperçu du produit

hystruct Aperçu du produit

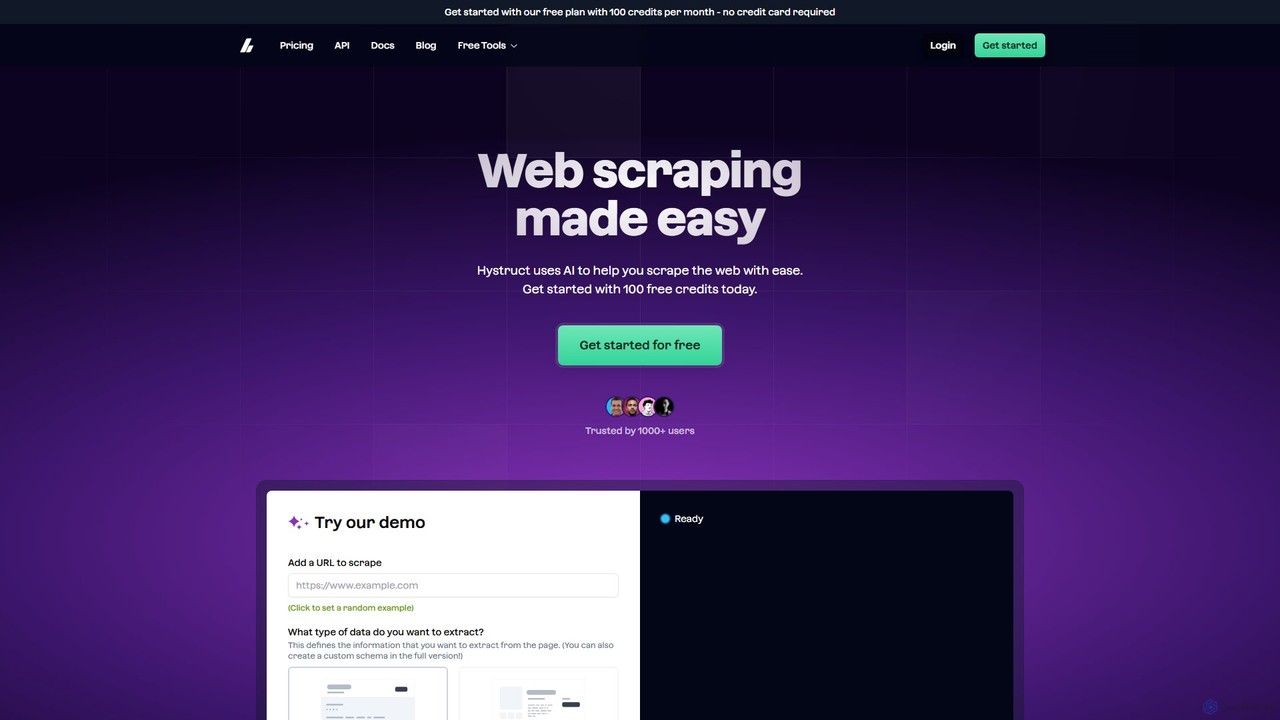
hystruct est un outil de web scraping alimenté par l'IA qui simplifie l'extraction de données. Il permet aux utilisateurs de transformer facilement du contenu web non structuré en données structurées à l'aide de schémas prédéfinis ou personnalisés, sans avoir besoin de coder. Avec des intégrations comme Zapier, il automatise les flux de travail pour l'étude de marché, la génération de leads, et plus encore. Il est conçu pour tout le monde, des débutants aux équipes d'entreprise.

Preview

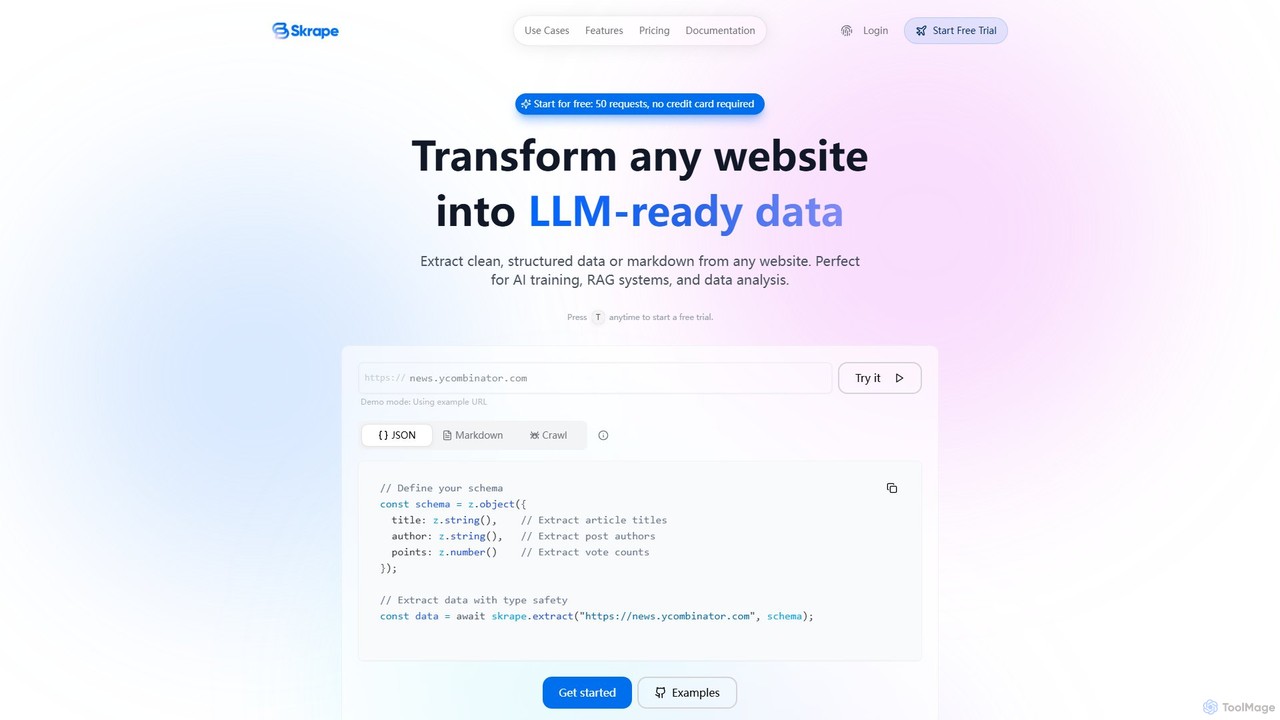
Skrape Aperçu du produit

Skrape est une API de web scraping alimentée par LLM, conçue pour transformer n'importe quel site web en données propres, structurées et prêtes pour les LLM. Elle simplifie l'extraction de données en convertissant les pages web en JSON structuré ou en markdown propre, ce qui la rend idéale pour l'entraînement d'IA, les systèmes RAG et l'analyse de données. Avec des fonctionnalités telles que la gestion de contenu dynamique et le crawling intelligent, Skrape offre une solution fiable pour les développeurs et les entreprises afin d'automatiser leurs pipelines de collecte de données.

Preview

Données clés

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

hystruct VS Skrape — Données clés
Données cléshystructSkrape
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusScrapingScraping
Publics et métiersNon vérifiéNon vérifié
CatégoriesScraping · API · Génération de leads · AutomatisationScraping · API · Automatisation
Added4 août 202512 août 2025
Mis à jour19 nov. 202619 nov. 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

hystruct

hystruct est une plateforme avancée de web scraping pilotée par l'IA, conçue pour rendre l'extraction de données de n'importe quel site web simple et efficace. Elle permet aux utilisateurs, quelle que soit leur expertise technique, de convertir des pages web non structurées en données propres et structurées. En tirant parti de l'intelligence artificielle, hystruct élimine le besoin de saisie manuelle de données ou de codage complexe, automatisant l'ensemble du processus, de la saisie de l'URL à la sortie des données. La plateforme est conçue pour un large éventail d'utilisateurs, des particuliers et petites équipes aux grandes entreprises, offrant une solution évolutive pour divers besoins en données.

Comment utiliser hystruct

L'utilisation de hystruct est un processus simple en trois étapes conçu pour une efficacité maximale :

  1. Choisissez une structure de données : Commencez par saisir l'URL du site web que vous souhaitez scraper. Ensuite, sélectionnez parmi des schémas de données prédéfinis pour des cas d'utilisation courants comme 'Offre d'emploi' ou 'Produit E-commerce'. Pour des besoins plus spécifiques, les plans payants vous permettent de créer des schémas personnalisés pour définir exactement les informations que vous souhaitez extraire. L'IA identifie intelligemment les points de données correspondants sur la page.
  2. Connectez vos outils préférés : hystruct s'intègre de manière transparente avec d'autres applications pour automatiser votre pipeline de données. Une intégration clé est avec Zapier, qui vous permet d'envoyer automatiquement vos données scrapées à des milliers d'autres applications, telles que Google Sheets, Airtable ou votre CRM, sans écrire de code.
  3. Commencez le scraping : Une fois votre schéma et vos intégrations configurés, vous pouvez lancer la tâche de scraping. hystruct traitera les pages, extraira les données selon votre structure définie, et les rendra disponibles au téléchargement ou les synchronisera automatiquement avec vos outils connectés. Les plans supérieurs offrent des tâches simultanées pour accélérer les projets à grande échelle.

Fonctionnalités principales de hystruct

  • Extraction de données alimentée par l'IA : Le cœur de hystruct est son moteur d'IA, qui comprend automatiquement la mise en page des pages web et extrait les données pertinentes sans que les utilisateurs aient à écrire des sélecteurs CSS ou des requêtes XPath.
  • Schémas prédéfinis et personnalisés : Démarrez rapidement avec des modèles prêts à l'emploi pour les types de données courants ou créez vos propres structures de données personnalisées pour des projets uniques.
  • Interface sans code : Une plateforme intuitive et conviviale qui rend le web scraping accessible aux non-développeurs, aux spécialistes du marketing, aux chercheurs et aux analystes commerciaux.
  • Intégrations transparentes : L'intégration native avec Zapier connecte hystruct à un vaste écosystème d'outils, permettant une automatisation puissante des flux de travail.
  • Accès API : Pour les développeurs et les équipes ayant des besoins personnalisés, hystruct fournit un accès API pour gérer et exécuter les tâches de scraping par programmation.
  • Performances évolutives : Avec des plans qui prennent en charge les tâches simultanées et des volumes de crédits élevés, hystruct peut tout gérer, des petites tâches ponctuelles à l'extraction de données continue au niveau de l'entreprise.
  • Guide du scraping éthique : La plateforme et ses ressources promeuvent des pratiques de scraping éthiques, telles que le respect du `robots.txt` et des limites de taux.

Cas d'utilisation pour hystruct

hystruct est polyvalent et peut être appliqué à de nombreux scénarios :

  • Étude de marché : Agrégez les détails des produits, les prix et les avis des clients des sites de commerce électronique pour analyser les tendances du marché et les stratégies des concurrents.
  • Génération de leads : Extrayez les informations de contact des annuaires en ligne, des réseaux professionnels et des sites web d'entreprise pour constituer des listes de prospects ciblées.
  • Recrutement et RH : Scrapez les sites d'offres d'emploi et les pages carrières pour recueillir des données sur les postes vacants, les benchmarks salariaux et les compétences requises.
  • Agrégation de contenu : Collectez des articles, des actualités et des billets de blog de diverses sources pour alimenter un portail d'actualités ou une plateforme de contenu.
  • Analyse immobilière : Rassemblez les annonces immobilières, les prix et les caractéristiques des sites web immobiliers pour l'analyse du marché et les décisions d'investissement.

Avantages de hystruct

hystruct offre un avantage concurrentiel significatif en simplifiant une tâche traditionnellement complexe. Ses principaux avantages incluent la vitesse, en automatisant ce qui prendrait des heures de travail manuel ou de codage ; l'accessibilité, en fournissant une solution sans code pour tous les niveaux de compétence ; et la flexibilité, grâce à son support pour les besoins d'extraction de données simples et complexes avec des schémas personnalisés et un accès API. Les capacités d'intégration améliorent encore la productivité en s'intégrant directement dans les flux de travail existants.

Tarification et plans

hystruct propose un modèle de tarification à plusieurs niveaux pour répondre à différents besoins :

  • Gratuit : Parfait pour commencer. Comprend 100 crédits, 1 schéma, 1 tâche simultanée et un temps de réponse du support de 24 heures. Aucune carte de crédit requise.
  • Core : Idéal pour les particuliers et les petits projets. Au prix de 9 $/mois, il fournit 1 000 crédits, jusqu'à 5 schémas, 1 tâche simultanée et un support de 24 heures.
  • Pro : Le plan le plus populaire pour les équipes avec des tâches plus importantes. Pour 99 $/mois, les utilisateurs obtiennent 45 000 crédits, des schémas illimités, 3 tâches simultanées et un temps de réponse du support de 12 heures.
  • Enterprise : Un plan personnalisé pour les grandes équipes ayant des exigences spécifiques. Il comprend des allocations de crédits personnalisées, des schémas illimités, le SSO et un support dédié.

Skrape

Skrape est une API de web scraping puissante et conviviale pour les développeurs qui exploite les grands modèles de langage (LLM) pour extraire des données propres et structurées de n'importe quel site web. Elle est spécifiquement conçue pour rationaliser le processus de collecte de données pour les applications d'IA modernes, telles que les systèmes de génération augmentée par récupération (RAG), l'affinage de modèles et l'analyse de données approfondie. Le service peut transformer des pages web complexes, y compris celles avec du contenu dynamique rendu par JavaScript, en markdown soigneusement formaté ou en données JSON structurées selon un schéma défini par l'utilisateur.

La philosophie centrale de Skrape est de simplifier l'extraction de données web. Au lieu de gérer une analyse HTML complexe, des mesures anti-scraping ou la gestion de proxys, les développeurs peuvent utiliser un simple appel API pour obtenir les données dont ils ont besoin. La plateforme est conçue pour la fiabilité et l'évolutivité, garantissant que les utilisateurs reçoivent toujours des données fraîches et en temps réel, sans aucune mise en cache.

Comment utiliser Skrape

L'utilisation de Skrape est simple et conçue pour une expérience de développement transparente. Voici le flux de travail typique :

  1. Inscrivez-vous et obtenez une clé API : Tout d'abord, créez un compte sur le site web de Skrape. Vous pouvez commencer avec un essai gratuit qui fournit 50 crédits sans nécessiter de carte de crédit. Lors de votre inscription, vous recevrez une clé API depuis votre tableau de bord.
  2. Authentification : Toutes les requêtes API doivent être authentifiées à l'aide d'un jeton Bearer. Vous devez inclure votre clé API dans l'en-tête `Authorization` de vos requêtes (par exemple, `Authorization: Bearer YOUR_API_KEY`).
  3. Choisissez un point de terminaison : Skrape propose plusieurs points de terminaison API en fonction de vos besoins :
    • /api/markdown : Convertit une seule page web en markdown propre.
    • /api/extract : Extrait des données JSON structurées d'une page web en fonction d'un schéma Zod que vous fournissez. Cela permet une extraction de données précise et typée.
    • /api/crawl : Parcourt un site web entier, en suivant les liens pour collecter efficacement des données sur plusieurs pages.
  4. Effectuez l'appel API : Utilisez votre client HTTP préféré ou les SDK officiels de Skrape (disponibles pour Node.js et Python) pour effectuer des requêtes à l'API. Par exemple, pour extraire des données, vous définiriez la structure de données souhaitée comme un schéma et la transmettriez avec l'URL cible au point de terminaison `/api/extract`.
  5. Traitez les résultats : L'API renvoie les données extraites dans le format que vous avez demandé — markdown propre ou JSON structuré. Le service prend également en charge le traitement des tâches en arrière-plan pour les tâches de longue durée, et vous pouvez vérifier l'état de la tâche via le point de terminaison `/api/get-job`.

Fonctionnalités principales de Skrape

  • Extraction intelligente alimentée par LLM : Définissez la structure de données souhaitée à l'aide d'un schéma, et l'IA extraira et formatera intelligemment les informations en JSON structuré.
  • Crawling intelligent : Parcourt automatiquement des sites web entiers, même ceux sans sitemaps, tout en respectant les règles de `robots.txt` pour garantir un scraping éthique.
  • Gestion du contenu dynamique : Prend entièrement en charge le rendu JavaScript, ce qui lui permet de gérer les applications à page unique (SPA) et d'autres contenus dynamiques avec lesquels les scrapers traditionnels ont du mal.
  • Conversion en Markdown propre : Convertit n'importe quelle page web en markdown parfaitement formaté et propre, idéal pour les systèmes RAG et les bases de connaissances.
  • Actions API : Peut effectuer des actions sur une page comme cliquer sur des boutons, faire défiler et attendre le chargement de contenu spécifique avant l'extraction.
  • Données en temps réel : Skrape ne met pas en cache le contenu, garantissant que vous obtenez toujours les données les plus fraîches et les plus à jour directement de la source.
  • Convivial pour les développeurs : Propose des SDK officiels pour Node.js et Python, une documentation API complète et un format de gestion des erreurs cohérent.

Cas d'utilisation pour Skrape

Skrape est polyvalent et peut être appliqué à un large éventail de tâches de collecte de données :

  • Collecte de données prête pour RAG : Transformez les sites web en ensembles de données propres et structurés avec une extraction automatique des métadonnées, parfaits pour alimenter les applications de génération augmentée par récupération.
  • Pipeline de données d'entraînement pour l'IA : Automatisez la collecte d'ensembles de données diversifiés, de haute qualité et multilingues pour l'affinage des modèles de langage et d'autres applications d'IA.
  • Création de bases de connaissances : Créez des bases de connaissances complètes en extrayant la documentation technique, les références d'API, les tutoriels et les articles de recherche de plusieurs sources.
  • Surveillance du contenu IA : Restez à jour avec les dernières tendances de l'industrie en suivant et en collectant les actualités, les recherches et les blogs techniques liés à l'IA.
  • Données d'évaluation de modèles : Rassemblez des données du monde réel provenant de divers domaines pour évaluer et comparer les performances de vos LLM.

Avantages de Skrape

Skrape offre un avantage significatif par rapport aux méthodes de web scraping traditionnelles. Ses principaux avantages incluent sa simplicité, sa puissance et sa fiabilité. L'approche API-first abstrait les complexités du web scraping, permettant aux développeurs de se concentrer sur l'utilisation des données. L'utilisation de LLM pour l'extraction offre une précision et une flexibilité supérieures par rapport aux méthodes fragiles basées sur les sélecteurs CSS. De plus, sa capacité à gérer le contenu dynamique et à fournir une sortie propre et prête à l'emploi permet d'économiser un temps et des efforts de développement considérables.

Tarification et plans

Skrape propose un modèle de tarification transparent et basé sur les crédits, conçu pour évoluer avec vos besoins.

  • Essai gratuit : Commencez avec 50 crédits gratuits pour tester le service. Aucune carte de crédit n'est requise.
  • Plan Starter : 15 $/mois pour 3 000 crédits. Idéal pour les petits projets et les développeurs individuels.
  • Plan Growth : 50 $/mois pour 10 000 crédits. Adapté aux équipes en croissance avec des besoins d'utilisation accrus. Inclut un support prioritaire.
  • Plan Pro : 250 $/mois pour 50 000 crédits. Conçu pour les entreprises et les équipes ayant des besoins de volume élevé. Inclut un support prioritaire et des limites de débit personnalisées.

Utilisation des crédits :

  • HTML vers Markdown : 1 crédit par page
  • Web Crawling : 1 crédit par page
  • Extraction de données par IA : 5 crédits par page

Positionnement

La taxonomie montre les chevauchements et le positionnement distinct de chaque produit. Les champs inconnus sont clairement indiqués et ne sont jamais complétés par des suppositions.

Catégories

Commun
ScrapingAPIAutomatisation
Uniquement hystruct
Génération de leads
Uniquement Skrape
Aucune donnée vérifiée

Étiquettes

Commun
APIautomatisationExtraction de donnéesWeb scraping
Uniquement hystruct
exploration de donnéesGénération de leadsétude de marchéNo-codeZapier
Uniquement Skrape
Formation IACollecte de donnéesoutil de développementcontenu dynamiqueJSONGrand modèle linguistiqueMarkdownGénération Augmentée par Récupération

Publics et métiers

Commun
Aucune donnée vérifiée
Uniquement hystruct
Aucune donnée vérifiée
Uniquement Skrape
Aucune donnée vérifiée

Comparaison du trafic

Le trafic utilise la même échelle afin de refléter fidèlement la visibilité sur le marché.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

hystruct monthly traffic:

Latest traffic · 2026-05

Visites mensuelles
1.4K
Durée moyenne
0:00
Pages par visite
1.06
Taux de rebond
37.79%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 320
  • 2026-01: 0
  • 2026-02: 21
  • 2026-03: 1K
  • 2026-04: 397
  • 2026-05: 1.4K

Principales régions

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States100%1.4K

Mots-clés

hystructpuppeteer scrape pagesscrape with puppeteerweb scraper - free web scrapingwrite tool to scrape data from website

Skrape

Non vérifié

Signaux communautaires

Les notes et réactions sont des signaux communautaires, pas une mesure absolue de pertinence.

hystruct

Note
Non vérifié
Commentaires
0
Favoris
162
J’aime
184

Skrape

Note
Non vérifié
Commentaires
0
Favoris
166
J’aime
153

hystruct vs Skrape · FAQ comparative

What do hystruct and Skrape have in common?
Both tools are listed under Scraping、API、Automatisation. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are hystruct and Skrape free?
Listed pricing models: hystruct — Freemium; Skrape — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between hystruct and Skrape?
The primary listed category is Scraping for hystruct, and Scraping for Skrape. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparatifs associés