

Crawlora Overview
Crawlora est une plateforme de web scraping de pointe, pilotée par l'IA, conçue pour démocratiser l'extraction de données sur le web. Elle permet aux entreprises et aux particuliers de récolter des informations précieuses sur n'importe quel site web sans nécessiter d'expertise technique ou d'écrire du code complexe. En s'appuyant sur l'intelligence artificielle, Crawlora peut identifier, sélectionner et structurer intelligemment les données de pages web dynamiques et complexes, transformant la vaste étendue d'Internet en une base de données organisée et exploitable. La plateforme est conçue pour l'évolutivité, l'efficacité et la facilité d'utilisation, répondant à un large éventail de besoins, de la simple collecte de données aux flux de travail de données complexes au niveau de l'entreprise.
Comment utiliser Crawlora
L'utilisation de Crawlora est un processus simple en trois étapes, conçu pour une efficacité maximale :
- Entrez l'URL : Collez simplement l'URL du site web dont vous souhaitez extraire les données dans le tableau de bord de Crawlora. La plateforme chargera la page dans un navigateur interactif.
- Pointez et Cliquez pour Sélectionner les Données : Utilisez votre souris pour cliquer sur les éléments de données que vous souhaitez extraire (par exemple, noms de produits, prix, coordonnées, articles). L'IA de Crawlora détectera automatiquement les modèles et sélectionnera tous les éléments similaires sur la page, créant ainsi une recette d'extraction de données pour vous.
- Exécutez et Exportez : Configurez vos paramètres de crawl, comme le programmer pour une exécution quotidienne ou hebdomadaire, puis lancez le scraper. Crawlora s'exécutera sur ses serveurs cloud, collectera les données et vous permettra de les télécharger dans des formats structurés comme CSV, JSON ou Excel. Vous pouvez également envoyer les données directement à d'autres applications via une API ou des webhooks.
Fonctionnalités principales de Crawlora
- Sélection d'Éléments par IA : Identifie intelligemment les champs de données et gère les structures de site complexes, réduisant l'effort manuel nécessaire pour construire un scraper.
- Interface Visuelle Sans Code : Un flux de travail convivial de type pointer-cliquer qui rend le web scraping accessible aux non-développeurs comme les spécialistes du marketing, les analystes et les entrepreneurs.
- Crawl Planifié et Automatisé : Configurez des scrapers pour qu'ils s'exécutent selon un calendrier récurrent (horaire, quotidien, hebdomadaire) afin de surveiller automatiquement les changements de données dans le temps.
- Infrastructure Basée sur le Cloud : Toutes les tâches de scraping s'exécutent sur les serveurs cloud évolutifs de Crawlora, vous n'avez donc pas besoin d'utiliser les ressources de votre propre ordinateur.
- Capacités de Scraping Avancées : Gère les sites web riches en JavaScript, la pagination, le défilement infini, et navigue à travers les formulaires et les connexions.
- Rotation de Proxy Intégrée : Fait tourner automatiquement les adresses IP pour éviter d'être bloqué, garantissant des taux de réussite élevés pour vos tâches d'extraction de données.
- Nettoyage et Transformation des Données : Fournit des outils pour nettoyer et formater les données extraites directement au sein de la plateforme avant l'exportation.
- Intégration API et Webhooks : Intégrez Crawlora de manière transparente avec vos propres applications, bases de données ou outils de business intelligence pour des flux de travail automatisés.
Cas d'utilisation pour Crawlora
Crawlora est un outil polyvalent applicable dans diverses industries :
- E-commerce et Vente au Détail : Surveillez les prix des concurrents, suivez la disponibilité des produits, agrégez les avis des clients et enrichissez les catalogues de produits.
- Marketing et Ventes : Générez des leads de haute qualité en scrapant des annuaires d'entreprises, des profils de médias sociaux et des réseaux professionnels.
- Études de Marché : Analysez les tendances du marché, suivez le sentiment de la marque et recueillez des informations concurrentielles sur les sites d'actualités, les forums et les blogs.
- Immobilier : Agrégez les annonces immobilières de plusieurs sites web pour créer une base de données complète des biens disponibles.
- Finance : Collectez des données boursières, des états financiers et des données alternatives pour l'analyse des investissements.
Avantages de Crawlora
Crawlora offre des avantages significatifs par rapport aux méthodes de scraping traditionnelles. Son approche sans code réduit considérablement le temps et les coûts associés à la collecte de données. Le moteur alimenté par l'IA garantit une plus grande précision et résilience, car il peut s'adapter aux changements mineurs de la mise en page d'un site web. Cela rend l'extraction de données plus fiable et moins gourmande en maintenance. De plus, son évolutivité permet aux utilisateurs de passer du scraping d'une seule page à des millions de pages sans se soucier de la gestion de l'infrastructure.
Tarification et plans
Crawlora fonctionne sur un modèle freemium, le rendant accessible à tous.
- Plan Gratuit : Idéal pour les petits projets et l'évaluation, offrant un nombre limité de crédits de crawl par mois et des fonctionnalités de base.
- Plan Débutant : Conçu pour les particuliers et les petites entreprises, offrant plus de crédits, le crawl planifié et un support standard.
- Plan Professionnel : Le meilleur pour les entreprises en croissance et les utilisateurs avancés, ce plan comprend un volume élevé de crédits, un accès API, des options de proxy premium et un support prioritaire.
- Plan Entreprise : Une solution personnalisée pour les grandes organisations ayant des besoins spécifiques, offrant une évolutivité illimitée, un gestionnaire de compte dédié et des accords de niveau de service (SLA).
Crawlora Alternatives
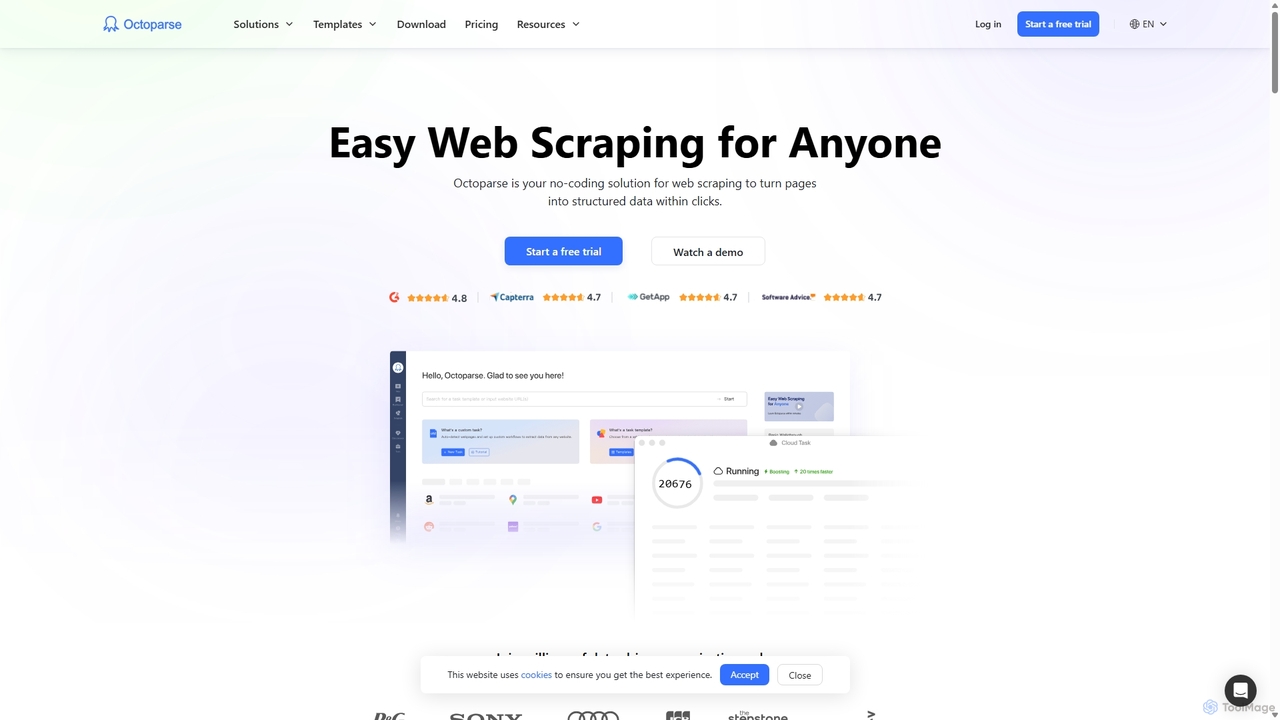
Octoparse
Octoparse est un puissant outil de web scraping sans code qui permet à quiconque d'extraire des données de sites web sans programmation. Il dispose d'un concepteur de flux de travail visuel, d'un assistant IA pour une configuration facile et de centaines de modèles prédéfinis pour les sites populaires. Grâce à l'automatisation basée sur le cloud, à la rotation d'IP et à la résolution de CAPTCHA, Octoparse gère efficacement les tâches de scraping complexes, transformant les pages web en données structurées pour la génération de leads, les études de marché, et plus encore.
Web scraping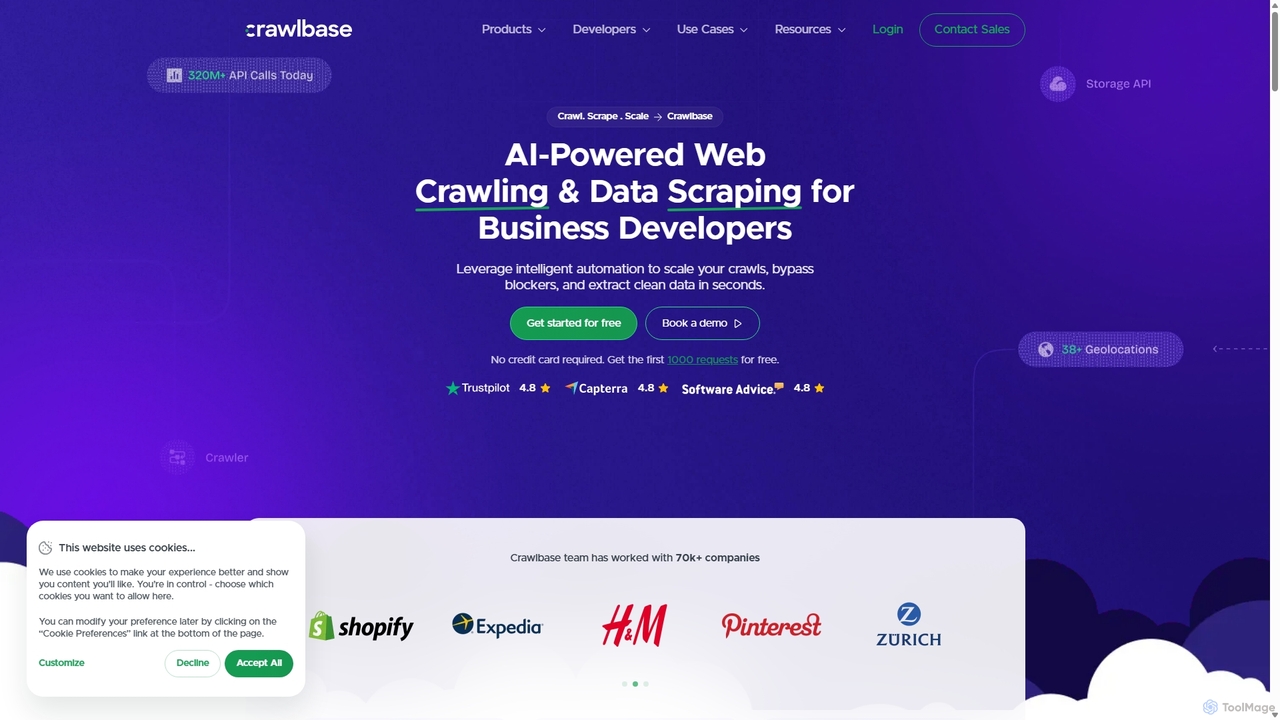
Crawlbase
Crawlbase est une plateforme de crawling web et de scraping de données alimentée par l'IA pour les développeurs et les entreprises. Elle fournit une suite d'outils, y compris une API de Crawling et un Smart Proxy, pour extraire anonymement des données de n'importe quel site web à grande échelle, en contournant les blocages et les CAPTCHAs avec un taux de réussite élevé. Elle simplifie la collecte de données pour le SEO, les études de marché, l'intelligence e-commerce et l'entraînement de modèles d'IA.
Extraction de Données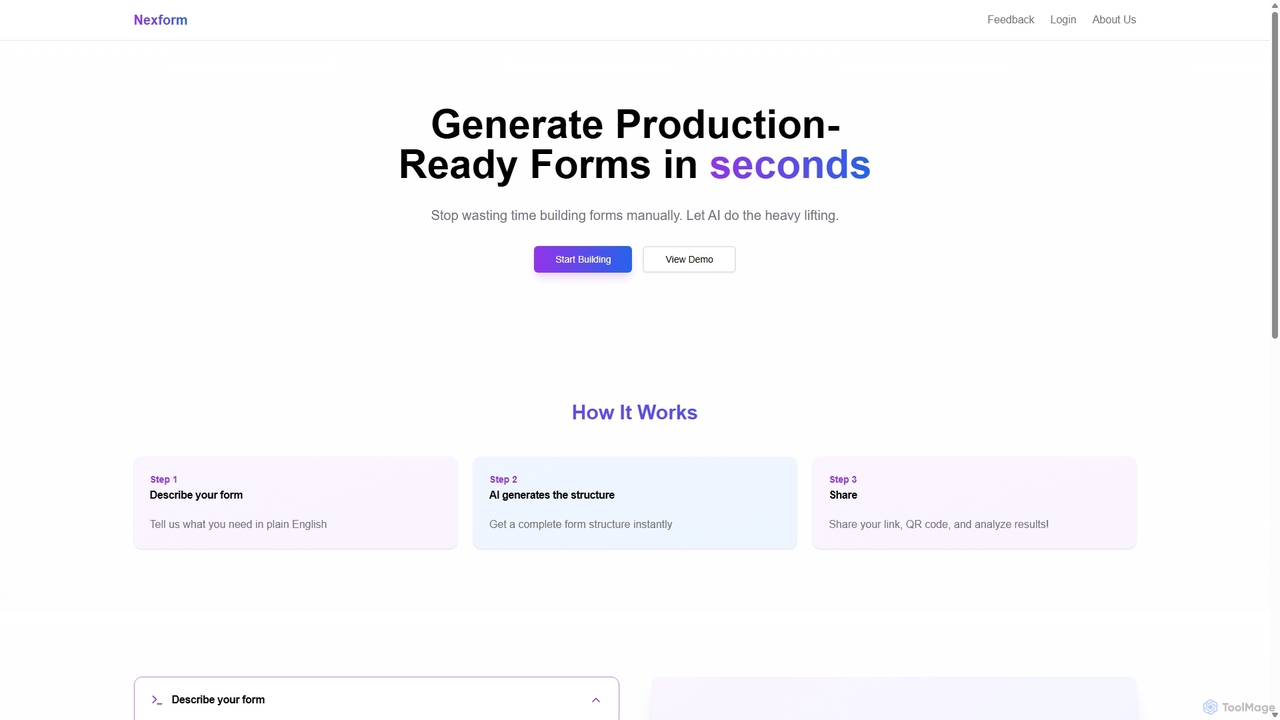
Nexform
Nexform est un constructeur de formulaires alimenté par l'IA qui transforme des descriptions textuelles simples en formulaires web entièrement fonctionnels et prêts pour la production en quelques secondes. Il automatise l'ensemble du processus de création de formulaires, de la génération de la structure à la validation intelligente, permettant aux développeurs et aux entreprises de construire et de déployer des formulaires avec une vitesse et une efficacité sans précédent.
Sans Code
FetchFox
FetchFox est un outil de web scraping alimenté par l'IA qui permet aux utilisateurs d'extraire des données de n'importe quel site web à l'aide de simples invites textuelles. Il élimine le besoin de codage complexe ou de sélecteurs CSS, en gérant automatiquement les mesures anti-bot. Disponible sous forme d'API, de bibliothèque JavaScript et d'extension Chrome, il est conçu pour que les développeurs et les utilisateurs non techniques puissent automatiser la collecte de données sans effort.
Extraction de Données
Chat4Data
Chat4Data est une extension Chrome alimentée par l'IA qui révolutionne le web scraping. Discutez simplement avec l'IA en langage naturel pour extraire des données structurées de n'importe quel site web, y compris du texte, des images, des liens et des e-mails. Aucun codage n'est requis, ce qui rend la collecte de données 10 fois plus rapide et accessible à tous. Il dispose d'une pagination automatisée et d'une détection intelligente des données pour des résultats complets.
Web scrapingCrawlora Categories
Crawlora Jobs
Crawlora Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Octoparse
Octoparse est un puissant outil de web scraping sans code qui permet à quiconque d'extraire des données de sites web sans programmation. Il dispose d'un concepteur de flux de travail visuel, d'un assistant IA pour une configuration facile et de centaines de modèles prédéfinis pour les sites populaires. Grâce à l'automatisation basée sur le cloud, à la rotation d'IP et à la résolution de CAPTCHA, Octoparse gère efficacement les tâches de scraping complexes, transformant les pages web en données structurées pour la génération de leads, les études de marché, et plus encore.
Web scraping
Zyte
Zyte est une plateforme complète de web scraping offrant une API full-stack et des services d'extraction de données. Elle simplifie l'acquisition de données en gérant les proxys, les navigateurs sans tête et les systèmes anti-blocage avancés. Propulsé par l'IA, Zyte fournit des données web fiables et structurées à grande échelle pour les entreprises du e-commerce, de l'étude de marché, et plus encore.
Intelligence de marchéCrawlbase
Crawlbase est une plateforme de crawling web et de scraping de données alimentée par l'IA pour les développeurs et les entreprises. Elle fournit une suite d'outils, y compris une API de Crawling et un Smart Proxy, pour extraire anonymement des données de n'importe quel site web à grande échelle, en contournant les blocages et les CAPTCHAs avec un taux de réussite élevé. Elle simplifie la collecte de données pour le SEO, les études de marché, l'intelligence e-commerce et l'entraînement de modèles d'IA.
Extraction de Données
Lection
Lection est un agent de web scraping alimenté par l'IA qui permet aux utilisateurs d'extraire des données structurées de n'importe quel site web en utilisant le langage naturel. Il automatise la collecte de données, s'intègre aux flux de travail populaires et fournit des données propres et validées sans nécessiter d'expertise en codage.
3D
Scrappey
Scrappey est une API de web scraping avancée conçue pour que les développeurs puissent extraire sans effort des données de n'importe quel site web. Elle gère toutes les complexités telles que les proxys rotatifs, les navigateurs sans tête et le contournement des mesures anti-bot comme Cloudflare et les CAPTCHAs. Avec un taux de réussite élevé et un modèle simple de paiement à l'utilisation, Scrappey simplifie la collecte de données pour diverses applications.
Extraction de Données
ParseHub
ParseHub est un puissant outil de web scraping sans code qui permet aux utilisateurs d'extraire des données de n'importe quel site web avec une simple interface pointer-cliquer. Il est conçu pour gérer des sites complexes et dynamiques avec JavaScript, AJAX, des formulaires et un défilement infini. Les données peuvent être collectées selon un calendrier, exportées en JSON/Excel ou consultées via une API, ce qui le rend idéal pour la génération de leads, les études de marché et l'agrégation de données.
Web scraping
TaskMagic
TaskMagic est un outil d'automatisation robotisée des processus (RPA) sans code qui vous permet d'automatiser n'importe quelle tâche basée sur le web. Enregistrez vos clics et vos frappes pour créer de puissants flux de travail pour le web scraping, la saisie de données et la gestion des médias sociaux sans écrire une seule ligne de code. Il simplifie les actions répétitives du navigateur, vous faisant gagner du temps et de l'effort.
Web scraping
PandaExtract
PandaExtract est l'extension de web scraping sans code ultime pour Chrome. Elle permet aux professionnels d'extraire des données de n'importe quel site web en un seul clic. Idéale pour les études de marché, la génération de leads, la surveillance des prix et l'analyse concurrentielle, elle ne nécessite aucune compétence en programmation.
Web scrapingFetchFox
FetchFox est un outil de web scraping alimenté par l'IA qui permet aux utilisateurs d'extraire des données de n'importe quel site web à l'aide de simples invites textuelles. Il élimine le besoin de codage complexe ou de sélecteurs CSS, en gérant automatiquement les mesures anti-bot. Disponible sous forme d'API, de bibliothèque JavaScript et d'extension Chrome, il est conçu pour que les développeurs et les utilisateurs non techniques puissent automatiser la collecte de données sans effort.
Extraction de DonnéesChat4Data
Chat4Data est une extension Chrome alimentée par l'IA qui révolutionne le web scraping. Discutez simplement avec l'IA en langage naturel pour extraire des données structurées de n'importe quel site web, y compris du texte, des images, des liens et des e-mails. Aucun codage n'est requis, ce qui rend la collecte de données 10 fois plus rapide et accessible à tous. Il dispose d'une pagination automatisée et d'une détection intelligente des données pour des résultats complets.
Web scraping
Roborabbit
Roborabbit est une plateforme sans code, alimentée par l'IA, pour le web scraping et l'automatisation de navigateur. Elle permet aux utilisateurs d'extraire des données de n'importe quel site web à l'aide d'une simple interface glisser-déposer, sans écrire de code. Planifiez des tâches, intégrez avec plus de 5000 applications via Zapier et Make.com, ou utilisez l'API REST pour des flux de travail avancés. Elle est conçue pour les marketeurs, les analystes de données et les développeurs afin d'automatiser les tâches répétitives, de surveiller les concurrents et de recueillir sans effort de précieuses informations commerciales.
Extraction de Données
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
instantapi
instantapi est une API de web scraping alimentée par l'IA, conçue pour la simplicité et la vitesse. Elle permet aux utilisateurs d'extraire des données structurées de n'importe quel site web avec un seul appel API, éliminant le besoin de codage complexe ou de configuration manuelle. Idéal pour les développeurs, les analystes de données et les entreprises qui ont besoin d'une extraction de données rapide, abordable et fiable sans les tracas des scrapers web traditionnels.
Extraction de Données
Chatsheet
Chatsheet est une plateforme de tableur alimentée par l'IA qui automatise la recherche, la création de contenu et l'analyse de données. En utilisant une interface de tableur familière, les utilisateurs peuvent créer des flux de travail complexes et sans code pour traiter des documents, extraire des données de sites web et générer du contenu personnalisé à grande échelle, transformant efficacement chaque cellule en un agent IA intelligent.
TableursNexform
Nexform est un constructeur de formulaires alimenté par l'IA qui transforme des descriptions textuelles simples en formulaires web entièrement fonctionnels et prêts pour la production en quelques secondes. Il automatise l'ensemble du processus de création de formulaires, de la génération de la structure à la validation intelligente, permettant aux développeurs et aux entreprises de construire et de déployer des formulaires avec une vitesse et une efficacité sans précédent.
Sans Code
Crawlora Comments (0)
Sign in to comment.
ConnexionNo comments yet.