

OCR.space Overview
OCR.space est un service de reconnaissance optique de caractères (OCR) polyvalent et robuste, fourni par a9t9 software GmbH. Il est conçu pour convertir le texte des images (JPG, PNG, WEBP) et des documents PDF en formats de texte modifiables et interrogeables. La plateforme s'adresse à un large public, des particuliers ayant besoin d'une conversion rapide aux développeurs nécessitant une API OCR puissante et évolutive pour leurs applications. Avec un engagement envers la confidentialité des utilisateurs et fonctionnant avec une énergie 100 % renouvelable, OCR.space se distingue comme un choix fiable et consciencieux sur le marché de l'OCR.
Le service propose à la fois une interface en ligne conviviale et une API complète. L'outil en ligne est entièrement gratuit pour les fichiers jusqu'à 5 Mo et ne nécessite aucune inscription, ce qui le rend incroyablement accessible pour les tâches rapides. Pour les flux de travail plus exigeants et automatisés, l'API OCR offre un moyen transparent d'intégrer des capacités avancées de reconnaissance de texte dans divers logiciels et processus métier.
Comment utiliser OCR.space
L'utilisation de l'outil OCR en ligne est simple :
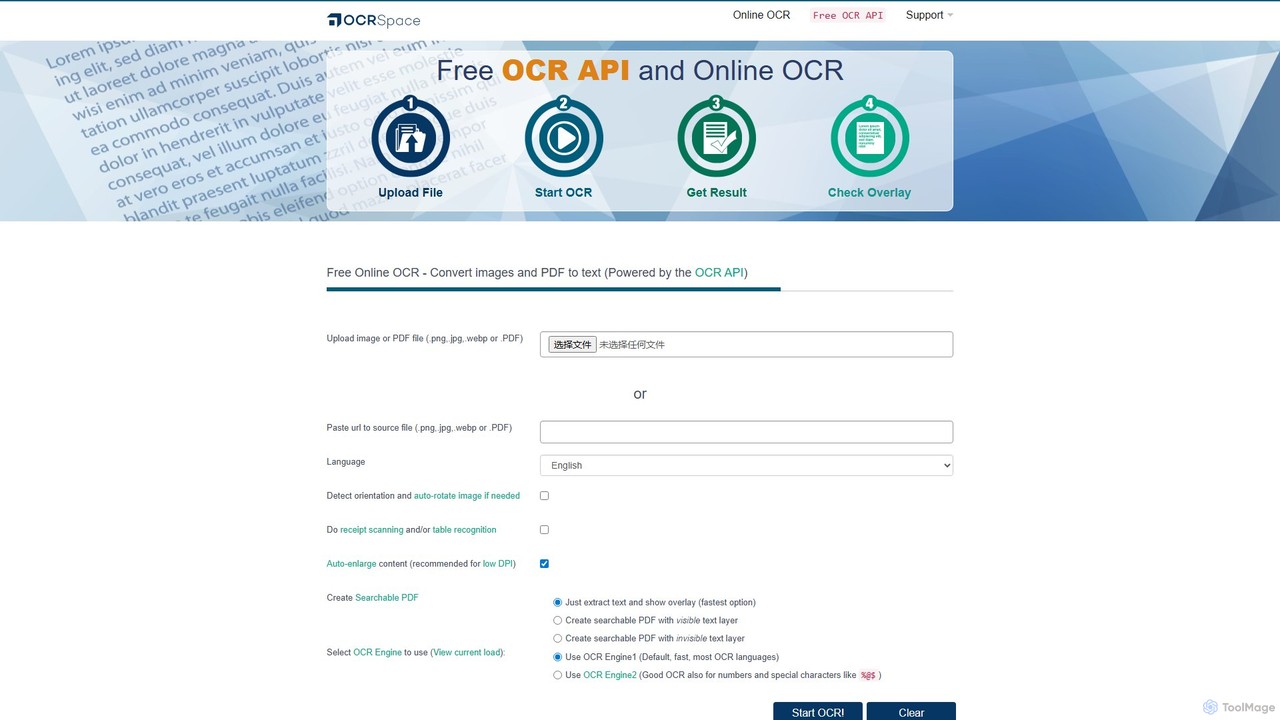
- Téléchargez votre fichier : Vous pouvez soit télécharger un fichier image ou PDF directement depuis votre ordinateur, soit coller une URL vers le fichier source. La fonctionnalité de glisser-déposer est également prise en charge.
- Sélectionnez la langue : Choisissez la langue du texte dans votre document à partir d'une liste étendue. Pour plus de commodité, une option 'Détection automatique' est disponible, ce qui est particulièrement utile pour les documents dont la langue est inconnue ou multiple.
- Choisissez le moteur d'OCR : OCR.space fournit plusieurs moteurs, chacun avec des atouts différents. Le Moteur 1 est rapide et prend en charge la plupart des langues. Le Moteur 2 est excellent pour les documents contenant des chiffres et des caractères spéciaux. D'autres moteurs, comme le Moteur 5, sont optimisés pour des langues spécifiques comme le chinois et pour le traitement de texte sur des arrière-plans complexes.
- Configurez les options : Vous pouvez sélectionner des options de traitement supplémentaires, telles que la rotation automatique de l'image, l'activation de la numérisation de reçus/tableaux, ou la création d'un PDF interrogeable au lieu de simplement extraire le texte.
- Lancez l'OCR : Cliquez sur le bouton 'Lancer l'OCR !' pour démarrer le processus. Le texte extrait s'affichera à l'écran, prêt à être copié, ou vous pourrez télécharger le PDF interrogeable résultant.
Pour les développeurs, l'API OCR peut être intégrée avec un simple appel d'API, en utilisant des paramètres pour spécifier la langue, le moteur et d'autres réglages pour un traitement automatisé.
Fonctionnalités principales de OCR.space
- Prise en charge étendue des langues : Reconnaît le texte dans plus de 25 langues, dont l'anglais, le chinois (simplifié et traditionnel), le japonais, le coréen, le russe, l'allemand, le français, l'espagnol, et bien d'autres. Il prend également en charge l'OCR de texte vertical pour des langues comme le chinois et le japonais.
- Plusieurs moteurs d'OCR : Les utilisateurs peuvent choisir parmi différents moteurs d'OCR pour obtenir la meilleure précision possible pour leur type de document spécifique, qu'il s'agisse d'un document texte standard, d'un reçu ou d'une image avec des caractères spéciaux.
- Création de PDF interrogeables : Allez au-delà de la simple extraction de texte en convertissant les documents numérisés et les images en fichiers PDF entièrement interrogeables. Vous pouvez choisir de rendre la couche de texte visible ou invisible.
- Reconnaissance de tableaux et de reçus : Fonctionnalités spécialisées conçues pour extraire avec précision les données structurées des tableaux et des reçus, simplifiant les tâches de saisie de données.
- API puissante et gratuite : Offre une API bien documentée et robuste avec un généreux niveau gratuit, permettant aux développeurs d'intégrer facilement les capacités d'OCR dans leurs propres applications et flux de travail.
- Normes de confidentialité élevées : OCR.space a une politique de confidentialité stricte, déclarant qu'il ne stocke aucune donnée utilisateur sur ses serveurs, garantissant la confidentialité de vos documents.
- Aucune inscription requise : L'outil OCR en ligne est gratuit et ne nécessite pas de compte, offrant un accès immédiat à ses fonctionnalités.
Cas d'utilisation pour OCR.space
OCR.space est précieux dans divers scénarios :
- Universitaires et chercheurs : Numérisez le texte de livres, d'articles et de documents d'archives pour les rendre interrogeables et faciles à analyser.
- Entreprises et professionnels : Automatisez la saisie de données en extrayant des informations de factures, de reçus et de formulaires. Convertissez des documents commerciaux en formats modifiables pour les rapports et la tenue de registres.
- Développeurs : Créez des applications nécessitant la reconnaissance de texte, telles que des systèmes de gestion de documents, des applications de suivi des dépenses ou des outils d'accessibilité.
- Utilisateurs généraux : Extrayez rapidement du texte d'une capture d'écran, d'une photo d'affiche ou de toute image contenant du texte pour un partage et une modification faciles.
Avantages de OCR.space
Le principal avantage d'OCR.space est sa combinaison de puissance, d'accessibilité et de rentabilité. Le niveau gratuit est très performant pour de nombreux utilisateurs, et la disponibilité de plusieurs moteurs spécialisés garantit des résultats de haute qualité. Son API conviviale pour les développeurs et son engagement ferme envers la confidentialité en font un choix de confiance pour les projets personnels et commerciaux. La capacité de créer directement des PDF interrogeables est une fonctionnalité importante qui ajoute une immense valeur aux flux de travail de numérisation de documents.
Tarification et plans
OCR.space fonctionne sur un modèle freemium.
Plan gratuit : Ce plan est idéal pour les utilisateurs occasionnels. Il est entièrement gratuit, ne nécessite aucune inscription et permet de traiter des fichiers jusqu'à 5 Mo.
Plans PRO/PRO PDF : Pour les utilisateurs ayant des besoins plus importants, tels que les entreprises et les développeurs, OCR.space propose des plans PRO payants. Ces plans offrent un nombre beaucoup plus élevé d'appels d'API, la prise en charge de fichiers plus volumineux, un traitement prioritaire et l'accès à des fonctionnalités supplémentaires. Les détails spécifiques des plans et leurs tarifs sont disponibles sur le site officiel.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 509.2K
- 2026-1: 520.1K
- 2026-2: 458.2K
- 2026-3: 472.8K
- 2026-4: 482.1K
- 2026-5: 478.4K
Geography
Top 5 countries / regions
- 🇮🇳Inde36.6%
- 🇺🇸États-Unis31.2%
- 🇵🇭Philippines11.3%
- 🇨🇳Chine10.6%
- 🇰🇷Corée du Sud10.3%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 84.6% |
Referral | 12.9% |
Email | 2.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| copyfish | $0.71 |
| ocr | $1.03 |
| ocr api | $5.29 |
| ocr online | $0.37 |
| ocr space | $1.61 |
OCR.space Alternatives

GPTOCR
GPTOCR est un outil d'extraction de données alimenté par l'IA qui transforme des documents, tels que des PDF, en fichiers JSON structurés. Il automatise la saisie manuelle des données, réduit les erreurs humaines et rationalise les flux de travail, permettant aux équipes de se concentrer sur des tâches à plus forte valeur ajoutée grâce à des données précises et prêtes à l'emploi.
Extraction de données
Affinda
Une puissante plateforme de traitement de documents basée sur l'IA qui automatise l'extraction de données de tout type de document. Affinda utilise une vision par ordinateur avancée et le NLP pour lire, comprendre et structurer les données des factures, CV, contrats, etc., et prend en charge plus de 50 langues. Elle aide les entreprises à accroître leur efficacité, à réduire les tâches manuelles et à améliorer la précision des données grâce à une intégration API transparente.
Extraction de données
super.ai
super.ai est une plateforme avancée de Traitement Intelligent des Documents (TID) qui utilise l'IA générative pour automatiser l'extraction de données à partir de documents complexes tels que les factures, les PDF et les tableaux. Elle garantit un traitement à 100 % avec une grande précision, en intégrant des flux de travail à intervention humaine (human-in-the-loop) pour gérer les exceptions et assurer des données fiables et exploitables pour les entreprises des secteurs de la finance, de la logistique et de l'assurance.
Extraction de données
Parseflow
Parseflow est une plateforme alimentée par l'IA pour l'extraction automatisée de données à partir de divers documents tels que les factures, les reçus, les contrats et les CV. Elle utilise l'OCR et le NLP avancés pour analyser les données structurées et non structurées, aidant les entreprises à rationaliser leurs flux de travail, à réduire la saisie manuelle et à diminuer les coûts opérationnels.
Extraction de données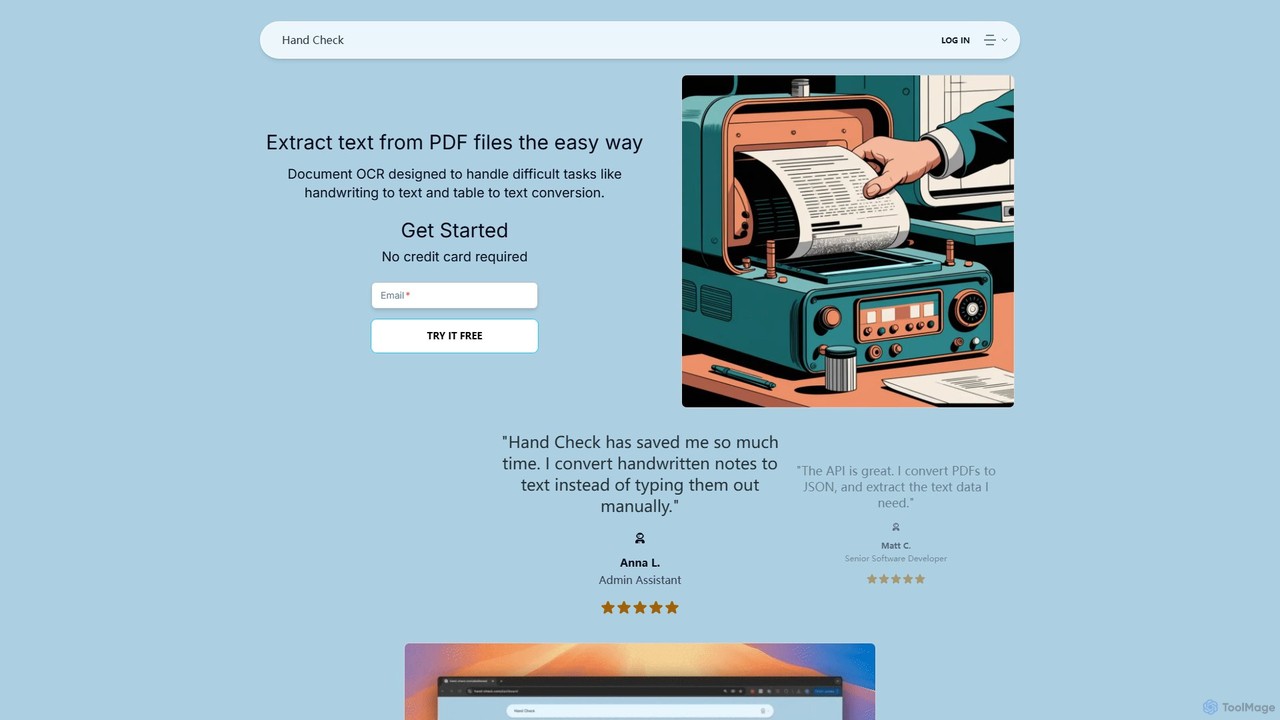
hand_check
hand_check est un outil d'OCR avancé qui utilise l'apprentissage automatique pour extraire du texte de PDF et d'images. Il est spécialisé dans la conversion de documents complexes, y compris les notes manuscrites et les tableaux, en texte modifiable ou en données JSON structurées. Avec une interface conviviale et une API puissante pour les développeurs, il est idéal pour les particuliers, les développeurs et les entreprises cherchant à automatiser le traitement des documents et l'extraction de données.
Extraction de DonnéesOCR.space Categories
OCR.space Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
olocr
olocr est un outil d'OCR IA gratuit et axé sur la confidentialité qui extrait le texte des images et des PDF directement dans votre navigateur. Il prend en charge plus de 70 langues, le traitement par lots et peut créer des PDF interrogeables sans télécharger vos fichiers, garantissant une sécurité totale des données.
Extraction
imgtotext.net
Un outil OCR en ligne avancé qui extrait avec précision le texte des images et des documents PDF. Il prend en charge le traitement par lots, plusieurs langues et divers formats de fichiers. Il offre également une fonction de traduction intégrée, ce qui en fait une solution polyvalente pour numériser et traiter gratuitement du contenu textuel.
Reconnaissance Optique de Caractères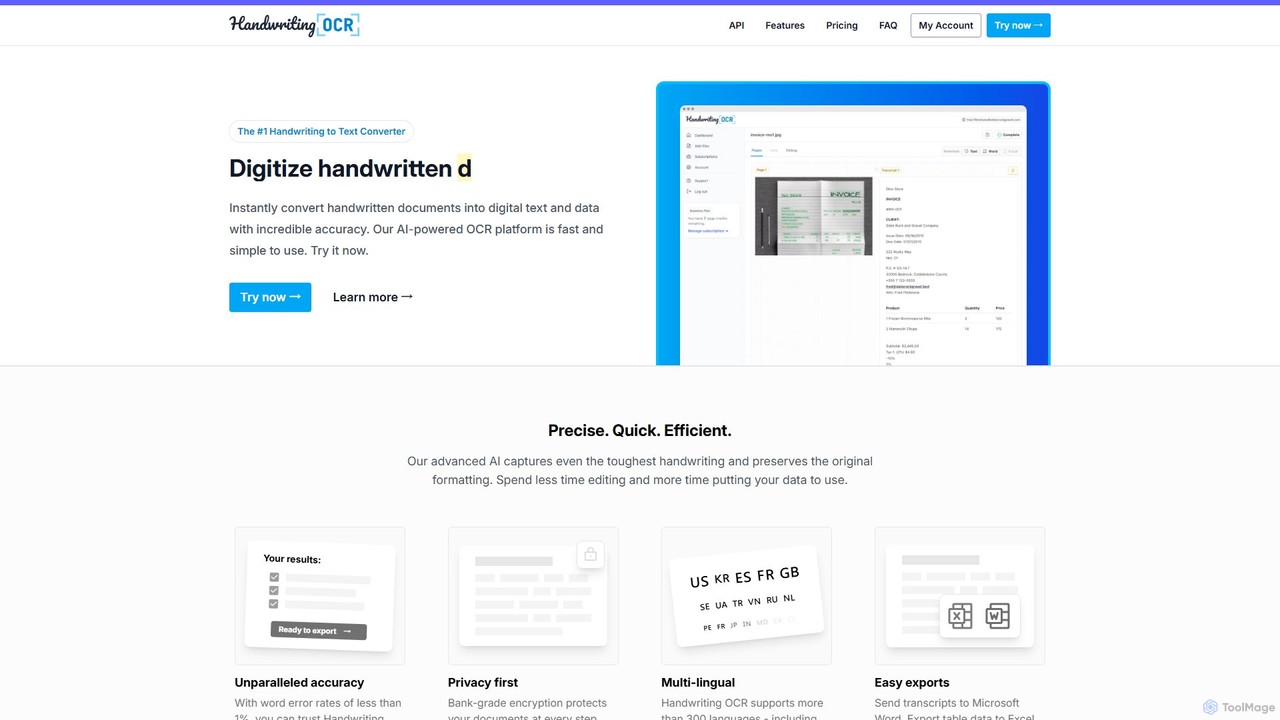
Handwriting OCR
Handwriting OCR est une plateforme alimentée par l'IA qui convertit instantanément les documents manuscrits et imprimés en texte numérique modifiable avec une précision incroyable. Elle prend en charge plus de 300 langues, divers formats de fichiers (PDF, JPG, PNG) et exporte vers Word, Excel et texte brut. Conçue pour les entreprises, les chercheurs et les particuliers, elle privilégie la sécurité avec un cryptage de niveau bancaire et une politique stricte de non-entraînement sur les données des utilisateurs.
Saisie de donnéeshand_check
hand_check est un outil d'OCR avancé qui utilise l'apprentissage automatique pour extraire du texte de PDF et d'images. Il est spécialisé dans la conversion de documents complexes, y compris les notes manuscrites et les tableaux, en texte modifiable ou en données JSON structurées. Avec une interface conviviale et une API puissante pour les développeurs, il est idéal pour les particuliers, les développeurs et les entreprises cherchant à automatiser le traitement des documents et l'extraction de données.
Extraction de Données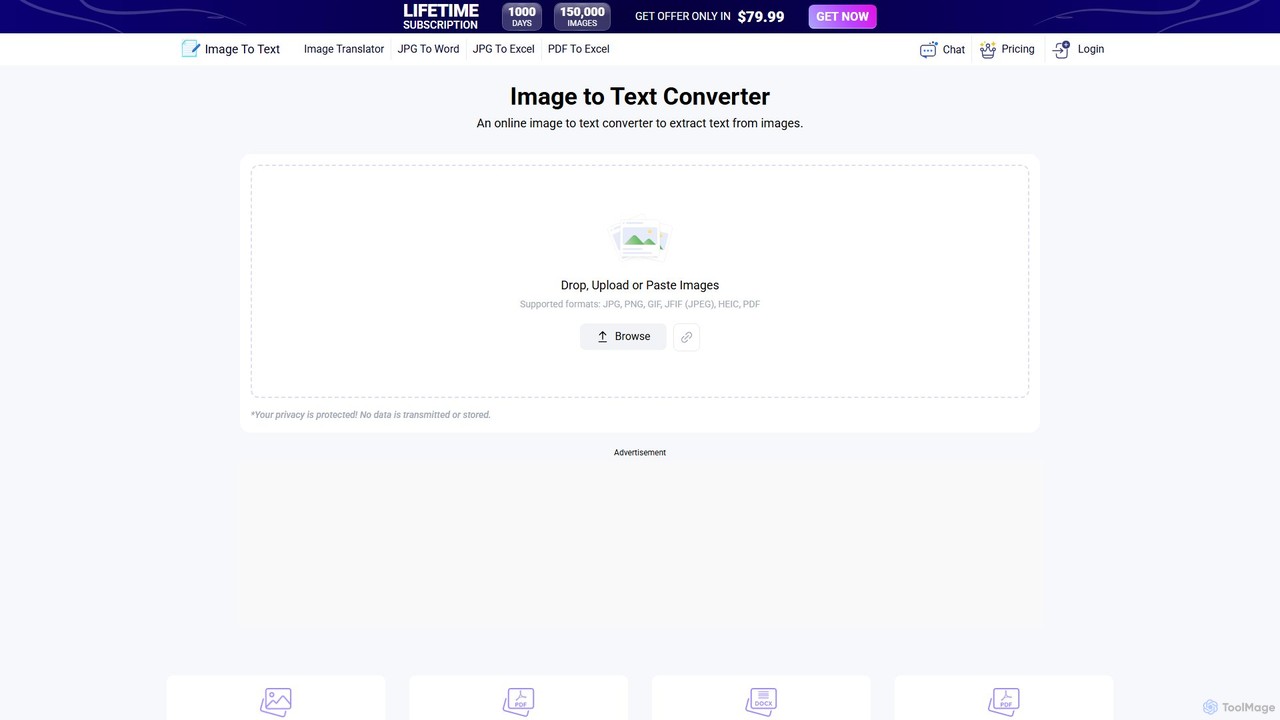
Image to Text
Un outil OCR en ligne gratuit et alimenté par l'IA qui extrait avec précision le texte des images. Il prend en charge de nombreuses langues et formats d'image sans nécessiter d'inscription. Convertissez facilement des images, des documents et des notes en texte modifiable, téléchargez-le en fichier .txt ou copiez-le dans votre presse-papiers.
Prise de notesGPTOCR
GPTOCR est un outil d'extraction de données alimenté par l'IA qui transforme des documents, tels que des PDF, en fichiers JSON structurés. Il automatise la saisie manuelle des données, réduit les erreurs humaines et rationalise les flux de travail, permettant aux équipes de se concentrer sur des tâches à plus forte valeur ajoutée grâce à des données précises et prêtes à l'emploi.
Extraction de données
Imagetotext.io
Un puissant outil d'OCR en ligne qui convertit avec précision les images en texte modifiable. Il prend en charge divers formats, plusieurs langues et extrait même le texte d'images à basse résolution et d'équations mathématiques. Idéal pour les étudiants, les professionnels et toute personne ayant besoin de numériser des documents rapidement et gratuitement.
Outils d'étude
Veryfi
Veryfi est une plateforme avancée alimentée par l'IA qui transforme les documents non structurés comme les reçus, les factures et les chèques en données structurées. Elle offre des API OCR avec une précision inégalée (99,9 %), une vitesse fulgurante et une sécurité de niveau entreprise. Conçue pour les développeurs et les entreprises, elle automatise la saisie de données, détecte la fraude et fournit des informations précieuses dans divers secteurs, notamment la FinTech, les PGC et la Santé.
API
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation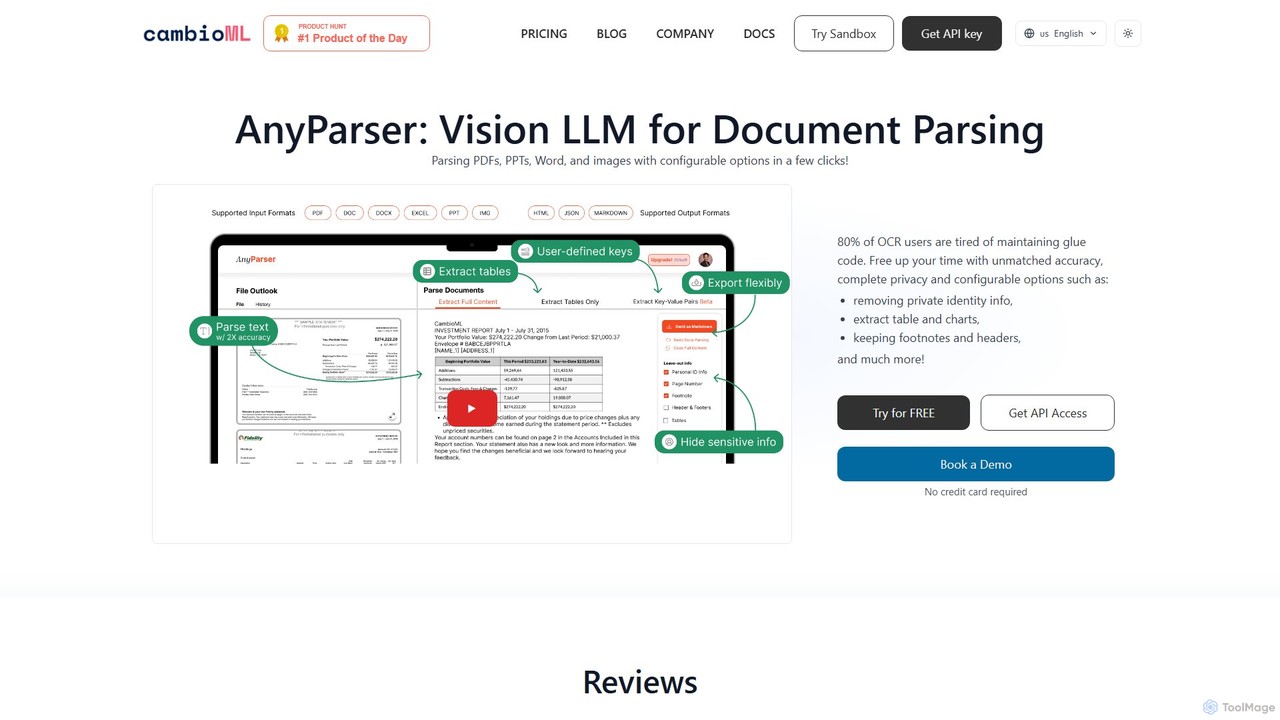
CambioML
CambioML propose l'API AnyParser, un puissant LLM de Vision conçu pour l'analyse de documents de haute précision. Il extrait du texte, des tableaux, des graphiques et des paires clé-valeur à partir de PDF, d'images et de documents Office. Avec des fonctionnalités telles que la rédaction des PII, des sorties configurables et un traitement en temps réel, il est idéal pour les développeurs et les entreprises des secteurs de la finance, de la recherche et de l'analyse de données pour automatiser les flux de travail d'extraction de données tout en garantissant la confidentialité et l'efficacité.
Extraction de Données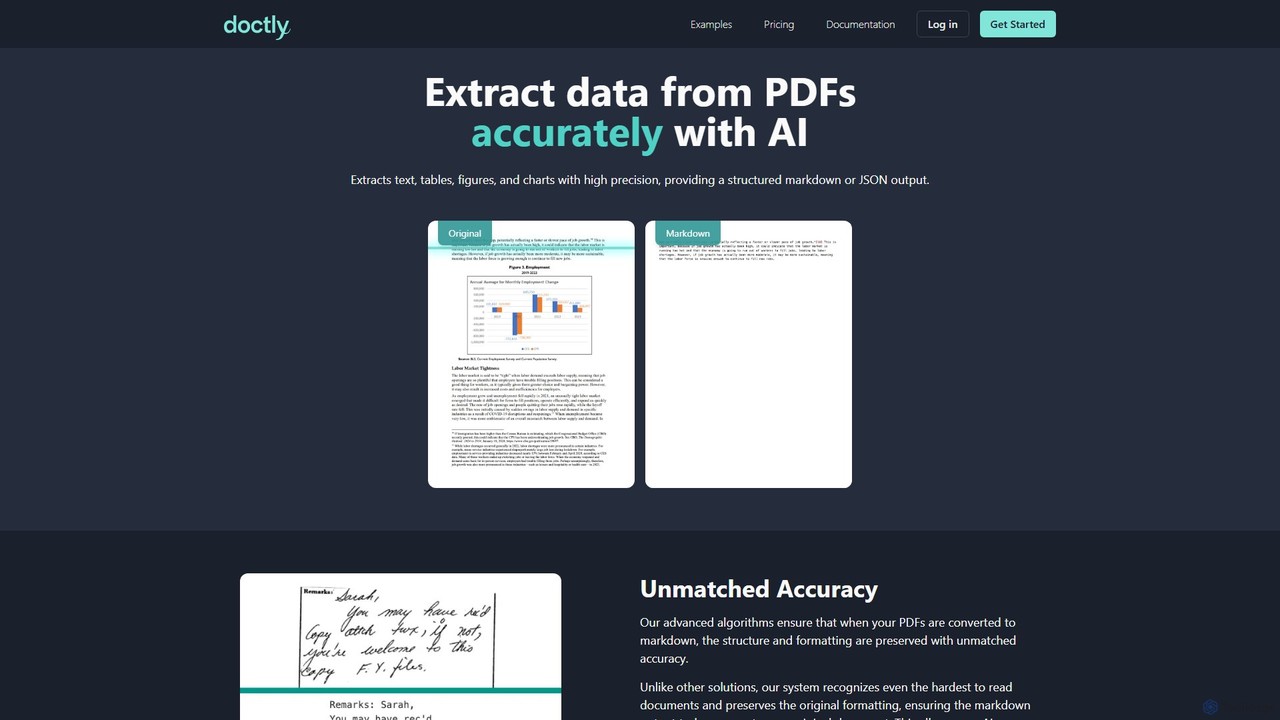
Doctly
Doctly est un outil alimenté par l'IA qui extrait avec précision les données des PDF et autres documents. Il convertit le texte, les tableaux, les figures et les graphiques en Markdown ou JSON structuré, en préservant le formatage original. Avec une API simple et une haute précision, il est conçu pour les développeurs et les entreprises afin d'automatiser les flux de travail de traitement de documents.
Extraction de Données
Expenses Day
Expenses Day est une puissante API d'OCR alimentée par l'IA, conçue pour numériser tout type de document de dépense. Elle extrait avec précision les données des reçus, factures, relevés bancaires et même des listes manuscrites, transformant les documents financiers non structurés en données structurées et exploitables pour les entreprises et les développeurs.
API
PDF.co
PDF.co est une puissante plateforme d'API REST pour les développeurs et les entreprises afin d'automatiser toutes les tâches liées aux PDF. Elle permet l'extraction de données PDF, l'édition, la conversion, la création et le remplissage de formulaires. Dotée d'une analyse de factures alimentée par l'IA et d'une intégration transparente avec plus de 3 000 plateformes comme Zapier et Make, elle aide à éliminer le travail manuel et à rationaliser les flux de travail documentaires.
Automatisation
Mindee
Mindee est une API d'OCR et d'extraction de données alimentée par l'IA pour les développeurs. Elle automatise la saisie de données en analysant et en structurant instantanément les informations de divers documents tels que les factures, les reçus et les passeports. Elle fournit des données JSON structurées, éliminant le travail manuel et améliorant la précision.
Gestion de Documents
Sensible
Sensible est une plateforme de traitement intelligent de documents API-first pour les développeurs. Elle utilise une analyse LLM avancée et des règles basées sur la mise en page visuelle pour extraire avec précision des données structurées de n'importe quel document, tel que des PDF, des images et des feuilles de calcul. Elle est conçue pour une intégration transparente, une évolutivité et une sécurité de niveau entreprise, y compris la conformité SOC 2 et HIPAA.
Automatisation
OCR.space Comments (0)
Sign in to comment.
ConnexionNo comments yet.