
Tensorlake Overview
Tensorlake est un Cloud de Données IA complet conçu pour combler le fossé entre les données brutes non structurées et les applications d'IA avancées. Il sert de plateforme unifiée pour les développeurs et les entreprises afin de transformer de manière fiable des données complexes provenant de diverses sources — y compris les PDF, les images, les notes manuscrites et les feuilles de calcul — en formats structurés et prêts à l'ingestion comme JSON ou markdown. Ce processus est crucial pour alimenter les Grands Modèles de Langage (LLM), améliorer les systèmes de Génération Augmentée par Récupération (RAG) et automatiser les flux de travail métier critiques.
La plateforme repose sur deux piliers fondamentaux : l'API d'Ingestion de Documents et les Workflows Serverless. L'API d'Ingestion de Documents offre des capacités d'analyse quasi humaines, préservant la mise en page originale et l'ordre de lecture des documents tout en extrayant des informations avec une grande précision. Les Workflows Serverless permettent aux utilisateurs de construire et de déployer des pipelines de traitement de données de bout en bout, entièrement gérés, en utilisant Python. Ces workflows sont hautement évolutifs, capables de traiter des millions de documents, et rentables car ils se réduisent à zéro lorsqu'ils sont inactifs.
Comment utiliser Tensorlake
L'utilisation de Tensorlake implique un flux de travail simple et centré sur le développeur :
- Télécharger ou Connecter des Données : Commencez par télécharger des fichiers directement via l'API ou en connectant vos sources de données existantes. La plateforme prend en charge une vaste gamme de types de fichiers.
- Appeler l'API pour le Traitement : Utilisez l'API d'Ingestion de Documents pour traiter vos fichiers. Vous pouvez soit utiliser le point de terminaison 'Parse' pour une conversion de document générale, soit le point de terminaison 'Extract' avec un schéma Pydantic défini pour extraire des données spécifiques et structurées au format JSON.
- Construire des Workflows Personnalisés (Optionnel) : Pour des transformations de données plus complexes, utilisez les Workflows Serverless de Tensorlake. Écrivez des fonctions Python pour définir les étapes de votre pipeline de données, telles que le nettoyage, l'enrichissement et le routage des données extraites vers vos bases de données ou d'autres systèmes.
- Récupérer les Données Traitées : Accédez aux données transformées et structurées instantanément après la fin du travail ou configurez un webhook pour des notifications asynchrones. La sortie est optimisée pour une utilisation dans les applications d'IA.
- Intégrer avec l'IA/LLM : Fournissez les données structurées de haute qualité à vos pipelines RAG, agents IA ou autres modèles d'apprentissage automatique pour améliorer leur précision et leurs capacités.
Fonctionnalités principales de Tensorlake
- API d'Ingestion de Documents : Analyse tout type de fichier, des notes manuscrites aux feuilles de calcul complexes, en préservant la mise en page et le contexte.
- Extraction de Données Structurées : Convertit le contenu non structuré en morceaux propres de JSON ou de markdown en utilisant des schémas Python personnalisés pour une extraction de haute précision.
- Workflows Serverless : Construisez, déployez et mettez à l'échelle des pipelines de traitement de données basés sur Python sans gérer aucune infrastructure. Les workflows s'adaptent automatiquement à la demande.
- Optimisation pour RAG : Produit des morceaux de données structurées enrichies de métadonnées, spécifiquement optimisés pour améliorer la précision et la pertinence des systèmes de Génération Augmentée par Récupération.
- Évolutivité Massive : Conçu pour traiter plus de 100 000 documents par client et par jour et gérer 10 000 événements par seconde avec une latence extrêmement faible.
- Détection de Signature : Une fonctionnalité intégrée pour identifier automatiquement la présence ou l'absence de signatures dans les documents, permettant des déclencheurs d'automatisation intelligents.
- Sécurisé et Collaboratif : Fournit un Contrôle d'Accès Basé sur les Rôles (RBAC), des espaces de noms pour la protection des données et des journaux détaillés pour une visibilité et une conformité complètes.
Cas d'utilisation pour Tensorlake
Tensorlake est idéal pour les applications à enjeux élevés où la précision des données est primordiale :
- Systèmes RAG Avancés : Construisez des pipelines de récupération sophistiqués pour les LLM en combinant la recherche sémantique avec des filtres structurés dérivés du contenu du document (par ex., tableaux, figures, métadonnées).
- Automatisation des Services Financiers : Traitez les demandes de prêt, les documents d'audit fiscal et les états financiers pour extraire des informations clés et automatiser la prise de décision.
- Gestion des Données de Santé : Numérisez et structurez les dossiers des patients, les rapports de laboratoire et les articles de recherche médicale pour l'analyse et la conformité.
- Juridique et Conformité : Analysez les contrats, les titres de propriété et les dépôts légaux pour extraire des clauses, identifier les risques et garantir la conformité.
- Chaîne d'Approvisionnement et Logistique : Traitez les documents de commerce international, les factures et les connaissements pour rationaliser les opérations et améliorer la visibilité.
Avantages de Tensorlake
Tensorlake offre un avantage concurrentiel significatif :
- Précision Inégalée : Ses capacités d'analyse et d'extraction structurée quasi humaines fournissent des données de haute qualité, minimisant les erreurs dans les modèles d'IA.
- Développement Simplifié : L'approche code-first et pilotée par API simplifie la création de pipelines de données complexes, permettant aux équipes de construire plus rapidement.
- Évolutivité Rentable : L'architecture serverless et la tarification transparente à l'usage garantissent que vous ne payez que ce que vous utilisez, ce qui rend la mise à l'échelle économique.
- Plateforme de Bout en Bout : Fournit une solution unique et unifiée pour l'ingestion, la structuration et l'orchestration, éliminant le besoin de pipelines fragiles à outils multiples.
- Flexibilité : S'intègre de manière transparente avec des outils populaires comme LangChain et Qdrant pour améliorer les piles d'IA existantes.
Tarification et plans
Tensorlake propose un modèle de tarification transparent et basé sur l'utilisation, sans frais cachés pour le stockage ou la bande passante.
- Ingestion de Documents : Un tarif simple, à la demande, de 0,01 $ par page.
- Workflows Serverless : Facturé à la seconde en fonction des ressources de calcul consommées :
- Nvidia H100 : 0,0009 $/s
- Nvidia A100 : 0,0005 $/s
- CPU (1 vCPU) : 0,00004 $/s
- Mémoire (DDR4) : 0,00009 $/Go/s
- Sur Site (On-Premise) : Des plans d'entreprise personnalisés sont disponibles pour un déploiement au sein de votre propre réseau. Contactez le service commercial pour plus de détails.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 6.9K
- 2026-1: 50.0K
- 2026-2: 61.4K
- 2026-3: 46.7K
- 2026-4: 46.4K
- 2026-5: 31.5K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis55.2%
- 🇳🇬Nigeria15.5%
- 🇻🇳Viêt Nam11.4%
- 🇮🇩Indonésie9.3%
- 🇮🇳Inde8.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.3% |
Referral | 8.3% |
Email | 6.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| opencode omo claude ekvivalent | $0.00 |
| opencode with everything claude code, direct use | $0.00 |
| tensorlaek | $0.00 |
| tensorlake | $6.31 |
| tensorlake documentation | $0.00 |
Tensorlake Alternatives
ScrapeGraphAI
ScrapeGraphAI est une API de web scraping alimentée par l'IA qui transforme les sites web non structurés en données JSON propres et structurées à l'aide de simples invites en langage naturel. Conçu pour les développeurs, les agents IA et les flux de travail automatisés, il simplifie l'extraction de données sans code complexe.
Analyse
boundaryml
boundaryml (BAML) est un langage de programmation et une boîte à outils spécialisés permettant aux développeurs d'extraire de manière fiable des données structurées à partir de grands modèles de langage (LLM). Il transforme l'ingénierie complexe des prompts en un processus rationalisé, semblable à du code, garantissant des sorties typées et corrigées des erreurs sur divers LLM et langages de programmation comme Python et TypeScript. Il est conçu pour améliorer la fiabilité, réduire les coûts et accélérer les cycles de développement des applications d'IA.
API
Eventual
Eventual construit l'avenir de l'infrastructure de données avec Daft, un moteur de requête open-source haute performance pour les données multimodales. Il permet aux ingénieurs de traiter des images, des vidéos, de l'audio et du texte à l'échelle du pétaoctet avec la simplicité de SQL, accélérant considérablement les flux de travail d'IA et de ML sans nécessiter une expertise approfondie des systèmes distribués.
Apprentissage Automatique
Apify
Apify est une plateforme full-stack de web scraping et d'automatisation qui permet aux développeurs de créer, déployer et publier des outils d'extraction de données, appelés 'Actors'. Elle offre une vaste place de marché de scrapers pré-construits pour des sites populaires comme Google Maps, Instagram et TikTok, ainsi qu'une infrastructure cloud robuste pour créer des solutions personnalisées. Avec le support de Python et JavaScript, de bibliothèques open-source et d'intégrations transparentes, Apify simplifie la collecte de données web à toute échelle.
Collecte de Données
Firecrawl
Firecrawl est une API open-source, axée sur les développeurs, qui transforme n'importe quel site web en données propres et prêtes pour les LLM. Elle gère toutes les complexités du web scraping, y compris le rendu JavaScript, la rotation de proxy et les limites de taux, vous permettant d'alimenter des applications d'IA, des agents et des systèmes RAG avec un contenu web fiable. Elle offre des fonctionnalités de scraping, de crawling et de recherche via une API simple.
Collecte de donnéesTensorlake Categories
Tensorlake Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
ScrapeGraphAI
ScrapeGraphAI est une API de web scraping alimentée par l'IA qui transforme les sites web non structurés en données JSON propres et structurées à l'aide de simples invites en langage naturel. Conçu pour les développeurs, les agents IA et les flux de travail automatisés, il simplifie l'extraction de données sans code complexe.
Analyseboundaryml
boundaryml (BAML) est un langage de programmation et une boîte à outils spécialisés permettant aux développeurs d'extraire de manière fiable des données structurées à partir de grands modèles de langage (LLM). Il transforme l'ingénierie complexe des prompts en un processus rationalisé, semblable à du code, garantissant des sorties typées et corrigées des erreurs sur divers LLM et langages de programmation comme Python et TypeScript. Il est conçu pour améliorer la fiabilité, réduire les coûts et accélérer les cycles de développement des applications d'IA.
APIApify
Apify est une plateforme full-stack de web scraping et d'automatisation qui permet aux développeurs de créer, déployer et publier des outils d'extraction de données, appelés 'Actors'. Elle offre une vaste place de marché de scrapers pré-construits pour des sites populaires comme Google Maps, Instagram et TikTok, ainsi qu'une infrastructure cloud robuste pour créer des solutions personnalisées. Avec le support de Python et JavaScript, de bibliothèques open-source et d'intégrations transparentes, Apify simplifie la collecte de données web à toute échelle.
Collecte de DonnéesFirecrawl
Firecrawl est une API open-source, axée sur les développeurs, qui transforme n'importe quel site web en données propres et prêtes pour les LLM. Elle gère toutes les complexités du web scraping, y compris le rendu JavaScript, la rotation de proxy et les limites de taux, vous permettant d'alimenter des applications d'IA, des agents et des systèmes RAG avec un contenu web fiable. Elle offre des fonctionnalités de scraping, de crawling et de recherche via une API simple.
Collecte de données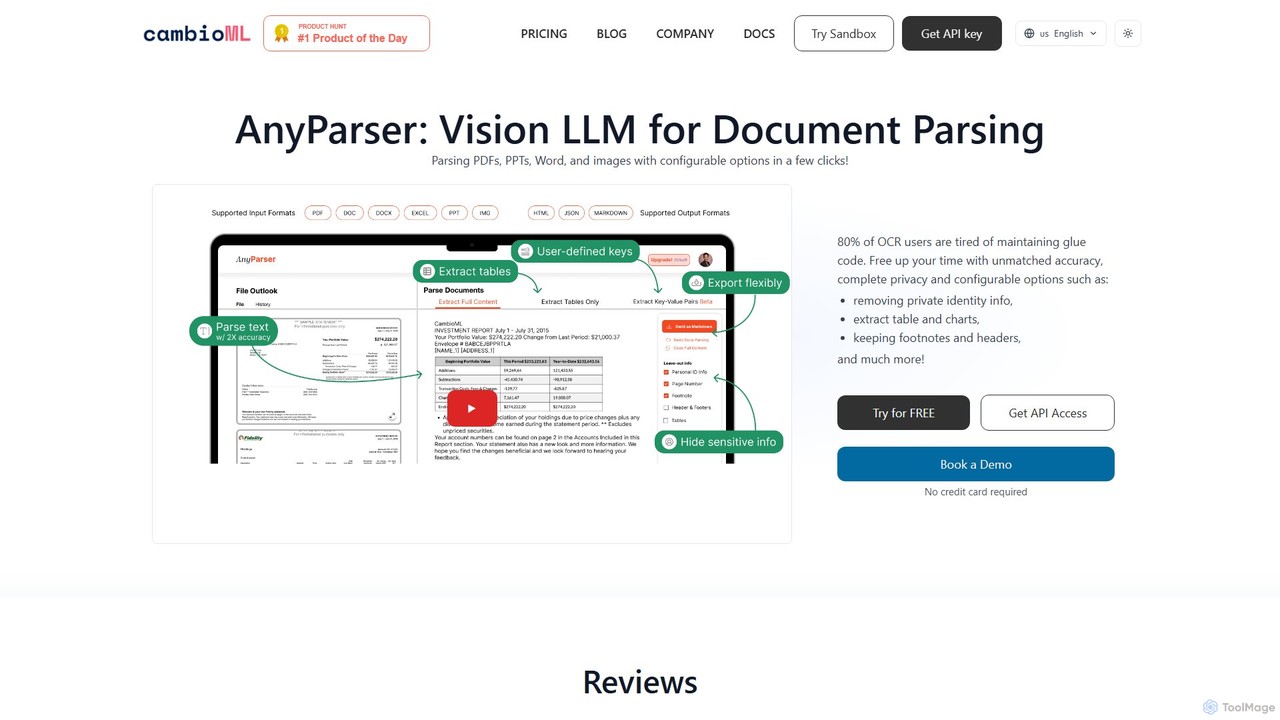
CambioML
CambioML propose l'API AnyParser, un puissant LLM de Vision conçu pour l'analyse de documents de haute précision. Il extrait du texte, des tableaux, des graphiques et des paires clé-valeur à partir de PDF, d'images et de documents Office. Avec des fonctionnalités telles que la rédaction des PII, des sorties configurables et un traitement en temps réel, il est idéal pour les développeurs et les entreprises des secteurs de la finance, de la recherche et de l'analyse de données pour automatiser les flux de travail d'extraction de données tout en garantissant la confidentialité et l'efficacité.
Extraction de Données
Ducky
Ducky est une infrastructure de recherche IA entièrement gérée, conçue pour les développeurs. Elle simplifie la mise en œuvre de la Génération Augmentée par la Récupération (RAG) en gérant des tâches complexes comme le découpage des données, l'intégration (embedding) et le reclassement. Avec un SDK Python simple, Ducky permet aux développeurs de créer rapidement des capacités de recherche sémantique rapides, précises et évolutives dans leurs applications, fournissant des réponses contextuelles et sans hallucination des LLM.
Génération Augmentée par Récupération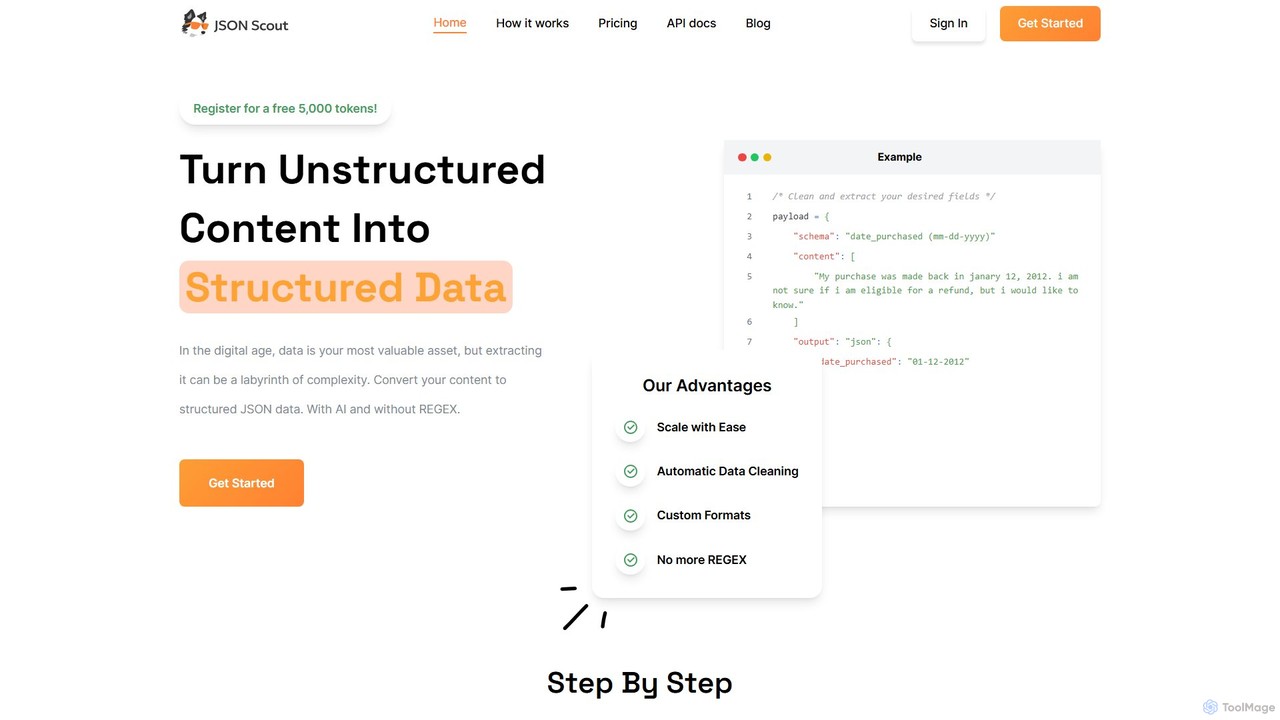
JSON Scout
JSON Scout est une API alimentée par l'IA pour les développeurs qui transforme le contenu textuel et audio non structuré en données JSON structurées. Elle exploite les grands modèles de langage (LLM) comme GPT-4o pour éliminer le besoin d'expressions régulières (REGEX) complexes, économisant ainsi du temps de développement et améliorant la précision de l'extraction de données.
Traitement des données
vocode
Vocode est une plateforme open-source pour construire, déployer et faire évoluer des agents IA vocaux hyperréalistes. Elle fournit aux développeurs un framework de base et une API de niveau entreprise pour créer des applications LLM sophistiquées basées sur la voix pour des tâches telles que le service client automatisé, les appels de vente et les systèmes de réponse vocale interactive (SVI).
Bot vocal
Modal
Modal est une plateforme d'infrastructure sans serveur haute performance pour les développeurs IA et ML. Elle vous permet d'exécuter des fonctions Python dans le cloud avec une seule ligne de code, offrant un accès instantané aux GPU, une mise à l'échelle automatique de zéro à des milliers de conteneurs et une tarification à la seconde. Éliminez la surcharge d'infrastructure et concentrez-vous sur la création et le déploiement d'applications gourmandes en calcul comme l'IA générative, le traitement par lots et l'analyse de données.
Déploiement de modèle
Exa
Exa est un moteur de recherche et une API nativement IA conçus pour les LLM. Il fournit des données web de haute qualité en temps réel grâce à la recherche sémantique, au crawling de contenu et à des capacités de recherche agentique pour alimenter les applications d'IA, réduire les hallucinations et découvrir des informations que les moteurs de recherche traditionnels ne trouvent pas.
Moteur de recherche
Jina AI
Jina AI fournit une plateforme de Fondation de Recherche de pointe, offrant une suite d'API puissantes pour les embeddings multimodaux, le reclassement et l'extraction de données. Elle est conçue pour les développeurs et les entreprises afin de créer des applications d'IA générative de haute qualité, RAG (Génération Augmentée par la Récupération) et de recherche avancée avec des capacités multilingues et multimodales.
Modèle de langage
Langflow
Langflow est une interface utilisateur visuelle open-source pour créer et déployer des applications d'IA. Elle dispose d'une interface glisser-déposer pour enchaîner les LLM, les agents et les outils, permettant un prototypage et un déploiement rapides de flux de travail complexes comme les systèmes RAG et multi-agents. Elle prend en charge de nombreuses intégrations et offre des options auto-hébergées et cloud.
Low-code No-code
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
supermemory
supermemory est une API de mémoire et une infrastructure pour l'ère de l'IA, conçue pour les développeurs afin de construire des LLM avec une mémoire persistante à long terme. Elle surmonte la limitation de la fenêtre de contexte finie, permettant la création d'agents IA intelligents et conscients du contexte, de chatbots et d'applications qui se souviennent des interactions passées et des informations sur diverses plateformes.
LLM
phidata
phidata est un framework Python open-source pour construire des Assistants IA autonomes. Il simplifie l'intégration des LLM avec la mémoire, les bases de connaissances et les outils externes, permettant aux développeurs de créer facilement des applications IA puissantes et avec état.
Frameworks
Tensorlake Comments (0)
Sign in to comment.
ConnexionNo comments yet.