
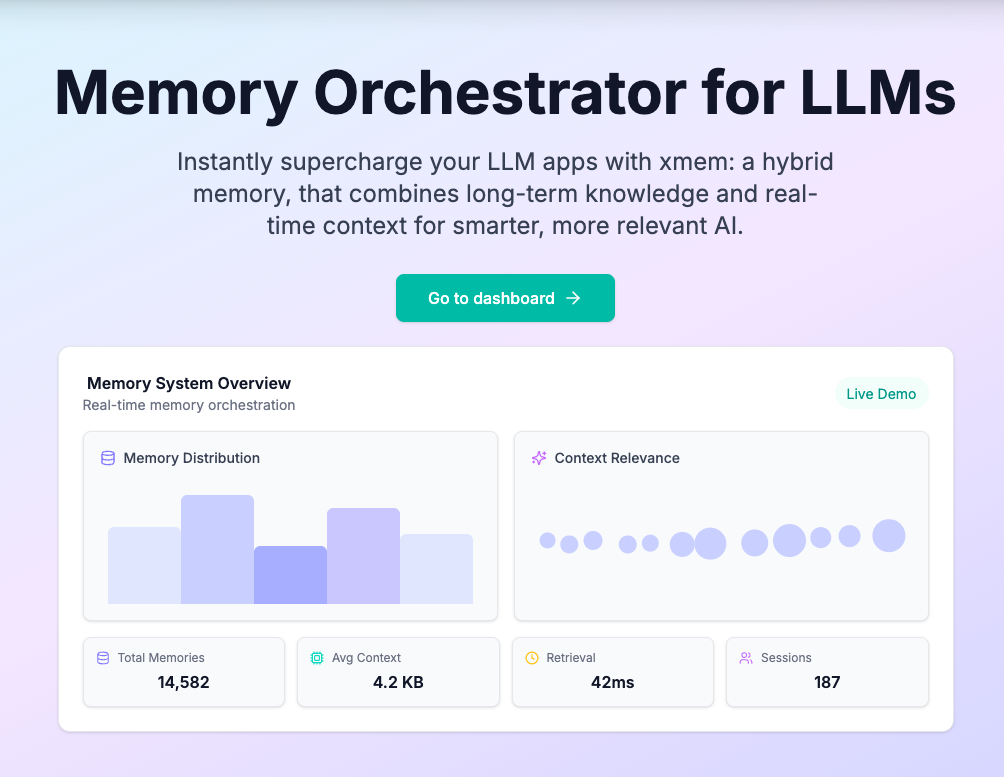
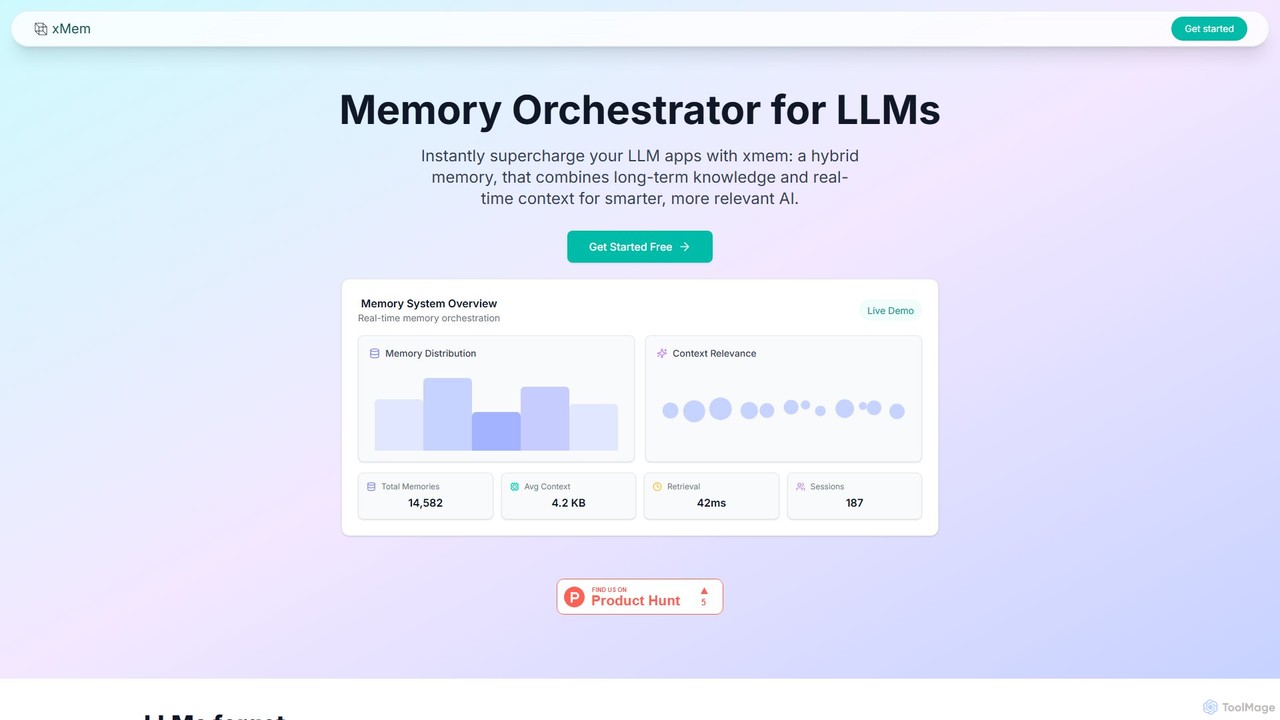
xMem Overview
xMem est un orchestrateur de mémoire sophistiqué conçu pour les développeurs qui créent des applications avec des grands modèles de langage (LLM). Il s'attaque à l'un des défis les plus importants du développement de l'IA : l'oubli inhérent des LLM. En fournissant un système de mémoire hybride, xMem garantit que les applications d'IA peuvent maintenir le contexte et les connaissances non seulement au sein d'une seule session, mais aussi à travers de multiples interactions au fil du temps.
La plateforme fonctionne en combinant intelligemment deux types de mémoire. La mémoire à long terme stocke et récupère des informations persistantes comme des documents, l'historique de l'utilisateur et des connaissances fondamentales en utilisant la recherche vectorielle, s'intégrant avec des bases de données vectorielles populaires telles que Qdrant, ChromaDB et Pinecone. Simultanément, la mémoire de session suit le contexte immédiat de la conversation en cours, y compris les messages et instructions récents, pour la personnalisation et la récence. La couche d'orchestration RAG (Retrieval-Augmented Generation) de xMem assemble automatiquement le contexte le plus pertinent des deux magasins de mémoire pour chaque appel au LLM, éliminant le besoin de réglage manuel et augmentant considérablement la précision et la pertinence des réponses de l'IA.
Comment utiliser xMem
L'intégration de xMem dans une application LLM est conçue pour être un processus simple pour les développeurs :
- Configuration et Installation : Commencez par choisir vos composants préférés. xMem est favorable à l'open-source et prend en charge divers fournisseurs de LLM (comme OpenAI, Llama.cpp, Ollama), des bases de données vectorielles (Qdrant, ChromaDB) et des magasins de session (en mémoire, MongoDB).
- Installation : Installez le SDK xMem dans votre projet. Le SDK principal est disponible pour les environnements TypeScript/JavaScript.
- Instanciation : Dans le code de votre application, créez une instance de l'orchestrateur xMem. Vous passerez vos configurations choisies pour le magasin de vecteurs, le magasin de session et le fournisseur de LLM lors de cette étape d'initialisation.
- Requête : Au lieu d'appeler directement le LLM, vous utilisez la méthode `orchestrator.query()` de xMem. Lorsque vous envoyez la requête d'un utilisateur via cette méthode, xMem gère automatiquement le processus complexe de récupération des connaissances pertinentes à long terme et du contexte de session récent, de leur empaquetage et de leur envoi au LLM.
- Surveillance : Utilisez le tableau de bord de xMem pour surveiller les performances du système. Le tableau de bord fournit des informations sur la distribution de la mémoire, la pertinence du contexte, la latence de récupération et les sessions actives. Il dispose également d'un graphe de connaissances pour visualiser les connexions entre différentes informations.
Fonctionnalités principales de xMem
- Système de Mémoire Hybride : Combine de manière transparente la mémoire persistante à long terme (via des bases de données vectorielles) et la mémoire de session volatile à court terme pour un contexte complet.
- Orchestration RAG Automatisée : Récupère et assemble intelligemment le contexte optimal pour chaque requête, améliorant la qualité de la réponse sans intervention manuelle.
- Graphe de Connaissances : Visualise les relations entre les concepts, les faits et le contexte de l'utilisateur en temps réel, permettant au LLM d'effectuer des raisonnements et des rappels plus complexes.
- Priorité à l'Open-Source : Conçu pour fonctionner avec n'importe quel LLM open-source (par exemple, Llama, Mistral) et base de données vectorielle, offrant une flexibilité maximale et évitant la dépendance vis-à-vis d'un fournisseur.
- Intégration sans Effort : Fournit une API simple et un tableau de bord complet pour une intégration, une surveillance et une gestion faciles du système de mémoire.
- Contexte Utilisateur Persistant : Résout le problème de la perte de contexte en s'assurant que l'IA se souvient des détails de l'utilisateur, des informations sur le projet et des conversations passées entre les sessions.
Cas d'utilisation pour xMem
xMem est idéal pour toute application où la mémoire contextuelle est cruciale pour une expérience utilisateur de haute qualité :
- Chatbots et Assistants Virtuels Avancés : Créez des assistants qui se souviennent des préférences de l'utilisateur, des conversations passées et des détails personnels, offrant une expérience véritablement personnalisée.
- Copilotes IA pour le Développement et le Travail : Construisez des copilotes qui maintiennent le contexte d'un projet, d'une base de code ou de discussions d'équipe, fournissant une aide pertinente sans avoir besoin de rappels constants.
- Agents de Support Client Intelligents : Déployez des agents d'IA qui ont accès à l'historique complet des interactions d'un client, leur permettant de fournir un support transparent et éclairé.
- Gestion des Connaissances Personnalisée : Développez des systèmes qui non seulement recherchent des documents, mais comprennent également le contexte de recherche de l'utilisateur, en reliant les nouvelles requêtes aux découvertes précédentes.
Avantages de xMem
Le principal avantage de xMem est sa capacité à rendre les applications LLM beaucoup plus intelligentes et conviviales. En donnant aux LLM une mémoire fiable, il évite les situations frustrantes où les utilisateurs doivent se répéter. Sa nature open-source offre flexibilité et contrôle aux développeurs. L'orchestration automatisée simplifie la tâche complexe de gestion du contexte pour les pipelines RAG, économisant du temps et des efforts de développement. En fin de compte, xMem améliore la précision des LLM, augmente l'engagement des utilisateurs et libère le potentiel pour des agents et copilotes IA plus sophistiqués.
Tarification et plans
xMem fonctionne sur un modèle freemium. Il offre un niveau gratuit généreux qui permet aux développeurs de démarrer et d'intégrer l'orchestrateur de mémoire dans leurs projets. Pour les applications ayant des besoins à plus grande échelle, des limites d'utilisation plus élevées ou des fonctionnalités d'entreprise avancées, des plans payants devraient être disponibles. Les détails spécifiques sur les niveaux et la tarification peuvent être trouvés sur le site officiel.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-8: 65
- 2025-9: 367
- 2026-3: 0
- 2026-4: 0
- 2026-5: 616
Geography
Top 5 countries / regions
- 🇺🇸États-Unis100.0%
Top keywords
| Keyword | Cost per click |
|---|---|
| xme ai | $0.00 |
xMem Alternatives
MyScale Chat
MyScale Chat est une plateforme alimentée par l'IA qui permet aux utilisateurs de créer des chatbots personnalisés en discutant avec leurs propres données. S'appuyant sur la base de données vectorielle haute performance MyScale, elle fournit des informations instantanées, sécurisées et précises à partir de documents, de sites web ou de bases de connaissances. Elle est conçue pour les développeurs et les entreprises afin de créer des applications sophistiquées de RAG (Génération Augmentée par Récupération), transformant les données privées en agents conversationnels interactifs et intelligents.
Analyse de documents
Zep
Zep est une plateforme d'ingénierie de contexte pour les développeurs qui créent des agents IA. Elle fournit une mémoire à long terme et des capacités avancées de Graph RAG, permettant aux agents de se souvenir des préférences de l'utilisateur, de l'historique des conversations et des données commerciales dynamiques. En construisant automatiquement des graphes de connaissances temporels, Zep fournit un contexte pertinent et efficace en jetons aux LLM, ce qui se traduit par des interactions IA plus rapides, plus précises et hautement personnalisées.
Constructeur d'Agents
Morphik
Morphik est une plateforme de développement avancée pour créer des systèmes de Génération Augmentée par la Récupération (RAG) et des agents IA de haute précision. Elle se spécialise dans l'élimination des hallucinations en utilisant une récupération visuelle prioritaire pour comprendre des documents complexes et spécifiques à un domaine, y compris les diagrammes et les schémas. Déployable en seulement deux lignes de code, elle offre des performances, une vitesse et une évolutivité supérieures pour les applications IA d'entreprise.
Entreprise
Lettria
Lettria est une plateforme d'IA d'entreprise dotée de la technologie GraphRAG. Elle améliore la Génération Augmentée par la Récupération (RAG) en combinant des graphes de connaissances avec des bases de données vectorielles pour fournir des réponses précises, vérifiables et transparentes à partir de données complexes et non structurées. Conçue pour des secteurs comme la santé, la finance et le juridique, elle élimine les hallucinations de l'IA et renforce la confiance dans les applications critiques.
Intelligence Documentaire
Pinecone
Pinecone est une base de données vectorielle haute performance et entièrement gérée, conçue pour créer des applications d'IA expertes à grande échelle. Elle permet aux développeurs de mettre en œuvre des fonctionnalités avancées telles que la recherche sémantique, la génération augmentée par récupération (RAG) et les recommandations personnalisées en stockant et en interrogeant efficacement des milliards d'embeddings vectoriels en temps réel.
Base de donnéesxMem Categories
xMem Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
AnythingLLM
AnythingLLM est une application IA open-source tout-en-un qui s'exécute localement sur votre bureau ou peut être auto-hébergée. Elle vous permet de créer une base de connaissances privée à partir de n'importe quel document, de discuter avec vos données et d'utiliser de puissants agents IA tout en garantissant une confidentialité et un contrôle total des données.
Gestion de Documents
Embedding.io
Une plateforme alimentée par l'IA qui transforme n'importe quel site web en une base de connaissances interactive et interrogeable pour les grands modèles de langage (LLM). Créez facilement des chatbots personnalisés, des fonctions de recherche par IA et des systèmes de support automatisés en fournissant une simple URL. Elle gère le crawling, l'embedding et l'intégration API.
Rechercher
phidata
phidata est un framework Python open-source pour construire des Assistants IA autonomes. Il simplifie l'intégration des LLM avec la mémoire, les bases de connaissances et les outils externes, permettant aux développeurs de créer facilement des applications IA puissantes et avec état.
FrameworksMyScale Chat
MyScale Chat est une plateforme alimentée par l'IA qui permet aux utilisateurs de créer des chatbots personnalisés en discutant avec leurs propres données. S'appuyant sur la base de données vectorielle haute performance MyScale, elle fournit des informations instantanées, sécurisées et précises à partir de documents, de sites web ou de bases de connaissances. Elle est conçue pour les développeurs et les entreprises afin de créer des applications sophistiquées de RAG (Génération Augmentée par Récupération), transformant les données privées en agents conversationnels interactifs et intelligents.
Analyse de documents
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
Chroma
Chroma est la base de données de recherche open-source et native pour l'IA, conçue pour créer de puissantes applications d'IA avec la Génération Augmentée par la Récupération (RAG). Elle simplifie le stockage et la recherche d'embeddings, de documents et de métadonnées, offrant une recherche vectorielle, une recherche plein texte et une plateforme cloud évolutive et sans serveur. Elle est conçue pour être simple d'utilisation, rentable et puissante, du développement local à la production à grande échelle.
Base de données vectorielle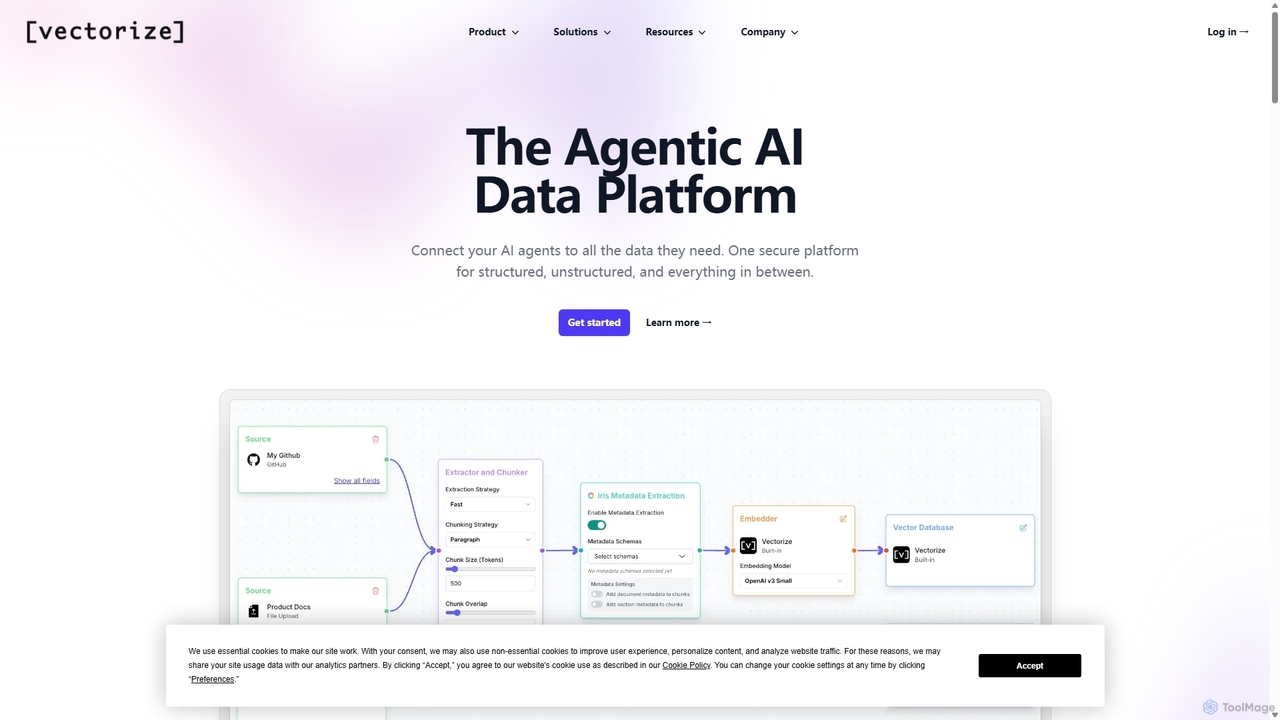
Vectorize
Vectorize est une plateforme RAG-as-a-Service qui simplifie la création d'applications d'IA sur des données non structurées. Elle offre des pipelines RAG gérés, de nombreux connecteurs de sources de données et la flexibilité d'utiliser sa base de données vectorielle gérée ou de connecter la vôtre, permettant aux développeurs de déployer rapidement des solutions d'IA prêtes pour la production.
Chiffon
supermemory
supermemory est une API de mémoire et une infrastructure pour l'ère de l'IA, conçue pour les développeurs afin de construire des LLM avec une mémoire persistante à long terme. Elle surmonte la limitation de la fenêtre de contexte finie, permettant la création d'agents IA intelligents et conscients du contexte, de chatbots et d'applications qui se souviennent des interactions passées et des informations sur diverses plateformes.
LLM
Weaviate
Weaviate est une base de données vectorielle open-source et native IA conçue pour les développeurs. Elle permet une recherche vectorielle, par mot-clé et hybride, évolutive et à faible latence. Idéale pour créer des applications d'IA telles que la recherche sémantique, les moteurs de recommandation et les systèmes de Génération Augmentée par Récupération (RAG), elle s'intègre de manière transparente avec les modèles de machine learning populaires pour stocker et interroger des données en fonction de leur signification sémantique.
Base de données vectorielle
ragie
Ragie est une plateforme RAG-as-a-Service entièrement gérée, conçue pour les développeurs. Elle simplifie le processus de création et de déploiement d'applications d'IA en gérant l'ensemble du pipeline de Génération Augmentée par la Récupération (Retrieval-Augmented Generation). Connectez vos sources de données et utilisez une API simple pour alimenter des chatbots précis et contextuels, une recherche sémantique et des systèmes de gestion des connaissances, sans la complexité de la gestion de l'infrastructure.
Apprentissage automatique
infiniflow
infiniflow est une base de données open-source, native de l'IA et à haute performance, spécialement conçue pour les applications LLM. Elle offre une recherche vectorielle incroyablement rapide, de puissantes capacités de recherche hybride (vecteur, texte intégral, tenseur) et un déploiement simplifié. Avec une API Python intuitive, elle est conçue pour alimenter des tâches d'IA exigeantes comme la Génération Augmentée par Récupération (RAG) et la recherche sémantique avec une latence de l'ordre de la milliseconde.
Recherche vectorielle
PostgresML
PostgresML est une puissante extension open-source qui intègre l'apprentissage automatique et l'IA directement dans votre base de données PostgreSQL. Elle permet l'inférence accélérée par GPU, la recherche vectorielle et des pipelines RAG complets à l'aide de simples commandes SQL, éliminant le mouvement des données et simplifiant la pile MLOps pour des applications IA performantes et évolutives.
MLOps
Superpowered AI
Superpowered AI est une plateforme qui améliore les grands modèles de langage (LLM) en les connectant de manière sécurisée à vos données privées. Elle permet aux développeurs et aux entreprises de créer des applications d'IA très précises et citées, comme des chatbots, des outils de recherche et des générateurs de contenu, via une API flexible et une interface intuitive sans code.
Chatbots
Firecrawl
Firecrawl est une API open-source, axée sur les développeurs, qui transforme n'importe quel site web en données propres et prêtes pour les LLM. Elle gère toutes les complexités du web scraping, y compris le rendu JavaScript, la rotation de proxy et les limites de taux, vous permettant d'alimenter des applications d'IA, des agents et des systèmes RAG avec un contenu web fiable. Elle offre des fonctionnalités de scraping, de crawling et de recherche via une API simple.
Collecte de données
LobeHub
LobeHub est une plateforme d'IA tout-en-un qui vous permet de construire et de gérer une équipe personnalisée d'Agents IA. Elle offre une expérience utilisateur supérieure aux interfaces LLM standard comme ChatGPT, avec un support pour de nombreux modèles, plugins et interactions multimodales. Créez, partagez et utilisez des agents spécialisés pour des tâches allant du codage et de la rédaction à la recherche académique et à la vie quotidienne, le tout au sein d'une seule interface de chat intuitive.
Plateforme de chatbot
xMem Comments (0)
Sign in to comment.
ConnexionNo comments yet.