Freemium
Bilberrydb
Bilberrydbは、高度なAIアプリケーションを構築するために設計されたエンタープライズグレードのマルチモーダルベクトルデータベースです。統一されたプラットフォーム上で、3Dモデル、画像、動画、音声、テキスト、表形式データなど、多様なデータタイプにわたる超高速の埋め込み検索を可能にします。
ベクトルデータベースVisits 6.9KFavorites 125Likes 145
Popular ベクトルデータベース AI tools in AIインフラ include MongoDB、Chroma、SingleStore、Weaviate、SurrealDB、LanceDB、TiDB Cloud、MyScale、Rivestack、Bilberrydb, helping you work more efficiently.
Bilberrydbは、高度なAIアプリケーションを構築するために設計されたエンタープライズグレードのマルチモーダルベクトルデータベースです。統一されたプラットフォーム上で、3Dモデル、画像、動画、音声、テキスト、表形式データなど、多様なデータタイプにわたる超高速の埋め込み検索を可能にします。
ベクトルデータベース
AIアプリケーション向けに最適化された、EUでホストされるマネージドPostgreSQLデータベースサービスです。ベクトル検索用のpgvector、自動スケーリング、バックアップ、透明な価格設定を備えた完全自動デプロイメントを提供し、開発者が数分で本番環境対応のデータベースを立ち上げることを可能にします。
ベクトルデータベース
Weaviateは、開発者向けに設計されたオープンソースのAIネイティブなベクトルデータベースです。スケーラブルで低遅延なベクトル、キーワード、ハイブリッド検索を可能にします。セマンティック検索、推薦エンジン、検索拡張生成(RAG)システムなどのAIアプリケーションの構築に最適で、人気の機械学習モデルとシームレスに統合し、意味的な意味に基づいてデータを保存・クエリします。
ベクトルデータベース
TiDB Cloudは、フルマネージドの分散型SQLデータベース・アズ・ア・サービス(DBaaS)です。水平スケーラビリティ、MySQL互換性、およびハイブリッドトランザクション/分析処理(HTAP)機能を提供します。最新のデータ集約型アプリケーションやAI搭載サービスの構築に最適で、データベース運用を簡素化し、リアルタイムトランザクションとAIベクトル検索を含む複雑な分析の両方を必要とするアプリケーションに強力なバックエンドを提供します。
ベクトルデータベース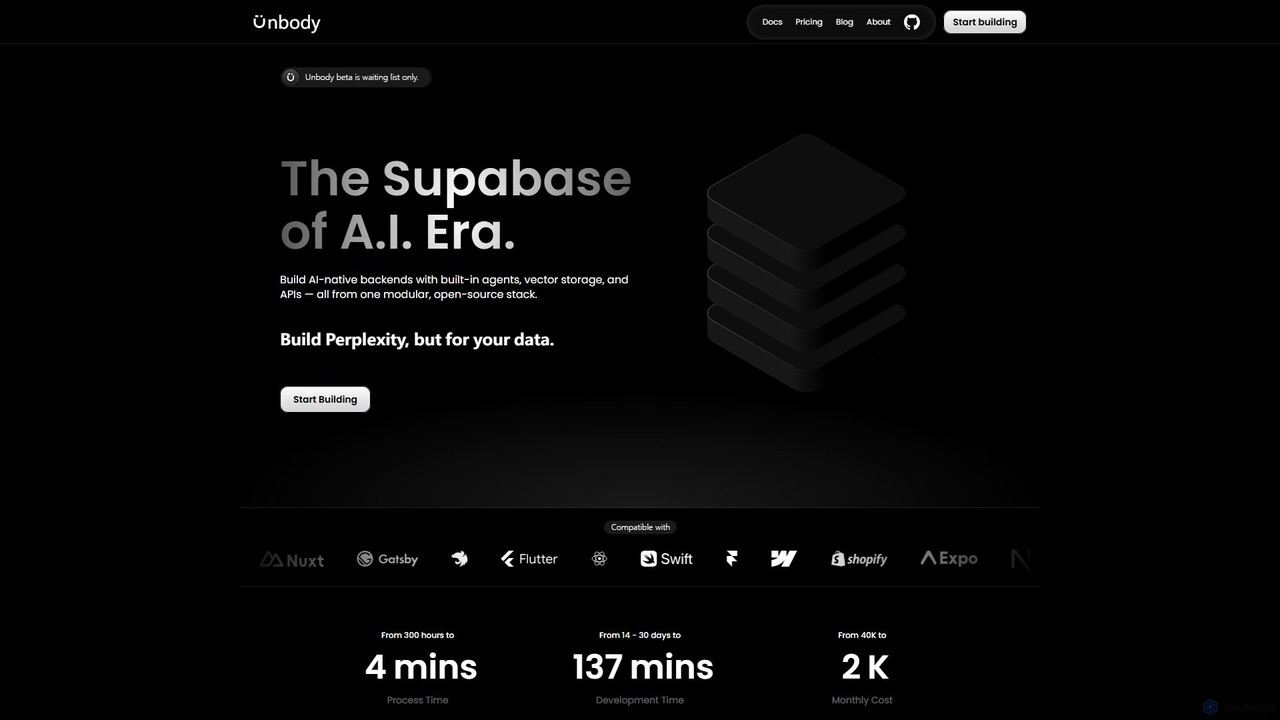
Unbodyは「AI時代のSupabase」と称されるAIネイティブ開発スタックです。開発者向けに、組み込みエージェント、ベクトルストレージ、統一APIを備えたモジュラーなオープンソースバックエンドを提供します。これにより、あらゆるデータをクエリ可能な知識ベースに変換し、断片化したシステムや複雑なAIパイプラインを不要にし、インテリジェントで適応性のあるアプリケーションを迅速かつコスト効率よく構築できます。
ベクトルデータベース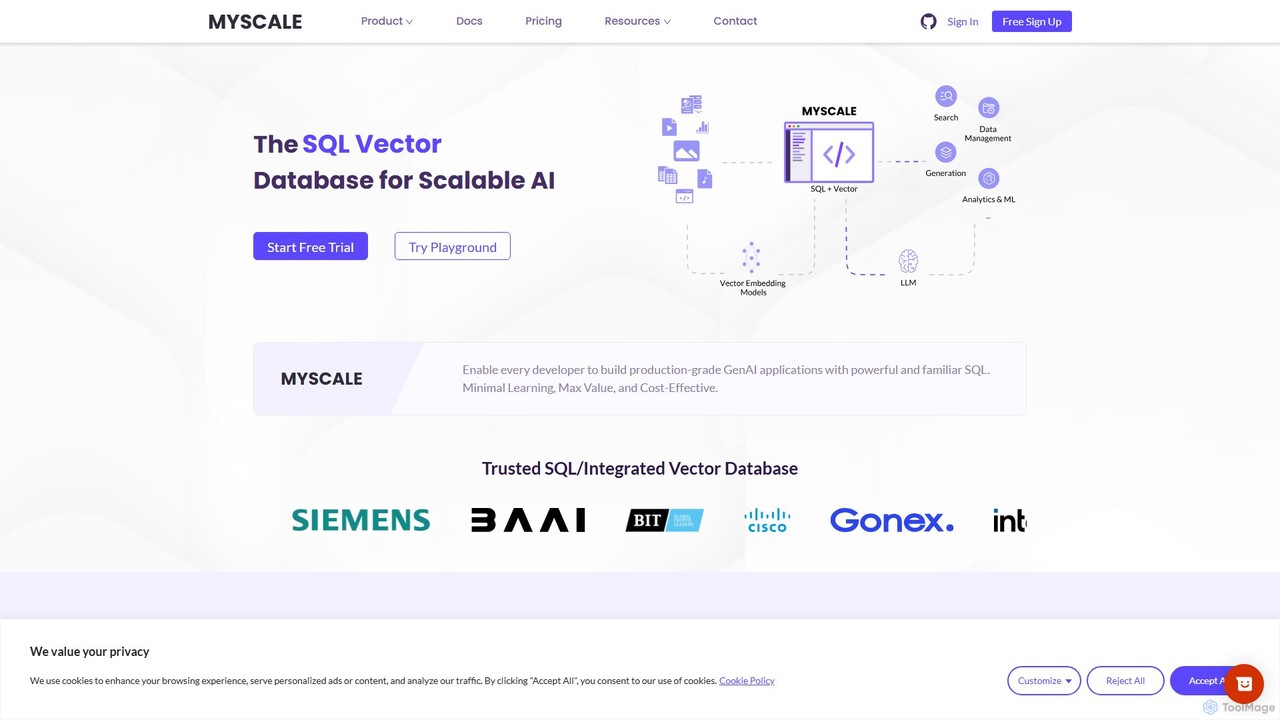
MyScaleは、ベクトル検索と強力なSQLの機能を独自に組み合わせた高性能なベクトルデータベースです。RAG、セマンティック検索、推薦システムなどの高度なAIアプリケーションの構築用に設計されており、開発者が単一の使い慣れたインターフェースを使用してベクトルと構造化データに対するハイブリッドクエリを実行できるようにすることで、技術スタックを簡素化します。
ベクトルデータベース
SingleStoreは、エンタープライズAIおよびデータ集約型アプリケーション向けに設計された高性能リアルタイムデータプラットフォームです。単一の分散SQLデータベースで、ベクトル検索を含むトランザクション(OLTP)と分析(OLAP)のワークロードを統合し、ミリ秒単位のレイテンシと大規模なスケーラビリティを実現します。
ベクトルデータベース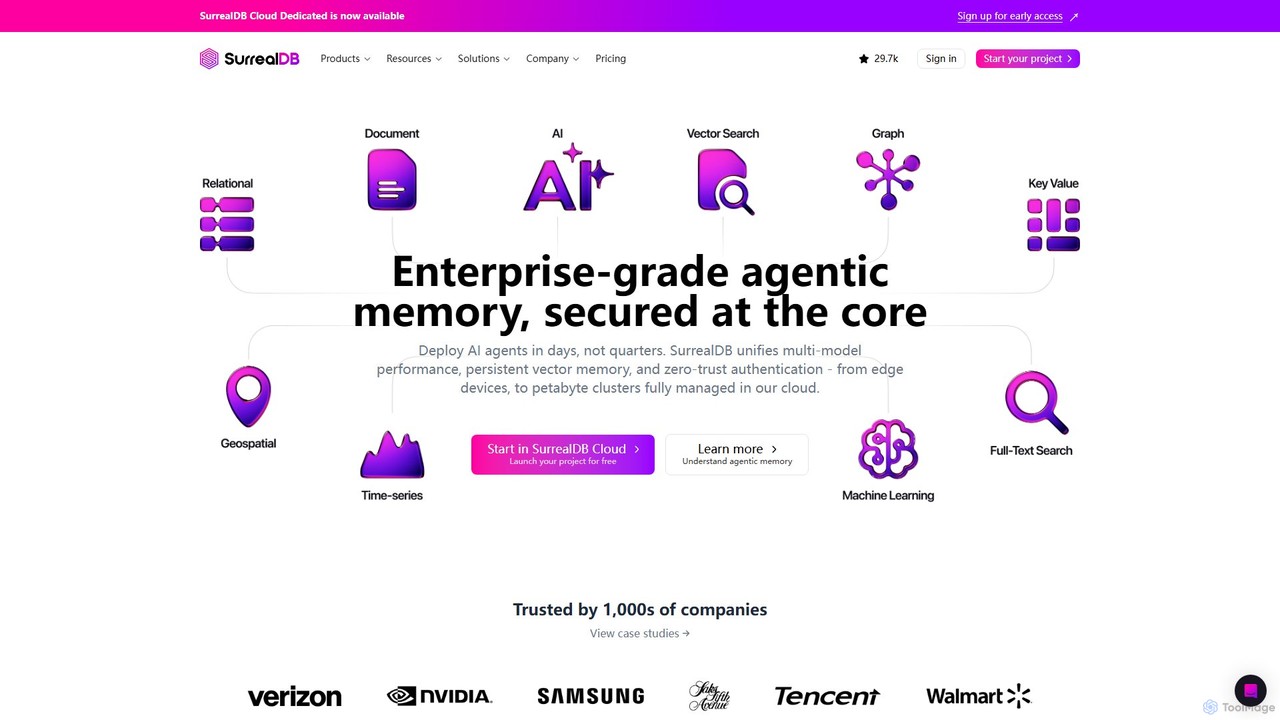
SurrealDBは、現代のアプリケーション向けに設計された次世代のマルチモーダルクラウドデータベースです。ドキュメント、リレーショナル、グラフ、時系列モデルを統合し、組み込みの全文検索、ベクトル検索、データベース内機械学習機能により、バックエンド開発を簡素化します。スケーラビリティとリアルタイムデータのために構築され、開発者が前例のない容易さと速さで複雑なAI駆動のアプリケーションを構築できるようにします。
ベクトルデータベース
LanceDBは、AIアプリケーションの構築とスケーリングのために設計された、オープンソースのAIネイティブなマルチモーダルレイクハウスです。テキスト、画像、音声、ベクトルなどの複雑なデータを保存、検索、管理するための統一プラットフォームを提供します。RAG、セマンティック検索、モデルトレーニングに最適で、超高速ハイブリッド検索、ペタバイト規模への大規模なスケーラビリティ、大幅なコスト削減を実現し、エンタープライズグレードのAIの強力な基盤となります。
ベクトルデータベース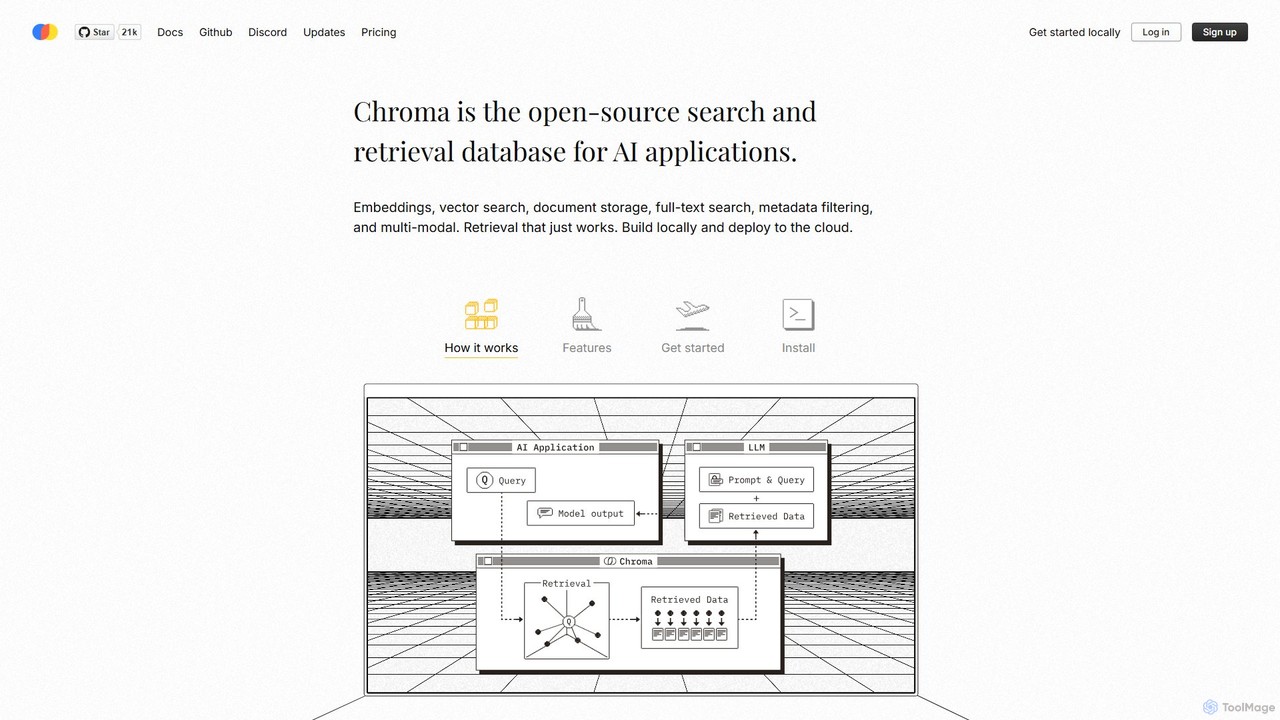
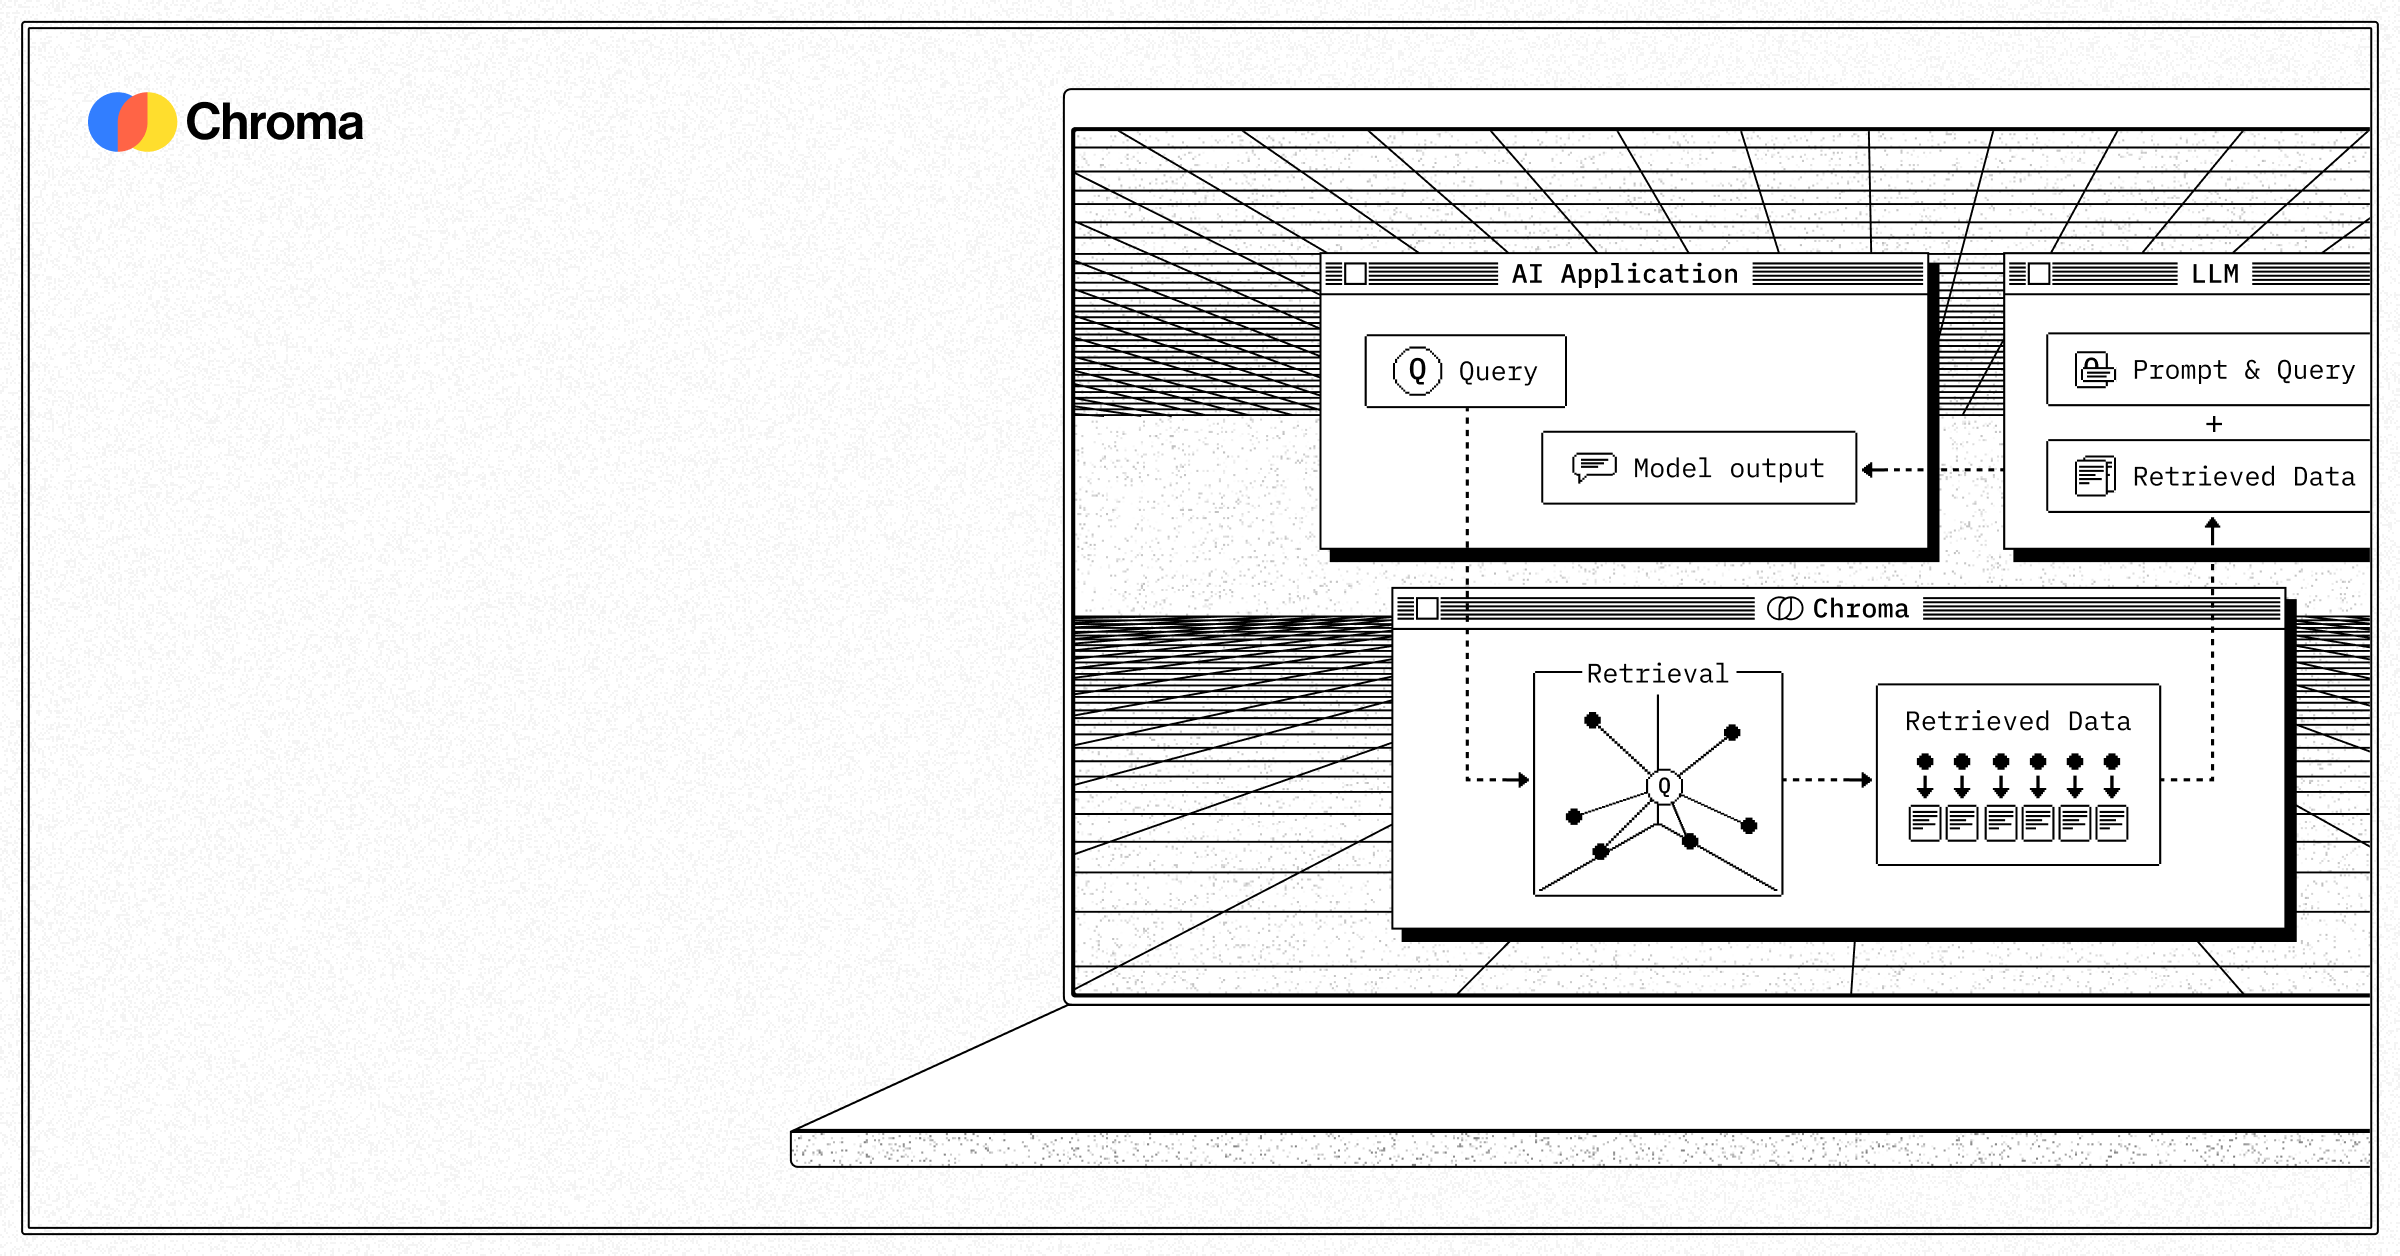
Chromaは、強力な検索拡張生成(RAG)AIアプリケーションを構築するために設計された、オープンソースのAIネイティブ検索データベースです。埋め込み、ドキュメント、メタデータの保存と検索を簡素化し、ベクトル検索、全文検索、スケーラブルなサーバーレスクラウドプラットフォームを提供します。ローカル開発から大規模な本番環境まで、使いやすく、コスト効率が高く、強力であるように作られています。
ベクトルデータベース
MongoDBは、主要なNoSQLドキュメントデータベース上に構築された開発者向けデータプラットフォームです。そのクラウドサービスであるMongoDB Atlasは、生成AI向けの強力なベクトル検索、全文検索、リアルタイム分析など、統合されたサービススイートを提供します。モダンなアプリケーション向けに設計されており、開発者がマルチクラウド環境でより速く、より効率的に構築するための柔軟性、スケーラビリティ、統一されたエクスペリエンスを提供します。
ベクトルデータベースベクトルデータベースは、テキスト、画像、音声などのデータの数値表現である高次元ベクトルを保存、管理、クエリするために設計された特殊なデータベースです。これらのデータベースは、高度なインデックスアルゴリズムを採用し、効率的な類似性検索を可能にすることで、AIシステムが単なる完全一致ではなく、意味的に類似したデータポイントを見つけられるようにします。これらは、非構造化データ内のコンテキストと関係の理解に依存する現代のAIアプリケーションを強化するための基盤であり、より広範なAIインフラストラクチャ内の重要なコンポーネントとして機能します。複雑なデータをベクトルに変換することで、これらのデータベースはインテリジェントな情報検索とパーソナライズされた体験の能力を解き放ちます。
ベクトルデータベースは、深い意味的理解とコンテキスト関連性を必要とするアプリケーションにとって不可欠です。これらは、単純なキーワードマッチングを超えて、意味に基づいて情報を検索できるインテリジェントな検索エンジンを構築するために広く使用されています。さらに、ユーザーの好みやアイテムの特性に基づいて非常に適切な製品、コンテンツ、サービスを提案する洗練されたレコメンデーションシステムを強化します。重要なことに、ベクトルデータベースは、大規模言語モデル(LLM)の検索拡張生成(RAG)アーキテクチャの中心であり、AI生成応答の精度と関連性を高めるために外部の最新知識を提供します。高次元データを処理および比較する能力は、さまざまな業界における高度なAI機能の基礎となっています。
ベクトルデータベースを選択する際には、いくつかの重要な要素を慎重に検討する必要があります。提供されるインデックスアルゴリズム(例:速度と精度のバランスが取れたHNSW、メモリ効率に優れたIVF_FLAT)を評価し、特定のパフォーマンスニーズに合致していることを確認してください。予想されるデータ増加とクエリ負荷に対応するためのデータベースのスケーラビリティ、および既存のAI/MLフレームワークとデータパイプラインとの統合機能を評価します。さらに、レイテンシやスループットなどのクエリパフォーマンス指標を考慮し、利用可能なデプロイオプション(クラウドマネージドサービスとセルフホスト型ソリューション)を検討し、ライセンス、運用オーバーヘッド、堅牢なコミュニティサポートやエンタープライズレベル機能の可用性を含む全体的な費用対効果を比較検討してください。
Eコマースプラットフォームは、ベクトルデータベースを活用して製品検索機能を強化します。顧客が「長距離ランニングに適した快適なランニングシューズ」と検索した場合、システムはキーワードのマッチングだけでなく、このクエリをベクトルに変換します。その後、ベクトルデータベースをクエリして、意味的に類似した製品埋め込み(靴を表すベクトル)を見つけ、製品説明に正確なキーワードが存在しなくても、ユーザーの意図に真に合致する結果を返します。これにより、より関連性の高い検索結果が得られ、顧客満足度が向上します。
メディアストリーミングサービスは、ベクトルデータベースを使用して高度にパーソナライズされたコンテンツレコメンデーションを提供します。ユーザーの視聴履歴、評価、好みはユーザー埋め込みベクトルに変換され、映画や番組はコンテンツ埋め込みベクトルで表現されます。ベクトルデータベースは、ユーザーのプロファイルベクトルやユーザーが楽しんだコンテンツに類似するコンテンツベクトルを効率的に見つけ、ユーザーの好みに合った新しいタイトルを提案できるようにすることで、エンゲージメントと発見を大幅に向上させます。
企業は、ベクトルデータベースを大規模言語モデル(LLM)と統合し、高度な顧客サポートチャットボットを構築します。ユーザーが質問をすると、クエリはベクトル化され、ベクトルデータベースから関連するドキュメントやナレッジベースの記事を検索するために使用されます。これらの検索されたスニペットは、コンテキストとしてLLMに供給され、正確で最新かつ根拠のある回答を生成できるようにすることで、ハルシネーションを減らし、AI応答の事実の正確性を向上させます。
サイバーセキュリティ企業は、ベクトルデータベースを利用してネットワークトラフィックの異常パターンを検出します。各ネットワークイベントまたはユーザー活動ログは高次元ベクトルに変換されます。ベクトルデータベースは、新しいイベントベクトルを通常の動作のベースラインと継続的に比較します。著しい逸脱や類似の異常ベクトルのクラスターはリアルタイムでフラグ付けされ、セキュリティアナリストは潜在的な脅威や侵入がエスカレートする前に迅速に特定して対応できるようになります。
膨大な画像およびビデオライブラリを持つ大企業は、ビジュアルコンテンツ検索にベクトルデータベースを利用しています。手動タグ付けやファイル名に頼るのではなく、ユーザーは画像をアップロードしたり、視覚的なコンセプトを記述したりできます。システムはこの入力をベクトルに変換し、データベースをクエリして視覚的に類似したアセットを見つけます。これにより、数百万のデジタルアセットの中から特定の画像を特定したり、重複を識別したり、関連するビジュアルコンテンツを発見したりするプロセスが大幅に簡素化されます。
ソーシャルメディアプラットフォームは、ベクトルデータベースを使用してユーザーのコンテンツフィードをパーソナライズします。投稿、記事、広告は、そのコンテンツとユーザーのインタラクションに基づいてベクトル化されます。各ユーザーのエンゲージメントプロファイルもベクトル化されます。その後、データベースはユーザーベクトルと関連するコンテンツベクトルを照合し、ユーザーが最も興味を持つ可能性のある投稿が表示されるようにすることで、フィードを個人の好みに合わせて調整し、より魅力的で定着率の高いユーザーエクスペリエンスを実現します。
ベクトルデータベースは、高次元ベクトルを効率的に保存、インデックス作成、クエリするために設計された特殊なデータベースです。これらのベクトルは、テキスト、画像、音声などの複雑なデータの数値表現(埋め込み)であり、その意味的意味を捉えます。その核となる機能は、高速な類似性検索を可能にすることであり、AIアプリケーションが単なる正確なキーワードマッチではなく、文脈的または意味的に関連するデータポイントを見つけられるようにします。これは、特に非構造化データを扱うタスクにおいて、現代のAIの基盤となる技術です。
主な違いは、そのデータモデルとクエリ機能にあります。従来のリレーショナルデータベースは、構造化データをテーブルに保存し、SQLを使用して完全一致クエリを実行します。対照的に、ベクトルデータベースは高次元ベクトルを保存し、ベクトル空間で「近い」データポイントを見つける類似性検索に優れています。リレーショナルデータベースが事前定義されたスキーマに基づく正確なデータ取得に焦点を当てるのに対し、ベクトルデータベースは、非構造化データ埋め込みを扱うAIアプリケーションにとって不可欠な、意味的理解と文脈的取得に最適化されています。
ベクトルデータベースは、AIアプリケーションにいくつかの主要な利点をもたらします。これらは、キーワードマッチングよりも優れた意味的意味を理解することで、非常に適切で文脈に沿った検索結果を可能にします。リアルタイムで数十億の高次元ベクトルを管理およびクエリするために必要なスケーラビリティとパフォーマンスを提供します。さらに、レコメンデーションシステム、異常検知、大規模言語モデルにおける検索拡張生成(RAG)などの高度なAI機能を強化するために不可欠であり、AIシステムのインテリジェンスと精度を大幅に向上させます。
ベクトルデータベースは、幅広いAI駆動型シナリオで適用されています。一般的なアプリケーションには、ユーザーが正確なキーワードではなく意味に基づいて情報を見つけることができるセマンティック検索エンジンの強化が含まれます。これらは、パーソナライズされたコンテンツや製品を提案する洗練されたレコメンデーションシステムを構築するために不可欠です。さらに、ベクトルデータベースは、大規模言語モデルにより正確な応答を提供するための外部知識を提供する検索拡張生成(RAG)アーキテクチャの基盤であり、サイバーセキュリティや詐欺防止におけるリアルタイムの異常検知にも使用されます。
ベクトルデータベースを選択する際には、そのインデックスアルゴリズム(例:HNSW、IVF_FLAT)と、パフォーマンスおよび精度要件への適合性を考慮してください。現在および将来のデータ量に対応するためのスケーラビリティ、およびクエリスループットとレイテンシを評価します。既存のAI/MLスタックおよびデータパイプラインとの統合機能も不可欠です。最後に、デプロイオプション(クラウドマネージドサービス、セルフホスト型)、コストへの影響、および運用上および予算上の要件を満たすためのコミュニティサポートまたはエンタープライズ機能のレベルを評価してください。