
Freemium
Label Studio
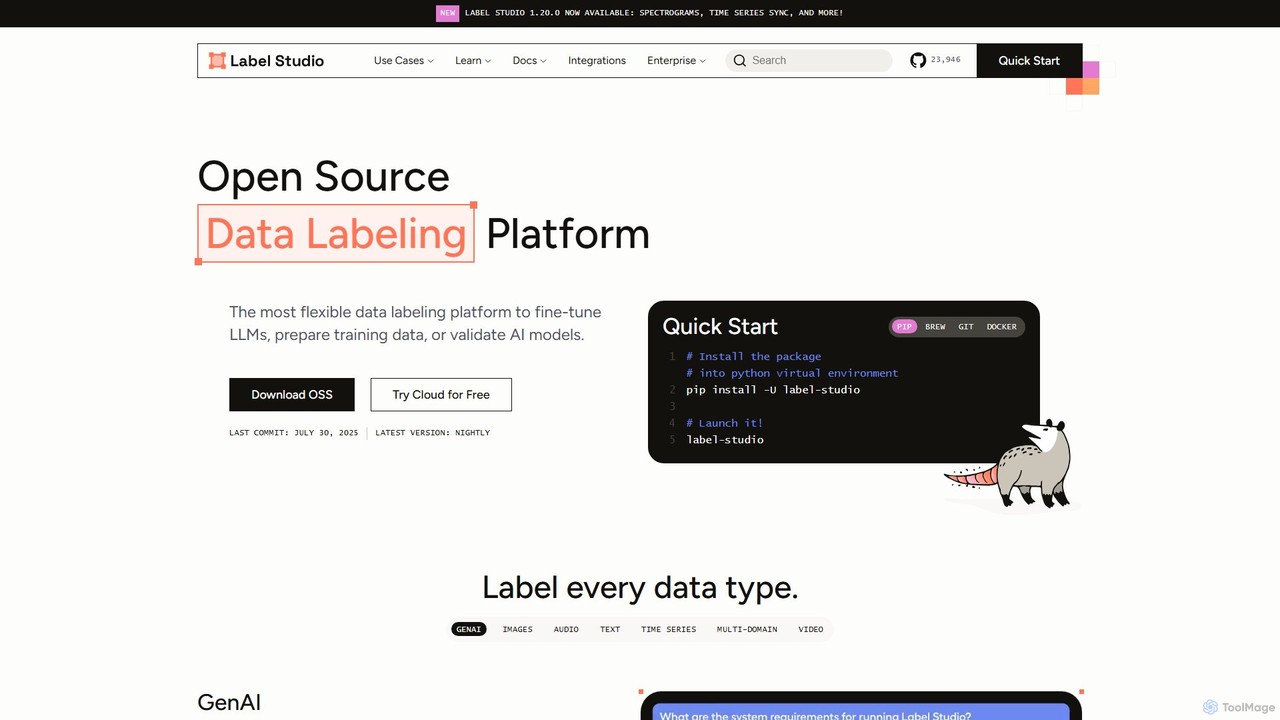
Label Studioは、多様なデータタイプ向けに設計された多機能なオープンソースのデータラベリングプラットフォームです。画像、テキスト、音声、動画、時系列データにアノテーションを付け、LLMのファインチューニング、機械学習用のトレーニングデータの準備、人間参加型のフィードバックによるAIモデルの検証を可能にします。
訓練データVisits 268.1KFavorites 160Likes 171
Popular 訓練データ AI tools in AIモデル開発 include Label Studio, helping you work more efficiently.
Label Studioは、多様なデータタイプ向けに設計された多機能なオープンソースのデータラベリングプラットフォームです。画像、テキスト、音声、動画、時系列データにアノテーションを付け、LLMのファインチューニング、機械学習用のトレーニングデータの準備、人間参加型のフィードバックによるAIモデルの検証を可能にします。
訓練データ訓練データツールは、機械学習モデルの開発と改良に不可欠な高品質なデータセットを収集、アノテーション、準備するために設計された、AIを活用した専門プラットフォームです。これらのツールは、データが正確にラベル付けされ、フォーマットされていることを保証することで、AIモデル開発の重要な初期段階を効率化します。これにより、AI実務者は、コンピュータビジョンから自然言語処理まで、さまざまなアプリケーションで信頼性の高いパフォーマンスを発揮する堅牢なモデルを構築できます。
これらのツールは、AI研究者、データサイエンティスト、機械学習エンジニアにとって不可欠です。オブジェクト検出のためのコンピュータビジョンモデルのトレーニング用データセットの準備、自然言語理解のためのテキストのアノテーション、自動運転システム用のセンサーデータのラベリングなどに使用されます。目標は、生の情報をモデルが取り込める構造化された利用可能な形式に変換することです。
訓練データプラットフォームを選択する際は、処理する必要があるデータの種類(画像、テキスト、音声、ビデオ)、アノテーションタスクの複雑さ、大規模データセットのスケーラビリティ要件を考慮してください。既存のMLパイプラインとの統合機能、アノテーションに提供される自動化のレベル、および品質管理機能の堅牢性を評価します。価格モデルと共同作業ワークフローのサポートも重要な要素です。
機械学習エンジニアが自動運転車向けの物体検出モデルをトレーニングする必要があります。彼らは訓練データプラットフォームを使用して、数千枚の画像に歩行者、車両、交通標識のバウンディングボックスを正確にラベル付けします。この詳細なアノテーションにより、モデルが実際の運転シナリオで物体を正確に識別し、位置を特定できるようになり、安全性とパフォーマンスにとって不可欠です。
データサイエンティストが顧客レビューの感情分析を行うためのNLPモデルを構築しています。彼らは訓練データツールを利用してテキストデータにアノテーションを付け、文やフレーズを肯定的、否定的、中立的に分類します。このプロセスには、テキスト内の主要なエンティティと関係を特定することが含まれ、モデルが顧客フィードバックの感情的なトーンを正確に理解し分類できるようになります。
医療や金融などの業界では、稀ではあるが重要なイベント(特定の疾病発生、詐欺パターンなど)に関する実世界のデータは不足しています。データエンジニアは、データ拡張機能を備えた訓練データツールを使用して、これらの稀なシナリオを模倣する合成データを生成します。これによりデータセットが拡張され、AIモデルがより包括的な状況でトレーニングできるようになり、異常を検出して対応する能力が向上します。
音声アシスタントを開発している企業は、トレーニング用に高品質な音声データを必要としています。彼らは訓練データツールを使用して、話し言葉をテキストに転写し、話者の交代、背景ノイズ、感情のトーンなどの特定の要素をアノテーションします。この綿密なプロセスにより、音声認識モデルが多様な音声入力を正確にテキストに変換できるようになり、アシスタントの理解度と応答性が向上します。
AIモデルをデプロイする前に、データ品質スペシャリストは訓練データツールを使用して準備されたデータセットを検証し、クリーニングします。これには、不整合の特定と修正、重複エントリの削除、欠損値の処理が含まれます。データがクリーンで正確であることを保証することで、モデルが誤ったパターンを学習するのを防ぎ、本番環境でのAIシステムのより堅牢で公平かつ信頼性の高いパフォーマンスにつながります。
環境科学者は、森林破壊、都市拡大、気候変動の影響を監視するAIモデル向けに、衛星画像やドローン映像などの地理空間データを処理し、ラベル付けするために訓練データツールを使用します。これには、土地被覆タイプのセグメンテーション、特定のフィーチャの識別、経時的な変化の追跡が含まれます。高品質にラベル付けされた地理空間データは、環境保全と資源管理のための正確な予測モデルを開発するために不可欠です。
AIにおける訓練データとは、機械学習モデルを学習させるために慎重に準備され、ラベル付けされた画像、テキスト、音声、ビデオなどの情報コレクションを指します。これは、モデルが学習段階でパターンを識別し、予測を行い、特定のタスクを実行できるようにするための入力として機能します。高品質な訓練データは、効果的で正確なAIモデルを構築するための基本であり、実際のアプリケーションにおけるパフォーマンスと信頼性に直接影響します。
適切な訓練データプラットフォームを選ぶには、いくつかの重要な要素を評価する必要があります。まず、扱うデータの種類(画像、テキスト、音声、ビデオなど)を考慮し、プラットフォームがそれらをサポートしていることを確認します。次に、アノテーションツールの多様性やAI支援のレベルを含むアノテーション機能を評価します。第三に、大量のデータを処理するためのスケーラビリティと、既存の機械学習パイプラインとの統合性を確認します。最後に、品質管理機能、価格体系、および共同作業ワークフローのサポートを評価します。
データ収集とは、ウェブスクレイピング、センサーフィード、既存のデータベースなど、さまざまなソースから未処理の生情報を収集することです。一方、データアノテーションは、収集された生データに意味のある属性をラベル付けまたはタグ付けして、機械学習モデルが理解できるようにするプロセスです。例えば、画像を収集することはデータ収集であり、それらの画像内のオブジェクトにバウンディングボックスを描画してラベル付けすることはデータアノテーションです。どちらも訓練データを準備する上で重要なステップですが、アノテーションはAI学習に必要なコンテキストを追加します。
高品質な訓練データは、AIモデルの精度、公平性、堅牢性に直接影響するため、非常に重要です。モデルはデータに存在するパターンや例から学習します。データに偏りがあったり、不正確であったり、不完全であったりすると、モデルはこれらの欠陥を受け継ぎ、パフォーマンスの低下、誤った予測、そして潜在的に有害な結果につながります。クリーンで多様かつ正確にラベル付けされたデータは、モデルが新しい未知のデータにうまく汎化し、実際のシナリオで信頼性の高いパフォーマンスを発揮することを保証し、信頼できる効果的なものにします。
訓練データの準備には通常、いくつかの主要なステップが含まれます。まず、データ収集で関連するソースから生情報を集めます。次に、データクリーニングと前処理で欠損値の処理、重複の削除、データを一貫した形式への変換を行います。第三に、データアノテーションとラベリングでデータに意味のあるタグや属性を追加します。第四に、データ拡張でバリエーションを作成してデータセットを拡大します。最後に、品質保証と検証で、AIモデルのトレーニングに使用する前に準備されたデータの正確性と一貫性を確認します。