
Freemium
Cleanlab Chat
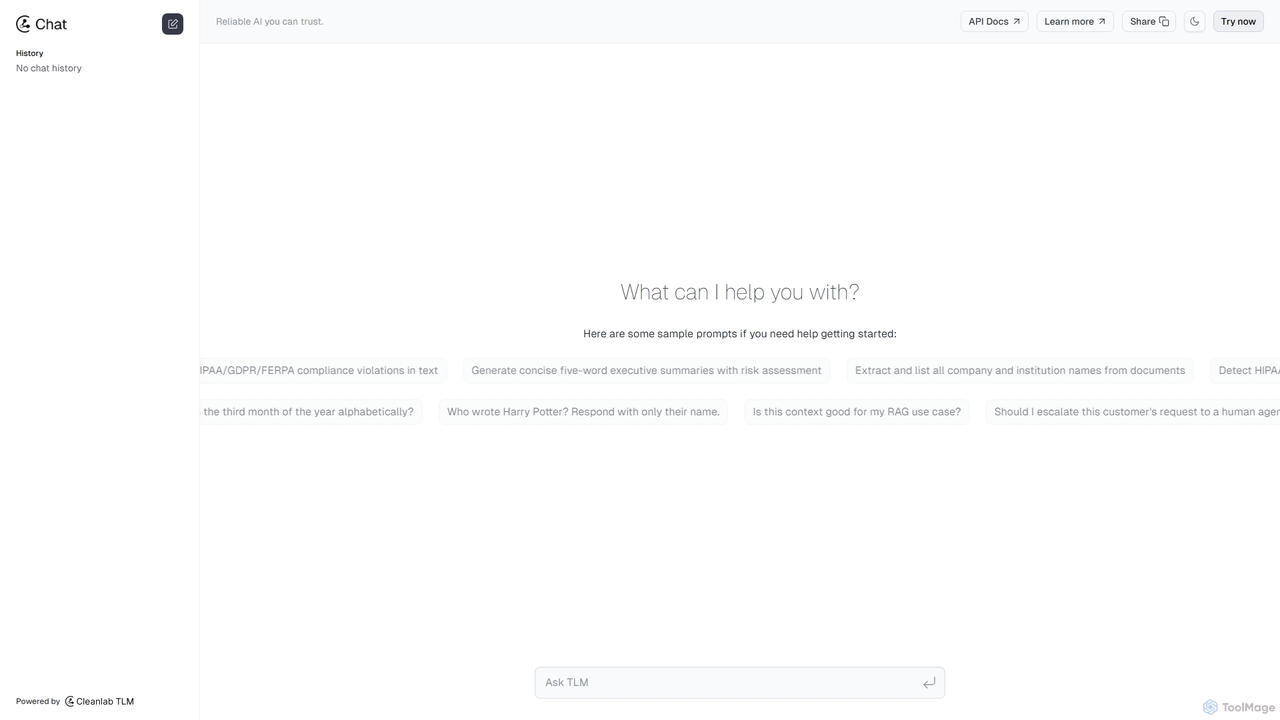
Cleanlab Chatは、Cleanlabの信頼できる言語モデル(TLM)を搭載した高度なAIチャットインターフェースです。RAGシステムの評価、ハルシネーションの検出、データコンプライアンスチェック(HIPAA、GDPR)、信頼性の高いテキスト分析など、エンタープライズレベルのタスク向けに設計されており、ビジネスアプリケーションにおける正確性と安全性を保証します。
LLM評価Visits 6.6KFavorites 170Likes 163
Popular LLM評価 AI tools in 開発者ツール include Cleanlab Chat, helping you work more efficiently.
Cleanlab Chatは、Cleanlabの信頼できる言語モデル(TLM)を搭載した高度なAIチャットインターフェースです。RAGシステムの評価、ハルシネーションの検出、データコンプライアンスチェック(HIPAA、GDPR)、信頼性の高いテキスト分析など、エンタープライズレベルのタスク向けに設計されており、ビジネスアプリケーションにおける正確性と安全性を保証します。
LLM評価LLM評価ツールは、大規模言語モデル(LLM)のパフォーマンスを体系的に測定、分析、比較するために設計された、開発者向けの専門的なユーティリティカテゴリです。これらのプラットフォームは、標準化されたベンチマークの実行、主要なメトリクスの計算、および定性的な評価を実施するためのフレームワークを提供し、モデルの信頼性、正確性、安全性を確保します。開発者や組織がデプロイ前にモデルの動作を検証し、本番環境でのパフォーマンスを監視し、モデルの選択やファインチューニング時にデータに基づいた意思決定を行うために不可欠です。このプロセスは、LLMの出力に関連する弱点、バイアス、潜在的なリスクを特定するのに役立ちます。
LLM評価ツールは、AI開発ライフサイクル全体で非常に重要です。MLエンジニアがモデルのファインチューニング後のリグレッションテストに使用したり、AIセーフティチームが一般公開前のバイアスや有害性の監査に使用したり、プロダクトマネージャーが特定のアプリケーションのために異なるサードパーティモデル(GPT対Claudeなど)を比較するために使用されます。また、本番アプリケーションでのパフォーマンス低下やモデルドリフトを検出するための継続的な監視にも不可欠です。
LLM評価ツールを選択する際は、様々なモデル(プロプライエタリAPIとオープンソースの両方)のサポート、組み込みのベンチマークとメトリクスの幅広さ、カスタム評価データセットと基準を定義する柔軟性を考慮してください。また、MLOpsパイプライン(CI/CDなど)との統合能力、共同での人間によるフィードバック機能、大規模なテストを処理するスケーラビリティも評価します。使用量、シート数、または機能に基づく価格設定モデルも重要な要素です。
Eコマース企業の製品チームは、新しいAIカスタマーサービスエージェントに最も適したLLMを選択する必要があります。彼らはLLM評価プラットフォームを使用して、3つの候補(GPT-4o、Claude 3 Opus、およびファインチューニングされたLlama 3モデル)を比較します。チームは、注文追跡、返品、製品に関する質問などのトピックをカバーする1,000件の実際の顧客クエリからなるカスタム評価データセットを作成します。このツールは、各クエリを3つのモデルすべてで実行するプロセスを自動化し、正確性、有用性、および会社の望むトーンへの準拠度に関するメトリクスを計算します。その後、人間のレビューアがプラットフォームの並列比較インターフェースを使用して、応答の微妙な品質を採点し、データに基づいた決定を下します。
あるエンタープライズソフトウェア企業は、四半期ごとに新しいデータで独自のコード生成モデルをファインチューニングしています。パフォーマンスの低下を防ぐため、彼らのMLOpsチームはLLM評価ツールをCI/CDパイプラインに統合しています。各ファインチューニングの実行後、パイプラインは自動的に評価ジョブをトリガーします。このジョブは、更新されたモデルを、既知の最適解を持つ500の複雑なプログラミング課題からなる「ゴールデンデータセット」に対して実行します。ツールはコードの正しさ、効率性、スタイルガイドへの準拠度を測定します。いずれかの主要メトリクスが事前に定義されたしきい値を下回ると、ビルドは失敗し、チームに警告が送られ、欠陥のあるモデルが本番環境にデプロイされるのを防ぎます。
ある金融サービス企業が、規制文書の要約を支援するLLMを開発しています。デプロイ前に、コンプライアンスおよびAIセーフティチームは評価ツールを使用して徹底的な監査を実施します。彼らはツールのレッドチーミング機能を使用して、保護された特性(例:年齢、性別)に関連するバイアスをテストし、プロンプトインジェクション攻撃などのセキュリティ脆弱性を調査するために設計された敵対的なプロンプトを生成します。プラットフォームは、有害、偏見のある、または非準拠の応答を自動的にフラグ付けし、詳細なレポートを生成します。これにより、開発チームはモデルが内部で使用される前に、重大な安全リスクを特定し、軽減することができます。
あるマーケティングチームが、ソーシャルメディアの広告コピーを生成するためにLLMを使用しています。最も効果的なプロンプト構造を見つけるために、彼らは評価ツールを使用して、ゼロショット、フューショット、思考の連鎖などのさまざまなプロンプト技術をA/Bテストします。彼らは100種類の製品説明を含むテストスイートを作成します。ツールは、5つの異なるプロンプトテンプレートを使用して、各製品説明をLLMで実行します。その後、出力は創造性、明確さ、ブランドボイスの一貫性に関するルーブリックに基づいて自動的に採点されます。この体系的なアプローチにより、チームは一貫して最高品質のコピーを生成するプロンプトテンプレートを特定し、コンテンツ作成ワークフローを最適化することができます。
あるリーガルテック企業が、文書要約機能を提供するためにLLMを使用しています。その品質を長期にわたって高く維持するため、彼らは継続的な監視のために評価ツールを採用しています。このツールは、毎日すべての本番リクエストとその対応する要約の1%をサンプリングするように設定されています。LLMの出力を参照要約(利用可能な場合)や他のヒューリスティクスと比較することで、ROUGEおよびBERTScoreメトリクスを自動的に計算します。ダッシュボードはこれらのメトリクスを時系列で視覚化します。週に平均ROUGEスコアが5%以上低下した場合、エンジニアリングチームにアラートが送信され、潜在的なモデルドリフトを示唆し、調査または再トレーニングサイクルを促します。
ある開発者が、モバイルアプリのリアルタイム翻訳機能を構築しており、品質、速度、コストのバランスを取る必要があります。彼らはLLM評価ツールを使用して、大規模で高品質なモデル(GPT-4など)と、より小さく、速く、安価なモデル(蒸留されたオープンソースモデルなど)を比較します。彼らは、2,000の一般的なフレーズからなるテストスイートを両方のモデルで実行します。評価ツールは、翻訳の正確さ(BLEUスコアを使用)だけでなく、各モデルの平均レイテンシとAPIコストも記録します。結果のレポートは明確なトレードオフ分析を提供し、開発者はユーザーの最低品質基準を満たしつつ、予算とレイテンシの目標内に収まるモデルを選択することができます。
LLM評価ツールは、開発者、研究者、組織が大規模言語モデルのパフォーマンスと安全性を体系的に測定するのを支援する専門的なソフトウェアプラットフォームです。これらは、テストの自動化、異なるモデルやプロンプトの比較、定義されたメトリクスに対する出力の分析を行うためのフレームワークを提供します。主な機能には、ベンチマークの実行、正確性や流暢さのスコア計算、バイアスや有害性の検出、人間によるフィードバックの促進などがあります。これらのツールは、LLMを活用したアプリケーションがデプロイ前後で信頼性が高く、効果的で、安全であることを保証するために不可欠です。
適切なツールの選択は、特定のニーズによって異なります。以下の要素を考慮してください:
自動評価と人間による評価は、LLMを評価するための2つの補完的な方法です。自動評価は、計算可能なメトリクス(BLEU、ROUGE、精度など)を使用して、参照データセットに対してモデルの出力を大規模かつ迅速にスコアリングします。特定のタスクに対しては、高速で安価、かつ客観的です。一方、人間による評価は、創造性、一貫性、有用性、トーンなどの主観的な品質に基づいて、人々がモデルの出力を評価または比較することを含みます。時間はかかり高価ですが、自動メトリクスが見逃しがちな言語の微妙な側面を捉えるためのゴールドスタンダードです。最も堅牢な評価戦略では、迅速で広範なテストのために自動化された方法を使用し、より深く、より定性的な検証のために人間によるフィードバックを使用します。
使用されるメトリクスはタスクに大きく依存します。しかし、一般的に使用されるものには以下が含まれます:
LLMのパフォーマンスは静的ではないため、継続的な評価は非常に重要です。現実世界の入力データのパターンが変化し、モデルがトレーニングされたデータと一致しなくなる「モデルドリフト」と呼ばれる現象により、パフォーマンスは時間とともに低下する可能性があります。例えば、カスタマーサービスボットが、トレーニングされていない新しい種類のクエリに遭遇するかもしれません。主要なメトリクスを継続的に監視することで、チームはこのパフォーマンスの低下を早期に検出し、その原因(例:新しいトピック、ユーザーの言語の変化)を特定し、モデルの再トレーニングやプロンプトの更新などの必要なアクションをトリガーすることができます。これにより、アプリケーションは初期リリース後も長期間にわたってユーザーにとって信頼性が高く、効果的であり続けることが保証されます。