Crawly
ウェブスクレイピング
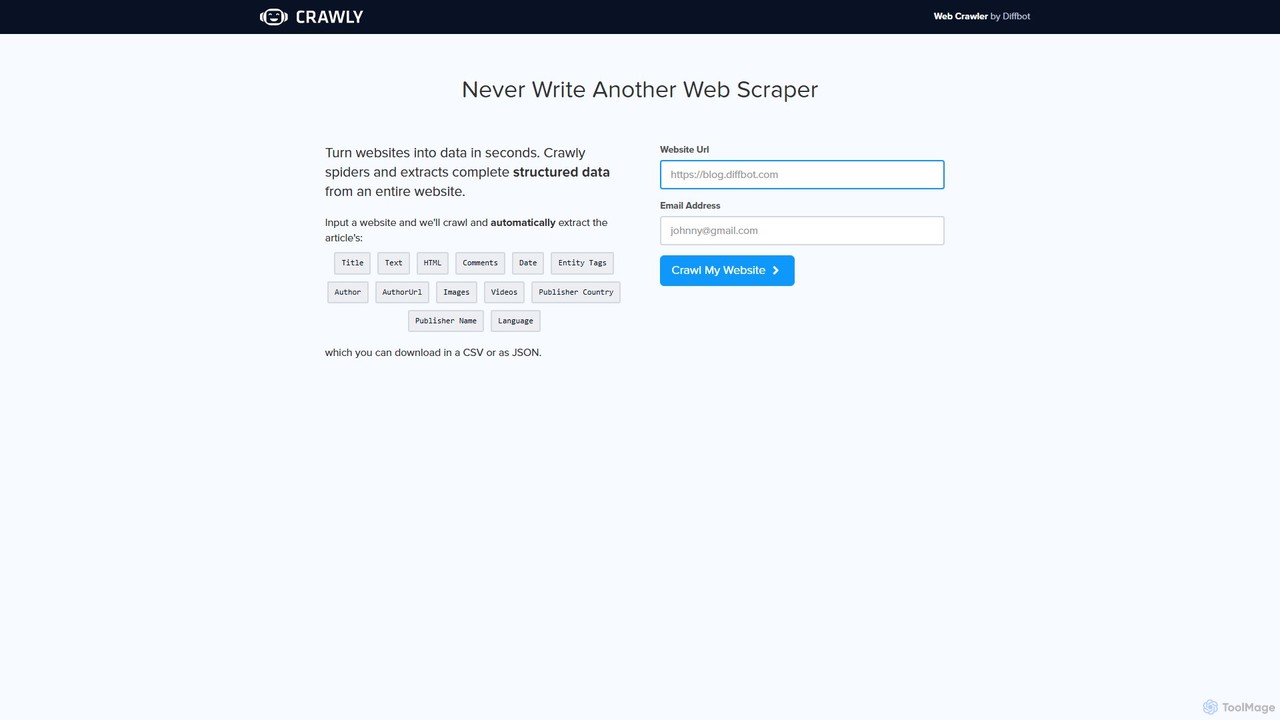
CrawlyはDiffbotが開発したAI搭載のウェブクローラーで、ウェブサイト全体から構造化データを自動的に抽出します。URLを入力するだけで、Crawlyがサイトをスパイダーし、記事、製品、ディスカッションなどの重要な情報を取得し、コーディング不要でクリーンなJSONまたはCSVデータに変換します。
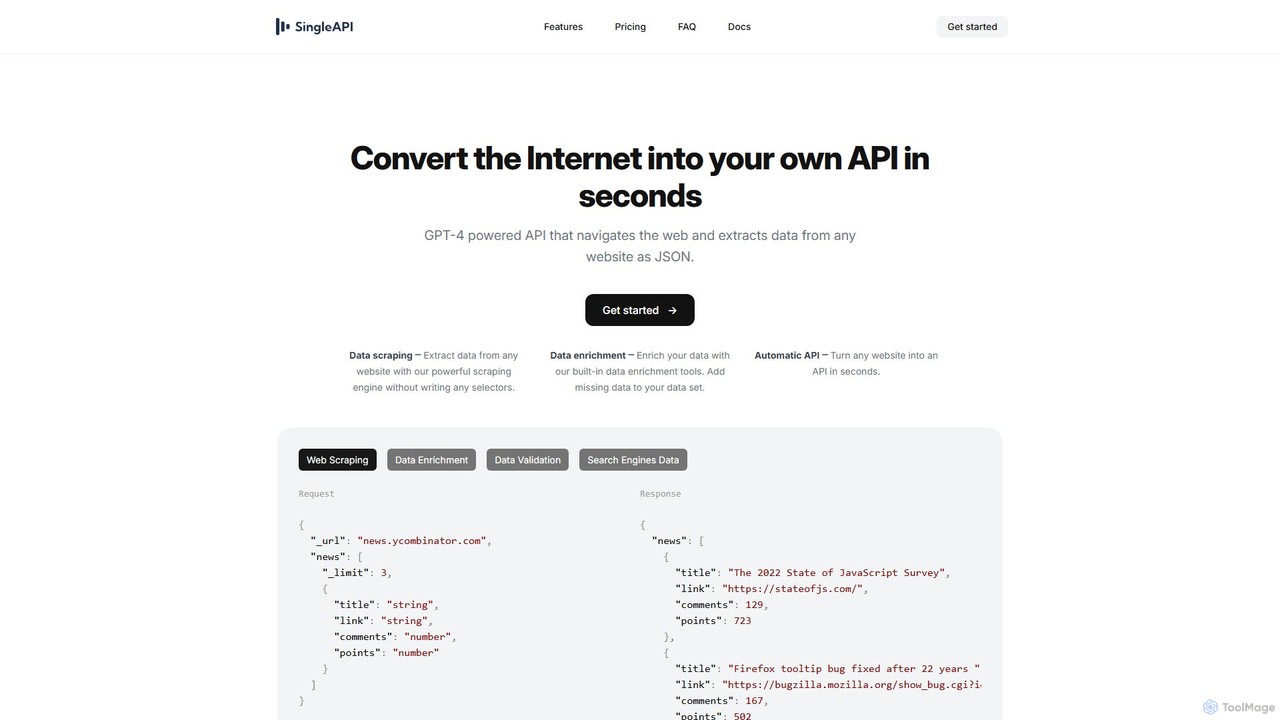
SingleAPIは、GPT-4を搭載したツールで、あらゆるウェブサイトを即座に構造化されたJSON APIに変換します。コードやセレクタを記述することなく、ウェブスクレイピング、データ抽出、データエンリッチメントを簡素化し、ユーザーが様々なアプリケーションのためにウェブデータに簡単にアクセスできるようにします。
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| 基本情報 | Crawly | SingleAPI |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | ウェブスクレイピング | ウェブスクレイピング |
| 対象ユーザーと職種 | 未確認 | 未確認 |
| カテゴリー | ウェブスクレイピング · API · 市場調査 · 自動化 | ウェブスクレイピング · API · データ抽出 · 自動化 |
| Added | 2025/08/10 | 2025/08/10 |
| 更新 | 2026/11/19 | 2026/11/19 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Crawlyは、AIによるデータ抽出のリーダーであるDiffbotによって開発された、強力でインテリジェントなウェブクローラーです。ウェブスクレイピングの手作業や技術的な課題を完全に排除することを目的として設計されています。Crawlyは、複雑なコードを書いたり、ウェブサイトの更新で壊れやすいセレクタを使用したりする代わりに、コンピュータビジョンや自然言語処理を含む高度な人工知能を活用して、人間のようにウェブページを理解し解釈します。これにより、単一のURLを入力するだけで、ウェブサイト全体から完全な構造化データを自動的に識別し抽出することが可能になります。
Crawlyの核心的な約束は、「ウェブサイトを数秒でデータに変える」ことです。ウェブサイト内をナビゲートし、リンクをたどり、各ページの構造を分析して、記事、製品、ディスカッション、画像ギャラリーなどのさまざまなコンテンツタイプを区別します。抽出されたデータは、その後、クリーンで構造化された形式に整理され、アプリケーション、データ分析、または機械学習モデルですぐに使用できる状態になります。
Crawlyの使い方は、技術的なスキルに関係なく、誰にでも非常にシンプルでアクセスしやすいように設計されています。プロセスはわずか数ステップで完了します:
Crawlyは、幅広い用途に適した多目的なツールです:
Crawlyの主な利点は、そのシンプルさとパワーです。ウェブデータ抽出を民主化し、通常はエンジニアチームが必要なタスクを非開発者が実行できるようにします。スクレイピングプロセス全体を自動化することで、膨大な時間とリソースを節約します。さらに、AI駆動のアプローチにより、従来の方法よりも高い精度と優れた回復力が保証され、信頼性の高い高品質なデータストリームを提供します。Diffbotの製品であるため、世界中の主要企業から信頼されているエンタープライズグレードの技術に支えられています。
Crawlyは、ホームページから直接無料のトライアルクロールを提供しており、ユーザーはURLとメールアドレスを入力するだけでその機能を試すことができます。これは、ツールが生成できる構造化データのサンプルを提供することを目的としています。大規模なクロール、頻繁なデータ抽出、またはプログラムによる使用のためのAPIアクセスなど、より広範なニーズに対しては、通常、親会社であるDiffbotが提供するツールのフルスイートに登録する必要があります。Diffbotの価格は階層化されており、スタートアップ、ビジネス、大企業向けのプランが用意され、異なるレベルのAPIコールと機能を提供しています。
SingleAPIは、インターネット全体を開発者フレンドリーな構造化データソースに変換するために設計された革新的なツールです。GPT-4を搭載し、インテリジェントなAPIを提供し、あらゆるウェブサイトをナビゲートし、その構造を理解し、目的の情報を数秒できれいなJSON形式に抽出します。これにより、開発者が特定のデータポイントをターゲットにするために脆弱なセレクタ(CSSセレクタやXPathなど)を記述・維持する必要があった、従来のウェブスクレイピングの退屈で複雑なプロセスが不要になります。SingleAPIを使えば、必要なデータを記述するだけで、残りはAIが処理します。
このプラットフォームは、個人のホビイストから大企業まで、幅広いユーザーに対応するため、シンプルさとパワーを両立させています。競合他社の価格監視、ニュースの集約、リードの生成、既存のデータセットのエンリッチメントなど、どのようなニーズにも対応し、時間とリソースを大幅に節約する堅牢で信頼性の高いソリューションを提供します。
SingleAPIの使い方は非常に簡単です。ターゲットのウェブサイトと抽出したいデータスキーマをJSONボディで指定した簡単なHTTPリクエストを送信するだけです。すると、AIエンジンがそのURLにアクセスし、リクエストを解釈し、ページ上の関連データを見つけ、完全に構造化されたJSONレスポンスで返します。
例えば、Hacker Newsからトップ3の記事を抽出する場合、リクエストは次のようになります:
リクエスト:
{
  "_url": "news.ycombinator.com",
  "news": [
    {
      "_limit": 3,
      "title": "string",
      "link": "string",
      "comments": "number",
      "points": "number"
    }
  ]
}
SingleAPIのAIはこの構造を理解し、Hacker Newsに移動して記事のリストを特定し、最初の3つのエントリのタイトル、リンク、コメント数、ポイントを抽出し、きれいなJSONオブジェクトを返します。
SingleAPIの多用途性により、幅広いアプリケーションに適しています:
SingleAPIの主な利点は、そのシンプルさと効率性です。動的なJavaScriptを多用するサイトの処理、プロキシの管理、HTMLの解析といったウェブスクレイピングの複雑さを抽象化します。これにより、開発者も非開発者も、データの取得ではなく活用に集中できます。AI駆動のアプローチは、従来のスクレイパーと比較して、ウェブサイトのレイアウト変更に対してより回復力があります。データ形式の柔軟性とWebhookによるリアルタイム配信は、現代のデータ駆動型ビジネスにとって強力なツールです。
SingleAPIは、さまざまなニーズに合わせて段階的な料金体系を提供しています:
分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。
市場での可視性の差を正しく示すため、同じ尺度で比較しています。
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇮🇶Iraq | 100% | 438 |
評価や反応は参考指標であり、製品適合性そのものではありません。
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.