
Crawlbase Overview
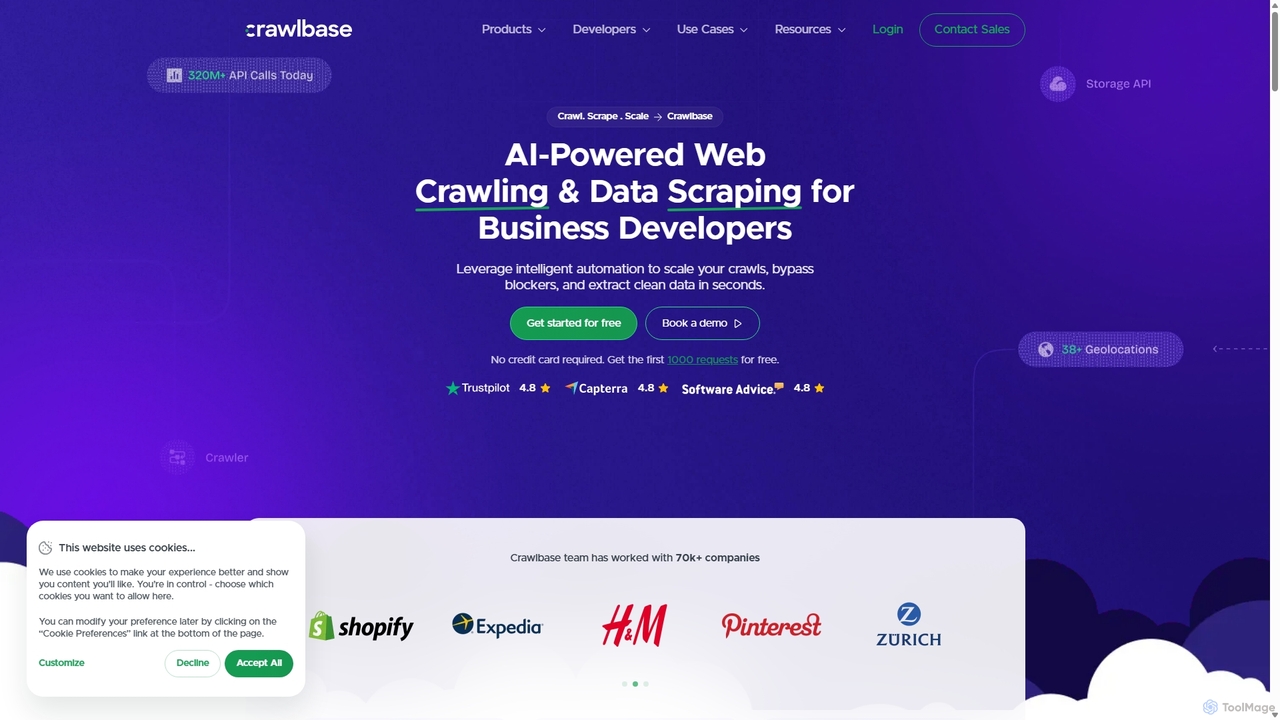
Crawlbaseは、ウェブデータへのアクセスを民主化するために設計された、包括的なAI駆動型プラットフォームです。開発者、データサイエンティスト、企業が大規模にインターネットをクロールおよびスクレイピングし、非構造化ウェブコンテンツをクリーンで構造化されたデータに変換することを可能にします。プロキシ、ブラウザ自動化、アンチボットシステムの複雑なインフラを処理することで、Crawlbaseはユーザーがデータ活用のみに集中できるようにします。このプラットフォームは、世界中の数百万のローテーション式住宅用およびデータセンター用プロキシを基盤としており、Amazon、LinkedIn、Googleなどのウェブサイトへの匿名かつ無制限のアクセスを保証し、99.9%の稼働率を保証します。
Crawlbaseの使い方
Crawlbaseをワークフローに統合するのは簡単で、数分で完了します:
- アカウントの作成: 無料のCrawlbaseアカウントにサインアップします。認証用のAPIトークンが発行されます。初期プランには、クレジットカード不要でサービスをテストできる1,000回の無料リクエストが含まれています。
- 適切なツールの選択: ニーズに合った製品を選択します。リアルタイムの同期データリクエストにはクローリングAPI (Crawling API)を使用します。大規模で継続的なプロジェクトには、非同期のクローラー (Crawler)がよりコスト効率的です。アプリケーションにシンプルなプロキシゲートウェイが必要な場合は、スマートプロキシ (Smart Proxy)が理想的な選択です。
- APIリクエストの実行: CrawlbaseのエンドポイントにAPIトークンとスクレイピングしたいターゲットURLを渡して、簡単なAPIコールを実行します。JavaScriptレンダリングを有効にしたり、地理的位置情報を設定したり、特定のデータスクレイパーを使用したりするための様々なパラメータを含めることができます。
- データの受信: Crawlbaseはリクエストを処理し、ブロック、プロキシ、CAPTCHAを通過します。その後、ページの完全なHTMLコンテンツを返すか、特定のスクレイパー(Amazonスクレイパーなど)を使用している場合は、構造化されたJSON形式でデータを提供します。
Crawlbaseの主な機能
- クローリングAPI (Crawling API): ウェブページのコンテンツをリアルタイムで取得する、強力で使いやすいAPIです。動的なウェブサイトのためのJavaScriptレンダリングをサポートし、Amazonなどの人気サイト用の組み込みスクレイパーを含み、構造化データを直接提供します。
- クローラー (The Crawler): 大規模なデータ抽出プロジェクト用に設計された非同期クローリングソリューションです。コールバックを使用してサーバーにデータを配信し、大量のURLに対するコスト、帯域幅、再試行回数を節約します。
- スマートプロキシ (Smart Proxy): 数百万のデータセンターおよび住宅用IPへのアクセスを提供するローテーション式プロキシソリューションです。ブロックを回避するために信頼性の高いプロキシを必要とするあらゆるアプリケーションやスクリプトに簡単に統合できます。
- AI搭載アンチブロッキング技術: IPブロック、ブラウザフィンガープリント、CAPTCHA、その他のアンチスクレイピング対策を自動的に処理し、高い成功率を保証する高度なアルゴリズムと機械学習モデルです。
- クラウドストレージ: クロールおよびスクレイピングしたデータをCrawlbaseの安全なクラウドストレージに直接移動させ、データパイプラインを簡素化する便利な機能です。
- グローバルジオロケーション: 30カ国以上のウェブコンテンツにアクセスし、ローカライズされた検索を実行し、地域固有のデータを収集することができます。
Crawlbaseの使用例
Crawlbaseは多目的で、幅広いデータ駆動型のビジネス活動をサポートします:
- Eコマース&小売: 競合他社の価格を監視し、製品の在庫状況を追跡し、顧客レビューを集約し、Amazon、eBay、Walmartなどのプラットフォームから製品データを分析して販売戦略を最適化します。
- 市場調査: 市場動向分析、ソーシャルメディアやフォーラムからのセンチメント分析、新たなビジネス機会の特定のために膨大な量のデータを収集します。
- リードジェネレーション: LinkedInなどのプロフェッショナルネットワーク、オンラインディレクトリ、企業ウェブサイトから連絡先情報やビジネス詳細を収集するプロセスを自動化します。
- AIと機械学習: 生成AIや大規模言語モデル(LLM)のトレーニング用に高品質で構造化されたデータセットを提供します。APIは必要な大量のテキストや画像データを効率的に収集できます。
- SEOモニタリング: さまざまな検索エンジンや地域でキーワードランキングを追跡し、競合他社のSEO戦略を分析し、ブロックされることなく包括的なサイト監査を実行します。
Crawlbaseの利点
Crawlbaseは、ウェブスクレイピングの複雑さを抽象化することで、大きな競争優位性を提供します。高価で脆弱な自社インフラを構築・維持する代わりに、ユーザーは信頼性が高く、スケーラブルで、コスト効率の良いソリューションの恩恵を受けることができます。プラットフォームの主な利点には、巨大なプロキシネットワーク、99%以上の高い成功率、99.9%の稼働率保証、24時間365日の専門家によるサポートが含まれます。開発者第一のアプローチにより、簡単な統合と堅牢なドキュメントが保証され、コンプライアンス(GDPR&CCPA)への取り組みは企業に安心を提供します。
料金プラン
Crawlbaseは、柔軟で透明性の高いフリーミアムモデルで運営されています。新規ユーザーは、クレジットカードを提供することなくプラットフォームの機能を完全にテストできる1,000回の無料リクエストを含む無料プランから始めることができます。無料トライアル後、価格は従量課金制に基づいており、コストは行われたリクエストの数と使用された機能(例:標準リクエスト対JavaScript有効リクエスト)によって決定されます。大量のデータニーズを持つ企業向けに、Crawlbaseは特定のプロジェクト要件を満たすためのカスタム価格、専任のアカウント管理、プレミアムサポートを提供するオーダーメイドのエンタープライズプランを提供しています。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 82.1K
- 2026-1: 74.4K
- 2026-2: 50.0K
- 2026-3: 46.3K
- 2026-4: 35.7K
- 2026-5: 32.4K
Geography
Top 5 countries / regions
- 🇩🇪ドイツ26.0%
- 🇷🇺ロシア22.6%
- 🇻🇳ベトナム18.4%
- 🇳🇬ナイジェリア17.5%
- 🇺🇸アメリカ合衆国15.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| apify | $0.89 |
| crawlbase | $2.99 |
| deviantart scraper | $0.00 |
| webscraping at scale | $0.00 |
| прокси в 2026 году бесплатно | $0.00 |
Crawlbase Alternatives
Octoparse
Octoparseは、プログラミング不要で誰でもウェブサイトからデータを抽出できる、強力なノーコードのウェブスクレイピングツールです。視覚的なワークフローデザイナー、簡単な設定を支援するAIアシスタント、人気サイト向けの数百の構築済みテンプレートを備えています。クラウドベースの自動化、IPローテーション、CAPTCHA解決機能により、複雑なスクレイピングタスクを効率的に処理し、ウェブページを見込み客発掘や市場調査のための構造化データに変換します。
ウェブスクレイピング
Browserless
Browserlessは、スケーラブルなウェブスクレイピングとブラウザ自動化のために設計された強力なBrowser-as-a-Service(BaaS)プラットフォームです。Puppeteer、Playwright、または独自のBrowserQL言語を使用して、開発者がCAPTCHAやボット検出器を簡単に回避できるように支援します。このサービスはブラウザインフラを管理し、ユーザーがアップデート、メモリリーク、スケーリングを心配することなく自動化スクリプトの構築に集中できるようにします。
データ抽出
Crawlbase Categories
Crawlbase Jobs
Crawlbase Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Octoparse
Octoparseは、プログラミング不要で誰でもウェブサイトからデータを抽出できる、強力なノーコードのウェブスクレイピングツールです。視覚的なワークフローデザイナー、簡単な設定を支援するAIアシスタント、人気サイト向けの数百の構築済みテンプレートを備えています。クラウドベースの自動化、IPローテーション、CAPTCHA解決機能により、複雑なスクレイピングタスクを効率的に処理し、ウェブページを見込み客発掘や市場調査のための構造化データに変換します。
ウェブスクレイピングBrowserless
Browserlessは、スケーラブルなウェブスクレイピングとブラウザ自動化のために設計された強力なBrowser-as-a-Service(BaaS)プラットフォームです。Puppeteer、Playwright、または独自のBrowserQL言語を使用して、開発者がCAPTCHAやボット検出器を簡単に回避できるように支援します。このサービスはブラウザインフラを管理し、ユーザーがアップデート、メモリリーク、スケーリングを心配することなく自動化スクリプトの構築に集中できるようにします。
データ抽出
Thordata
Thordataは、大規模なWebデータスクレイピングとAIアプリケーション向けに設計された高性能プロキシサービスプロバイダーです。6000万以上の住宅用、モバイル、ISP、データセンタープロキシからなるグローバルネットワークを提供し、高い稼働率と低遅延を誇ります。また、Thordataは強力なスクレイパーAPIとデータマーケットプレイスを提供し、AIモデルのトレーニング、Eコマースのモニタリング、SEO分析、ブランド保護などのタスクのデータ取得を簡素化し、信頼性と拡張性の高い公開Webデータへのアクセスを保証します。
データ収集

PandaExtract
PandaExtractは、究極のノーコードWebスクレイピングChrome拡張機能です。専門家がワンクリックであらゆるウェブサイトからデータを抽出できます。プログラミングスキルは不要で、市場調査、リードジェネレーション、価格監視、競合分析に最適です。
ウェブスクレイピング
Bright Data
Bright Dataは、プロキシネットワーク、AI搭載ウェブスクレイパー、すぐに使えるデータセットなど、包括的なツールスイートを提供する世界有数のウェブデータプラットフォームです。企業がAIトレーニング、市場調査、競合情報のために大量の公開ウェブデータを収集することを可能にします。
ビジネスインテリジェンス

Crawlbase Comments (0)
Sign in to comment.
ログインNo comments yet.