
Tensorlake Overview
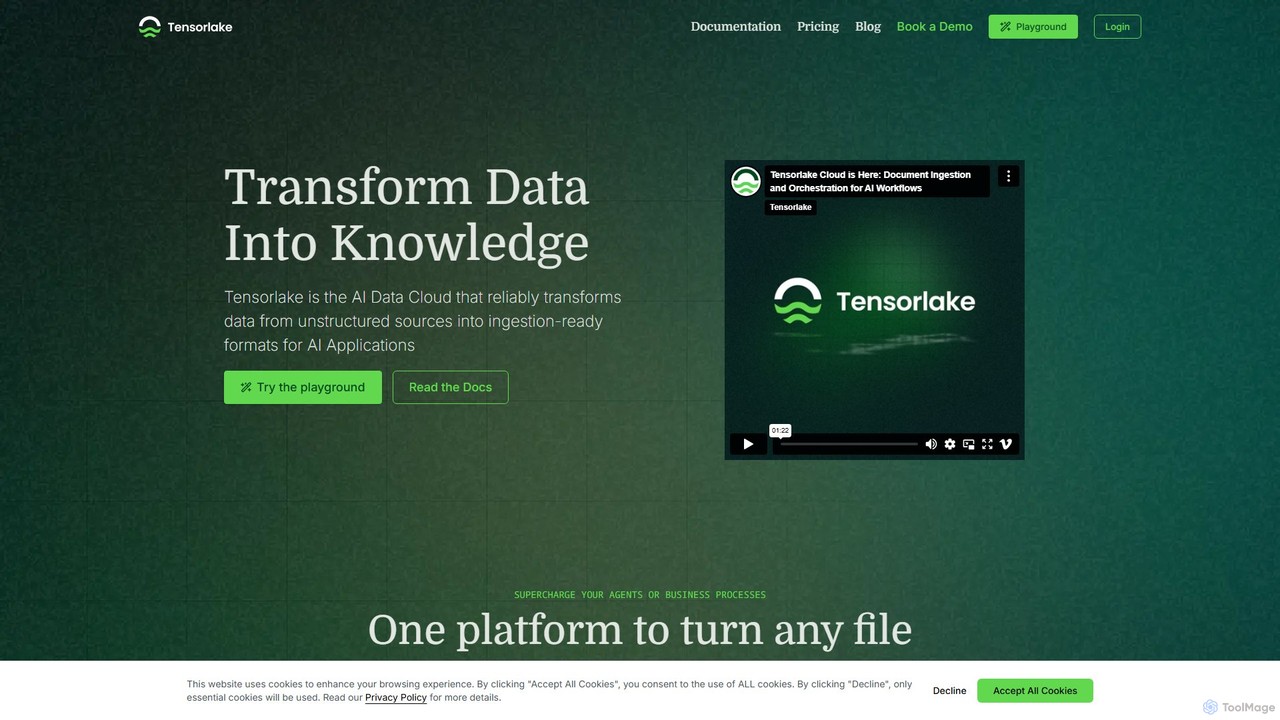
Tensorlakeは、生の非構造化データと高度なAIアプリケーションとの間のギャップを埋めるために設計された包括的なAIデータクラウドです。開発者や企業が、PDF、画像、手書きメモ、スプレッドシートなど、さまざまなソースからの複雑なデータを、JSONやマークダウンのような構造化されたインジェスト可能なフォーマットに確実に変換するための統一プラットフォームとして機能します。このプロセスは、大規模言語モデル(LLM)の強化、検索拡張生成(RAG)システムの向上、および重要なビジネスワークフローの自動化に不可欠です。
このプラットフォームは、ドキュメントインジェストAPIとサーバーレスワークフローという2つの主要な柱に基づいています。ドキュメントインジェストAPIは、人間のような解析機能を提供し、ドキュメントの元のレイアウトと読み取り順序を維持しながら、高精度で情報を抽出します。サーバーレスワークフローにより、ユーザーはPythonを使用して完全に管理されたエンドツーエンドのデータ処理パイプラインを構築およびデプロイできます。これらのワークフローは拡張性が高く、数百万のドキュメントを処理でき、アイドル時にはゼロにスケールダウンするため、コスト効率に優れています。
Tensorlakeの使い方
Tensorlakeの使用は、シンプルで開発者中心のワークフローを含みます:
- データのアップロードまたは接続: APIを介して直接ファイルをアップロードするか、既存のデータソースを接続して開始します。プラットフォームは広範なファイルタイプをサポートしています。
- 処理のためのAPI呼び出し: ドキュメントインジェEST APIを使用してファイルを処理します。一般的なドキュメント変換には「Parse」エンドポイントを使用するか、定義済みのPydanticスキーマを持つ「Extract」エンドポイントを使用して特定の構造化データをJSON形式で抽出します。
- カスタムワークフローの構築(オプション): より複雑なデータ変換には、Tensorlakeのサーバーレスワークフローを使用します。Python関数を記述して、データのクリーニング、エンリッチメント、データベースや他のシステムへのルーティングなど、データパイプラインのステップを定義します。
- 処理済みデータの取得: ジョブ完了後すぐに変換された構造化データにアクセスするか、非同期通知のためにWebhookを設定します。出力はAIアプリケーションでの使用に最適化されています。
- AI/LLMとの統合: 高品質の構造化データをRAGパイプライン、AIエージェント、または他の機械学習モデルに供給して、その精度と能力を向上させます。
Tensorlakeの主な機能
- ドキュメントインジェストAPI: 手書きメモから複雑なスプレッドシートまで、あらゆるファイルタイプを解析し、レイアウトとコンテキストを維持します。
- 構造化データ抽出: カスタムPythonスキーマを使用して非構造化コンテンツをクリーンなJSONまたはマークダウンチャンクに変換し、高精度の抽出を実現します。
- サーバーレスワークフロー: インフラを管理することなく、Pythonベースのデータ処理パイプラインを構築、デプロイ、スケーリングします。ワークフローは需要に応じて自動的にスケーリングします。
- RAG最適化: メタデータで強化された構造化データチャンクを生成し、検索拡張生成システムの精度と関連性を向上させるために特別に最適化されています。
- 大規模なスケーラビリティ: 顧客あたり1日10万件以上のドキュメントを処理し、1秒あたり1万件のイベントを極めて低いレイテンシで処理するように設計されています。
- 署名検出: ドキュメント内の署名の有無を自動的に識別し、インテリジェントな自動化トリガーを可能にする統合機能。
- セキュアで協調的: ロールベースのアクセス制御(RBAC)、データ保護のための名前空間、完全な可視性とコンプライアンスのための詳細なログを提供します。
Tensorlakeの使用例
Tensorlakeは、データの正確性が最重要視されるハイステークスなアプリケーションに最適です:
- 高度なRAGシステム: セマンティック検索とドキュメントコンテンツ(例:表、図、メタデータ)から派生した構造化フィルターを組み合わせて、LLM用の洗練された検索パイプラインを構築します。
- 金融サービスの自動化: ローン申請書、税務監査書類、財務諸表を処理して主要情報を抽出し、意思決定を自動化します。
- 医療データ管理: 患者記録、検査報告書、医学研究論文をデジタル化および構造化し、分析とコンプライアンスに利用します。
- 法務およびコンプライアンス: 契約書、不動産証書、法務書類を分析して条項を抽出し、リスクを特定し、コンプライアンスを確保します。
- サプライチェーンとロジスティクス: 国際貿易書類、請求書、船荷証券を処理して業務を合理化し、可視性を向上させます。
Tensorlakeの利点
Tensorlakeは、顕著な競争上の優位性を提供します:
- 比類のない精度: 人間のような解析と構造化抽出機能により、高品質のデータを提供し、AIモデルのエラーを最小限に抑えます。
- 開発の簡素化: コードファースト、API駆動のアプローチにより、複雑なデータパイプラインの作成が簡素化され、チームはより迅速に構築できます。
- コスト効率の高いスケーラビリティ: サーバーレスアーキテクチャと透明性の高い従量課金制により、使用した分だけを支払うため、経済的にスケールできます。
- エンドツーエンドのプラットフォーム: インジェスト、構造化、オーケストレーションのための単一の統一ソリューションを提供し、脆弱なマルチツールパイプラインの必要性を排除します。
- 柔軟性: LangChainやQdrantなどの人気ツールとシームレスに統合し、既存のAIスタックを強化します。
料金プラン
Tensorlakeは、ストレージや帯域幅の隠れた料金なしで、透明性の高い使用量ベースの料金モデルを提供しています。
- ドキュメントインジェスト: ページあたり$0.01のシンプルなオンデマンド料金。
- サーバーレスワークフロー: 消費されたコンピューティングリソースに基づいて秒単位で課金されます:
- Nvidia H100: $0.0009/秒
- Nvidia A100: $0.0005/秒
- CPU (1 vCPU): $0.00004/秒
- メモリ (DDR4): $0.00009/GB/秒
- オンプレミス: 自社ネットワーク内でのデプロイ用に、カスタムエンタープライズプランが利用可能です。詳細は営業にお問い合わせください。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 6.9K
- 2026-1: 50.0K
- 2026-2: 61.4K
- 2026-3: 46.7K
- 2026-4: 46.4K
- 2026-5: 31.5K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国55.2%
- 🇳🇬ナイジェリア15.5%
- 🇻🇳ベトナム11.4%
- 🇮🇩インドネシア9.3%
- 🇮🇳インド8.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.3% |
Referral | 8.3% |
Email | 6.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| opencode omo claude ekvivalent | $0.00 |
| opencode with everything claude code, direct use | $0.00 |
| tensorlaek | $0.00 |
| tensorlake | $6.31 |
| tensorlake documentation | $0.00 |
Tensorlake Alternatives
ScrapeGraphAI
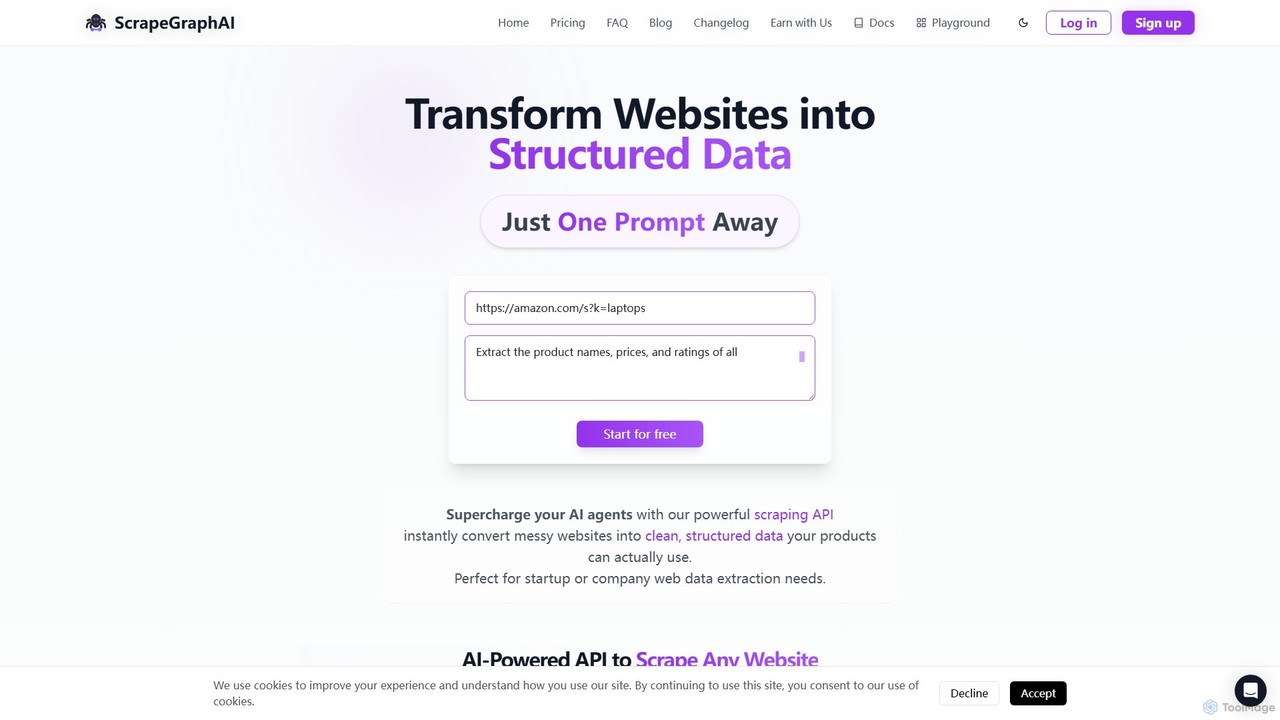
ScrapeGraphAIは、AIを活用したウェブスクレイピングAPIで、簡単な自然言語プロンプトを使って非構造化ウェブサイトをクリーンで構造化されたJSONデータに変換します。開発者、AIエージェント、自動化ワークフロー向けに設計されており、複雑なコードなしでデータ抽出を簡素化します。
分析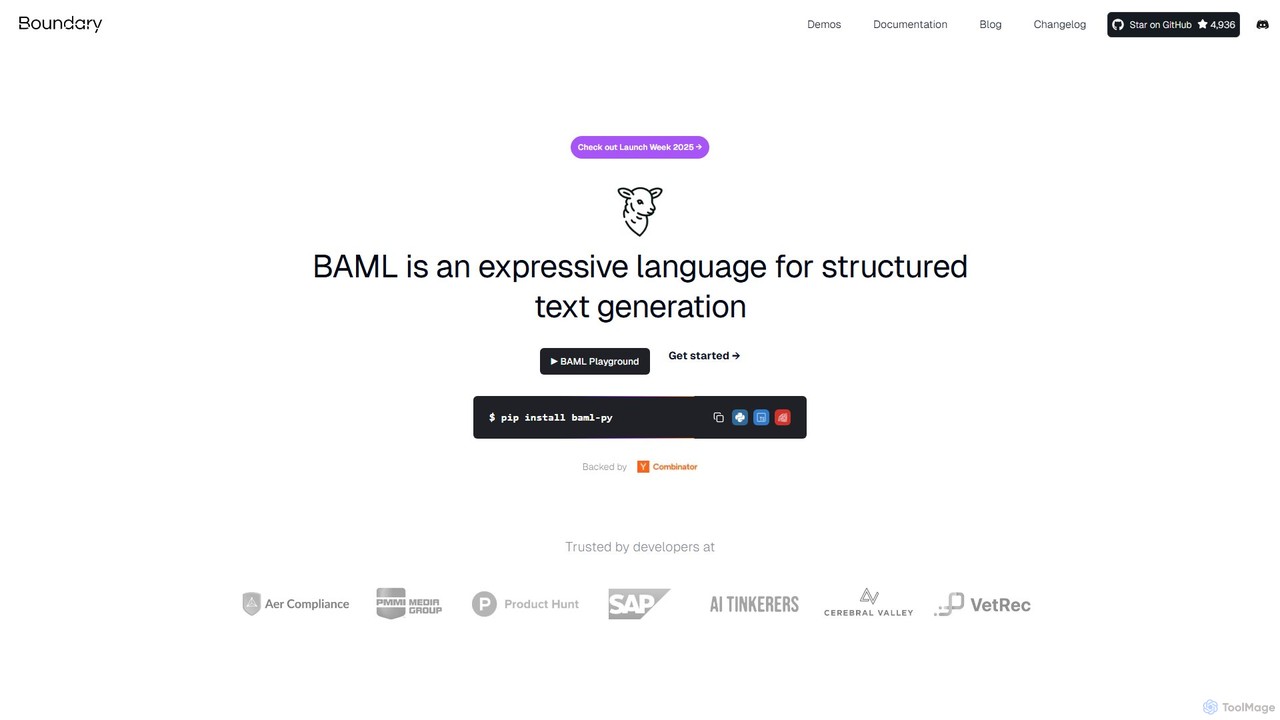
boundaryml
boundaryml (BAML)は、開発者が大規模言語モデル(LLM)から構造化データを確実に抽出するために設計された専門のプログラミング言語およびツールキットです。複雑なプロンプトエンジニアリングを合理化されたコードのようなプロセスに変換し、PythonやTypeScriptなどの様々なLLMやプログラミング言語で型安全でエラー修正された出力を保証します。信頼性を高め、コストを削減し、AIアプリケーションの開発サイクルを加速させることを目的としています。
API

Tensorlake Categories
Tensorlake Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
ScrapeGraphAI
ScrapeGraphAIは、AIを活用したウェブスクレイピングAPIで、簡単な自然言語プロンプトを使って非構造化ウェブサイトをクリーンで構造化されたJSONデータに変換します。開発者、AIエージェント、自動化ワークフロー向けに設計されており、複雑なコードなしでデータ抽出を簡素化します。
分析boundaryml
boundaryml (BAML)は、開発者が大規模言語モデル(LLM)から構造化データを確実に抽出するために設計された専門のプログラミング言語およびツールキットです。複雑なプロンプトエンジニアリングを合理化されたコードのようなプロセスに変換し、PythonやTypeScriptなどの様々なLLMやプログラミング言語で型安全でエラー修正された出力を保証します。信頼性を高め、コストを削減し、AIアプリケーションの開発サイクルを加速させることを目的としています。
API

JSON Scout
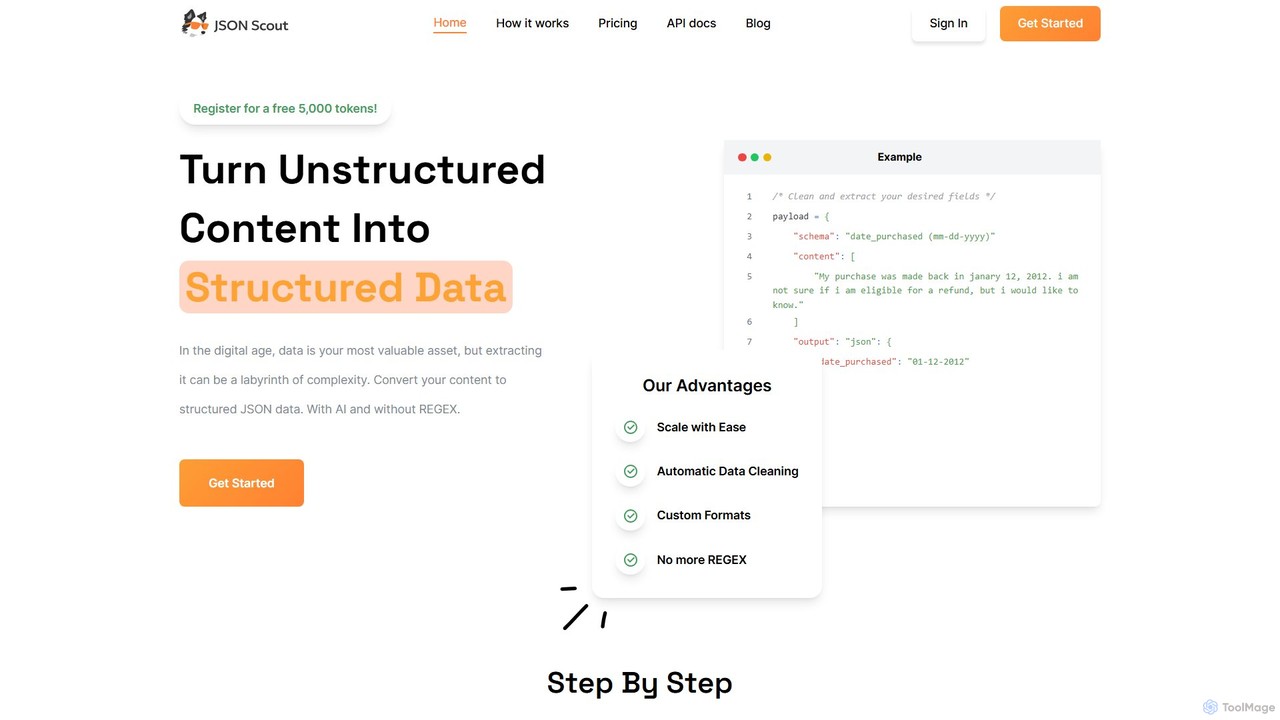
JSON Scoutは、非構造化テキストや音声コンテンツを構造化JSONデータに変換する、開発者向けのAI搭載APIです。GPT-4oのような大規模言語モデル(LLM)を活用し、複雑な正規表現(REGEX)の必要性をなくし、開発時間を節約し、データ抽出の精度を向上させます。
データ処理
Modal
Modalは、AIおよびML開発者向けの高性能サーバーレスインフラストラクチャプラットフォームです。1行のコードでPython関数をクラウドで実行でき、GPUへの即時アクセス、ゼロから数千コンテナへの自動スケーリング、秒単位の課金を提供します。インフラのオーバーヘッドをなくし、生成AI、バッチ処理、データ分析などの計算集約型アプリケーションの構築とデプロイに集中できます。
モデルデプロイメント
Langflow
Langflowは、AIアプリケーションを構築・展開するためのオープンソースのビジュアルUIです。ドラッグ&ドロップインターフェースでLLM、エージェント、ツールを連携させ、RAGやマルチエージェントシステムなどの複雑なワークフローの迅速なプロトタイピングと展開を可能にします。広範な統合をサポートし、セルフホストとクラウドの両方のオプションを提供します。
ローコード・ノーコード
supermemory
supermemoryは、AI時代のためのメモリAPIおよびインフラストラクチャであり、開発者が長期的で永続的なメモリを持つLLMを構築するために設計されています。有限なコンテキストウィンドウの制限を克服し、過去の対話や情報を様々なプラットフォームで記憶する、インテリジェントで文脈を認識するAIエージェント、チャットボット、アプリケーションの作成を可能にします。
LLM
Tensorlake Comments (0)
Sign in to comment.
ログインNo comments yet.