
ToolMage
Entrar

Best 1 Banco de Dados Vetorial AI tools for Banco de Dados

Popular Banco de Dados Vetorial AI tools in Banco de Dados include DeConsole, helping you work more efficiently.

DeConsole
Freemium

DeConsole

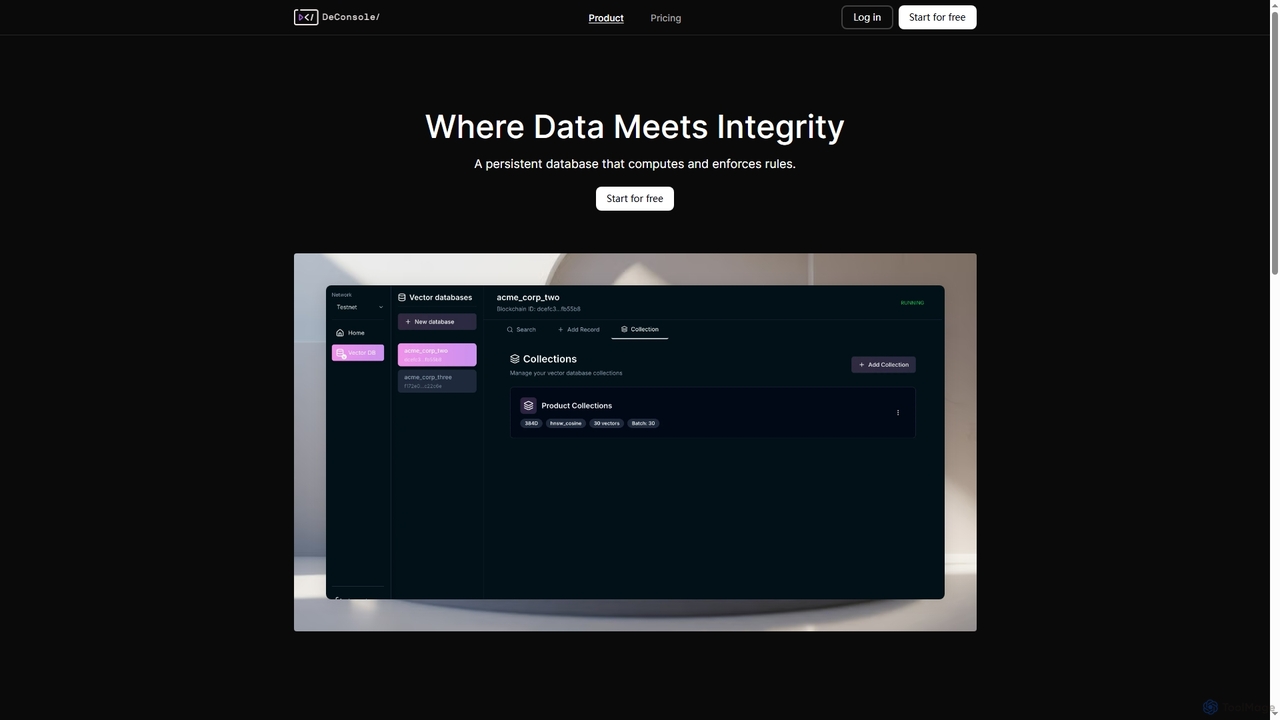
DeConsole é um serviço de banco de dados distribuído, persistente e resistente a adulterações, projetado para dados críticos, oferecendo a simplicidade de um DBaaS em nuvem sem um único ponto de controle. Ele calcula e impõe regras, garantindo a integridade dos dados e fornecendo um histórico à prova de adulteração para várias aplicações, especialmente IA.

Sistemas RAG
Visits 6.4KFavorites 111Likes 117

About Banco de Dados Vetorial

Bancos de dados vetoriais são sistemas de armazenamento de dados especializados projetados para armazenar, indexar e consultar eficientemente embeddings de vetores de alta dimensão. Diferentemente dos bancos de dados tradicionais que gerenciam dados estruturados, os bancos de dados vetoriais se destacam no tratamento de dados não estruturados, representando-os como vetores numéricos, permitindo buscas de similaridade rápidas e compreensão semântica. Eles são cruciais para aplicações de IA que exigem correspondência de similaridade em tempo real, sistemas de recomendação e funcionalidades de busca avançadas, fornecendo a espinha dorsal para sistemas inteligentes modernos.

Recursos Principais

  • Indexação Eficiente de Vetores: Utiliza algoritmos avançados (ex: HNSW, IVF) para indexar vetores de alta dimensão para busca de similaridade rápida.
  • Busca de Similaridade: Permite encontrar os vetores mais semelhantes a um vetor de consulta com base em métricas de distância (ex: similaridade de cosseno, distância euclidiana).
  • Escalabilidade: Projetado para lidar com bilhões de vetores e alto throughput de consultas, frequentemente distribuído em vários nós.
  • Filtragem de Metadados: Permite combinar a busca de similaridade vetorial com a filtragem de metadados tradicional para resultados mais precisos.

Casos de Uso

Bancos de dados vetoriais são essenciais em cenários onde a compreensão semântica e a similaridade são primordiais. Eles impulsionam motores de busca inteligentes que vão além da correspondência de palavras-chave, sistemas de recomendação que sugerem itens relevantes com base nas preferências do usuário e sistemas de detecção de anomalias que identificam padrões incomuns em fluxos de dados.

Como Escolher

Ao selecionar um banco de dados vetorial, considere seus algoritmos de indexação para desempenho, escalabilidade para seu volume de dados, métricas de similaridade suportadas, capacidades de integração com frameworks de IA existentes e custo-benefício. Avalie sua capacidade de lidar com filtragem de metadados e atualizações em tempo real para aplicações dinâmicas.

Banco de Dados Vetorial use cases

1

Construção de Motores de Busca Semântica

Plataformas de conteúdo ou sites de e-commerce podem usar bancos de dados vetoriais para impulsionar a busca semântica. Os usuários inserem consultas em linguagem natural, que são convertidas em vetores. O banco de dados então encontra documentos ou produtos com vetores semanticamente semelhantes, fornecendo resultados mais relevantes do que a busca baseada em palavras-chave, mesmo para consultas sutis.

2

Desenvolvimento de Sistemas de Recomendação Alimentados por IA

Serviços de streaming ou varejistas online utilizam bancos de dados vetoriais para recomendar conteúdo ou produtos. Dados de interação do usuário (por exemplo, filmes assistidos, itens comprados) são incorporados em vetores. Ao encontrar vetores de usuário ou item semelhantes, o sistema pode sugerir recomendações altamente personalizadas, aumentando o engajamento do usuário e as vendas.

3

Implementação de Detecção de Anomalias em Tempo Real

Instituições financeiras ou empresas de cibersegurança implantam bancos de dados vetoriais para detecção de anomalias em tempo real. Registros de tráfego de rede ou dados de transação são convertidos em vetores. O banco de dados identifica rapidamente vetores que são significativamente diferentes dos padrões normais conhecidos, sinalizando instantaneamente possíveis fraudes ou violações de segurança.

4

Aprimorando Aplicações de IA Generativa com RAG

Desenvolvedores que constroem aplicações de modelos de linguagem grandes (LLM) usam bancos de dados vetoriais para Geração Aumentada por Recuperação (RAG). Conhecimento externo relevante (documentos, artigos) é armazenado como vetores. Quando um LLM recebe uma consulta, o banco de dados vetorial recupera informações contextualmente semelhantes, permitindo que o LLM gere respostas mais precisas e atualizadas.

5

Potencializando a Busca de Imagens e Vídeos

Empresas de mídia ou sistemas de gerenciamento de ativos digitais utilizam bancos de dados vetoriais para busca visual. Imagens ou quadros de vídeo são incorporados em vetores. Os usuários podem então consultar por exemplo (carregando uma imagem) ou por descrição de texto, e o banco de dados retorna ativos de mídia visual ou semanticamente semelhantes, otimizando a descoberta de conteúdo.

6

Criação de Chatbots Inteligentes e Sistemas de Perguntas e Respostas

Departamentos de atendimento ao cliente ou plataformas de gerenciamento de conhecimento empregam bancos de dados vetoriais para construir chatbots inteligentes. Artigos da base de conhecimento ou FAQs são vetorizados. Quando um usuário faz uma pergunta, o chatbot consulta o banco de dados vetorial para encontrar as respostas semanticamente mais relevantes, fornecendo respostas precisas e conscientes do contexto.

Banco de Dados Vetorial FAQ

O que é um Banco de Dados Vetorial?

Um banco de dados vetorial é um banco de dados especializado projetado para armazenar, indexar e consultar vetores de alta dimensão, que são representações numéricas de dados como texto, imagens ou áudio. Sua função principal é realizar buscas de similaridade eficientes, encontrando vetores que estão "próximos" a um determinado vetor de consulta com base em várias métricas de distância. Essa capacidade é fundamental para aplicações de IA que dependem da compreensão de relações semânticas em vez de correspondências exatas.

Como um Banco de Dados Vetorial difere de um Banco de Dados Relacional Tradicional?

Bancos de dados relacionais tradicionais armazenam dados estruturados em tabelas com linhas e colunas, otimizados para correspondências exatas e operações transacionais. Bancos de dados vetoriais, por outro lado, são otimizados para armazenar e consultar dados não estruturados representados como vetores de alta dimensão, focando na busca de similaridade. Enquanto bancos de dados relacionais usam SQL para recuperação precisa de dados, bancos de dados vetoriais usam algoritmos de similaridade vetorial para encontrar vizinhos mais próximos aproximados, tornando-os adequados para busca semântica e aplicações de IA.

Quais são os principais benefícios de usar um Banco de Dados Vetorial?

Os principais benefícios incluem a habilitação de capacidades de busca semântica, o impulsionamento de sistemas de recomendação avançados, a facilitação da detecção de anomalias em tempo real e o aprimoramento de modelos de IA generativa através da Geração Aumentada por Recuperação (RAG). Eles oferecem desempenho superior para consultas de similaridade em grandes conjuntos de dados, permitindo que as aplicações de IA compreendam o contexto e as relações nos dados de forma mais eficaz do que os métodos tradicionais.

Quais são os casos de uso comuns para Bancos de Dados Vetoriais?

Bancos de dados vetoriais são amplamente utilizados em motores de busca semântica para sites e aplicações, sistemas de recomendação personalizados (por exemplo, e-commerce, streaming), detecção de fraudes, análise de ameaças de cibersegurança, reconhecimento de imagens e vídeos, e para alimentar chatbots inteligentes ou sistemas de perguntas e respostas. Eles também são críticos para aumentar modelos de linguagem grandes (LLMs) com informações externas e atualizadas.

Como os Bancos de Dados Vetoriais lidam com escalabilidade e desempenho?

Bancos de dados vetoriais alcançam escalabilidade e desempenho através de várias técnicas. Eles usam algoritmos de vizinhos mais próximos aproximados (ANN) (como HNSW, IVF) para indexar vetores eficientemente, permitindo buscas rápidas mesmo com bilhões de vetores. Muitos são projetados para arquiteturas distribuídas, permitindo escalabilidade horizontal em vários nós. Eles também otimizam para alto throughput de consultas e baixa latência, frequentemente aproveitando o processamento em memória e hardware especializado.