
ToolMage
Entrar

Best 1 Avaliação de LLM AI tools for Ferramentas para Desenvolvedores

Popular Avaliação de LLM AI tools in Ferramentas para Desenvolvedores include Cleanlab Chat, helping you work more efficiently.

Cleanlab Chat
Freemium

Cleanlab Chat

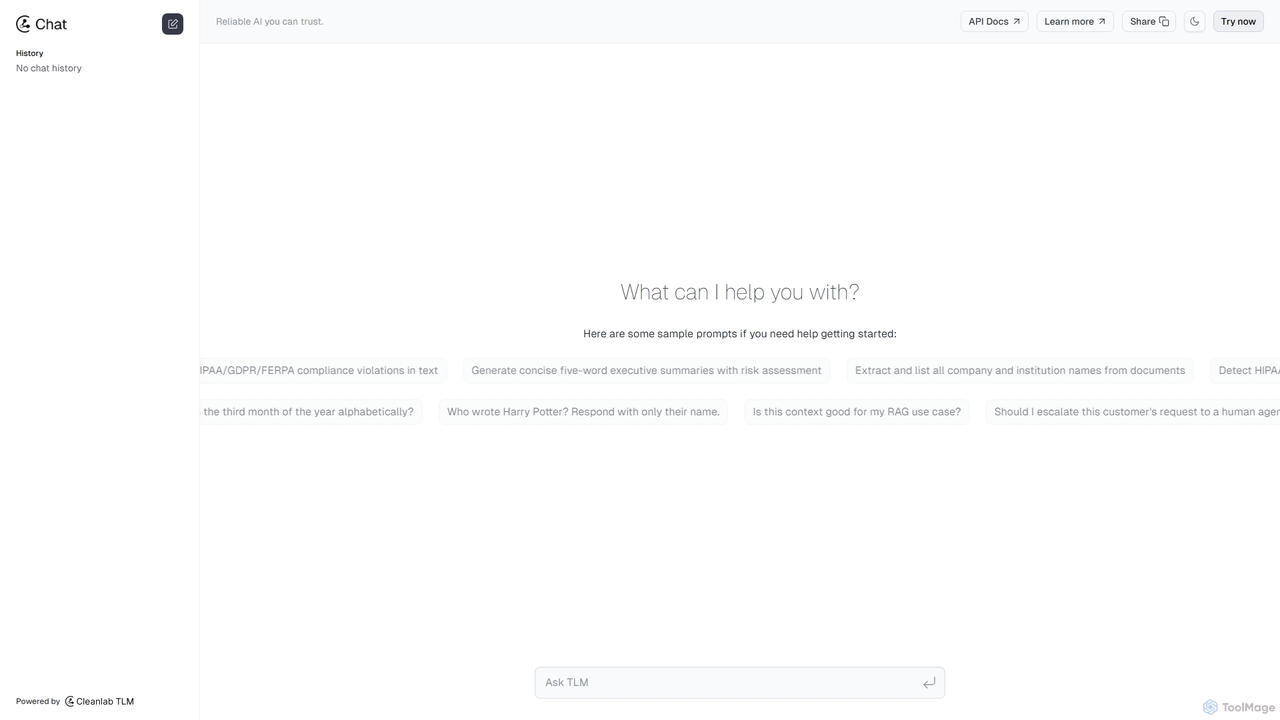
O Cleanlab Chat é uma interface de chat de IA avançada, alimentada pelo Modelo de Linguagem Confiável (TLM) da Cleanlab. Foi projetado para tarefas de nível empresarial, incluindo avaliação de sistemas RAG, deteção de alucinações, verificações de conformidade de dados (HIPAA, GDPR) e análise de texto confiável, garantindo precisão e segurança em aplicações de negócios.

Avaliação de LLM
Visits 6.6KFavorites 170Likes 163

About Avaliação de LLM

As ferramentas de Avaliação de LLM são uma categoria especializada de utilitários para desenvolvedores, projetadas para medir, analisar e comparar sistematicamente o desempenho de Grandes Modelos de Linguagem (LLMs). Essas plataformas fornecem estruturas para executar benchmarks padronizados, calcular métricas-chave e realizar avaliações qualitativas para garantir a confiabilidade, precisão e segurança do modelo. Elas são essenciais para que desenvolvedores e organizações validem o comportamento do modelo antes da implantação, monitorem o desempenho em produção e tomem decisões baseadas em dados ao selecionar ou ajustar modelos. Este processo ajuda a identificar fraquezas, vieses e riscos potenciais associados às saídas do LLM.

Recursos Principais

  • Benchmarking Automatizado: Execute modelos em conjuntos de dados acadêmicos e industriais padrão (ex: MMLU, HellaSwag) para obter pontuações de desempenho comparáveis.
  • Cálculo de Métricas: Calcule automaticamente métricas quantitativas como precisão, perplexidade, pontuações BLEU/ROUGE, níveis de toxicidade e indicadores de viés.
  • Avaliação Humana no Ciclo (HITL): Forneça interfaces para revisores humanos classificarem, ranquearem ou compararem as saídas do modelo lado a lado para análise qualitativa.
  • Testes Adversariais e Red Teaming: Investigue sistematicamente os modelos em busca de vulnerabilidades, falhas de segurança e comportamentos inesperados, gerando entradas desafiadoras ou maliciosas.
  • Acompanhamento de Desempenho e Custo: Monitore métricas operacionais como latência, throughput e custos de API durante o processo de avaliação para avaliar a prontidão para produção.

Casos de Uso

As ferramentas de Avaliação de LLM são cruciais em todo o ciclo de vida de desenvolvimento de IA. Elas são usadas por engenheiros de ML para testes de regressão após o ajuste fino de um modelo, por equipes de segurança de IA para auditar viés e toxicidade antes de um lançamento público, e por gerentes de produto para comparar diferentes modelos de terceiros (como GPT vs. Claude) para uma aplicação específica. Essas ferramentas também são vitais para o monitoramento contínuo para detectar degradação de desempenho ou desvio do modelo em aplicações ativas.

Como Escolher

Ao selecionar uma ferramenta de Avaliação de LLM, considere seu suporte a vários modelos (APIs proprietárias e de código aberto), a amplitude de seus benchmarks e métricas integrados e sua flexibilidade para definir conjuntos de dados e critérios de avaliação personalizados. Avalie também suas capacidades de integração com pipelines de MLOps (como CI/CD), seus recursos para feedback humano colaborativo e sua escalabilidade para lidar com testes em larga escala. O modelo de precificação — seja baseado em uso, assentos ou recursos — é outro fator importante.

Avaliação de LLM use cases

1

Selecionando o melhor LLM para um chatbot de atendimento ao cliente

Uma equipe de produto de uma empresa de e-commerce precisa escolher o LLM mais adequado para seu novo agente de atendimento ao cliente com IA. Eles usam uma plataforma de avaliação de LLM para comparar três candidatos: GPT-4o, Claude 3 Opus e um modelo Llama 3 ajustado. A equipe cria um conjunto de dados de avaliação personalizado com 1.000 consultas de clientes do mundo real, cobrindo tópicos como rastreamento de pedidos, devoluções e perguntas sobre produtos. A ferramenta automatiza o processo de executar cada consulta nos três modelos e calcula métricas de precisão, utilidade e adesão ao tom desejado pela empresa. Em seguida, revisores humanos usam a interface de comparação lado a lado da plataforma para pontuar as respostas em qualidades sutis, levando a uma decisão baseada em dados.

2

Automatizando testes de regressão para atualizações de modelo

Uma empresa de software corporativo ajusta seu modelo proprietário de geração de código trimestralmente com novos dados. Para evitar a degradação do desempenho, sua equipe de MLOps integra uma ferramenta de avaliação de LLM em seu pipeline de CI/CD. Após cada execução de ajuste fino, o pipeline aciona automaticamente um trabalho de avaliação. Este trabalho executa o modelo atualizado em um 'conjunto de dados de ouro' de 500 desafios de programação complexos com soluções ótimas conhecidas. A ferramenta mede a correção do código, a eficiência e a adesão aos guias de estilo. Se qualquer métrica chave cair abaixo de um limiar predefinido, a compilação falha e a equipe é alertada, impedindo que um modelo defeituoso seja implantado em produção.

3

Conduzindo auditorias de segurança e viés de IA

Uma empresa de serviços financeiros está desenvolvendo um LLM para auxiliar no resumo de documentos regulatórios. Antes da implantação, sua equipe de conformidade e segurança de IA usa uma ferramenta de avaliação para conduzir uma auditoria completa. Eles usam os recursos de red teaming da ferramenta para gerar prompts adversários projetados para testar vieses relacionados a características protegidas (ex: idade, gênero) e para investigar vulnerabilidades de segurança, como ataques de injeção de prompt. A plataforma sinaliza automaticamente respostas tóxicas, enviesadas ou não conformes e gera um relatório detalhado. Isso permite que a equipe de desenvolvimento identifique e mitigue riscos de segurança críticos antes que o modelo seja usado internamente.

4

Comparando estratégias de engenharia de prompt

Uma equipe de marketing está usando um LLM para gerar textos de anúncios para mídias sociais. Para encontrar a estrutura de prompt mais eficaz, eles usam uma ferramenta de avaliação para testar A/B diferentes técnicas de prompting, como zero-shot, few-shot e cadeia de pensamento. Eles criam um conjunto de testes com 100 descrições de produtos diferentes. A ferramenta executa cada descrição através do LLM usando cinco modelos de prompt diferentes. As saídas são então pontuadas automaticamente com base em uma rubrica de criatividade, clareza e consistência da voz da marca. Essa abordagem sistemática permite que a equipe identifique o modelo de prompt que produz consistentemente o texto da mais alta qualidade, otimizando seu fluxo de trabalho de criação de conteúdo.

5

Monitorando modelos de produção para desvio de desempenho

Uma empresa de tecnologia jurídica usa um LLM para alimentar um recurso de resumo de documentos. Para garantir que sua qualidade permaneça alta ao longo do tempo, eles empregam uma ferramenta de avaliação para monitoramento contínuo. A ferramenta é configurada para amostrar 1% de todas as solicitações de produção e seus resumos correspondentes diariamente. Ela calcula automaticamente as métricas ROUGE e BERTScore comparando a saída do LLM com um resumo de referência (quando disponível) ou outras heurísticas. Um painel visualiza essas métricas ao longo do tempo. Se a pontuação média do ROUGE cair mais de 5% em uma semana, um alerta é enviado à equipe de engenharia, sinalizando um possível desvio do modelo e solicitando uma investigação ou um ciclo de retreinamento.

6

Otimizando custo e latência em aplicações em tempo real

Um desenvolvedor está construindo um recurso de tradução em tempo real para um aplicativo móvel e precisa equilibrar qualidade, velocidade e custo. Ele usa uma ferramenta de avaliação de LLM para comparar um modelo grande e de alta qualidade (como o GPT-4) com um modelo menor, mais rápido e mais barato (como um modelo de código aberto destilado). Ele executa um conjunto de testes com 2.000 frases comuns em ambos os modelos. A ferramenta de avaliação registra não apenas a precisão da tradução (usando pontuações BLEU), mas também a latência média e o custo da API para cada modelo. O relatório resultante fornece uma análise clara de trade-offs, permitindo que o desenvolvedor escolha o modelo que atende ao padrão mínimo de qualidade para seus usuários, mantendo-se dentro das metas de orçamento e latência.

Avaliação de LLM FAQ

O que são ferramentas de Avaliação de LLM?

As ferramentas de Avaliação de LLM são plataformas de software especializadas que ajudam desenvolvedores, pesquisadores e organizações a medir sistematicamente o desempenho e a segurança de Grandes Modelos de Linguagem. Elas fornecem estruturas para automatizar testes, comparar diferentes modelos ou prompts e analisar os resultados com base em métricas definidas. As funções principais incluem a execução de benchmarks, o cálculo de pontuações de precisão e fluência, a detecção de viés e toxicidade e a facilitação de feedback humano. Essas ferramentas são essenciais para garantir que as aplicações baseadas em LLM sejam confiáveis, eficazes e seguras antes e depois da implantação.

Como escolher a ferramenta de Avaliação de LLM certa?

A escolha da ferramenta certa depende das suas necessidades específicas. Considere os seguintes fatores:

  • Suporte a Modelos: A ferramenta suporta os LLMs que você usa (ex: OpenAI, Anthropic, modelos de código aberto como Llama)?
  • Métricas e Benchmarks: Oferece os benchmarks e métricas padrão relevantes para o seu caso de uso (ex: ROUGE para sumarização, correção de código para geração)?
  • Personalização: Você pode facilmente carregar seus próprios conjuntos de dados privados e definir lógicas ou métricas de avaliação personalizadas?
  • Integração: Quão bem ela se integra ao seu fluxo de trabalho MLOps existente, como pipelines de CI/CD para testes automatizados?
  • Recursos de Colaboração: Fornece uma boa interface de usuário para que revisores humanos forneçam feedback qualitativo?
  • Escalabilidade e Custo: Ela pode lidar com o volume de avaliações que você precisa, e seu modelo de preços se ajusta ao seu orçamento?
Qual é a diferença entre avaliação automatizada e humana para LLMs?

A avaliação automatizada e a avaliação humana são dois métodos complementares para avaliar LLMs. A avaliação automatizada usa métricas computáveis (como BLEU, ROUGE, precisão) para pontuar rapidamente as saídas do modelo em relação a um conjunto de dados de referência em grande escala. É rápida, barata e objetiva para tarefas específicas. Por outro lado, a avaliação humana envolve pessoas classificando ou comparando as saídas do modelo com base em qualidades subjetivas como criatividade, coerência, utilidade ou tom. Embora mais lenta e mais cara, é o padrão ouro para capturar aspectos sutis da linguagem que as métricas automatizadas muitas vezes não conseguem. A maioria das estratégias de avaliação robustas usa métodos automatizados para testes rápidos e amplos e feedback humano para uma validação mais profunda e qualitativa.

Quais são as métricas comuns usadas na Avaliação de LLM?

As métricas usadas dependem muito da tarefa. No entanto, algumas comuns incluem:

  • Precisão (Accuracy): Para tarefas de classificação ou resposta a perguntas, mede a porcentagem de previsões corretas.
  • Perplexidade (Perplexity): Mede quão bem um modelo de probabilidade prevê uma amostra. Uma perplexidade menor geralmente indica um modelo melhor.
  • BLEU/ROUGE: Comumente usados para tradução e resumo, eles comparam a sobreposição de n-gramas entre a saída do modelo e um texto de referência.
  • Pontuações de Toxicidade/Viés: Classificadores especializados são usados para pontuar as saídas em busca de conteúdo prejudicial, estereótipos ou outros vieses.
  • Latência e Custo: Métricas operacionais que medem o tempo de resposta do modelo e o custo financeiro por inferência, cruciais para aplicações do mundo real.
Por que a avaliação contínua de LLMs em produção é importante?

A avaliação contínua é crucial porque o desempenho de um LLM não é estático. Ele pode se degradar ao longo do tempo devido a um fenômeno chamado 'desvio de modelo' (model drift), onde os padrões nos dados de entrada do mundo real mudam e não correspondem mais aos dados com os quais o modelo foi treinado. Por exemplo, um bot de atendimento ao cliente pode encontrar novos tipos de consultas para as quais não foi treinado. O monitoramento contínuo de métricas-chave permite que as equipes detectem essa degradação de desempenho precocemente, identifiquem sua causa (ex: novos tópicos, mudança na linguagem do usuário) e acionem as ações necessárias, como retreinar o modelo ou atualizar os prompts. Isso garante que a aplicação permaneça confiável e eficaz para os usuários muito tempo após seu lançamento inicial.