
Freemium
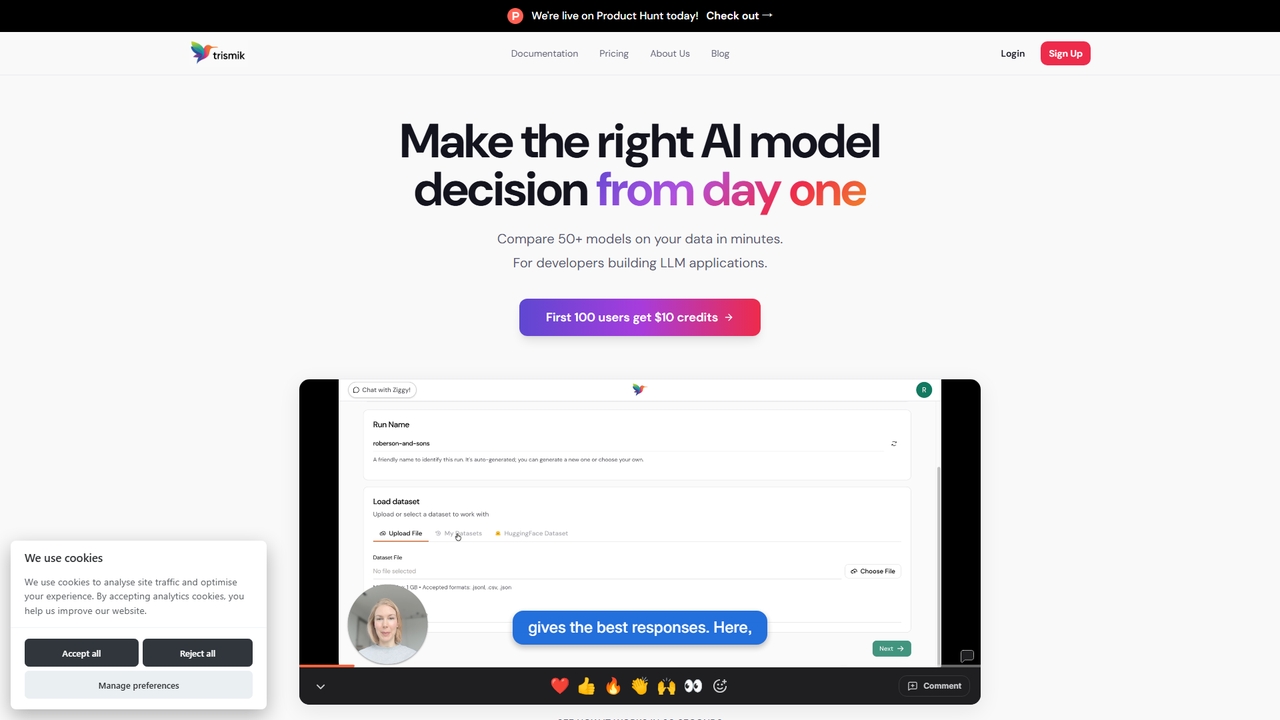
Trismik
Compare mais de 50 LLMs em seus próprios dados em minutos. Tome decisões de modelo baseadas em evidências sobre qualidade, custo e velocidade.
Ai Model SelectionVisits 9.7KFavorites 50Likes 49
Popular Comparação de Modelos AI tools in Ferramentas para Desenvolvedores include Trismik, Compare AI Models e Joythee AI, helping you work more efficiently.
Compare mais de 50 LLMs em seus próprios dados em minutos. Tome decisões de modelo baseadas em evidências sobre qualidade, custo e velocidade.
Ai Model Selection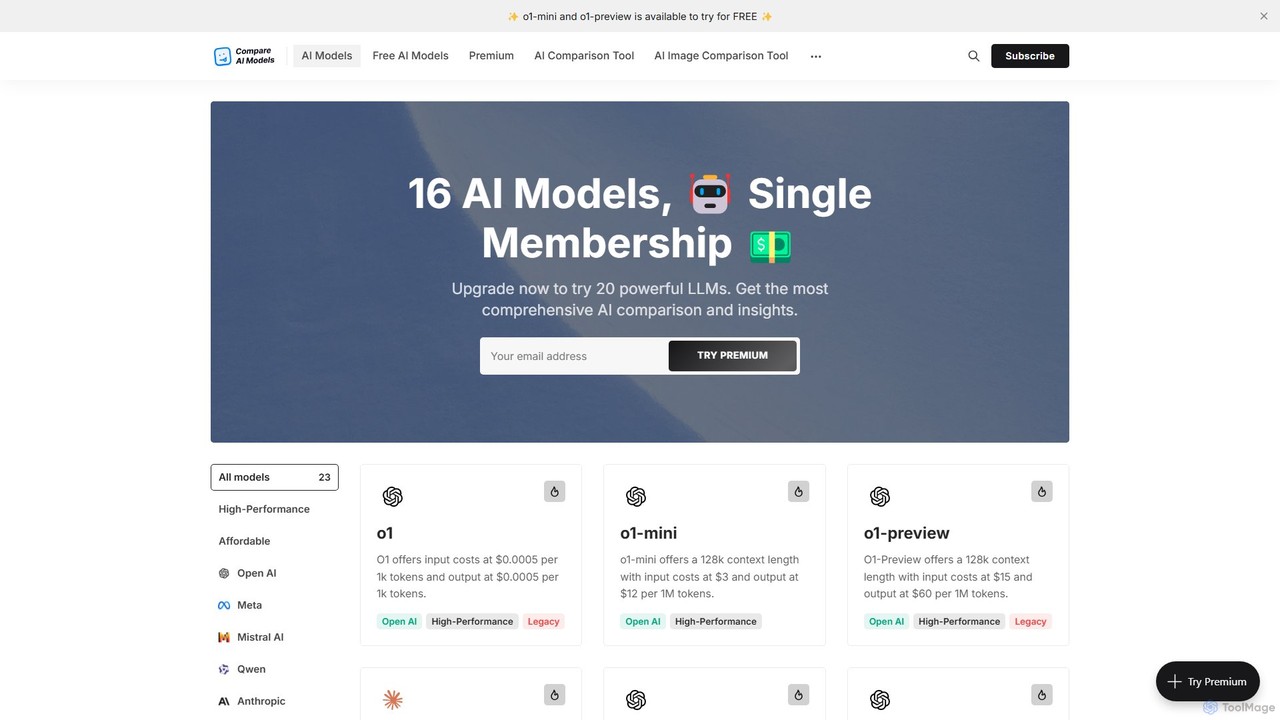
Uma plataforma abrangente para comparar mais de 20 dos principais Modelos de Linguagem Grandes (LLMs). Oferece métricas detalhadas sobre desempenho, preços de API, janelas de contexto e recursos, juntamente com um chat gratuito para testar modelos diretamente. Uma ferramenta essencial para desenvolvedores, pesquisadores e empresas encontrarem a IA perfeita para suas necessidades.
Diretório LLM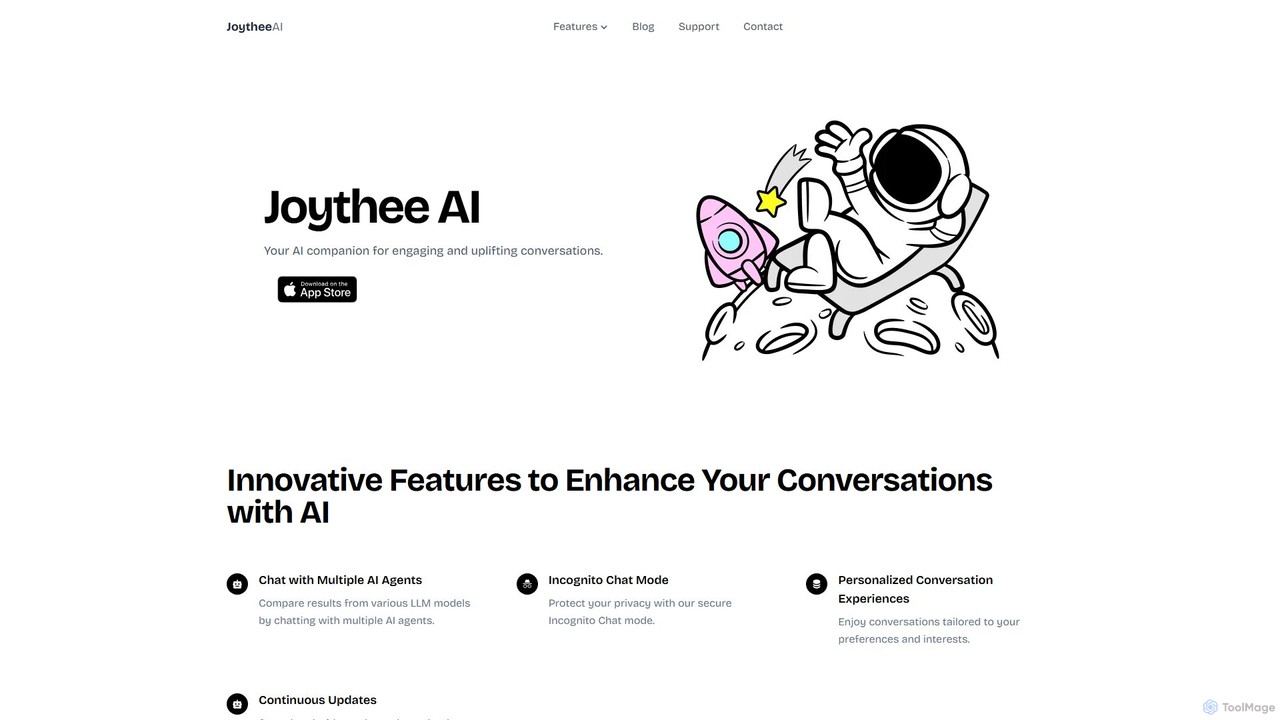
Joythee AI é uma plataforma avançada de IA conversacional que permite conversar com múltiplos agentes de IA simultaneamente. Compare respostas de vários LLMs em uma única interface, desfrute de conversas personalizadas e proteja sua privacidade com um modo de navegação anônima. Ideal para indivíduos, equipes e empresas que buscam maior produtividade e criatividade.
Comparação de ModelosAs ferramentas de Comparação de Modelos são plataformas especializadas dentro do kit de ferramentas do desenvolvedor, projetadas para avaliar, referenciar e comparar sistematicamente o desempenho de diferentes modelos de IA. Essas ferramentas fornecem um ambiente estruturado para executar modelos como LLMs ou geradores de imagem com as mesmas entradas e conjuntos de dados para medir seus resultados objetivamente. Elas são essenciais para tomar decisões baseadas em dados, permitindo que desenvolvedores e pesquisadores selecionem o modelo mais preciso, econômico e eficiente para uma aplicação específica. Ao oferecer análise lado a lado e métricas quantitativas, elas simplificam o processo de seleção de modelos, que de outra forma seria complexo e demorado.
Essas ferramentas são cruciais para desenvolvedores de IA, engenheiros de MLOps e gerentes de produto durante o ciclo de vida de desenvolvimento e manutenção. Elas são usadas ao selecionar um modelo fundamental para um novo recurso, avaliar o impacto do ajuste fino ou realizar testes de regressão após uma atualização do modelo. Por exemplo, uma equipe construindo um chatbot de atendimento ao cliente usaria essas ferramentas para comparar as habilidades de conversação e os custos dos modelos da OpenAI, Anthropic e Google antes de se comprometer com um.
Ao selecionar uma ferramenta de Comparação de Modelos, considere a amplitude dos modelos suportados, incluindo APIs proprietárias e opções de código aberto. Avalie os conjuntos de benchmarks disponíveis e a flexibilidade para criar conjuntos de dados de avaliação personalizados. Analise suas capacidades de integração com seu fluxo de trabalho de MLOps e pipelines de CI/CD existentes. Por fim, considere os recursos de colaboração que permitem aos membros da equipe revisar os resultados e os modelos de preços que escalam com suas necessidades de avaliação.
Uma equipe de produto está desenvolvendo um novo chatbot de suporte ao cliente com IA. Eles usam uma ferramenta de comparação de modelos para avaliar o GPT-4, Claude 3 Sonnet e Llama 3 70B. Eles criam um 'conjunto de dados de ouro' com 100 consultas comuns de clientes e executam os três modelos com ele. A plataforma fornece uma visão lado a lado das respostas, juntamente com métricas automatizadas de utilidade e tom. Ela também calcula o custo médio por 1.000 conversas para cada modelo. Com base nos resultados, eles escolhem o Claude 3 Sonnet, pois oferece o melhor equilíbrio entre qualidade de conversação e custo operacional para seu caso de uso específico.
Um engenheiro de ML ajustou um modelo de código aberto Mistral 7B com documentos internos da empresa para uma tarefa de perguntas e respostas. Para justificar a implantação, ele usa uma ferramenta de comparação para comparar o modelo ajustado com o modelo base Mistral 7B e um modelo proprietário como o GPT-4. Ele carrega um conjunto de teste de 50 perguntas técnicas. A ferramenta mede a precisão factual e a relevância. Os resultados mostram que seu modelo ajustado supera o modelo base em 30% em precisão e é 10 vezes mais barato que o GPT-4, fornecendo evidências claras para prosseguir com a implantação.
Uma equipe de MLOps gerencia um recurso de resumo que depende de uma API de modelo externa. O provedor da API anuncia uma nova versão. Antes de mudar, a equipe usa uma plataforma de comparação de modelos para executar seu conjunto de 500 documentos de teste nas versões antiga e nova da API. A plataforma sinaliza automaticamente quaisquer resumos da nova versão que sejam significativamente mais curtos, menos coerentes ou factualmente incorretos em comparação com o resultado da versão antiga. Este teste de regressão automatizado evita a degradação da qualidade do serviço e garante uma transição suave para o modelo atualizado.
Uma agência de marketing precisa selecionar um modelo de geração de imagem para criar criativos de anúncios. Eles usam uma ferramenta de comparação para testar DALL-E 3, Midjourney e Stable Diffusion com 20 prompts diferentes relacionados aos produtos de seu cliente. A ferramenta permite que sua equipe criativa avalie cada imagem gerada em uma escala de 1 a 5 quanto à aderência ao prompt, qualidade estética e alinhamento com a marca. As pontuações agregadas revelam que, embora o Midjourney produza as imagens mais esteticamente agradáveis, o DALL-E 3 é superior na incorporação precisa de detalhes específicos do produto mencionados nos prompts, tornando-o a melhor escolha para suas necessidades.
Um serviço de agregação de notícias usa um LLM para resumir artigos. Para reduzir custos, eles querem encontrar o modelo mais barato que mantenha a qualidade. Usando uma ferramenta de comparação, eles testam cinco modelos diferentes, desde o GPT-4 de ponta até alternativas de código aberto menores. Eles processam 1.000 artigos em cada um e usam pontuações ROUGE automatizadas para medir a qualidade do resumo, enquanto a ferramenta rastreia o custo de cada modelo. Eles descobrem que uma versão quantizada de um modelo Llama 3 8B fornece 95% da qualidade do GPT-4 por apenas 10% do custo, levando a economias mensais significativas.
Um engenheiro de prompts tem a tarefa de criar o prompt mais eficaz para um recurso de geração de código. Em vez de testar os prompts um por um, ele usa uma ferramenta de comparação de modelos para configurar um experimento matricial. Ele insere três variações de prompts diferentes e as testa em quatro modelos (por exemplo, GPT-4, Claude 3 Opus, Gemini Pro e um modelo de código especializado). A plataforma executa todas as 12 combinações e apresenta os resultados em um mapa de calor, mostrando qual par de prompt-modelo produz o código mais preciso e eficiente. Isso acelera o processo de otimização de prompts em dez vezes.
Ferramentas de Comparação de Modelos de IA são plataformas de software especializadas que permitem a desenvolvedores e pesquisadores avaliar e comparar sistematicamente múltiplos modelos de IA entre si. Em vez de testar manualmente cada modelo, essas ferramentas fornecem uma interface unificada para executar os mesmos prompts ou conjuntos de dados em diferentes modelos (como GPT-4, Claude 3 e Llama 3) simultaneamente. Elas medem e exibem métricas-chave como qualidade da saída, custo, latência e desempenho em testes padronizados, permitindo decisões objetivas e baseadas em dados ao selecionar o melhor modelo para uma tarefa específica.
A escolha da ferramenta certa depende de suas necessidades específicas. Considere os seguintes fatores:
A comparação de modelos e o monitoramento de modelos são duas etapas distintas no ciclo de vida do MLOps. A comparação de modelos é uma atividade pré-implantação. Trata-se de selecionar o melhor modelo de um conjunto de candidatos antes de entrar em produção. Você compara modelos em um conjunto de dados de teste estático para avaliar suas capacidades principais. O monitoramento de modelos é uma atividade pós-implantação. Envolve o acompanhamento do desempenho de um modelo ao vivo em produção, observando problemas como desvio de dados, degradação de desempenho ou comportamento inesperado com dados de usuários do mundo real. Em resumo, a comparação ajuda você a escolher o modelo certo, enquanto o monitoramento garante que o modelo escolhido permaneça certo.
As métricas para comparar modelos de IA podem ser divididas em duas categorias principais:
Uma avaliação abrangente usa uma mistura de ambas para obter uma imagem completa do desempenho de um modelo.
As ferramentas de Comparação de Modelos são valiosas para uma gama de profissionais envolvidos na construção de produtos com IA. Os principais usuários incluem: