
ToolMage
Entrar

Best 1 Gerenciamento de Infraestrutura AI tools for MLOps

Popular Gerenciamento de Infraestrutura AI tools in MLOps include PloyD, helping you work more efficiently.

PloyD

PloyD

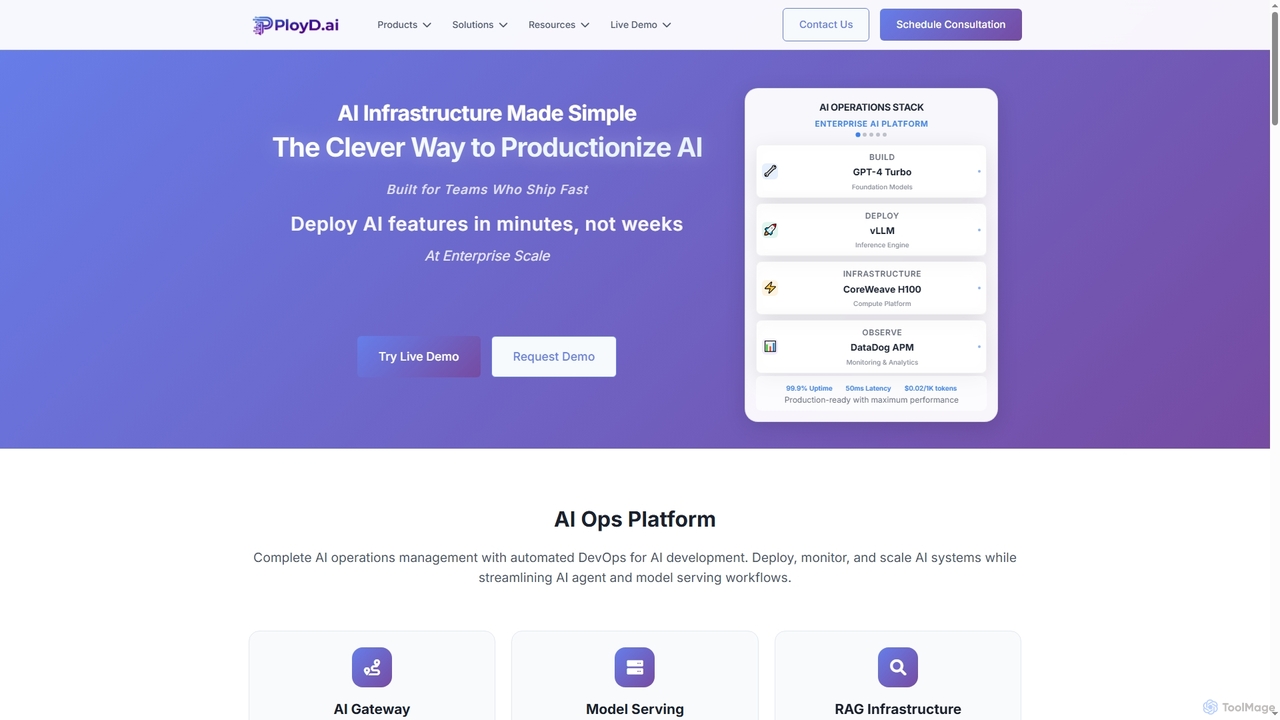
PloyD é uma plataforma de operações de IA empresarial projetada para otimizar a produção de modelos e aplicações de IA. Ela aborda desafios comuns como gargalos na velocidade do desenvolvedor, complexidade da infraestrutura, eficiência da equipe e conformidade de segurança, permitindo que as organizações implantem, gerenciem e escalem soluções de IA com confiança e rapidez.

Sistemas RAG
Visits 7.5KFavorites 146Likes 166

About Gerenciamento de Infraestrutura

As ferramentas de Gerenciamento de Infraestrutura para MLOps são plataformas especializadas para provisionar, escalar e otimizar os recursos computacionais necessários para os ciclos de vida de aprendizado de máquina. Essas ferramentas automatizam o gerenciamento de hardware como GPUs e CPUs, seja localmente (on-premise) ou na nuvem, orquestrando ambientes em contêineres. Seu valor principal reside na melhoria da utilização de recursos, na redução dos custos de computação em nuvem e na aceleração do pipeline da experimentação à produção para modelos de IA. Como a camada fundamental de uma pilha de MLOps, elas fornecem o ambiente estável e escalável necessário para treinar, implantar e gerenciar modelos de forma eficaz.

Recursos Principais

  • Orquestração de Recursos de Computação: Gerencia e agenda trabalhos de ML em clusters compartilhados de GPUs e CPUs para maximizar a utilização.
  • Provisionamento Automatizado de Ambientes: Cria ambientes de desenvolvimento e produção consistentes e reproduzíveis usando contêineres como o Docker.
  • Capacidades de Autoescalonamento: Ajusta automaticamente a alocação de recursos de computação com base nas demandas em tempo real das cargas de trabalho de treinamento ou inferência.
  • Monitoramento de Custo e Uso: Fornece painéis detalhados para rastrear o consumo de recursos, analisar gastos e identificar oportunidades de otimização de custos.
  • Suporte Híbrido e Multi-Nuvem: Oferece uma interface unificada para gerenciar recursos de forma transparente em data centers locais e múltiplos provedores de nuvem (por exemplo, AWS, GCP, Azure).

Casos de Uso

Essas ferramentas são essenciais para engenheiros de MLOps, equipes de DevOps que apoiam iniciativas de IA e equipes de ciência de dados em organizações que executam numerosos ou modelos de aprendizado de máquina em grande escala. Cenários comuns incluem o gerenciamento de um cluster de GPU compartilhado em uma instituição de pesquisa para garantir acesso justo, a automação da infraestrutura para treinar grandes modelos de linguagem (LLMs) ou a otimização dos gastos com a nuvem para o departamento de IA de uma empresa.

Como Escolher

Ao selecionar uma ferramenta de Gerenciamento de Infraestrutura, considere sua compatibilidade com sua configuração existente (local, nuvem específica ou híbrida). Avalie suas capacidades de integração com outras ferramentas de MLOps para rastreamento de experimentos e CI/CD. Analise sua tecnologia subjacente, como sua dependência do Kubernetes, e considere a experiência do usuário tanto para cientistas de dados quanto para engenheiros dedicados. Por fim, analise seus recursos de gerenciamento de custos para garantir que estejam alinhados com suas metas de otimização de orçamento.

Gerenciamento de Infraestrutura use cases

1

Gerenciar um Cluster de GPU Compartilhado para uma Equipe de Pesquisa

O laboratório de pesquisa em IA de uma universidade tem um conjunto limitado de GPUs de ponta compartilhado entre dezenas de estudantes e pesquisadores. Um administrador de MLOps usa uma ferramenta de gerenciamento de infraestrutura para criar um sistema de agendamento justo. A ferramenta permite que eles definam cotas de recursos, priorizem trabalhos críticos e forneçam uma interface simples para os usuários enviarem suas tarefas de treinamento. Isso evita conflitos de recursos, maximiza a utilização de hardware caro e fornece visibilidade clara sobre quem está usando quais recursos a qualquer momento.

2

Automatizar Ambientes de Treinamento Escaláveis para uma Startup

Uma startup de IA precisa treinar um novo modelo de visão computacional em um grande conjunto de dados. Em vez de configurar manualmente instâncias na nuvem, seu engenheiro de MLOps define um modelo de ambiente de treinamento na ferramenta de gerenciamento de infraestrutura. Quando um cientista de dados inicia uma execução de treinamento, a ferramenta provisiona automaticamente um cluster de 10 instâncias de GPU na AWS, instala todas as dependências necessárias de uma imagem Docker, executa o trabalho e, em seguida, encerra todas as instâncias após a conclusão. Essa automação economiza horas de configuração manual e reduz os custos da nuvem, garantindo que os recursos fiquem ativos apenas quando necessário.

3

Otimizar Custos de Nuvem para Treinamento de Modelos em Larga Escala

A fatura mensal de nuvem de uma grande empresa para treinamento de modelos de IA está excessivamente alta. Uma equipe de MLOps implementa uma ferramenta de gerenciamento de infraestrutura para obter controle. O painel da ferramenta revela que muitas instâncias de GPU potentes ficam ociosas durante a noite. Eles configuram políticas para desligar ou hibernar automaticamente os espaços de trabalho ociosos. Além disso, a ferramenta os ajuda a aproveitar instâncias spot mais baratas para trabalhos de treinamento não críticos, lidando automaticamente com interrupções e retomadas. Em três meses, eles reduzem seus gastos com computação em nuvem em mais de 30% sem impactar a produtividade da equipe.

4

Provisionar Ambientes de Desenvolvimento Consistentes

Uma equipe de ciência de dados frequentemente encontra o problema de "funciona na minha máquina", onde o código falha em produção devido a ambientes locais diferentes. Usando uma ferramenta de gerenciamento de infraestrutura, o líder da equipe define um ambiente de desenvolvimento padrão e em contêiner com versões específicas de Python, CUDA e bibliotecas principais. Agora, cada cientista de dados pode iniciar um espaço de trabalho idêntico e pré-configurado com um único clique, seja localmente ou na nuvem. Isso garante a reprodutibilidade, simplifica a integração de novos membros da equipe и elimina bugs relacionados ao ambiente durante a implantação.

5

Gerenciar Cargas de Trabalho em Nuvem Híbrida para Soberania de Dados

Uma instituição financeira precisa treinar modelos com dados sensíveis de clientes que não podem sair de seu data center local. No entanto, eles querem usar a nuvem pública para tarefas menos sensíveis, como o pré-treinamento em conjuntos de dados públicos. Eles usam uma ferramenta de gerenciamento de infraestrutura de nuvem híbrida que fornece um painel único para gerenciar tanto o cluster Kubernetes local quanto a conta do GCP. Isso permite que eles agendem trabalhos de forma transparente para o ambiente apropriado com base nas políticas de segurança de dados, enquanto os cientistas de dados têm uma experiência unificada, independentemente de onde a computação acontece.

6

Garantir Alta Disponibilidade para Serviços de Inferência em Produção

Uma empresa de varejo implanta um motor de recomendação em tempo real como um microsserviço no Kubernetes. Sua ferramenta de gerenciamento de infraestrutura é configurada para monitorar este serviço de produção. Ela escala automaticamente o número de pods de inferência com base no tráfego de usuários de entrada, garantindo baixa latência durante os horários de pico de compras. Se um pod parar de responder, o sistema detecta automaticamente a falha e o substitui por um saudável, garantindo que o serviço permaneça disponível para os clientes 24 horas por dia, 7 dias por semana. Este gerenciamento automatizado é crítico para manter uma aplicação de IA confiável e de nível de produção.

Gerenciamento de Infraestrutura FAQ

O que é Gerenciamento de Infraestrutura de IA?

O Gerenciamento de Infraestrutura de IA refere-se às ferramentas e processos usados para provisionar, gerenciar e otimizar os recursos de hardware e software necessários para todo o ciclo de vida do aprendizado de máquina. Essas ferramentas ficam entre o hardware bruto (como GPUs na nuvem ou localmente) e os cientistas de dados, automatizando tarefas complexas como agendamento de recursos, configuração de ambiente e autoescalonamento. Seu principal objetivo é tornar o uso de recursos computacionais mais eficiente, econômico e reproduzível para o desenvolvimento de IA.

Como o Gerenciamento de Infraestrutura difere de uma plataforma MLOps geral?

Uma plataforma MLOps visa cobrir todo o ciclo de vida do aprendizado de máquina, incluindo versionamento de dados, rastreamento de experimentos, registro de modelos e pipelines de implantação. O Gerenciamento de Infraestrutura é um componente mais focado e fundamental dentro desse ciclo de vida. Ele lida especificamente com os recursos de computação (o 'onde' e 'como') nos quais todos os outros processos de MLOps são executados. Embora algumas plataformas MLOps abrangentes incluam recursos de gerenciamento de infraestrutura, muitas organizações usam uma ferramenta de infraestrutura especializada que se integra a outras ferramentas MLOps de ponta.

Quais são os recursos essenciais a serem procurados em uma ferramenta de Gerenciamento de Infraestrutura de IA?

Ao avaliar essas ferramentas, concentre-se nestes recursos principais:

  • Orquestração: A capacidade de agendar e gerenciar trabalhos em diferentes recursos de computação (GPUs, CPUs, local, nuvem).
  • Gerenciamento de Ambiente: Suporte para criar ambientes reproduzíveis, geralmente usando contêineres como o Docker.
  • Escalabilidade: Recursos para autoescalar recursos para cima ou para baixo com base na carga de trabalho para equilibrar desempenho e custo.
  • Monitoramento e Controle de Custos: Painéis e relatórios para rastrear o uso, monitorar gastos e aplicar orçamentos.
  • Integrações: Compatibilidade com seus provedores de nuvem, sistemas de CI/CD e outras ferramentas de MLOps.
Quem normalmente usa as ferramentas de Gerenciamento de Infraestrutura de IA?

Os principais usuários são Engenheiros de MLOps e Engenheiros de DevOps, responsáveis por construir e manter a plataforma de IA/ML para sua organização. No entanto, essas ferramentas também fornecem valor significativo aos Cientistas de Dados, dando-lhes acesso de autoatendimento a recursos de computação sem a necessidade de profundo conhecimento em infraestrutura. Além disso, Administradores de TI e equipes de Finanças usam os recursos de monitoramento e relatórios para gerenciar ativos de hardware e controlar os gastos com a nuvem.

Por que o Kubernetes é importante para o Gerenciamento de Infraestrutura de IA?

O Kubernetes tornou-se o padrão de fato para orquestração de contêineres, o que é crítico para as cargas de trabalho de IA modernas. Ele fornece uma base robusta para implantar, escalar e gerenciar aplicações complexas e em contêineres. Para a IA, isso significa que ele pode gerenciar eficientemente os recursos de GPU, lidar com o escalonamento de trabalhos de treinamento ou serviços de inferência e fornecer capacidades de autorrecuperação para garantir a confiabilidade. Muitas ferramentas avançadas de gerenciamento de infraestrutura de IA são construídas sobre o Kubernetes para aproveitar seu poder e flexibilidade para os desafios específicos de ML.