ToolMage
Entrar

AI TOOL COMPARISON

Browserless vs Crawlbase

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

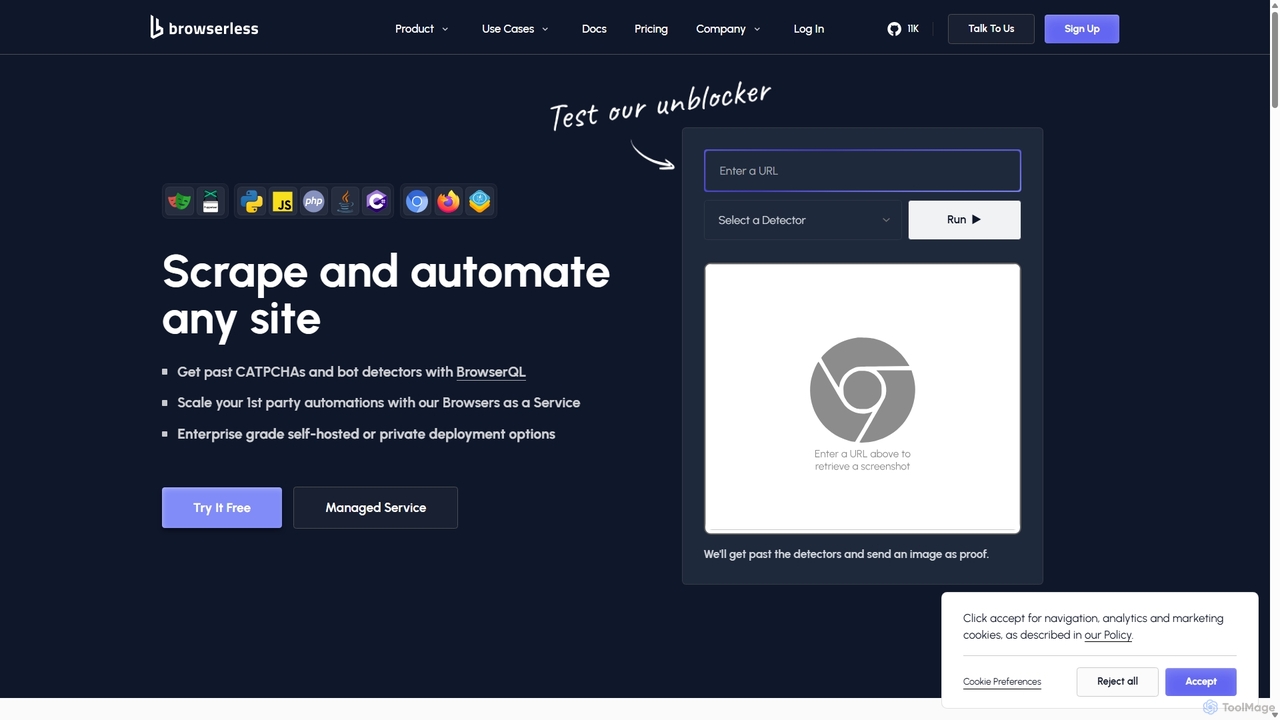
Browserless Visão geral

Browserless é uma poderosa plataforma de Browser-as-a-Service (BaaS) projetada para web scraping escalável e automação de navegador. Ajuda os desenvolvedores a contornar CAPTCHAs e detectores de bots sem esforço usando Puppeteer, Playwright ou sua linguagem proprietária BrowserQL. O serviço gerencia a infraestrutura do navegador, permitindo que os usuários se concentrem na criação de scripts de automação sem se preocupar com atualizações, vazamentos de memória ou escalabilidade.

Preview

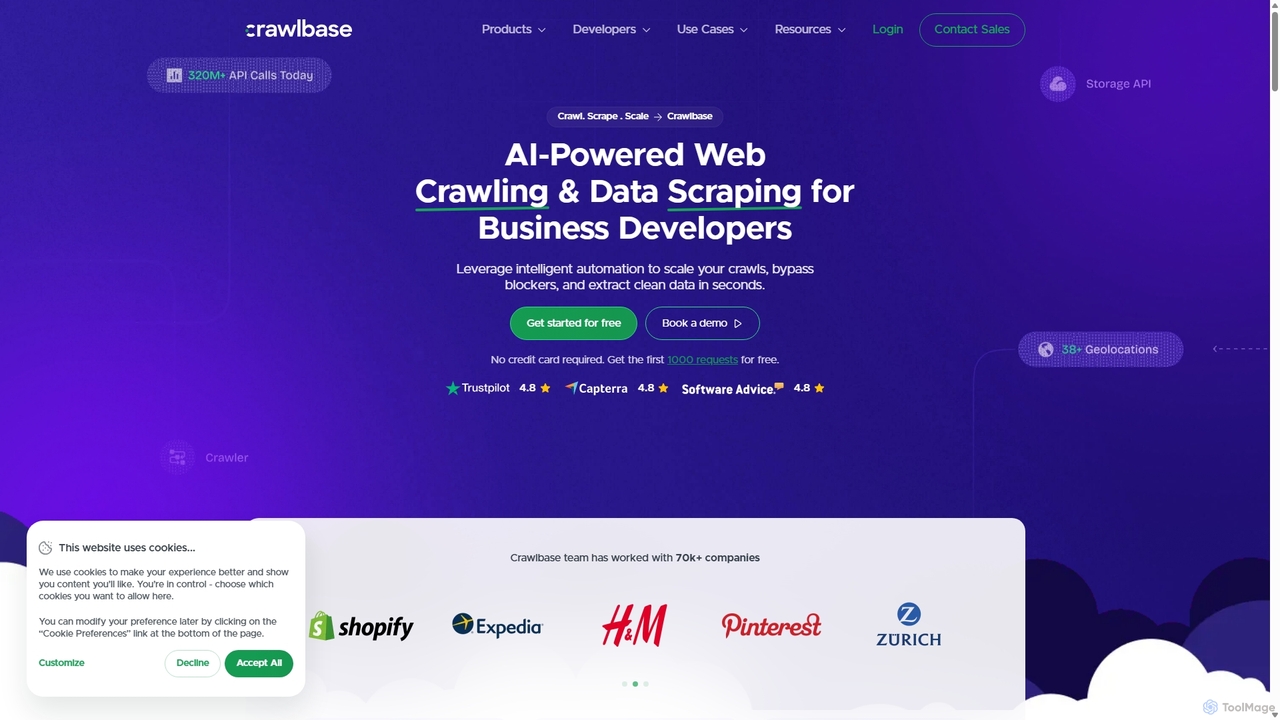
Crawlbase Visão geral

Crawlbase é uma plataforma de web crawling e extração de dados alimentada por IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo uma API de Crawling e Proxy Inteligente, para extrair dados anonimamente de qualquer site em escala, contornando bloqueios e CAPTCHAs com alta taxa de sucesso. Simplifica a coleta de dados para SEO, pesquisa de mercado, inteligência de e-commerce e treinamento de modelos de IA.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Browserless VS Crawlbase — Dados principais
Dados principaisBrowserlessCrawlbase
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusExtração de DadosExtração de Dados
Público e funçõesAnalista de Dados · Cientista de Dados · Engenheiro de DevOps · Gerente de Marketing · Gerente de Produto · Engenheiro de QA · Desenvolvedor de SoftwareProprietário de Negócio · Analista de Dados · Gerente de Marketing · Gerente de Produto · Pesquisador · Representante de Vendas · Especialista em SEO · Desenvolvedor de Software
CategoriasExtração de Dados · Web Scraping · AutomaçãoExtração de Dados · Web Scraping · Geração de Leads
Added15 de set. de 202511 de set. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Browserless

Browserless é uma plataforma abrangente baseada em nuvem que fornece instâncias de navegador headless para uma ampla gama de tarefas de automação da web e extração de dados. Foi construída para resolver os desafios comuns que os desenvolvedores enfrentam ao trabalhar com navegadores headless em escala, como gerenciamento de infraestrutura, problemas de desempenho e evasão de sistemas sofisticados de detecção de bots. Ao oferecer um pool robusto de navegadores gerenciados, o Browserless permite que desenvolvedores e empresas se concentrem em sua lógica principal, em vez das complexidades de implantar e manter sistemas de automação de navegador.

O serviço é confiável para milhares de empresas, de startups a grandes corporações, por sua confiabilidade, escalabilidade e recursos avançados. Ele oferece tanto serviços gerenciados em nuvem quanto soluções empresariais auto-hospedadas, proporcionando flexibilidade para diferentes necessidades de segurança e conformidade, incluindo a conformidade com SOC 2 Tipo II.

Como usar o Browserless

O Browserless oferece várias maneiras de integrar seus serviços ao seu fluxo de trabalho, tornando-o acessível para vários níveis de habilidade e requisitos de projeto:

  1. Conectar com Puppeteer ou Playwright: A maneira mais fácil de começar é conectando seus scripts existentes de Puppeteer ou Playwright. Em vez de iniciar uma instância de navegador local, você simplesmente altera o método de conexão para apontar para um endpoint WebSocket do Browserless. Isso requer alterações mínimas no código e escala instantaneamente suas automações existentes.
  2. Usar APIs REST: Para tarefas comuns como gerar PDFs, tirar screenshots ou extrair conteúdo HTML, o Browserless fornece APIs REST simples. Você pode fazer uma requisição cURL ou usar qualquer cliente HTTP para realizar essas ações sem escrever scripts complexos de automação de navegador.
  3. Aproveitar o BrowserQL: Para casos de uso avançados, especialmente aqueles que envolvem contornar detectores de bots difíceis (como o Cloudflare), o Browserless oferece o BrowserQL. Esta é uma linguagem de automação e IDE de última geração projetada para deixar o mínimo de impressões digitais. Você pode escrever consultas concisas para realizar ações complexas como clicar em botões, resolver CAPTCHAs e extrair dados estruturados, tudo isso parecendo mais humano para os sistemas de detecção.
  4. Automações Híbridas: O Browserless suporta fluxos de trabalho híbridos onde você pode transmitir uma sessão do navegador para um iframe. Isso é útil para tarefas que requerem intervenção manual, como resolver um CAPTCHA complexo, inserir códigos 2FA ou lidar com logins OAuth dentro de um script automatizado.

Recursos principais do Browserless

  • BrowserQL: Uma linguagem de consulta e IDE proprietária construída do zero para contornar os detectores de bots mais avançados, minimizando as impressões digitais do navegador.
  • Browser as a Service (BaaS): Um pool escalável e gerenciado de milhares de navegadores, cuidando de todos os aspectos da infraestrutura, como atualizações de versão, balanceamento de carga e gerenciamento de recursos.
  • Evasão de Detecção de Bots e CAPTCHA: Tecnologia especializada para resolver automaticamente CAPTCHAs (reCAPTCHA, hCaptcha) e passar por serviços de bloqueio de bots como o Cloudflare.
  • Integração com Puppeteer e Playwright: Compatibilidade perfeita com as duas bibliotecas de automação de navegador mais populares.
  • APIs REST: Endpoints simples para tarefas comuns, como geração de PDF, screenshots e scraping de conteúdo.
  • Gerenciamento de Sessão e Reconexões: A capacidade de manter as sessões do navegador ativas e reconectar-se a elas, o que reduz significativamente o uso de proxy e evita verificações repetitivas de bots.
  • Soluções de Nível Empresarial: Opções para auto-hospedagem, implantações em nuvem privada, configurações de máquina personalizadas (incluindo GPUs), SSO, suporte dedicado e conformidade com SOC 2 Tipo II.
  • Monitoramento e Depuração: Um painel de controle amigável que fornece métricas sobre solicitações, saúde do trabalhador (CPU/memória) e um depurador para assistir à execução dos scripts em tempo real.

Casos de uso para o Browserless

O Browserless é versátil e pode ser aplicado a inúmeros cenários:

  • Web Scraping e Extração de Dados: Coleta de dados de sites dinâmicos e pesados em JavaScript, plataformas de e-commerce (por exemplo, Walmart, eBay), listas de imóveis (Zillow) e quadros de empregos (Indeed).
  • Testes de Software Automatizados: Execução de testes de ponta a ponta para aplicações web em escala, integrando-se com frameworks como o Laravel Dusk sem a necessidade de gerenciar uma grade Selenium complexa.
  • Ingestão de Dados para IA e LLM: Fornecer a agentes de IA (por exemplo, usando LangChain ou CrewAI) acesso à web em tempo real para coletar dados frescos para treinar modelos de linguagem grandes ou realizar pesquisas automatizadas.
  • Geração de Relatórios: Geração automática de PDFs e screenshots de painéis, relatórios de análise ou faturas de aplicações web.
  • Monitoramento de Preços e Concorrência: Rastreamento de preços de produtos, níveis de estoque e estratégias de concorrentes em vários varejistas online.

Vantagens do Browserless

Usar o Browserless oferece várias vantagens importantes:

  • Redução da Sobrecarga Operacional: Elimina a necessidade de uma equipe dedicada para construir, implantar e manter uma infraestrutura complexa de automação de navegador.
  • Taxas de Sucesso Aprimoradas: Suas técnicas avançadas de evasão de bots, particularmente com o BrowserQL, levam a taxas de sucesso mais altas no scraping de sites protegidos.
  • Escalabilidade sob Demanda: Escala sem esforço de algumas sessões simultâneas para milhares, lidando com picos de tráfego sem degradação de desempenho.
  • Eficiência de Custo: Recursos como reconexões de sessão podem reduzir os custos de proxy em até 90%. O modelo de preços baseado em unidades é previsível e econômico.
  • Focado no Desenvolvedor: Projetado por desenvolvedores para desenvolvedores, com excelente documentação, SDKs e suporte técnico responsivo.

Preços e planos

O Browserless oferece um modelo de preços flexível e baseado em unidades para atender a diferentes necessidades:

  • Plano Gratuito: Inclui 1.000 unidades por mês, 1 navegador simultâneo máximo e acesso ao editor BrowserQL. Não é necessário cartão de crédito.
  • Plano de Prototipagem: Começa em $25/mês (cobrado anualmente) para 20.000 unidades e 3 navegadores simultâneos. Ideal para pequenos projetos e testes.
  • Plano Inicial: Começa em $140/mês (cobrado anualmente) para 180.000 unidades e 20 navegadores simultâneos, adequado para aplicações em crescimento.
  • Plano de Escala: Começa em $350/mês (cobrado anualmente) para 500.000 unidades e 50 navegadores simultâneos, projetado para operações de alto volume.
  • Plano Empresarial: Preços personalizados para usuários que precisam de milhões de unidades, implantações privadas, auto-hospedagem, recursos avançados como infraestrutura de GPU, SSO e um gerente de contas técnico dedicado.

Uma "Unidade" corresponde a até 30 segundos de tempo de navegador. Sessões mais longas consomem unidades adicionais. As unidades também são usadas para proxies residenciais e resoluções de CAPTCHA bem-sucedidas.

Crawlbase

Crawlbase é uma plataforma abrangente, impulsionada por IA, projetada para democratizar o acesso a dados da web. Ela capacita desenvolvedores, cientistas de dados e empresas a rastrear e extrair dados da internet em grande escala, transformando conteúdo web não estruturado em dados limpos e estruturados. Ao lidar com a infraestrutura complexa de proxies, automação de navegadores e sistemas anti-bot, a Crawlbase permite que os usuários se concentrem exclusivamente na utilização dos dados. A plataforma é construída sobre uma base de milhões de proxies residenciais e de datacenter rotativos em todo o mundo, garantindo acesso anônimo e irrestrito a sites como Amazon, LinkedIn, Google e outros, com um tempo de atividade garantido de 99,9%.

Como usar Crawlbase

Integrar a Crawlbase ao seu fluxo de trabalho é projetado para ser simples e pode ser feito em minutos:

  1. Crie uma Conta: Inscreva-se para uma conta gratuita na Crawlbase. Você receberá um token de API para autenticação. O plano inicial inclui 1.000 solicitações gratuitas para testar o serviço sem a necessidade de cartão de crédito.
  2. Escolha a Ferramenta Certa: Selecione o produto apropriado para suas necessidades. Use a API de Crawling para solicitações de dados síncronas em tempo real. Para projetos de grande escala e contínuos, o Crawler assíncrono é mais econômico. Se você precisa de um gateway de proxy simples para sua aplicação, o Proxy Inteligente é a escolha ideal.
  3. Faça uma Requisição à API: Faça uma chamada de API simples para o endpoint da Crawlbase, passando seu token de API e a URL de destino que deseja extrair. Você pode incluir vários parâmetros para habilitar a renderização de JavaScript, definir geolocalizações ou usar extratores de dados específicos.
  4. Receba os Dados: A Crawlbase processa a solicitação, navegando por bloqueios, proxies e CAPTCHAs. Em seguida, retorna o conteúdo HTML completo da página ou, se estiver usando um extrator específico (como o extrator da Amazon), fornece os dados em um formato JSON estruturado.

Recursos principais do Crawlbase

  • API de Crawling: Uma API poderosa e fácil de usar que busca o conteúdo de páginas da web em tempo real. Suporta renderização de JavaScript para sites dinâmicos e inclui extratores integrados para sites populares como a Amazon, fornecendo dados estruturados diretamente.
  • O Crawler: Uma solução de crawling assíncrona projetada para projetos de extração de dados em massa. Ele usa callbacks para entregar dados aos seus servidores, economizando custos, largura de banda e tentativas de repetição para grandes volumes de URLs.
  • Proxy Inteligente: Uma solução de proxy rotativo que fornece acesso a milhões de IPs de datacenter e residenciais. Pode ser facilmente integrado em qualquer aplicação ou script que requeira um proxy confiável para evitar ser bloqueado.
  • Tecnologia Anti-Bloqueio com IA: Algoritmos sofisticados e modelos de aprendizado de máquina que lidam automaticamente com bloqueios de IP, impressão digital do navegador, CAPTCHAs e outras medidas anti-extração, garantindo uma alta taxa de sucesso.
  • Armazenamento em Nuvem: Um recurso conveniente que permite mover seus dados rastreados e extraídos diretamente para o armazenamento em nuvem seguro da Crawlbase, simplificando seu pipeline de dados.
  • Geolocalização Global: Acesse conteúdo da web de mais de 30 países diferentes, permitindo que você realize pesquisas localizadas e colete dados específicos da região.

Casos de uso para Crawlbase

A Crawlbase é versátil e suporta uma ampla gama de atividades de negócios orientadas por dados:

  • E-commerce e Varejo: Monitore os preços dos concorrentes, rastreie a disponibilidade de produtos, agregue avaliações de clientes e analise dados de produtos de plataformas como Amazon, eBay e Walmart para otimizar estratégias de vendas.
  • Pesquisa de Mercado: Colete grandes quantidades de dados para análise de tendências de mercado, análise de sentimento de mídias sociais e fóruns, e identificação de oportunidades de negócios emergentes.
  • Geração de Leads: Automatize o processo de coleta de informações de contato e detalhes de negócios de redes profissionais como o LinkedIn, diretórios online e sites corporativos.
  • IA e Aprendizado de Máquina: Forneça conjuntos de dados estruturados de alta qualidade para treinar IA generativa e grandes modelos de linguagem (LLMs). A API pode coletar eficientemente os enormes volumes de dados de texto e imagem necessários.
  • Monitoramento de SEO: Acompanhe os rankings de palavras-chave em diferentes mecanismos de busca e locais, analise as estratégias de SEO dos concorrentes e realize auditorias de site abrangentes sem ser bloqueado.

Vantagens do Crawlbase

A Crawlbase oferece uma vantagem competitiva significativa ao abstrair as complexidades da extração de dados da web. Em vez de construir e manter uma infraestrutura interna cara e frágil, os usuários se beneficiam de uma solução confiável, escalável e econômica. As principais vantagens da plataforma incluem sua enorme rede de proxies, alta taxa de sucesso (acima de 99%), garantia de 99,9% de tempo de atividade e suporte especializado 24/7. Sua abordagem focada no desenvolvedor garante fácil integração e documentação robusta, enquanto seu compromisso com a conformidade (GDPR e CCPA) oferece tranquilidade para as empresas.

Preços e planos

A Crawlbase opera em um modelo freemium flexível e transparente. Novos usuários podem começar com um plano gratuito que inclui 1.000 solicitações gratuitas, permitindo que testem completamente as capacidades da plataforma sem fornecer um cartão de crédito. Após o teste gratuito, o preço é baseado em um sistema de pagamento conforme o uso, onde os custos são determinados pelo número de solicitações feitas e pelos recursos utilizados (por exemplo, solicitações padrão vs. solicitações com JavaScript habilitado). Para empresas com grandes necessidades de dados, a Crawlbase oferece planos Empresariais personalizados que vêm com preços customizados, gerenciamento de conta dedicado e suporte premium para atender a requisitos específicos de projetos.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Extração de DadosWeb Scraping
Só Browserless
Automação
Só Crawlbase
Geração de Leads

Etiquetas

Em comum
APIExtração de dadosmineração de dadosWeb scraping
Só Browserless
Detecção de botAutomação de navegadorResolução de captchaNavegador headlessPlaywrightPuppeteer
Só Crawlbase
Dados de treinamento de IARastreadorDados de e-commerceGeração de leadsProxyFerramentas de SEO

Público e funções

Em comum
Analista de DadosGerente de MarketingGerente de ProdutoDesenvolvedor de Software
Só Browserless
Cientista de DadosEngenheiro de DevOpsEngenheiro de QA
Só Crawlbase
Proprietário de NegócioPesquisadorRepresentante de VendasEspecialista em SEO

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Browserless monthly traffic:

Latest traffic · 2026-05

Visitas mensais
242.1K
Duração média
1:17
Páginas por visita
2.45
Taxa de rejeição
56.01%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 126.9K
  • 2026-01: 150.9K
  • 2026-02: 150.8K
  • 2026-03: 157.8K
  • 2026-04: 148.9K
  • 2026-05: 242.1K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇧🇷Brazil28.09%68K
🇺🇸United States26.55%64.3K
🇨🇭Switzerland23.8%57.6K
🇨🇦Canada11.55%28K
🇪🇸Spain10.01%24.2K

Fontes de tráfego

Source typePercentageEstimated visits
Direto81.79%198K
Referência13.74%33.3K
E-mail4.47%10.8K

Palavras-chave

browserlessbrowserless apibrowserless iomemory leak fixplaywright vs selenium

Crawlbase monthly traffic:

Latest traffic · 2026-05

Visitas mensais
32.4K
Duração média
0:19
Páginas por visita
2
Taxa de rejeição
38.17%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 82.1K
  • 2026-01: 74.4K
  • 2026-02: 50K
  • 2026-03: 46.3K
  • 2026-04: 35.7K
  • 2026-05: 32.4K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇩🇪Germany25.96%8.4K
🇷🇺Russia22.56%7.3K
🇻🇳Vietnam18.35%5.9K
🇳🇬Nigeria17.5%5.7K
🇺🇸United States15.63%5.1K

Palavras-chave

apifycrawlbasedeviantart scraperwebscraping at scaleпрокси в 2026 году бесплатно

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Browserless

Avaliação
Não verificado
Comentários
0
Favoritos
178
Curtidas
165

Crawlbase

Avaliação
Não verificado
Comentários
0
Favoritos
187
Curtidas
195

Browserless vs Crawlbase · FAQ da comparação

What do Browserless and Crawlbase have in common?
Both tools are listed under Extração de Dados、Web Scraping. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Browserless and Crawlbase free?
Listed pricing models: Browserless — Freemium; Crawlbase — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Browserless and Crawlbase?
The primary listed category is Extração de Dados for Browserless, and Extração de Dados for Crawlbase. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas