

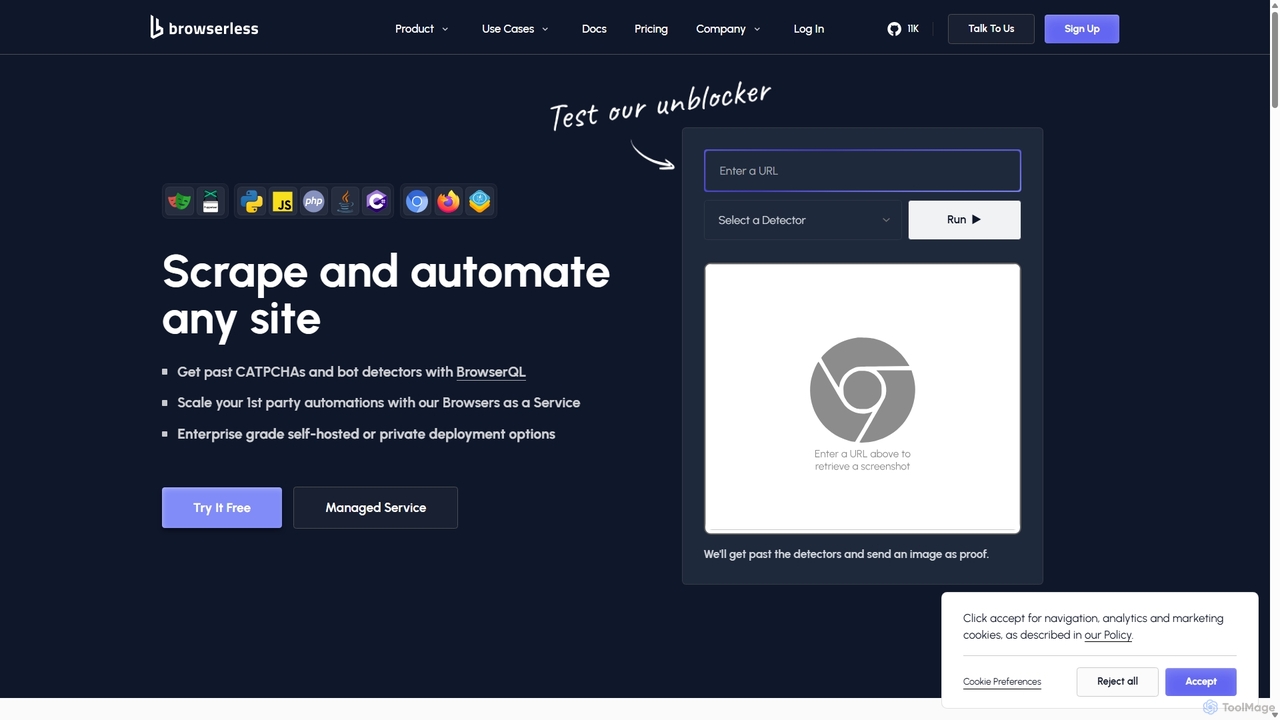
Browserless Overview
Browserless é uma plataforma abrangente baseada em nuvem que fornece instâncias de navegador headless para uma ampla gama de tarefas de automação da web e extração de dados. Foi construída para resolver os desafios comuns que os desenvolvedores enfrentam ao trabalhar com navegadores headless em escala, como gerenciamento de infraestrutura, problemas de desempenho e evasão de sistemas sofisticados de detecção de bots. Ao oferecer um pool robusto de navegadores gerenciados, o Browserless permite que desenvolvedores e empresas se concentrem em sua lógica principal, em vez das complexidades de implantar e manter sistemas de automação de navegador.
O serviço é confiável para milhares de empresas, de startups a grandes corporações, por sua confiabilidade, escalabilidade e recursos avançados. Ele oferece tanto serviços gerenciados em nuvem quanto soluções empresariais auto-hospedadas, proporcionando flexibilidade para diferentes necessidades de segurança e conformidade, incluindo a conformidade com SOC 2 Tipo II.
Como usar o Browserless
O Browserless oferece várias maneiras de integrar seus serviços ao seu fluxo de trabalho, tornando-o acessível para vários níveis de habilidade e requisitos de projeto:
- Conectar com Puppeteer ou Playwright: A maneira mais fácil de começar é conectando seus scripts existentes de Puppeteer ou Playwright. Em vez de iniciar uma instância de navegador local, você simplesmente altera o método de conexão para apontar para um endpoint WebSocket do Browserless. Isso requer alterações mínimas no código e escala instantaneamente suas automações existentes.
- Usar APIs REST: Para tarefas comuns como gerar PDFs, tirar screenshots ou extrair conteúdo HTML, o Browserless fornece APIs REST simples. Você pode fazer uma requisição cURL ou usar qualquer cliente HTTP para realizar essas ações sem escrever scripts complexos de automação de navegador.
- Aproveitar o BrowserQL: Para casos de uso avançados, especialmente aqueles que envolvem contornar detectores de bots difíceis (como o Cloudflare), o Browserless oferece o BrowserQL. Esta é uma linguagem de automação e IDE de última geração projetada para deixar o mínimo de impressões digitais. Você pode escrever consultas concisas para realizar ações complexas como clicar em botões, resolver CAPTCHAs e extrair dados estruturados, tudo isso parecendo mais humano para os sistemas de detecção.
- Automações Híbridas: O Browserless suporta fluxos de trabalho híbridos onde você pode transmitir uma sessão do navegador para um iframe. Isso é útil para tarefas que requerem intervenção manual, como resolver um CAPTCHA complexo, inserir códigos 2FA ou lidar com logins OAuth dentro de um script automatizado.
Recursos principais do Browserless
- BrowserQL: Uma linguagem de consulta e IDE proprietária construída do zero para contornar os detectores de bots mais avançados, minimizando as impressões digitais do navegador.
- Browser as a Service (BaaS): Um pool escalável e gerenciado de milhares de navegadores, cuidando de todos os aspectos da infraestrutura, como atualizações de versão, balanceamento de carga e gerenciamento de recursos.
- Evasão de Detecção de Bots e CAPTCHA: Tecnologia especializada para resolver automaticamente CAPTCHAs (reCAPTCHA, hCaptcha) e passar por serviços de bloqueio de bots como o Cloudflare.
- Integração com Puppeteer e Playwright: Compatibilidade perfeita com as duas bibliotecas de automação de navegador mais populares.
- APIs REST: Endpoints simples para tarefas comuns, como geração de PDF, screenshots e scraping de conteúdo.
- Gerenciamento de Sessão e Reconexões: A capacidade de manter as sessões do navegador ativas e reconectar-se a elas, o que reduz significativamente o uso de proxy e evita verificações repetitivas de bots.
- Soluções de Nível Empresarial: Opções para auto-hospedagem, implantações em nuvem privada, configurações de máquina personalizadas (incluindo GPUs), SSO, suporte dedicado e conformidade com SOC 2 Tipo II.
- Monitoramento e Depuração: Um painel de controle amigável que fornece métricas sobre solicitações, saúde do trabalhador (CPU/memória) e um depurador para assistir à execução dos scripts em tempo real.
Casos de uso para o Browserless
O Browserless é versátil e pode ser aplicado a inúmeros cenários:
- Web Scraping e Extração de Dados: Coleta de dados de sites dinâmicos e pesados em JavaScript, plataformas de e-commerce (por exemplo, Walmart, eBay), listas de imóveis (Zillow) e quadros de empregos (Indeed).
- Testes de Software Automatizados: Execução de testes de ponta a ponta para aplicações web em escala, integrando-se com frameworks como o Laravel Dusk sem a necessidade de gerenciar uma grade Selenium complexa.
- Ingestão de Dados para IA e LLM: Fornecer a agentes de IA (por exemplo, usando LangChain ou CrewAI) acesso à web em tempo real para coletar dados frescos para treinar modelos de linguagem grandes ou realizar pesquisas automatizadas.
- Geração de Relatórios: Geração automática de PDFs e screenshots de painéis, relatórios de análise ou faturas de aplicações web.
- Monitoramento de Preços e Concorrência: Rastreamento de preços de produtos, níveis de estoque e estratégias de concorrentes em vários varejistas online.
Vantagens do Browserless
Usar o Browserless oferece várias vantagens importantes:
- Redução da Sobrecarga Operacional: Elimina a necessidade de uma equipe dedicada para construir, implantar e manter uma infraestrutura complexa de automação de navegador.
- Taxas de Sucesso Aprimoradas: Suas técnicas avançadas de evasão de bots, particularmente com o BrowserQL, levam a taxas de sucesso mais altas no scraping de sites protegidos.
- Escalabilidade sob Demanda: Escala sem esforço de algumas sessões simultâneas para milhares, lidando com picos de tráfego sem degradação de desempenho.
- Eficiência de Custo: Recursos como reconexões de sessão podem reduzir os custos de proxy em até 90%. O modelo de preços baseado em unidades é previsível e econômico.
- Focado no Desenvolvedor: Projetado por desenvolvedores para desenvolvedores, com excelente documentação, SDKs e suporte técnico responsivo.
Preços e planos
O Browserless oferece um modelo de preços flexível e baseado em unidades para atender a diferentes necessidades:
- Plano Gratuito: Inclui 1.000 unidades por mês, 1 navegador simultâneo máximo e acesso ao editor BrowserQL. Não é necessário cartão de crédito.
- Plano de Prototipagem: Começa em $25/mês (cobrado anualmente) para 20.000 unidades e 3 navegadores simultâneos. Ideal para pequenos projetos e testes.
- Plano Inicial: Começa em $140/mês (cobrado anualmente) para 180.000 unidades e 20 navegadores simultâneos, adequado para aplicações em crescimento.
- Plano de Escala: Começa em $350/mês (cobrado anualmente) para 500.000 unidades e 50 navegadores simultâneos, projetado para operações de alto volume.
- Plano Empresarial: Preços personalizados para usuários que precisam de milhões de unidades, implantações privadas, auto-hospedagem, recursos avançados como infraestrutura de GPU, SSO e um gerente de contas técnico dedicado.
Uma "Unidade" corresponde a até 30 segundos de tempo de navegador. Sessões mais longas consomem unidades adicionais. As unidades também são usadas para proxies residenciais e resoluções de CAPTCHA bem-sucedidas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 126.9K
- 2026-1: 150.9K
- 2026-2: 150.8K
- 2026-3: 157.8K
- 2026-4: 148.9K
- 2026-5: 242.1K
Geography
Top 5 countries / regions
- 🇧🇷Brasil28.1%
- 🇺🇸Estados Unidos26.6%
- 🇨🇭Suíça23.8%
- 🇨🇦Canadá11.6%
- 🇪🇸Espanha10.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.8% |
Referral | 13.7% |
Email | 4.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| browserless | $3.04 |
| browserless api | $0.00 |
| browserless io | $5.97 |
| memory leak fix | $2.60 |
| playwright vs selenium | $2.37 |
Browserless Videos on YouTube

browserless
browserless


browserless


Latent Space TV (see @LatentSpacePod for Pod)
Browserless Alternatives
Scrappey
Scrappey é uma API avançada de web scraping projetada para que desenvolvedores extraiam dados de qualquer site sem esforço. Ele lida com todas as complexidades, como proxies rotativos, navegadores headless e o contorno de medidas anti-bot como Cloudflare e CAPTCHAs. Com uma alta taxa de sucesso e um modelo simples de pagamento conforme o uso, o Scrappey otimiza a coleta de dados para várias aplicações.
Extração de Dados
Crawlbase
Crawlbase é uma plataforma de web crawling e extração de dados alimentada por IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo uma API de Crawling e Proxy Inteligente, para extrair dados anonimamente de qualquer site em escala, contornando bloqueios e CAPTCHAs com alta taxa de sucesso. Simplifica a coleta de dados para SEO, pesquisa de mercado, inteligência de e-commerce e treinamento de modelos de IA.
Extração de Dados
Foxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de Dados
Apify
Apify é uma plataforma full-stack de web scraping e automação que permite aos desenvolvedores construir, implantar e publicar ferramentas de extração de dados, conhecidas como 'Actors'. Oferece um vasto mercado de scrapers pré-construídos para sites populares como Google Maps, Instagram e TikTok, juntamente com uma infraestrutura de nuvem robusta para criar soluções personalizadas. Com suporte para Python e JavaScript, bibliotecas de código aberto e integrações perfeitas, a Apify simplifica a coleta de dados da web em qualquer escala.
Coleta de Dados
FetchFox
FetchFox é uma ferramenta de web scraping alimentada por IA que permite aos usuários extrair dados de qualquer site usando simples prompts de texto. Elimina a necessidade de codificação complexa ou seletores CSS, lidando automaticamente com medidas anti-bot. Disponível como API, biblioteca JavaScript e extensão para Chrome, foi projetado para desenvolvedores e usuários não técnicos automatizarem a coleta de dados sem esforço.
Extração de DadosBrowserless Categories
Browserless Jobs
Browserless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Scrappey
Scrappey é uma API avançada de web scraping projetada para que desenvolvedores extraiam dados de qualquer site sem esforço. Ele lida com todas as complexidades, como proxies rotativos, navegadores headless e o contorno de medidas anti-bot como Cloudflare e CAPTCHAs. Com uma alta taxa de sucesso e um modelo simples de pagamento conforme o uso, o Scrappey otimiza a coleta de dados para várias aplicações.
Extração de DadosCrawlbase
Crawlbase é uma plataforma de web crawling e extração de dados alimentada por IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo uma API de Crawling e Proxy Inteligente, para extrair dados anonimamente de qualquer site em escala, contornando bloqueios e CAPTCHAs com alta taxa de sucesso. Simplifica a coleta de dados para SEO, pesquisa de mercado, inteligência de e-commerce e treinamento de modelos de IA.
Extração de Dados
Zyte
Zyte é uma plataforma abrangente de web scraping que oferece uma API full-stack e serviços de extração de dados. Simplifica a aquisição de dados gerenciando proxies, navegadores headless e sistemas avançados anti-bloqueio. Com a tecnologia de IA, a Zyte entrega dados da web confiáveis e estruturados em escala para empresas de e-commerce, pesquisa de mercado e muito mais.
Inteligência de MercadoFoxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de Dados
Browserman
Browserman é uma plataforma avançada de automação de navegador projetada para capacitar assistentes de IA como Claude, ChatGPT, Gemini e Grok a gerenciar operações de mídia social. Oferece suporte a múltiplas plataformas e contas, uma robusta API REST e integração nativa do Protocolo de Contexto de Modelo (MCP) para fluxos de trabalho de automação contínuos, escaláveis e seguros.
Integração
Skyvern
Skyvern é uma plataforma de automação de navegador alimentada por IA que usa visão computacional e linguagem natural para automatizar fluxos de trabalho complexos na web. Ele pode lidar com extração de dados, envio de formulários, recuperação de faturas e muito mais em qualquer site, adaptando-se dinamicamente a mudanças sem scripts tradicionais.
API
ManyPI
ManyPI é uma plataforma moderna de coleta de dados que transforma qualquer site em uma API tipo-segura. Ela simplifica a extração de dados estruturados com definição de esquema, extração de dados e transformação de registros integrados, capacitando desenvolvedores e equipes técnicas a coletar dados da web de forma confiável em escala.
3D
Hyperbrowser
O Hyperbrowser é uma plataforma de Navegador como Serviço (BaaS) projetada para agentes de IA e desenvolvedores. Ele fornece navegadores em nuvem escaláveis e ultrarrápidos para automatizar tarefas da web, extrair dados e permitir interações da web orientadas por IA. Com recursos como navegação furtiva, resolução automática de captcha e APIs amigáveis para desenvolvedores, ele capacita fluxos de trabalho complexos sem limites.
Raspagem de Dados da Web
Octoparse
Octoparse é uma poderosa ferramenta de web scraping sem código que permite a qualquer pessoa extrair dados de sites sem programação. Possui um designer de fluxo de trabalho visual, um assistente com IA para configuração fácil e centenas de modelos pré-construídos para sites populares. Com automação baseada em nuvem, rotação de IP e resolução de CAPTCHA, o Octoparse lida com tarefas complexas de scraping de forma eficiente, transformando páginas da web em dados estruturados para geração de leads, pesquisa de mercado e muito mais.
Raspagem de Dados da Web
Crawlora
Crawlora é uma plataforma de web scraping sem código, alimentada por IA, que permite aos usuários extrair dados de qualquer site sem esforço. Sua interface inteligente de apontar e clicar simplifica a extração de dados, permitindo que você transforme páginas da web em dados estruturados (CSV, JSON) sem escrever uma única linha de código. Ideal para pesquisa de mercado, geração de leads e monitoramento de preços.
Extração de Dados
BrowserBook
BrowserBook é um ambiente de desenvolvimento integrado (IDE) alimentado por IA, projetado para construir, implantar e escalar automações de navegador determinísticas. Ele simplifica tarefas complexas de automação web, oferecendo velocidade, estabilidade e economia de custos ao combinar a geração de código por IA com execução de script confiável. Ideal para agentes de IA, web scraping, testes de UI e fluxos de trabalho específicos da indústria em saúde e finanças.
Desenvolvimento de Agente IA
Browserbase
O Browserbase fornece uma infraestrutura em nuvem escalável para executar e gerenciar navegadores headless. Foi projetado para que desenvolvedores capacitem agentes de IA, automatizem fluxos de trabalho web complexos e realizem raspagem de dados em larga escala sem gerenciar a infraestrutura subjacente.
Raspagem de Dados da Web
ScrapingBee
O ScrapingBee é uma poderosa API de web scraping que lida com navegadores headless e rotação de proxy para evitar bloqueios. Possui um extrator inovador alimentado por IA que permite descrever os dados de que você precisa em inglês simples, eliminando a necessidade de seletores CSS complexos. Ideal para desenvolvedores, profissionais de marketing e analistas de dados para tarefas como monitoramento de preços, geração de leads e análise de SERP.
Extração de Dados
Rtrvr
Rtrvr é um agente de IA avançado projetado para automatizar tarefas complexas da web usando linguagem natural. Ele navega em sites, extrai dados, preenche formulários e executa fluxos de trabalho, transformando operações tediosas em conversas simples.
Automação Web
Browserless Comments (0)
Sign in to comment.
EntrarNo comments yet.