

ScrapingBee Overview
O ScrapingBee é uma API de web scraping abrangente, projetada para simplificar o complexo processo de extração de dados da web. Ele enfrenta eficazmente os desafios mais comuns no web scraping, como bloqueios de IP, limitação de taxa e o manuseio de sites dinâmicos e pesados em JavaScript. Ao gerenciar uma frota de navegadores Chrome headless e um vasto pool de proxies rotativos, o ScrapingBee permite que desenvolvedores e empresas se concentrem na análise de dados em vez das complexidades da manutenção de scrapers. Sua característica de destaque é um extrator de dados alimentado por IA, que permite aos usuários especificar seus requisitos de dados em linguagem natural, tornando o processo mais intuitivo e resiliente a mudanças no layout do site.
Como usar o ScrapingBee
Usar o ScrapingBee é simples e projetado para a eficiência do desenvolvedor. O processo começa com um simples cadastro para obter uma chave de API. Com sua chave em mãos, você pode fazer solicitações de API para o endpoint do ScrapingBee.
1. Escolha seu endpoint: Para scraping geral, você envia uma solicitação GET para a API com a URL de destino como parâmetro.
2. Habilite a Renderização de JavaScript: Para fazer scraping de aplicações de página única (SPAs) construídas com React, Vue.js ou Angular, basta adicionar o parâmetro `render_js=True` à sua solicitação. Isso informa ao ScrapingBee para renderizar a página em um navegador Chrome real antes de retornar o HTML.
3. Use a Extração por IA: Para a extração de dados mais simples, use o recurso de extração por IA. Você descreve os campos de dados que deseja em inglês simples (por exemplo, "extrair o título do produto, preço e avaliações dos clientes"). A IA analisará a página e retornará dados JSON estruturados sem que você precise escrever nenhum seletor CSS.
4. Execute Scripts Personalizados: Para interações complexas como clicar em botões, rolar a página ou esperar que elementos apareçam, você pode usar o parâmetro `js_scenario` para passar um trecho de JavaScript personalizado.
5. Tire Screenshots: Adicione o parâmetro `screenshot=True` para capturar uma screenshot de página inteira ou parcial do site de destino.
6. Faça Scraping do Google: Use o endpoint dedicado da API de Pesquisa do Google para fazer scraping facilmente das páginas de resultados do motor de busca (SERPs) sem enfrentar limites de taxa.
Recursos principais do ScrapingBee
- Extração Alimentada por IA: Descreva os dados de que você precisa em inglês simples. A IA identifica e extrai inteligentemente as informações relevantes em um formato JSON estruturado, adaptando-se automaticamente às mudanças no layout do site.
- Renderização de Navegador Headless: Utiliza as versões mais recentes do Chrome para renderizar qualquer site pesado em JavaScript, garantindo que você obtenha o conteúdo HTML completo de páginas dinâmicas e aplicações de página única.
- Rotação Automática de Proxy: Aproveita um grande pool de proxies residenciais e de datacenter para rotacionar automaticamente os endereços IP para cada solicitação, reduzindo significativamente a chance de ser bloqueado ou ter a taxa limitada.
- Geotargeting: Especifique o país para sua solicitação para acessar conteúdo geo-restrito e visualizar sites como um usuário local faria.
- Cenários de JavaScript Personalizados: Execute código JavaScript personalizado na página de destino para lidar com interações complexas como cliques, rolagens, envios de formulário e espera por elementos específicos aparecerem.
- API de Scraping de SERP: Uma API especializada para fazer scraping das páginas de resultados de pesquisa do Google de forma eficiente e confiável, contornando obstáculos comuns.
- API de Screenshot: Capture screenshots de alta qualidade, de página inteira ou parciais de qualquer site diretamente através da API.
Casos de uso para ScrapingBee
O ScrapingBee é versátil e confiável por mais de 2.500 clientes para uma ampla gama de aplicações:
- E-commerce e Monitoramento de Preços: Varejistas e analistas de mercado usam o ScrapingBee para rastrear preços de concorrentes, monitorar níveis de estoque e coletar detalhes de produtos de milhares de sites de e-commerce.
- Geração de Leads: Equipes de vendas e marketing fazem scraping de redes profissionais, diretórios online e sites de empresas para construir listas de leads direcionadas.
- SEO e Análise de SERP: Profissionais de SEO usam a API de Pesquisa do Google para rastrear rankings de palavras-chave, analisar recursos de SERP e monitorar a presença online dos concorrentes.
- Agregação de Dados Imobiliários: Agências e investidores fazem scraping de anúncios imobiliários para coletar dados sobre preços de imóveis, disponibilidade e características em diferentes plataformas.
- Pesquisa Acadêmica e de Mercado: Pesquisadores e jornalistas extraem dados de várias fontes da web para estudos, relatórios e criação de conteúdo, como demonstrado por usuários que coletam dados para dissertações ou postagens de blog.
Vantagens do ScrapingBee
A principal vantagem do ScrapingBee é sua capacidade de abstrair as partes mais difíceis do web scraping. Os usuários não precisam mais gerenciar sua própria infraestrutura de proxy ou frotas de navegadores headless, economizando tempo, recursos e sobrecarga de manutenção significativos. O recurso de extração por IA é um grande diferencial, tornando os scrapers mais fáceis de construir e mais robustos contra atualizações de sites. A API é bem documentada, fácil de integrar e oferece uma alta taxa de sucesso mesmo em sites fortemente protegidos. Além disso, o modelo "pague pelo sucesso", onde solicitações falhas não são cobradas, e o excelente suporte ao cliente o tornam uma solução confiável e econômica.
Preços e planos
O ScrapingBee oferece uma estrutura de preços transparente e em níveis, adequada para várias necessidades, com a opção de cancelar a qualquer momento. Todos os planos vêm com um teste gratuito de 1.000 chamadas de API (não é necessário cartão de crédito).
- Plano Freelance: A partir de $49/mês, este plano inclui 250.000 créditos de API e 10 solicitações simultâneas, ideal para desenvolvedores individuais e pequenos projetos.
- Plano Startup: Por $99/mês, fornece 1.000.000 de créditos de API e 50 solicitações simultâneas, adequado para empresas em crescimento.
- Plano Business: Por $249/mês, os usuários obtêm 3.000.000 de créditos de API e 100 solicitações simultâneas, projetado para empresas estabelecidas com maiores demandas de scraping.
- Plano Business+: Por $599/mês, este plano oferece 8.000.000 de créditos de API e 200 solicitações simultâneas.
Todos os planos pagos incluem renderização de JavaScript, proxies rotativos e premium, e geotargeting. Planos de nível superior oferecem suporte por e-mail prioritário и gerenciamento de conta dedicado. Planos empresariais personalizados estão disponíveis para usuários que precisam de mais créditos e simultaneidade.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 218.3K
- 2026-1: 287.2K
- 2026-2: 262.7K
- 2026-3: 265.2K
- 2026-4: 241.2K
- 2026-5: 258.2K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos57.0%
- 🇮🇳Índia16.8%
- 🇲🇦Marrocos9.7%
- 🇷🇺Rússia8.6%
- 🇫🇷França8.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 83.5% |
Referral | 11.9% |
Email | 4.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| scrapfly | $4.37 |
| scraping bee | $1.97 |
| scrapingbee | $1.87 |
| scrapling | $2.33 |
| serpapi | $2.23 |
ScrapingBee Videos on YouTube

Stephen W. Thomas | AI, Agents & Azure Integration

Stephen W. Thomas | AI, Agents & Azure Integration
Stephen W. Thomas | AI, Agents & Azure Integration
Stephen W. Thomas | AI, Agents & Azure Integration
Stephen W. Thomas | AI, Agents & Azure Integration
My Online Master Global

👋 Yerain Abreu - SEO & Digital Marketing
ScrapingBee Alternatives
Crawlbase
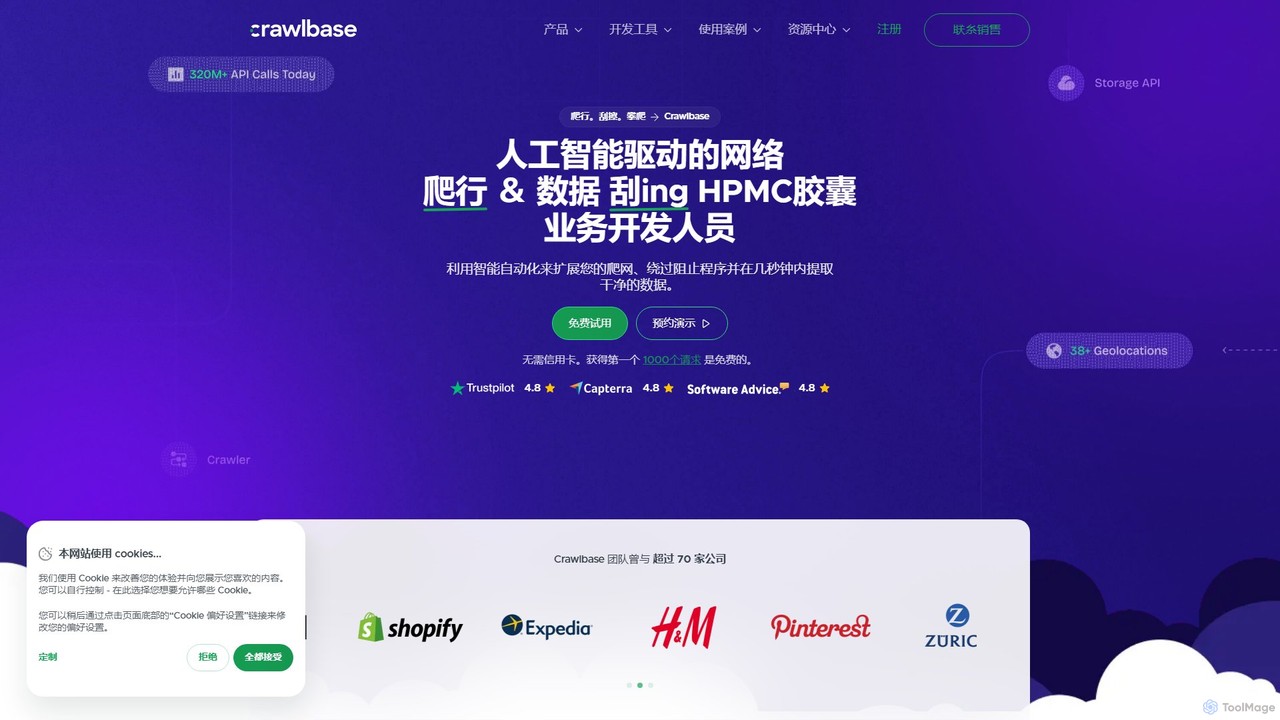
Crawlbase é uma plataforma de web scraping e crawling alimentada por IA, projetada para desenvolvedores e empresas. Simplifica a extração de dados ao lidar com proxies, CAPTCHAs e sistemas anti-bot, permitindo que você rastreie anonimamente qualquer site e recupere dados limpos e estruturados em escala. Oferece um conjunto de ferramentas, incluindo uma API de Crawling, Smart Proxy e Cloud Storage.
Coleta de Dados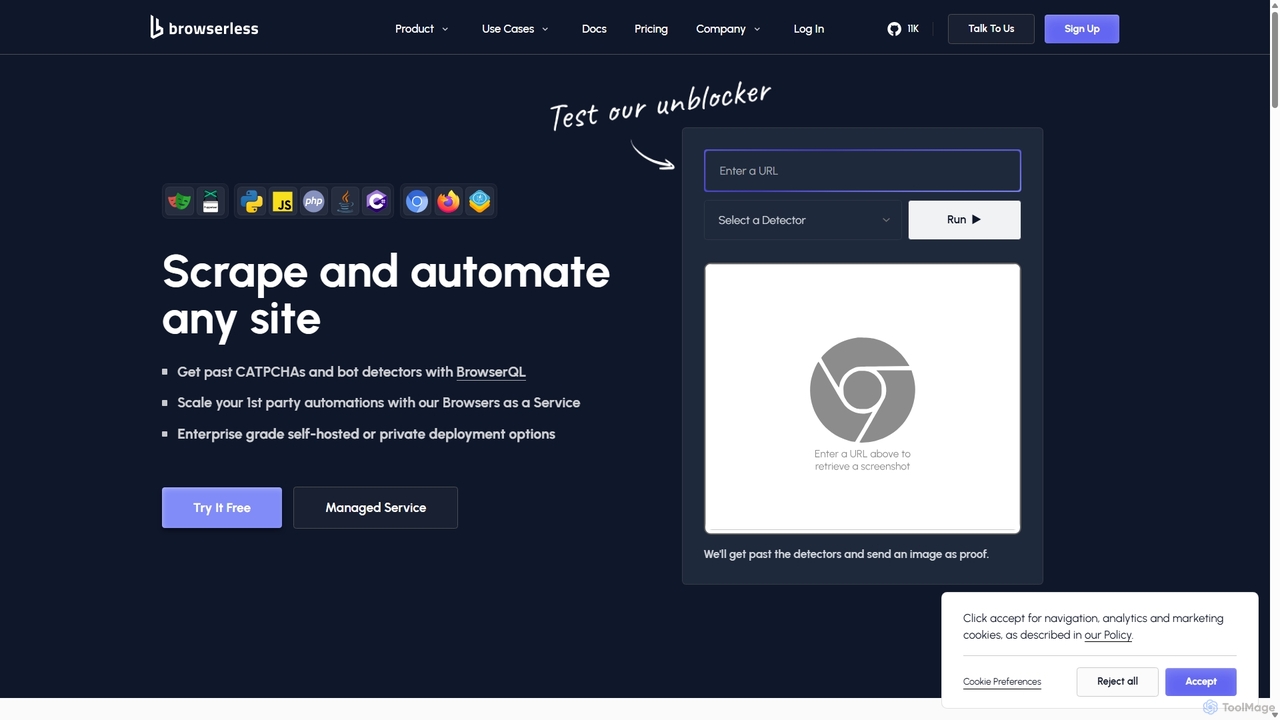
Browserless
Browserless é uma poderosa plataforma de Browser-as-a-Service (BaaS) projetada para web scraping escalável e automação de navegador. Ajuda os desenvolvedores a contornar CAPTCHAs e detectores de bots sem esforço usando Puppeteer, Playwright ou sua linguagem proprietária BrowserQL. O serviço gerencia a infraestrutura do navegador, permitindo que os usuários se concentrem na criação de scripts de automação sem se preocupar com atualizações, vazamentos de memória ou escalabilidade.
Extração de Dados
WebScraping.AI
WebScraping.AI é uma API avançada para desenvolvedores que simplifica a raspagem de dados da web usando IA. Possui proxies rotativos, renderização de JavaScript e geolocalização para contornar bloqueios e acessar conteúdo dinâmico. Sua principal força reside em suas ferramentas alimentadas por LLM, que podem extrair dados não estruturados, gerar resumos e responder a perguntas diretamente de páginas da web, otimizando a coleta de dados para qualquer projeto.
Extração de Dados
Scrappey
Scrappey é uma API avançada de web scraping projetada para que desenvolvedores extraiam dados de qualquer site sem esforço. Ele lida com todas as complexidades, como proxies rotativos, navegadores headless e o contorno de medidas anti-bot como Cloudflare e CAPTCHAs. Com uma alta taxa de sucesso e um modelo simples de pagamento conforme o uso, o Scrappey otimiza a coleta de dados para várias aplicações.
Extração de Dados
Apify
Apify é uma plataforma full-stack de web scraping e automação que permite aos desenvolvedores construir, implantar e publicar ferramentas de extração de dados, conhecidas como 'Actors'. Oferece um vasto mercado de scrapers pré-construídos para sites populares como Google Maps, Instagram e TikTok, juntamente com uma infraestrutura de nuvem robusta para criar soluções personalizadas. Com suporte para Python e JavaScript, bibliotecas de código aberto e integrações perfeitas, a Apify simplifica a coleta de dados da web em qualquer escala.
Coleta de DadosScrapingBee Categories
ScrapingBee Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Foxscrape
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
Extração de DadosBrowserless
Browserless é uma poderosa plataforma de Browser-as-a-Service (BaaS) projetada para web scraping escalável e automação de navegador. Ajuda os desenvolvedores a contornar CAPTCHAs e detectores de bots sem esforço usando Puppeteer, Playwright ou sua linguagem proprietária BrowserQL. O serviço gerencia a infraestrutura do navegador, permitindo que os usuários se concentrem na criação de scripts de automação sem se preocupar com atualizações, vazamentos de memória ou escalabilidade.
Extração de DadosScrappey
Scrappey é uma API avançada de web scraping projetada para que desenvolvedores extraiam dados de qualquer site sem esforço. Ele lida com todas as complexidades, como proxies rotativos, navegadores headless e o contorno de medidas anti-bot como Cloudflare e CAPTCHAs. Com uma alta taxa de sucesso e um modelo simples de pagamento conforme o uso, o Scrappey otimiza a coleta de dados para várias aplicações.
Extração de DadosWebScraping.AI
WebScraping.AI é uma API avançada para desenvolvedores que simplifica a raspagem de dados da web usando IA. Possui proxies rotativos, renderização de JavaScript e geolocalização para contornar bloqueios e acessar conteúdo dinâmico. Sua principal força reside em suas ferramentas alimentadas por LLM, que podem extrair dados não estruturados, gerar resumos e responder a perguntas diretamente de páginas da web, otimizando a coleta de dados para qualquer projeto.
Extração de DadosCrawlbase
Crawlbase é uma plataforma de web scraping e crawling alimentada por IA, projetada para desenvolvedores e empresas. Simplifica a extração de dados ao lidar com proxies, CAPTCHAs e sistemas anti-bot, permitindo que você rastreie anonimamente qualquer site e recupere dados limpos e estruturados em escala. Oferece um conjunto de ferramentas, incluindo uma API de Crawling, Smart Proxy e Cloud Storage.
Coleta de Dados
Zyte
Zyte é uma plataforma abrangente de web scraping que oferece uma API full-stack e serviços de extração de dados. Simplifica a aquisição de dados gerenciando proxies, navegadores headless e sistemas avançados anti-bloqueio. Com a tecnologia de IA, a Zyte entrega dados da web confiáveis e estruturados em escala para empresas de e-commerce, pesquisa de mercado e muito mais.
Inteligência de Mercado
Simplescraper
O Simplescraper é uma poderosa ferramenta de web scraping que extrai dados de qualquer site em segundos. Oferece uma extensão do Chrome fácil de usar para seleção de dados sem código, automação baseada na nuvem para scraping em grande escala e um recurso inovador de IA (AI Enhance) para extrair insights usando prompts simples. Transforme sites em dados estruturados (CSV, JSON) ou APIs instantâneas e integre com ferramentas como Google Sheets e Airtable.
Raspagem de Dados da WebApify
Apify é uma plataforma full-stack de web scraping e automação que permite aos desenvolvedores construir, implantar e publicar ferramentas de extração de dados, conhecidas como 'Actors'. Oferece um vasto mercado de scrapers pré-construídos para sites populares como Google Maps, Instagram e TikTok, juntamente com uma infraestrutura de nuvem robusta para criar soluções personalizadas. Com suporte para Python e JavaScript, bibliotecas de código aberto e integrações perfeitas, a Apify simplifica a coleta de dados da web em qualquer escala.
Coleta de Dados
FetchFox
FetchFox é uma ferramenta de web scraping alimentada por IA que permite aos usuários extrair dados de qualquer site usando simples prompts de texto. Elimina a necessidade de codificação complexa ou seletores CSS, lidando automaticamente com medidas anti-bot. Disponível como API, biblioteca JavaScript e extensão para Chrome, foi projetado para desenvolvedores e usuários não técnicos automatizarem a coleta de dados sem esforço.
Extração de Dados
Crawlbase
Crawlbase é uma plataforma de web crawling e extração de dados alimentada por IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo uma API de Crawling e Proxy Inteligente, para extrair dados anonimamente de qualquer site em escala, contornando bloqueios e CAPTCHAs com alta taxa de sucesso. Simplifica a coleta de dados para SEO, pesquisa de mercado, inteligência de e-commerce e treinamento de modelos de IA.
Extração de Dados
Scrapeless
Um kit de ferramentas de web scraping com tecnologia de IA para desenvolvedores e empresas. Oferece um conjunto de ferramentas, incluindo um Navegador de Scraping, API de Scraping Universal e API Deep SERP para extrair dados públicos da web em escala sem esforço. É especializado em contornar medidas anti-bot, fornecendo dados estruturados para e-commerce, pesquisa de mercado e treinamento de modelos de IA, com foco em confiabilidade e facilidade de uso.
Raspagem
URLtoText
URLtoText é uma ferramenta alimentada por IA que extrai texto limpo e estruturado de qualquer site ou PDF. Remove de forma inteligente anúncios, barras laterais e outros ruídos para fornecer apenas o conteúdo principal. Com renderização de JavaScript, proxies de IP residenciais e uma API para desenvolvedores, é projetado para pesquisadores, desenvolvedores e empresas que precisam de extração de dados confiável de páginas da web estáticas e dinâmicas.
Curadoria de Conteúdo
instantapi
O instantapi é uma API de web scraping alimentada por IA, projetada para simplicidade e velocidade. Permite que os usuários extraiam dados estruturados de qualquer site com uma única chamada de API, eliminando a necessidade de codificação complexa ou configuração manual. Ideal para desenvolvedores, analistas de dados e empresas que precisam de extração de dados rápida, acessível e confiável sem o incômodo dos raspadores da web tradicionais.
Extração de Dados
UseScraper
UseScraper é uma poderosa API de crawler e scraper da web projetada para desenvolvedores e aplicações de IA. Extrai dados de qualquer site de forma eficiente, com renderização completa de JavaScript, infraestrutura de autoescalonamento e formatos de saída limpos como Markdown, ideal para alimentar dados em LLMs como o ChatGPT.
Extração de Dados
ScrapingBee Comments (0)
Sign in to comment.
EntrarNo comments yet.