Foxscrape
Extração de Dados
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Extração de Dados
Extração de Dados
O FoxScrape é uma API REST de web scraping com IA para desenvolvedores. Ele simplifica a extração de dados convertendo qualquer site em dados JSON estruturados, usando recursos como análise orientada por IA a partir de inglês simples, renderização de JavaScript para sites dinâmicos e rotação automática de proxy para evitar bloqueios.
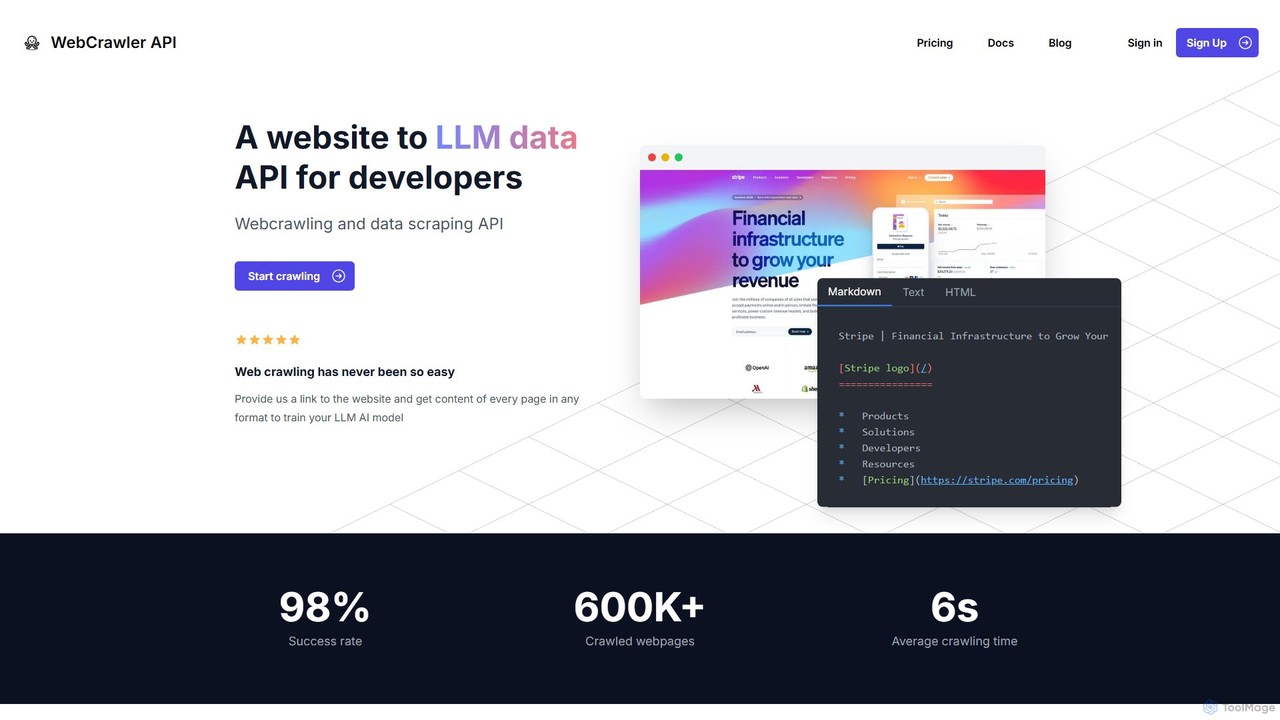
Webcrawlerapi é uma API poderosa para desenvolvedores rastrearem sites e extraírem dados limpos sem esforço. Simplifica a raspagem de dados ao lidar com renderização de JavaScript, medidas anti-bot e análise de dados. Ideal para coletar conteúdo estruturado como Markdown ou texto para treinar modelos de IA LLM ou para sistemas de Geração Aumentada por Recuperação (RAG), oferece uma alta taxa de sucesso e um modelo de preços simples de pagamento conforme o uso.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Dados principais | Foxscrape | Webcrawlerapi |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Extração de Dados | Extração de Dados |
| Público e funções | Analista de Negócios · Analista de Dados · Cientista de Dados · Gerente de Marketing · Gerente de Produto · Desenvolvedor de Software | Não verificado |
| Categorias | Extração de Dados · API · Automação | Extração de Dados · API · Automação |
| Added | 5 de nov. de 2025 | 2 de ago. de 2025 |
| Atualizado | 19 de nov. de 2026 | 19 de nov. de 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
O FoxScrape fornece uma API REST profissional projetada para otimizar o processo de web scraping para desenvolvedores. Ele permite que os usuários extraiam dados estruturados de qualquer site e os recebam em formato JSON limpo. A plataforma foi construída para ser poderosa e fácil de usar, atendendo tanto a iniciantes quanto a profissionais experientes. Ela utiliza milhares de instâncias do Chrome headless para garantir que as solicitações de API se comportem como um usuário real, contornando medidas anti-bot comuns e extraindo dados de forma confiável em escala.
Para usar o FoxScrape, os desenvolvedores podem começar obtendo uma chave de API gratuita que inclui 1.000 créditos. A integração é direta: faça uma chamada de API REST para o endpoint do FoxScrape, incluindo sua chave de API no cabeçalho 'Authorization' e a URL de destino como parâmetro. Para sites dinâmicos construídos com frameworks como React ou Vue, basta habilitar o parâmetro 'render_js'. Para extração inteligente, descreva os dados necessários em inglês simples, e a IA cuidará da análise sem a necessidade de seletores CSS ou XPath.
O FoxScrape é ideal para uma variedade de tarefas de extração de dados. Desenvolvedores e analistas de dados podem usá-lo para monitoramento de preços em sites de e-commerce, coleta de anúncios imobiliários, agregação de avaliações de clientes, realização de pesquisas de mercado extraindo dados de concorrentes e extração de resultados de mecanismos de busca para análise de SEO. Sua capacidade de lidar com sites complexos também o torna adequado para extrair dados de portais financeiros, mídias sociais e sites de notícias.
A principal vantagem do FoxScrape é sua inteligência e confiabilidade. A extração alimentada por IA elimina a necessidade de seletores CSS frágeis, tornando os scrapers mais resilientes a atualizações de sites. A rotação de proxy integrada e a renderização no nível do navegador garantem altas taxas de sucesso e evitam bloqueios. Ele oferece uma solução completa que combina um scraper, renderizador e gerenciador de proxy em uma única API escalável, economizando tempo e esforço significativos dos desenvolvedores em comparação com a construção e manutenção de uma configuração própria.
O FoxScrape oferece um modelo de preços transparente com um teste gratuito. Novos usuários recebem 1.000 créditos de API gratuitos sem a necessidade de um cartão de crédito.
Webcrawlerapi é uma API especializada projetada para otimizar o processo de rastreamento da web e extração de dados para desenvolvedores. Em uma era onde os dados são cruciais para treinar grandes modelos de linguagem (LLMs) e alimentar aplicações de IA, a raspagem de dados tradicional apresenta desafios significativos. Estes incluem lidar com conteúdo dinâmico renderizado por JavaScript, contornar sistemas anti-bot sofisticados, gerenciar proxies e limpar HTML bagunçado em formatos utilizáveis. A Webcrawlerapi abstrai todas essas complexidades, fornecendo uma interface simples, mas poderosa, para transformar qualquer site em uma fonte de dados estruturada.
Com uma taxa de sucesso relatada de 98% e um tempo médio de rastreamento de apenas 6 segundos, o serviço é construído para eficiência e confiabilidade. Ele permite que os desenvolvedores se concentrem na lógica principal de sua aplicação, em vez de se prenderem às complexidades de construir e manter uma infraestrutura de rastreamento escalável. Ao fornecer um link, os desenvolvedores podem receber conteúdo limpo e pronto para uso em formatos como Markdown, texto ou HTML bruto, tornando-o perfeito para alimentar pipelines de treinamento de modelos de IA ou bases de conhecimento para sistemas RAG.
Integrar a Webcrawlerapi em seu projeto é projetado para ser simples. O processo geralmente envolve apenas algumas linhas de código. Primeiro, você precisa se inscrever no site da Webcrawlerapi para obter sua chave de acesso única da API. Em seguida, você pode usar uma de suas bibliotecas de cliente fornecidas para linguagens de programação populares.
Por exemplo, em um ambiente NodeJS, você começaria instalando a biblioteca do cliente via npm: npm i webcrawlerapi-js. Então, em seu código, você importa a biblioteca, cria uma nova instância do cliente com sua chave de API e chama o método `crawl`. Este método aceita parâmetros como a `url` de destino, o `scrape_type` desejado (por exemplo, 'markdown') e limites opcionais como `items_limit`. A API então lida com todo o processo de rastreamento em segundo plano e retorna uma resposta JSON estruturada com os dados extraídos. Padrões de integração simples semelhantes estão disponíveis para Python, PHP e .NET, tornando-o acessível a uma ampla gama de desenvolvedores.
A Webcrawlerapi é versátil e pode ser aplicada a uma variedade de tarefas intensivas em dados. Seus principais casos de uso giram em torno de IA e análise de dados.
A principal vantagem da Webcrawlerapi é sua simplicidade e eficiência. Ela permite que as equipes de desenvolvimento terceirizem toda a infraestrutura de rastreamento da web e o ônus da manutenção. Isso significa um tempo de lançamento mais rápido para produtos orientados a dados. A alta taxa de sucesso (98%) e os recursos robustos anti-bot garantem que os pipelines de dados sejam confiáveis. Além disso, seu modelo de preços transparente e de pagamento conforme o uso é altamente econômico, pois você paga apenas por solicitações bem-sucedidas, eliminando o risco e a sobrecarga associados a assinaturas ou à construção de uma solução interna.
A Webcrawlerapi emprega um modelo de preços 'pague pelo uso' direto e transparente, evitando completamente assinaturas e taxas ocultas. Os custos são calculados com base no número de páginas que você rastreia com sucesso a cada mês. O serviço inclui trabalhos de rastreamento ilimitados, uma rede de proxy ilimitada e gerenciada automaticamente, e suporte por e-mail em seu preço. Para uma estimativa de custo clara, o site fornece uma calculadora. Como exemplo, rastrear 10.000 páginas em um mês custaria aproximadamente $20. Este modelo é ideal para projetos de todos os tamanhos, desde experimentos em pequena escala até operações de dados em grande escala, pois os custos escalam diretamente com o uso. A plataforma também permite que os usuários experimentem o serviço antes de fazer uma compra, provavelmente através de uma alocação de crédito gratuito para novas contas.
A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.
O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇧🇷Brazil | 27.03% | 439 |
| 🇨🇭Switzerland | 25.81% | 419 |
| 🇮🇳India | 25.7% | 417 |
| 🇦🇹Austria | 15.65% | 254 |
| 🇺🇸United States | 5.81% | 94 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.
Sim, o Foxscrape foi projetado para extrair dados de sites modernos. Ao habilitar o parâmetro `render_js` em sua solicitação de API, o serviço usa instâncias do Chrome headless para renderizar completamente qualquer site construído com frameworks como React, Vue ou Angular, permitindo que você extraia conteúdo dinâmico.
Você pode integrar o Foxscrape fazendo solicitações HTTP para seu endpoint de API REST. De acordo com a documentação, você precisa incluir sua chave de API no cabeçalho `Authorization` como um token Bearer (ex: `Authorization: Bearer YOUR_API_KEY`). A documentação fornece exemplos para cURL e a API `fetch` do JavaScript para você começar rapidamente.
O Foxscrape emprega um sistema de rotação automática de proxy que utiliza um grande pool geo-distribuído de proxies premium. Este recurso rotaciona automaticamente os endereços IP para suas solicitações, reduzindo significativamente as chances de encontrar limites de taxa, CAPTCHAs e banimentos de IP dos sites de destino.
A API do Foxscrape usa códigos de status HTTP padrão para indicar o resultado de uma solicitação. Conforme a documentação, uma solicitação bem-sucedida retorna um código de status `200`. Erros são indicados com códigos como `400` para solicitações inválidas (parâmetros ausentes/inválidos), `401` para uma chave de API inválida ou `500` para um erro interno do servidor.
O Foxscrape oferece dois planos pagos principais: o plano Starter por $20/mês para 150.000 créditos de API e 20 solicitações simultâneas, e o plano Pro por $79/mês para 1.000.000 de créditos de API e 100 solicitações simultâneas. Há também um teste gratuito que fornece 1.000 créditos de API para novos usuários sem exigir um cartão de crédito.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.